Nachklapp zur ersten GNDCon der Deutschen Nationalbibliothek, Frankfurt am Main, 3./4. Dezember 2018

Die Tickets für die erste große – vom 3. auf den 4. Dezember 2018 an der Frankfurter Nationalbibliothek veranstaltete – GNDCon waren Monate zuvor restlos vergeben. Um die 300 Interessenten füllten schließlich den großen Saal der Adickesallee 1 mit seiner Empore und am Rande aufgestellten Stehtischen: Bibliotheksrepräsentanten, Informatiker, die an Museen und in Archiven im deutschsprachigen Raum Datenbanken betreuen, Geisteswissenschaftler aus den Digital Humanities aller möglichen Projekte. Schließlich sollte es um nicht weniger als die „Öffnung der GND“, der Gemeinsamen Normdaten gehen, mit denen die Deutsche Nationalbibliothek Kultureinrichtungen im gesamten deutschsprachigen Raum und weltweit versorgt. CC0, frei lizenziert, sind sie schon seit längerem, doch das soll erst der Beginn der Öffnung sein.

Die anwesende Forschung war angereist zum guten Teil mit dem Willen aufzubegehren: Man sollte drauf dringen, in Zukunft höhere Rechte erhalten als das bescheidene, Vorschläge zu neuen Einträgen und zu dringenden Korrekturen machen zu dürfen. Bibliothekare äußerten sich unter der Spannung eines auf sie zurollenden Softwareumbruchs. Wer auch immer von der „Öffnung der GND“ redete, hatte womöglich noch kaum verstanden, wie die GND ihre Autorität bislang verteidigte. Für Wikidata sollte die Veranstaltung zu einer eigenartigen Geburtstagsfeier werden: Sechs Jahre waren vergangen und Wikidata war, anders als die Wikipedien zuvor, nach diesem sehr kurzen Spurt in der Lage, unter den globalen Normdatenanbietern mit Autorität zu punkten und mit der Software um die sich alles immer wieder drehte.

Durch das Programm führten Barbara Fischer und Jürgen Kett, erstere von Wikimedia an die DNB gewechselt. Internetkulturen mischten sich plötzlich mit ganz unerwartetem Charme.

Bildquelle: https://wiki.dnb.de/display/GNDCON2018/Bilder+%7C+GNDCon, Lizenz: Creative Commons unter Namensnennung, Weitergabe unter gleichen Bedingungen 2.5 Generic

Normdaten – Dreh- und Angelpunkte der Verständigung über die Dinge im Internet

Über die Normdaten organisieren sich mittlerweile die Katalogsysteme der Archive, Bibliotheken und Museen – und zunehmend auch Forschungsprojekte in den Digital Humanities.

Früher vermerkte jede Bibliothek, jedes Museum und jedes Forschungsprojekt für sich, von wem es soeben sprach; ob von „Thomas Mann“, dem Autor der Buddenbrooks, dem 1946 geborenen CDU-Politiker, dem zwanzig Jahre jüngeren Juristen oder von einem anderem der insgesamt 28 Träger dieses Namens, die die GND listet. Eindeutigkeit und Referenzdaten gewährleistet heute die GND-Nummer, an die sich alle Daten koppeln, über die die Trennungen verlaufen: biographische Eckdaten, geographische Informationen, Berufsbezeichnungen, zentrale Werkzuweisungen. Natürlich sollte Forschung der Digitalen Geisteswissenschaften sich der GND bei jedem Arbeitsschritt bedienen. Ein Projekt, das in Periodika der Weimarer Republik Autoren namentlich identifiziert, sollte diesen GND-Nummern zuweisen, wo immer solche bereits vorliegen, und so für spätere Auswertungen nachvollziehbar machen, wen genau man identifizierte. Es wäre im selben Moment praktisch, wenn das Projekt selbst GND-Nummern vergeben könnte. Am Ende erwartet man von der Deutschen Nationalbibliothek, dass sie die Forschung auswertet und neue Einträge generiert. Die Forschung weiß eigentlich am präzisesten, welche Datensätze sie soeben generieren möchte.

Im Rahmen des organisatorischen Verbunds, der die GND effektiv unter dem „DACH“ deutsch-österreichisch-schweizerischer Institutionen produziert, agieren in der GND eben darum längst schon Forscher mit eingeschränkten Editierrechten, mit Vorschlagsrechten – was indes eben immer noch weit entfernt bleibt von der Offenheit, mit der Wikidata jedem Nutzer erlaubt, Datensätze zu Personen und Werken anzulegen und Q-Nummern zu vergeben.

Die Eröffnungsvorträge der GNDCon folgten aufeinander wie zum Fanal abgestimmt. Harriet Aagaard, die Vertreterin der königlichen Bibliothek Schwedens, Vincent Boulet von der Bibliothéque Nationale de France und Jürgen Kett von der Deutschen Nationalbibliothek mit ihren Verschwisterungen nach Österreich und in die Schweiz verkündeten ihre Entscheidung, Wikidata in Zukunft als Brückenkopf im Informationsaustausch einzubeziehen. Darüber hinaus werde man prüfen, ob nicht Wikibase, die Software von Wikidata, die neue allgemeine Software im Bereich werden könne. Lydia Pintscher führte in Abrundung dieses Fanals in Wikidata ein. Spannung lag im Saal, da diese Weichenstellung verwirrende Unsicherheiten schafft: Wie vermittelt sich diese Entscheidungen der Bibliotheksleiter nach unten? Und: Was genau war hier den Forschern gesagt, die in der GND editieren wollen – dass sie besser gleich in Wikidata Datensätze erzeugten?

Wie Wikidata solches Gewicht gewann

Wikidata, der Startschuss zur Softwareentwicklung fiel erst 2012, begann mit dem Versuch, die Binnenverlinkung zwischen den gut 200 weltweit arbeitenden Wikipedien zu übernehmen – bis dahin hatten Wikipedianer sichergestellt, dass man über die „Interwiki-Links“ korrekt in Parallelartikel der anderen Sprachen gelenkt wurde. Wikidata weiß aus dieser Datenübernahme, in welchen Sprachen es einen „Thomas Mann“-Wikipedia-Artikel gibt und trennt die Artikel zum Lübecker Autor dabei mühelos von den Artikeln zu den anderen Namensträgern in allen Sprachen. Das allein wäre keine Revolution. Die kam mit der Entscheidung, die eigenen Identifikationen im nächsten Schritt mit allen wichtigeren Normdatensätzen weltweit zu verbinden. Wikidata wurde damit unvermerkt das Normdaten Repositorium, das den nationalen (und primär bibliothekarischen) Normdatenprojekten zueinander hilft: BNF-Mitarbeiter schlagen in Wikidata nach, welche GND-Datensätze den in der BNF identifizierten entsprechen. Doch wäre auch das vermutlich nur ein praktisches kleines Geschenk gewesen, wäre Wikidata nicht in jedem Moment dabei ganz anders aufgestellt gewesen: Wikidata kennt nicht nur alle Personen, die in irgendeiner Wikipedia einen Artikel haben, und kann dabei sagen, wo sich zwei Artikel auf dieselbe Person beziehen. Wikidata hat daneben auch Normdatensätze für Apfelsorten, Tische, Stühle und Bänke, ob namhafte Einzelstücke oder den Apfel, den Stuhl, den Tisch als solchem. Die Aussagen, die Wikidata in den Datensätzen macht, sind struktureller Natur: Wikidata erfasst (wie die DNB), dass Heinrich Mann Thomas Manns Bruder war. Anders als die GND-Datenbank weiß Wikidata jedoch zudem, sofern Wissen struktureller Natur ist, nicht nur nebenbei, was „Bruder“ auf Chinesisch oder Koreanisch heißt. „Bruder“, „Vater“, „Mutter“… sind in Wikidata selbst wieder Objekte mit Q-Nummern und mit Aussagen durch P-Nummern, die nun klären, was einen „Vater“ von einem „Bruder“ und einer „Mutter“ im Geflecht struktureller Aussagen zu nun Generation und Geschlecht unterscheidet – und hier wird im nächsten Zug wieder mit Q-Nummern und P-Aussagen definiert.

Die Normdatensätze der Bibliotheken sind, verglichen mit diesen Projekt, eng in ihrer vornehmlich nationalen Orientierung wie ihren Relevanzkriterien, die darauf abzielen, primär Autoren zu identifizieren und Schlagwortkataloge zu beliefern. Auf die Enzyklopädie aller Begriffe und Diskussionsgegenstände in allen Sprachen hatte es keine der Nationalbibliotheken abgesehen – Wikidata dagegen entspringt dieser globalen Enzyklopädie.

Wikibase: Eine Datenbank-Software für jedermann, die typische Bibliothekssoftware überraschend schlägt

Ich begriff am Vormittag des zweiten Tags klarer, warum man in der Deutschen Nationalbibliothek und eben nicht nur hier soeben über Wikibase nachdenkt. Interessierten war im Keller der Nationalbibliothek Zugriff auf eine Datenbankdoublette der GND eingeräumt.

Für den, der in Wikibase bereits Datensätze anlegte, ist die Software ein Schritt zurück in die 1990er Jahre: Die Benutzeroberfläche verlangt Einarbeitung. Jede Zeile eines Datensatzes eröffnet mit einer Nummer, der Ankündigung der nachfolgenden Aussage für den späteren Katalogeintrag. Hinter jeder Nummer muss Information in einer sehr speziellen Sprache abgelegt werden, um nachher korrekt ausgelesen zu werden. Man öffnet die begleitende Dokumentation im zweiten Browserfenster, sieht nach, welche Nummern etwa in einem Personendatensatz verwendet werden könnten und wie dabei die Eingabe zu geschehen hat – hier werden nicht Q-Nummern miteinander verbunden, hier wird vergleichsweise oft Text standardisiert eingegeben. Die Software arbeitet flach: Speichert man ab, wird der bisherige Datensatz überschrieben. Wikibase notiert dagegen, welche einzelne Aussage im Datensatz geändert oder hinzugefügt wurde und bietet Raum für Quellenangaben im Plural hinter jedem beliebigen Statement eines jeden Datensatzes. Die GND-Software ist zufrieden mit einer einzigen Quellenangabe für den ganzen Datensatz – und selbst die fehlt, wo immer man Daten aus vorhandenen Bibliotheksrepositorien übernahm.

Große Entscheidungen muss auch die DNB fällen und vorher diskutieren – die Diskussionen bleiben intern und außerhalb des Systems, wo in Wikidata ganz wie in den Wikipedien über alles öffentlich beraten, wenn nicht gestritten wird, was nachher Richtungsänderungen mit sich bringt.

Braucht man die Wikipedia-Öffentlichkeit in nationalen Bibliotheken? Und ist die Versionsverliebtheit der Wikibase-Software mit ihren Bearbeiterstempeln und Datierungen wie ihren „undo“-Aufforderungen mehr als eine nutzlose Anschwellung der Datenbank, die sich besser darauf konzentrierte, Fakten zu präsentieren?

Aus Sicht des Historikers ist die Antwort klar: Was heute erst einmal nach unnütz viel mehr Daten anmutet, wird in fünf Jahren von Laptops geleistet; und natürlich braucht man die Versionierung und die Quellen zu jedem einzelnen Statement. Es genügt nicht, irgendein Geburtsdatum zu kennen. Man sollte sagen können, woher dieses Datum bezogen ist. Und bei interessanten größeren Entscheidungen würde man gerne wissen, auf welcher Argumentation sie zustande kamen, um diese entweder übernehmen oder die Revision diskutieren zu können.

Die Autorität des Monopols

Die Autorität der nationalen Normdatenanbieter war bislang primär institutionell gewährleistet. Die deutsche Nationalbibliothek bietet das Geburtsdatum des Autors der Buddenbrooks, das jede Bibliothek übernehmen kann, weil eine Änderung (wenn sie denn unter einem neuen Befund nötig würde) eben der Nationalbibliothek gemeldet würde, um von hier aus in den vielen Katalogen zu erscheinen.

Den Scan der Geburtsurkunde benötigt die DNB dabei nicht. Wikidata würde ihn benötigen, die Datenbank, in der jeder Dahergelaufene Unsinn behaupten könnte, und die erst mit einem öffentlichen Quellenbeleg eine korrekte Information durchsetzen kann. Wikibase bietet die Nachweis-Aufforderung bis hin zur Option, einander widersprechende Daten mit den jeweiligen Quellen als genau solche divergierenden Daten verwalten zu können – eine extrem attraktive Option, da wir in der Datenüberlieferung oft nicht mehr haben, als einander widersprechende Quellen.

Eine neue GND-Software wird mindestens so leistungsfähig sein müssen wie Wikibase gegenwärtig ist. Sie wird in der Lage sein müssen, Nummern mehrsprachig zu belegen. Sie wird Edits einzeln versionieren können, um in Datensätzen jede einzelne Stellungnahme überprüfbar zu machen. Sie wird den Quellennachweis zu jeder Aussage einfordern und der Öffentlichkeit Einblick in Entscheidung gewähren, um mehr Sicherheit als Wikidata zu geben.

Wikibase ist frei lizenziert. Theoretisch könnte man die Software wohl so umprogrammieren, dass sie danach wesentliche Hierarchien in Bearbeitungsrechten aufweist, wie intransparente, „rein interne“ gegenüber öffentlich sichtbaren Bereichen. Praktisch wird der Schritt in Wikibase viel einfacher sein, wenn es gelingt, Instanzen in Kommunikation miteinander zu bringen. Man wird dann von der Nationalbibliothek aus mehrere Instanzen betreiben – öffentliche und weniger öffentliche und zwischen diesen die Richtungen im fortlaufenden Datenfluss autoritativ festlegen.

Dass Wikibase-Instanzen sich untereinander austauschen können, das Projekt von „Federated Wikibase Instances“, steht unabhängig davon in den Wikimedia Entwicklungsplänen.

Einigten die zentralen Normdatenanbieter sich global auf Softwarestandards, wäre man einen immensen Schritt weiter im Streben nach neuer Eindeutigkeit im weltweiten Datenaustausch. Gemeinsam mit Wikidata würden die alten Bibliotheken wieder Sicherheiten von Aussagen ins Netz bringen, härtere Aussagen als die der fuzzy Google searches, an die wir uns gewöhnten.

Und die Forschung?

In der GND zu editieren ist unter den gegenwärtigen Bedingungen für Forschungsprojekte nur bedingt attraktiv. Die Software ist unbefriedigend, doch natürlich wäre man gerne als Lieferant und Bezieher von GND-Nummern mit dabei, falls diese nicht soeben rapide an Wert verlieren. Im Moment sticht die GND – sobald man auf die nationale Ebene geht – Wikidata noch in der puren Quantität der Daten in den Kerngebieten aus; ein Rechenexempel aus Gothas Illuminaten-Projekt kann das verdeutlichen:

Zahl der nachgewiesenen Mitglieder im Illuminatenorden 1354 100%
Zahl der nachgewiesenen Illuminaten mit GND-Nummern 553 41%
Zahl der nachgewiesenen Illuminaten mit Wikidata-Nummern 191 14%

Die GND erfasst mehr historische Personen. Dass sie Studenten mit einer bibliotheksnotierten Dissertation beim Namen nennt, macht sie bei den Illuminaten überlegen; diese rekrutierten vornehmlich Studenten mit guten Karriereprognosen.

Im Zeitalter des freien Datenflusses hat ein solcher Vorsprung sein Verfallsdatum. Wikidata könnte die gesamte GND-Personenliste importieren (man mag ob der Doubletten, die man sich einhandeln würde, wie der fehlenden Vernetzung der Datensätze, vor einem solchen Import zurückschrecken). Die Masse Wikidata-nummerierter Personen bleibt im Gegenzug für die GND so uninteressant wie chinesische Lokalpolitiker, die Artikel in der Wikipedia ihrer Sprache haben. Die Überlegung lässt erahnen, von wo nach wo der Informationsfluss verlaufen wird: von den feinmaschigen vielen nationalen Datenbanken hin zu Wikidata.

Die Frage der „Relevanzkriterien“, die es bei der GND und weniger hart bei Wikidata gibt, ist am Ende die Frage, die für ganz eigene Forschungsplattformen spricht, denn die Forschung benötigt in letzter Konsequenz gänzlich offene Plattformen, auf denen man Datensätze bereits anlegen kann, wenn man erst noch sehen muss, ob sich mehr Dokumente zum Namen finden, über den man soeben stolperte. Ein Forschungsprojekt zum Bevölkerungsaufbau in frühneuzeitlichen Städten wird Datensätze für Säuglinge anlegen, die in den ersten zwei Lebensjahren verstarben – eine Erlaubnis, solche Personen einfügen zu dürfen, wird ein solches Forschungsprojekt von niemandem erbitten wollen. Was in der Forschung „relevant“ ist, darauf wetten Projekte kompetitiv in einer Zukunftsprognose: Was wichtige Forschung und damit relevante Information ist, das stellt sich dann heraus, wenn die Zitate der Arbeit beginnen und die Daten-Nutzung in Gang kommt, so die Spekulation jedes einzelnen Projekts.

Es ist dies der Grund, warum eine unabhängige Wikibase-Instanz mit den GND-Daten für die deutschsprachige Forschung so besonders spannend wäre – eine Plattform, die danach Schrittweise Datensätze anderer Nationen aufnähme.

Die große Kulturrevolution steht am Ende weniger für die GND oder Wikidata an, als für die Geisteswissenschaften, für deren bedeutendste Repräsentanten das Internet im Moment noch immer nicht viel mehr als ein grandioser Selbstbedienungsladen ist. Hier stellen, so die professorale Sicht, Großkonzerne wie Google gemeinsam mit Bibliotheken Hunderttausende von Büchern ins Netz, und hier schreiben fleißige namenlose Bienchen Wikipedia-Artikel, aus denen man mit copy & paste Informationen schnell mal eben beziehen kann, verblüffend verlässlich. Man selbst schreibt ein großes Buch und erwartet im Gegenzug mit dem Selbstverständnis des wissenschaftlich Publizierenden, dass die Leute aus dem Internet die eigene Arbeit geflissentlich beachten und noch aus den Fußnoten, die man setzte, die biographischen Richtigstellungen beziehen und korrekt in die Kataloge und Wikipedia-Artikel bringen. (Empört ist man, wenn die eigene Arbeit dabei nicht ordnungsgemäß zitiert wird; enttäuscht, wenn sie von denen im Internet unbeachtet bleibt.)

Die GND wird in der Transformation der Geisteswissenschaften, die hier noch immer ansteht, den interessantesten Impuls geben, wenn sie ihre Haltung zu den Wissenschaftlern wie zur eigenen Arbeit ändert. Es wird nötig werden, dass Wissenschaftler die Datenlage, die sie nutzen, unter der laufenden Arbeit in gesellschaftlicher Verantwortung in Stand halten – offen proklamiert. Sie benötigen dazu Plattformen, auf denen sie auch marginale Korrekturen von Daten noch als Forschungsbeiträge verbuchen können – sie ziehen es andernfalls vor, den persönlichen Wissensvorsprung auf dem privaten Rechner in Word-Dateien für sich und gegenüber den Kollegen zu behaupten, die ihre eigenen Word-Dateien mit bahnbrechenden Informationen für sich sorgsam hüten.

Die GND und Wikidata sind gegenwärtig in der einmaligen Lage, die Plattformen zur Verfügung stellen zu können, auf denen sich in Zukunft Wissen diskursiv – durch das Angebot des Belegs und der nachvollziehbaren Forschung – von der Flut der haltlosen bleibenden Behauptungen abgrenzt. Der Aufbau der neuen überlegenen, weil zitierbaren Ressourcen ist dabei derzeit noch gar nicht als Zentrum der Verantwortung der Geisteswissenschaften für das Wissen unserer Gesellschaften (wieder) in den Blick genommen.

Mehr Links

Der Gotha Zettelkasten – Wir vergeben Accounts

In den letzten Wochen gaben wir am Forschungszentrum Gotha mehrere – einander überlappende – Datensätze ins FactGrid ein. Unser Ziel ist es, die Grundlage für einen kollektiven großen Zettelkasten zu schaffen. Sein Gegenstand: das historische Gotha.

Gotha 1850, nach Abtragung der Stadtmauern

Der Gotha Zettelkasten soll

  • Informationen zu allen möglichen Objekten der Stadt erfassen: zu Häusern, Denkmälern, ja noch zu Bäumen
  • Informationen zu allen uns bekannt werdenden Personen bieten – ob berühmte Bürger oder Kinder, die noch kurz nach der Geburt unter der hohen Kindersterblichkeit der Frühen Neuzeit starben
  • Informationen zu Archivalien mit Datenbankobjekten verknüpfen – ob öffentlich verfügbaren Dokumenten oder privaten, die bei uns in Reproduktionen zugänglich gemacht werden können
  • Informationen zu Ereignissen anbieten, die hier als eigene Gegenstände des Interesses mit Wissen über die Orte, die beteiligten Personen und die vorliegenden Dokumente verknüpft werden

Was bieten wir im Moment?

Manches ist bereits ziemlich unüberschaubar. Das folgende Link bietet (blauen Knopf drücken) alle Personen, die in Gotha (zeitweilig) ortsansässig waren:

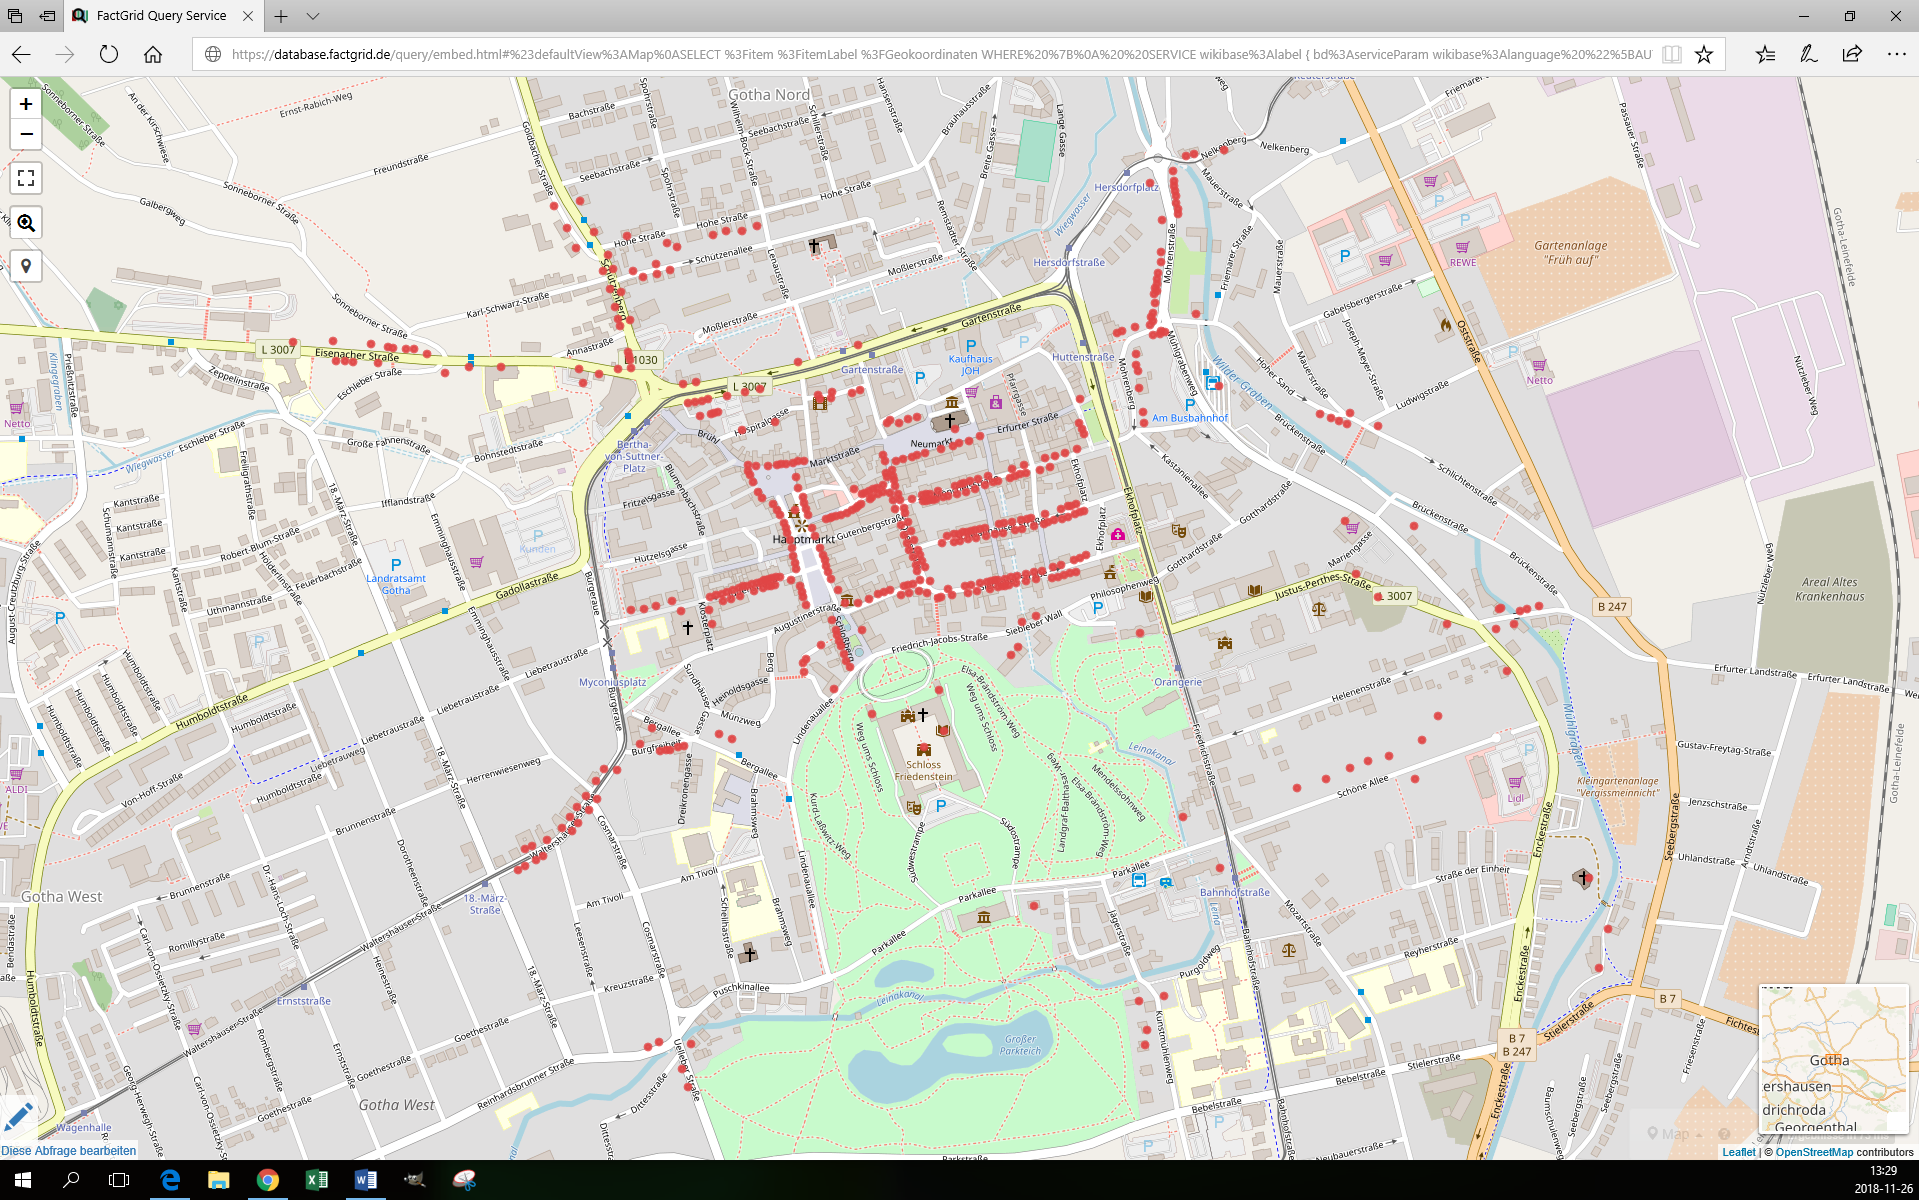
Vieles andere ist im Moment noch sehr gewöhnungsbedürftig: Die Datenbank kennt alle Adressen Gothas vor 1859. Viele von ihnen tauchen jetzt in der Suche auf der aktuellen Landkarte auf (wir wollen im Verlauf historische Landkarten verfügbar machen, auf denen man recherchieren kann). Mit dem folgenden Link kann man sich die gegenwärtig georeferenzierten Adressen auf der Landkarte anzeigen lassen:

 
…ist der Stadtplan auch noch unvollständig, weil die heutige Karte schlecht mit den alten Adressen zusammengeht, so bekommt man mit der tabellarischen Suche die gesamte Liste der Adressen vor 1859. Zu Beginn steht jeweils das Link in den Datensatz, unter dem man die früheren Namen der Adresse findet:

(um die Suchanfrage zu bearbeiten, Link links unten anklicken)

Für das Jahr 1848 können wir zudem alle männlichen, damals als Wahlmänner ausgeschriebenen, Erwachsenen nennen und den Häusern zuordnen. Wir wissen damit grob, welche Familien in welchen Häusern beieinander wohnten, wir kennen zudem die Berufe der Hausväter. Leider kennen wir damit noch lange nicht die Familien selbst: die Frauen und Kinder, die Eltern und Großeltern und mit diesen die Verwandtschaftsbeziehungen in der Stadt.

Hier vier Blicke in einzelne Häuser:

Dürftig ist zur Zeit unser Dokumentenvorrat – das Illuminatenprojekt (dessen Bestände in derselben Datenbank liegen) führt in die 1780er Jahre und berührt Gothas Stadtgeschichte und Bevölkerung nur hier und da.

Was wollen wir möglich machen?

Das FactGrid ist eine Wikibase-Datenbank. In gewisser Hinsicht kann sie alles, was Wikipedia kann: Man kann mit ihr beliebige Informationen auf Seiten zusammenstellen und die Informationen verlinken. Anders als in Wikipedia werden hier jedoch keine Artikel geschrieben, sondern Aussagen gesammelt: Wer war der Vater, wer die Mutter, wer die Ehefrau, wer die Kinder. Wann, wo geboren? Wann wo gestorben? Welchen Beruf? Welche Dokumente? Wann wo gewohnt? Wann wechselte dieses Haus den Besitzer? Wann wurde es abgerissen und neugebaut? Welche Namen trug es? Wo genau stand es auf der Landkarte?

Man kann ebenso gut Aussagen zu Dokumenten machen: In welcher Akte liegt das Dokument? Von wann ist es? Welche Personen sind genannt?

Anders als in Wikipedia wird es bei uns keine Debatte darüber geben, ob eine Person oder ein Dokument einen Wikipedia-Artikel „wert“ ist. Das Kind, das im Jahr 1784 zweijährig verstarb und von dem wir nur wissen, wer die Eltern waren, wie es hieß, wann es geboren wurde – ist mit all diesen Informationen einen Datenbankeintrag wert. Wir können im selben Moment sagen, wie viele Kinder Frauen im 18. Jahrhundert gebaren und wie viele davon nur überlebten. Uns interessieren Familienbilder, private Briefe, Tagebücher von Ur-Ur-Urgroßeltern, sollten sie noch irgendwo auf einem Dachboden liegen.

Wie kann man mitmachen?

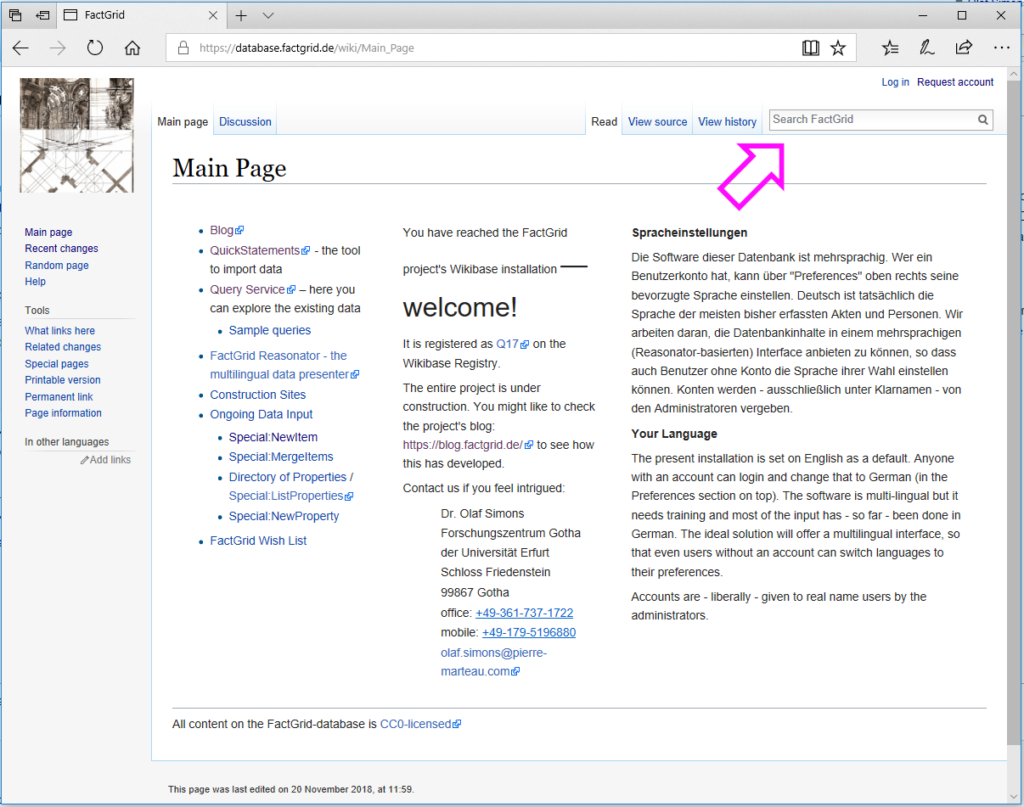
Die Datenbank ist offen sichtbar – was drin ist, kann sich jeder Besucher im Internet zeigen lassen. Im Moment ist das noch etwas holprig, da uns eine bessere Benutzeroberfläche fehlt. Man kann bereits jetzt wie in Wikipedia suchen (über das Suchfeld oben rechts).

Link in die FactGrid Datenbank

 
Daneben gibt es für Suchende mit besseren Computerkenntnissen die SPARQL Suche und eine Seite mit ersten Muster-Suchanfragen – eine reguläre Suchmaske ersetzt das nicht; sie muss kommen.

Wer sich von uns einen Account eröffnen lässt, kann sofort sehr viel mehr tun: Mit dem Account lässt sich die Benutzersprache auf Deutsch umstellen und, eingeloggt, kann man nun Änderungen an den Datensätzen vornehmen oder neue Datenblätter zu Personen der eigenen Familie anlegen wie zu Dokumenten aus dem eigenen Familienarchiv. Freuen würden wir uns, wenn sich hier eine Community bilden würde, die beim großen Puzzlespiel zusammenarbeitet und die sich mit unterschiedlichen Fähigkeiten ergänzt: Wer kann deutsche Handschrift lesen? Wer kann aus der Datenbank mit kleinen Programmierkenntnissen sehr viel mehr herausholen? – denn manches wird hier erst einmal ungewohnt sein: Man möchte bei einer Person einfach hinschreiben, wer der Vater war, doch will die Datenbank erst einmal, dass dieser Vater seine eigenen Q-Nummer hat, mit der sie dann gerne alle Verbindungen herstellen will. Wir helfen bei allen technischen Hürden online weiter.

Um den Start einfacher zu machen, gaben wir für die Mitte des 19. Jahrhunderts alle gut 1300 damals notierten Häuser ein und verteilten auf diese die gut 2400 bekannte Familienväter aus der Wahlliste des Jahres 1848. An diese ersten Datensätzen kann man nun leichter Steine anfügen im großen Puzzlespiel der historischen Stadt-Daten.

Für wen ist das spannend und warum soll man hier mitmachen?

Spannend ist die Datenbank für jeden, der zu Gotha privat oder beruflich forscht. Spannend ist sie aber auch für jeden, der seine Familiengeschichte oder die Geschichte seines Hauses hier zurückverfolgen will. Spannend sollte die Datenbank für Schulprojekte werden, die sich mit der Geschichte der Stadt oder des Territoriums auseinandersetzen – wir geben gerne ganze Recherchethemen, bei denen man in Projektarbeit über Akten und Geschichte und Informatik schlauer wird.

Der “Gotha Zettelkasten” sollte im Verlauf eine Ressource werden, um kollektiv Wissen sammeln und gemeinsam zu sortieren. Er sollte im selben Moment Menschen einander näherbringen, die hier ihr persönliches Wissen zu Gotha und seinen Bewohnern zusammenbringen.

Kontakt:

Via Facebook: Öffentliche Facebook Gruppe “Der Gotha Zettelkasten”

Am Ort und per E-mail:

Forschungszentrum Gotha der Universität Erfurt
— Dr. Olaf Simons
Schloss Friedenstein
99867 Gotha


Präsentation auf der Gothaer Stadtgeschichte Tagung 2022

2018-11-16/17: Wikibase/Illuminatenorden Data-Mining Workshop: 10 Reisestipendien nach Gotha zu vergeben

[Google translation of this page]

Das Forschungszentrum Gotha veranstaltet jährlich einen „Illuminatenworkshop“ mit dem Ziel, aktuelle Forschung zum Geheimorden der 1770er und 1780er Jahre zu bündeln.

Nachdem wir dieses Jahr in einer Kooperation mit Wikimedia Deutschland gut 5.000 komplexere Sätze von Metadaten zu den Akten des Illuminatenordens in einer Wikibase-Instanz verfügbar machten, möchten wir mit diesem Aufruf Wikidata-Enthusiasten einladen, gemeinsam mit Forschenden einen ersten Blick in diesen Datenschatz hinein zu wagen.

  1. Welche Visualisierungen (Netzwerke, Timelines, geographischen Erfassungen…) lassen sich aus dem Datenmaterial ziehen?
  2. Wie müsste man die Daten strukturieren, um noch ganz andere Forschungsfragen anzugehen?
  3. Wie lässt sich das dieses Datenmaterial am besten mit Volltext-Transkripten von Dokumenten verknüpfen?
  4. Wie kann unser bisheriges konventionelles Wiki – die Gotha Illuminati-Research Base – aus der Datenbank Information beziehen?
  5. Wie modellieren wir Datenobjekte auf einem Kurs, der Informations-Redundanzen vermeidet?
  6. Wie würde man Daten eingeben, um Zeitschnitte (und Repräsentationen auf alten Landkarten) zu bewerkstelligen?
  7. Wie gelingt es uns, unsere Reasonator-Integration klug in Richtung eines mehrsprachigen, Übersichtlichkeit generierenden Informationsangebots zu nutzen?
  8. Wie machen wir unsere Arbeit optimal im Wikidata-Universum nutzbar?

Unser diesjähriger Workshop soll Datenanalyse und Forschung zusammenbringen. Mitspieler, die sich mit SPARQL Datenbankabfragen und Visualisierungen auskennen, wollen wir einladen, mit der Forschung ins Gespräch zu kommen. Wir haben die Daten, die Datenbank und detailliertes Wissen über die die Aktenlage des Illuminatenordens mit seinen gut 1350 Mitgliedern und Tausenden von internen Dokumenten, um das Data-Mining spannend machen –, aber erfassen im Moment kaum, welche Aufschlüsse uns unser eigenes Material in der ganz neuen technischen Erschließung gibt. Wir verfügen über Erfahrung mit unserem bisherigen Arbeitsinstrument, einem konventionellen Wiki, aber erfassen im Moment gerade in Ansätzen, was uns das komplexere Medium der Wikidata-Technologie an hinzukommenden Optionen der praktischen Arbeit liefert.

Wer am wissenschaftlichen Programm im ganzen Umfang teilnehmen will, kann am Freitag den 16. November 2018 ab 9:00 am Forschungszentrum Gotha in unsere Forschungsdiskussionen Einblick nehmen.

Der Data-Mining-Workshop, dem die vorliegende Einladung speziell gilt, wird am Nachmittag Forschende und Wikidata-Kenner zusammenbringen. Die Veranstaltungen werden im Verlauf des Nachmittags getrennt in einen Wikibase Bastel-Workshop und in die Serie der spezifischeren Fachreferate.

Ein gemeinsames Abendessen ist für 19:00 angesetzt. Das Forschungszentrum steht Bastelwütigen indes danach noch die ganze Nacht offen.

Am zweiten Workshop-Tag wollen wir gegen 11:00 die Gruppen wieder zusammenführen, um voneinander zu lernen:

  • Was können Forschende aus der Datenbank gewinnen?
  • Was wünschten sich Datenbankenthusiasten an Forschungsarbeit, um im Data-Mining wesentlich tiefer einsteigen zu können?
  • Wie würde man ein größeres Aktenerschließungsprojekt mit dieser Datenbank am besten organisieren?

Wir können Reisekosten (unter der sich entwickelnden Etatlage sicher aus dem deutschsprachigen Raum), Unterbringung und Tagegelder übernehmen. Teilnahmewünsche sind mit eingehenderen Aussagen zu Arbeitsinteressen bis zum 5. November 2018 zu richten an olaf.simons@piere-marteau.com.


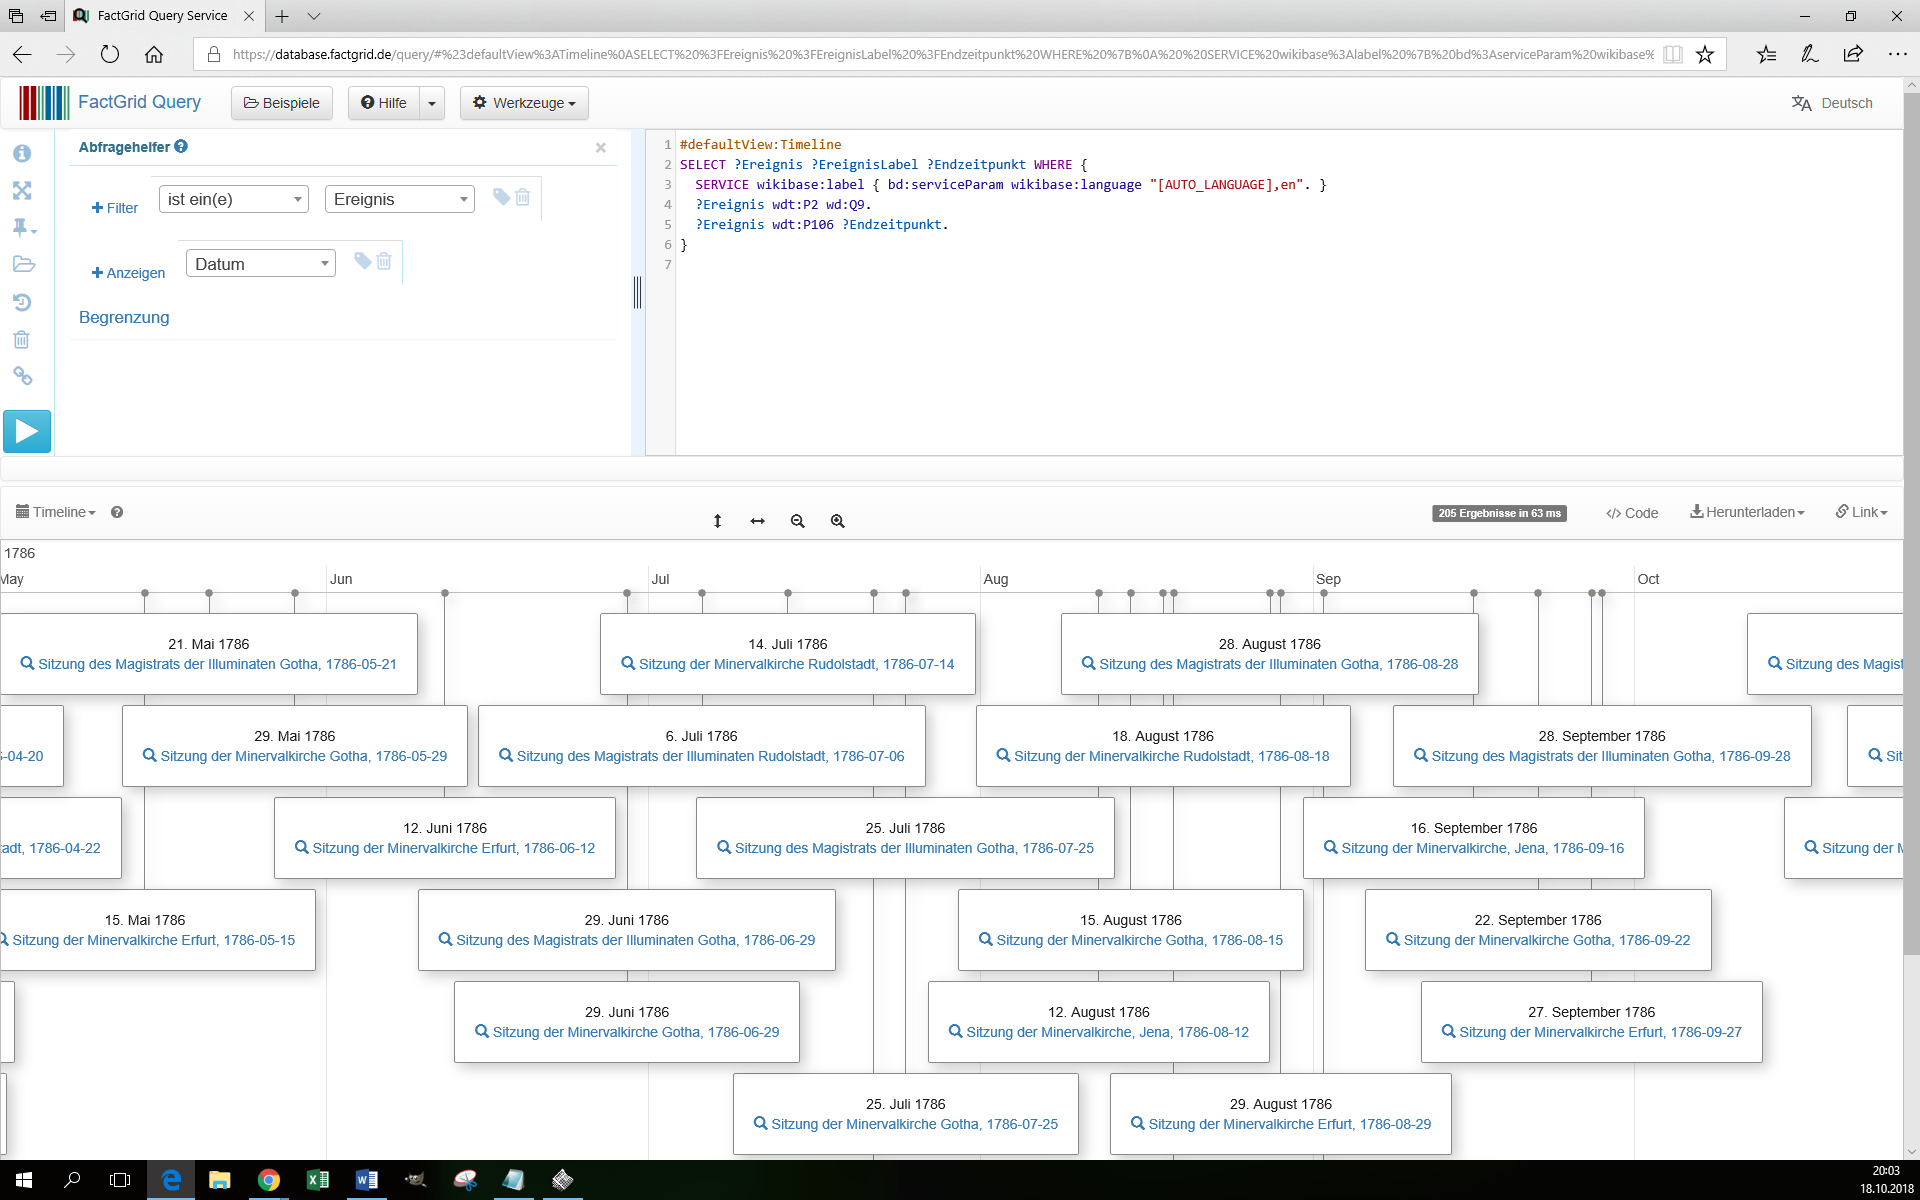
Erste Suchen und Visualisierungen zur Anregung

Sample queries: https://database.factgrid.de/wiki/Sample_queries

Wikidata x ConedaKOR: Ein Anwendungsbeispiel für den Bereich Digitale Kunstgeschichte

in diesem Blog Wikidata erklären zu wollen, würde wahrlich Q1373747 bedeuten. Daher will ich mich hier zu Beginn auf die Punkte beschränken, die mir entscheidend für die Beschäftigung mit Wikidata am Deutschen Forum für Kunstgeschichte Paris (DFK Paris) erscheinen.

Das Potenzial der frei bearbeitbaren, mehrsprachigen Wissensdatenbank Wikidata besteht nicht zuletzt darin, dass es nicht um Deutungen geht, vielmehr ist das Ziel, den Wissensstand zu einem definierten Zeitpunkt belegbar abzubilden. Das Modell von Wikidata weist eine enorme Flexibilität auf, ist entsprechend erweiterbar und die derzeit mehr als 50.000.000 Datensätze[1] stehen unter der CC0 1.0-Lizenz, womit sie frei von urheberrechtlichen und verwandten Schutzrechten sind. Neben der Lesbarkeit für Mensch und Maschine sind an den Objekten zahlreiche Identifikatoren aufgeführt, die in Datenbanken von externen Organisationen verwendet werden und – spätestens hier wird es für die Kunstgeschichte spannend – Wikidata führt mehr Kunstwerke auf, als z.B. die GND.

Ein Framework also, welches diverse Szenarien der Nachnutzung eröffnet – auch jenseits der Verwendung in Wikidata-Schwesterprojekten wie Wikipedia et al. – und vor dessen Hintergrund am DFK Paris der Gedanke aufkam, das oben beschriebene Potenzial für die eigenen Vorhaben zu nutzen.

Ausgangslage

Mit dem quelloffenen ConedaKOR[2] wird im DFK Paris eine graphbasierte Datenbanklösung genutzt, die das in der Fachwissenschaft relevante Beziehungsgeflecht zwischen Werken und ihren Kontexten abzubilden vermag. Die digitale Bildersammlung hat sich hierbei im Laufe der Zeit zu einer Wissensdatenbank und einem Instrument zur Vermittlung kunsthistorischer Kompetenzen weiterentwickelt. Die Software erfüllt in diesem Szenario sehr spezifische Anforderungen der kunsthistorischen Forschung, ohne jedoch als spezifische Anwendung konzipiert zu sein. Das Konzept einer modularen Softwarearchitektur erlaubt es, die Spezialisierung über Konfigurationsmöglichkeiten und einzelne kleinere Dienste zu erreichen. Das Datenmodell ist innerhalb der Applikation frei konfigurier- und erweiterbar, erlaubt sowohl die Kompatibilität mit einer Top-Level-Domäne (CIDOC CRM) als auch die lokale Ausprägung.[3] Ein rollen- und sammlungsbasiertes Rechtemanagement erlaubt hier die – in Verbundprojekten und institutsweiten Anwendungen so kritische – granulare Rechtekontrolle. Diese spezifische Konfiguration, Verwaltung und Betreuung (Datenmodellierung, Objekterschließung usw.) begründen das Bestehen und die Weiterentwicklung dieser lokalen Infrastrukturen als Komplement zu zentralen, generischen Werkzeugen oder Portalen.[4]

Überlegung

Aus der Beobachtung heraus, dass in vielen neu startenden, datenbankgestützten Projekten jedes Mal aufs Neue ein Grundstock bereits vorliegender Informationen angelegt wird (insbesondere Personen, Werke, Orte etc.), kann Wikidata eine Möglichkeit bieten, die begrenzten Ressourcen eines Projekts in die Erschließung neuer Informationen zu investieren. Aus demselben Grund kann sich der Einsatz von Wikidata als externe Datensammlung selbstverständlich auch für das Tagesgeschäft in kunsthistorischen Einrichtungen mit ihren zahlreichen Bilddatenbanken lohnen.
Es geht hierbei aber nicht nur um die einbahnstraßenhafte Nutzung der Daten aus Wikidata, denn die in den Instituten und Projekten erhobenen Informationen können auch wieder in den Wikidata-Bestand hineingeschrieben werden und kommen damit der Allgemeinheit, der Sichtbarkeit und dem Gedanken der Nachnutzung (= Nachhaltigkeit) zugute. Eine in der Tat verführerische Idee, wenn in der Kunstgeschichte nicht das zentrale Objekt der Untersuchung das Bild wäre, welches zugleich Gegenstand einer oft schwierigen Rechtelage ist. Und somit entsteht die Notwendigkeit, zumindest dort ein eigenes Repositorium für die Bilddaten zu betreiben, wo diese aus rechtlichen Gründen nicht gezeigt werden dürfen oder aus forschungsrelevanten Überlegungen heraus (z.B. bei Aufnahmen, die im Projektkontext noch auszuwerten sind) vorerst nicht gezeigt werden sollen. Aus diesem Dilemma heraus wurde daher am DFK Paris ein Workflow entwickelt, der die Verknüpfung lokaler Daten mit Wikidata ermöglicht.[5]

Umsetzung

Um diese angestrebte Kopplung bei größtmöglicher Kompatibilität und zugleich geringem Aufwand (Entwicklung und Anwendung) zu erreichen, wurde bei der Implementerung auf eine Browser-Erweiterung gesetzt. Verfügbar für Firefox und Chrome wird nach der Installation des Add-ons bei jedem Besuch einer Website nachgesehen, ob diese eine Wikidata-ID enthält[6]. Ist das der Fall, dann meldet die Extension, wenn eine korrespondierende Entität in der eigenen Datenbank vorhanden ist[7] und das a) Abbildungen dazu vorliegen, die bereits im Extension-Fenster als Vorschaubild erscheinen und im eigenen Repositorium angezeigt werden können oder b) es noch keine zugehörigen Abbildungen gibt und – falls verfügbar – nun ins eigene System hochgeladen werden können (s. Szenario 01 bzw. 02).

https://www.youtube.com/watch?v=A_lsGmYQF7w

Szenario 1


https://www.youtube.com/watch?v=QhfliHjsM9I

Szenario 2

Damit ist die Nutzung der Datenbasis in Wikidata möglich und die häufig rechtesensible Situation der Abbildungen wird bei diesem Vorgehen weiterhin im System der Nutzer*innen geklärt. Dieser Ablauf ermöglicht, dass neu erarbeitete Informationen, die in Wikidata abgelegt werden können, auch direkt dort hineingeschrieben werden. Damit erhält – wie oben bereits angedeutet – projektspezifisches kunsthistorisches Wissen Sichtbarkeit in Wikidata und kann darüber hinaus entsprechend nachgenutzt werden.

Konkret angewendet wurde dieses Vorgehen im DFK Paris zum Beispiel im Projekt „Wissenschaftliche Bearbeitung des Palais Beauharnais“, wo im Zusammenhang mit der Erstellung einer online recherchierbaren Version des vollständigen Inventars der Möbel, Bronzen, Gemälde und anderer Gegenstände des Palais Beauharnais zahlreiche Entitäten in Wikidata angelegt wurden[8].

Die Browser-Erweiterung ermöglicht aber auch die Übernahme von Wikidata-Inhalten in die eigene Datenbank. Wenn die zugehörige Entität einer entdeckten Wikidata-ID noch nicht im eigenen System vorhanden ist, bietet die Extension eine konfigurierbare Importmöglichkeit an (s. Szenario 03).

https://www.youtube.com/watch?v=lvvTN-6aYXw

Szenario 3

Bei diesem Import wird ferner nachgesehen, ob über Relationen zu verbindende Entitäten bereits in der eigenen Installation vorhanden sind und im positiven Fall werden diese Verbindungen zeitgleich angelegt. Im obigen Beispiel (Szenario 03) werden somit gleich Verknüpfungen zwischen dem Werk („Susanna and the Elders“), der aufbewahrenden Sammlung (Bayerische Staatsgemäldesammlungen) und dem Urheber (Albrecht Altdorfer) erzeugt.

Ausblick

Voraussetzung für das beschriebene Verfahren mit einer Forschungssoftware mit spezifischen Funktionalitäten und einem externen Datenbestand ist selbstverständlich die Bereitschaft, die Daten im Netz, in Wikidata, vorzuhalten, zu ergänzen und nicht mehr primär im eigenen Datenbanksystem. Damit ergeben sich – neben technisch zu berücksichtigenden Aspekten – natürlich Fragen, die u.a. die Redaktionshoheit betreffen. Welche neuen datenkuratorischen Wege sind zu gehen, welche Prozesse ergeben sich, wenn eine größere Gruppe an den Datensätzen mitschreibt? Hier könnte z.B. der in der Wikidata community diskutierte Ansatz der „signed statements“ interessant werden, womit Institutionen ihre Aussagen mit einem Label versehen könnten.[9]

Aber auch generell steht diese Kombination aus Forschungssoftware mit spezifischen Funktionalitäten, sowie einem externen Datenbestand, beispielhaft für eine flexible und wissenschaftsgetriebene Nutzung digitaler Infrastrukturen, deren Services sich bedarfsspezifisch zusammensetzen. Ein derart modularer Aufbau dürfte zukünftig wichtiger werden, als monolithische Virtuelle Forschungsumgebungen. Im Falle von Drittmittelprojekten ist allerdings noch zu diskutieren, wie erarbeitete Daten gegenüber der jeweiligen Förderinstitution klar ausgewiesen werden können, wenn diese Arbeit im großen Ganzen von Wikidata aufgegangen ist?

Sicher ist, dass – neben einem zweckmäßige(re)n Einsatz von Ressourcen – auf diesem Weg eine Reduzierung der isolierten Datenbestände einer Fachdomäne erfolgen kann, wie sie derzeit als Datensilos eben immer noch als (ein) Ergebnis von zeitlich begrenzten Vorhaben zurückbleiben und die Förderung des freien Zugangs zu den Kultur- und Forschungsdaten in maschinenlesbarer und standardisierter Form gestärkt werden kann.

——————————————-

[1] Siehe hierzu: https://www.wikidata.org/wiki/Wikidata:Statistics

[2] ConedaKOR: https://github.com/coneda/kor und https://coneda.net.

[3] Vgl. Sven Peter: Abbildung relationaler Daten auf die Ontologie des CIDOC CRM, 2015, DOI: https://doi.org/10.11588/artdok.00003454.

[4] Der technische Betrieb dieser webbasierten Anwendungen vor Ort erfordert Ressourcen und Kompetenzen, die vielen Projekten und Instituten nicht zur Verfügung stehen. Als Antwort auf dieses Szenario wurde ConedaKOR daher in Kooperation mit DARIAH-DE (https://de.dariah.eu/en/) zu einem „Software-as-a-Service“-Modell weiterentwickelt und steht als erste community-driven Software über DARIAH-DE zur Verfügung.

[5] In der Folge bezieht sich die Darstellung auf eine ConedaKOR-Installation, aber die hier beschriebene Erweiterung ließe sich auch für andere Datenbanksysteme entwickeln.

[6] Die Extension reagiert auf Wikidata-IDs einer Website – die nicht nur auf Wikidata-Seiten vorhanden sein müssen – und somit zum Beispiel auch beim Browsen auf Wikipedia.

[7] Dazu muss eine zugehörige Wikidata-ID im eigenen System abgelegt sein. Alternativ auch andere Identifier, über welche die Wikidata-IDs importiert werden können.

[8] Öffentlich zugängliche Online-Version des Katalogs unter: https://dfk-paris.org/de/WissenschaftlicheBearbeitungdesPalaisBeauharnais/Datenbank.html

[9] https://phabricator.wikimedia.org/T138708

The Illuminati Files Online: Some remarks on the FactGrid’s first – roughly 16,000 – datasets

German Version

The FactGrid (still lacking a unique design) has, over the last six weeks, just received its first project data – data from Halle’s and Gotha’s Illuminati research of the last 20 years, which I will briefly outline in the following. Some of the datasets are still lacking the complexity we are aiming at, others have gained quite some depth:

We are presently listing some 2,000 people, about 1,350 of whom have been Illuminati members in the 1780s; the rest are mostly people mentioned in the correspondences which we are trying to map. We are hesitating here with the far more complex biographical input which he have in store, since this would be better done in joint ventures with the GND and with Katrin Möller, university of Halle, who has become the leading expert on 18th-century careers and professions. We are negotiating in both directions. Our roughly 2,000 titles of research on the Illuminati come in equally rudimentary sets. Again, we have realized that it would be more interesting to base this work on library catalogue norms from the outset.

But we are quite detailed with the more than 9,000 documents currently associated with the original Illuminati: documents that survived with the publications of Illuminati documents by the Bavarian state of 1786 and 1787 and with the archives of Adam Weishaupt, Johann Joachim Christoph Bode, of Gotha’s first lodge “The Compass”, and of Ernest II of Saxony-Gotha-Altenburg.

Some 3,000 of these documents received detailed and complex metadata on our database; they will shed light on Gotha’s Illuminati research of the last five years. Led by Martin Mulsow, Markus Meumann and I have been mapping and analysing Illuminati Essays collected in the “Schwedenkiste”, the famous “Swedish Box”. Our work had started with volume 13 and had soon moved beyond. Junior scholars had joined us with their research. Christian Wirkner dealt excessively with the minutes of the meetings collected in volume 15 and with exemplary strands of “Quibus Licet”/“Reproch” communication which the Order had designed to guide its members. Gotha’s research comes therefore with an emphasis on volumes 11 to 16 of the “Swedish Box”

The Gotha Illuminati Research Base, a conventional MediaWiki which we had set up in order to organise the team’s research became within a year of its existence the pool of ongoing work for the entire (small) community of Illuminati researchers. It attracted the first massive external data inputs: Hermann Schüttler offered us a list of members which he eventually connected with biographies to all our documents. He moved on with a technological relic: an Access database of the research he and Reinhard Markner had conducted for the two volumes of The Illuminati Correspondence (published in 2005 and 2013 respectively). These data are now the deeper layer under the special qid Item: Q11305.

Schüttler provides the following overview of this special database:

1. What is in it? Letters collected by a) Adam Weishaupt now located Hamburg’s State Archive, as deposit of the “United Five” (lodges) Hamburg, and b) the of the “Schwedenkiste”, – collected here by Johann Joachim Christoph Bode and augmented by Ernst II. of Saxony-Gotha-Altenburg, now located in the Prussian Privy State Archives, Berlin (formerly located in State Archive of the GDR, Merseburg). We have added any materials of the Illuminati context from other sources, where we could spot them.
2. Who has been working on this from when to when? The data was collected during the years of the IZEA project between early 2000 and mid-2005 by Hermann Schüttler and have been partially supplemented by Reinhard Markner.
3. Which archives have been visited? Hamburg’s State Archive, the Prussian Privy State Archives, Berlin, the Bavarian Main State Archives, Munich (Weishaupt letters in the “Kasten Schwarz” collection), the Palatine State Library, Speyer (collection Schwanckhardt).
4. Which publications are linked to this? The titles, which are listed under the qid Item: Q11305.

For the first time, the FactGrid can therefore present the tip of the iceberg of the Illuminati files online. Future projects will be able to add to this now that the grid is laid out – but we could also enter a far more dynamic process offering the digitized documents together with the metadata we have here collected. This will only be conceivable in a project for which the Grand Lodges and the archives involved remain to be won.

The creative part of the work can now begin

Compared to the previous MediaWiki, the FactGrid is structurally in one aspect at a disadvantage: The wiki offers transcripts and summaries of hundreds of documents and sessions of the Order (see here what we did with Document 70, Schwedenkiste volume 13 in our conventional Wiki and see here the respective database record: Item:Q6641). It would be exciting to make the transcripts available in the database itself. We will write out two work contracts, on the one hand to bring database information into the conventional wiki – on the other hand to develop a concept of how we could use the FactGrid as our sole repository for data, extended digests, transcripts and media files.

The database is otherwise far superior to the previous MediaWiki: It creates the grid which future research can use while it is opening the door to the data mining that can now begin. One will now be able to map the entire work of the Order between the late 1770s and 1788 (as far as it is still documented). It will be possible to examine membership careers (as soon as we get on with the personal data in greater detail): Who got into the Order on whose proposal? What kind of networking did members unfold within the Order at what stage of its brief existence?

The project will now need groups to bring their own research into the database. It should at the same moment begin to attract “data scientists” and “data visualizers”. And, of course: We are immensely curious about what information others will make visible where we can only offer our gut feelings and sketchy ideas of personal networks that developed in this web. The FactGrid blog will be a good place to present data analytics, which SPARQL enthusiasts can now do far better than the researchers behind the data resource.

More

In alphabetical order: Lorenza Castella, Erik Liebscher, Reinhard Markner, Markus Meumann, Martin Mulsow, Hermann Schüttler, Olaf Simons and Christian Wirkner

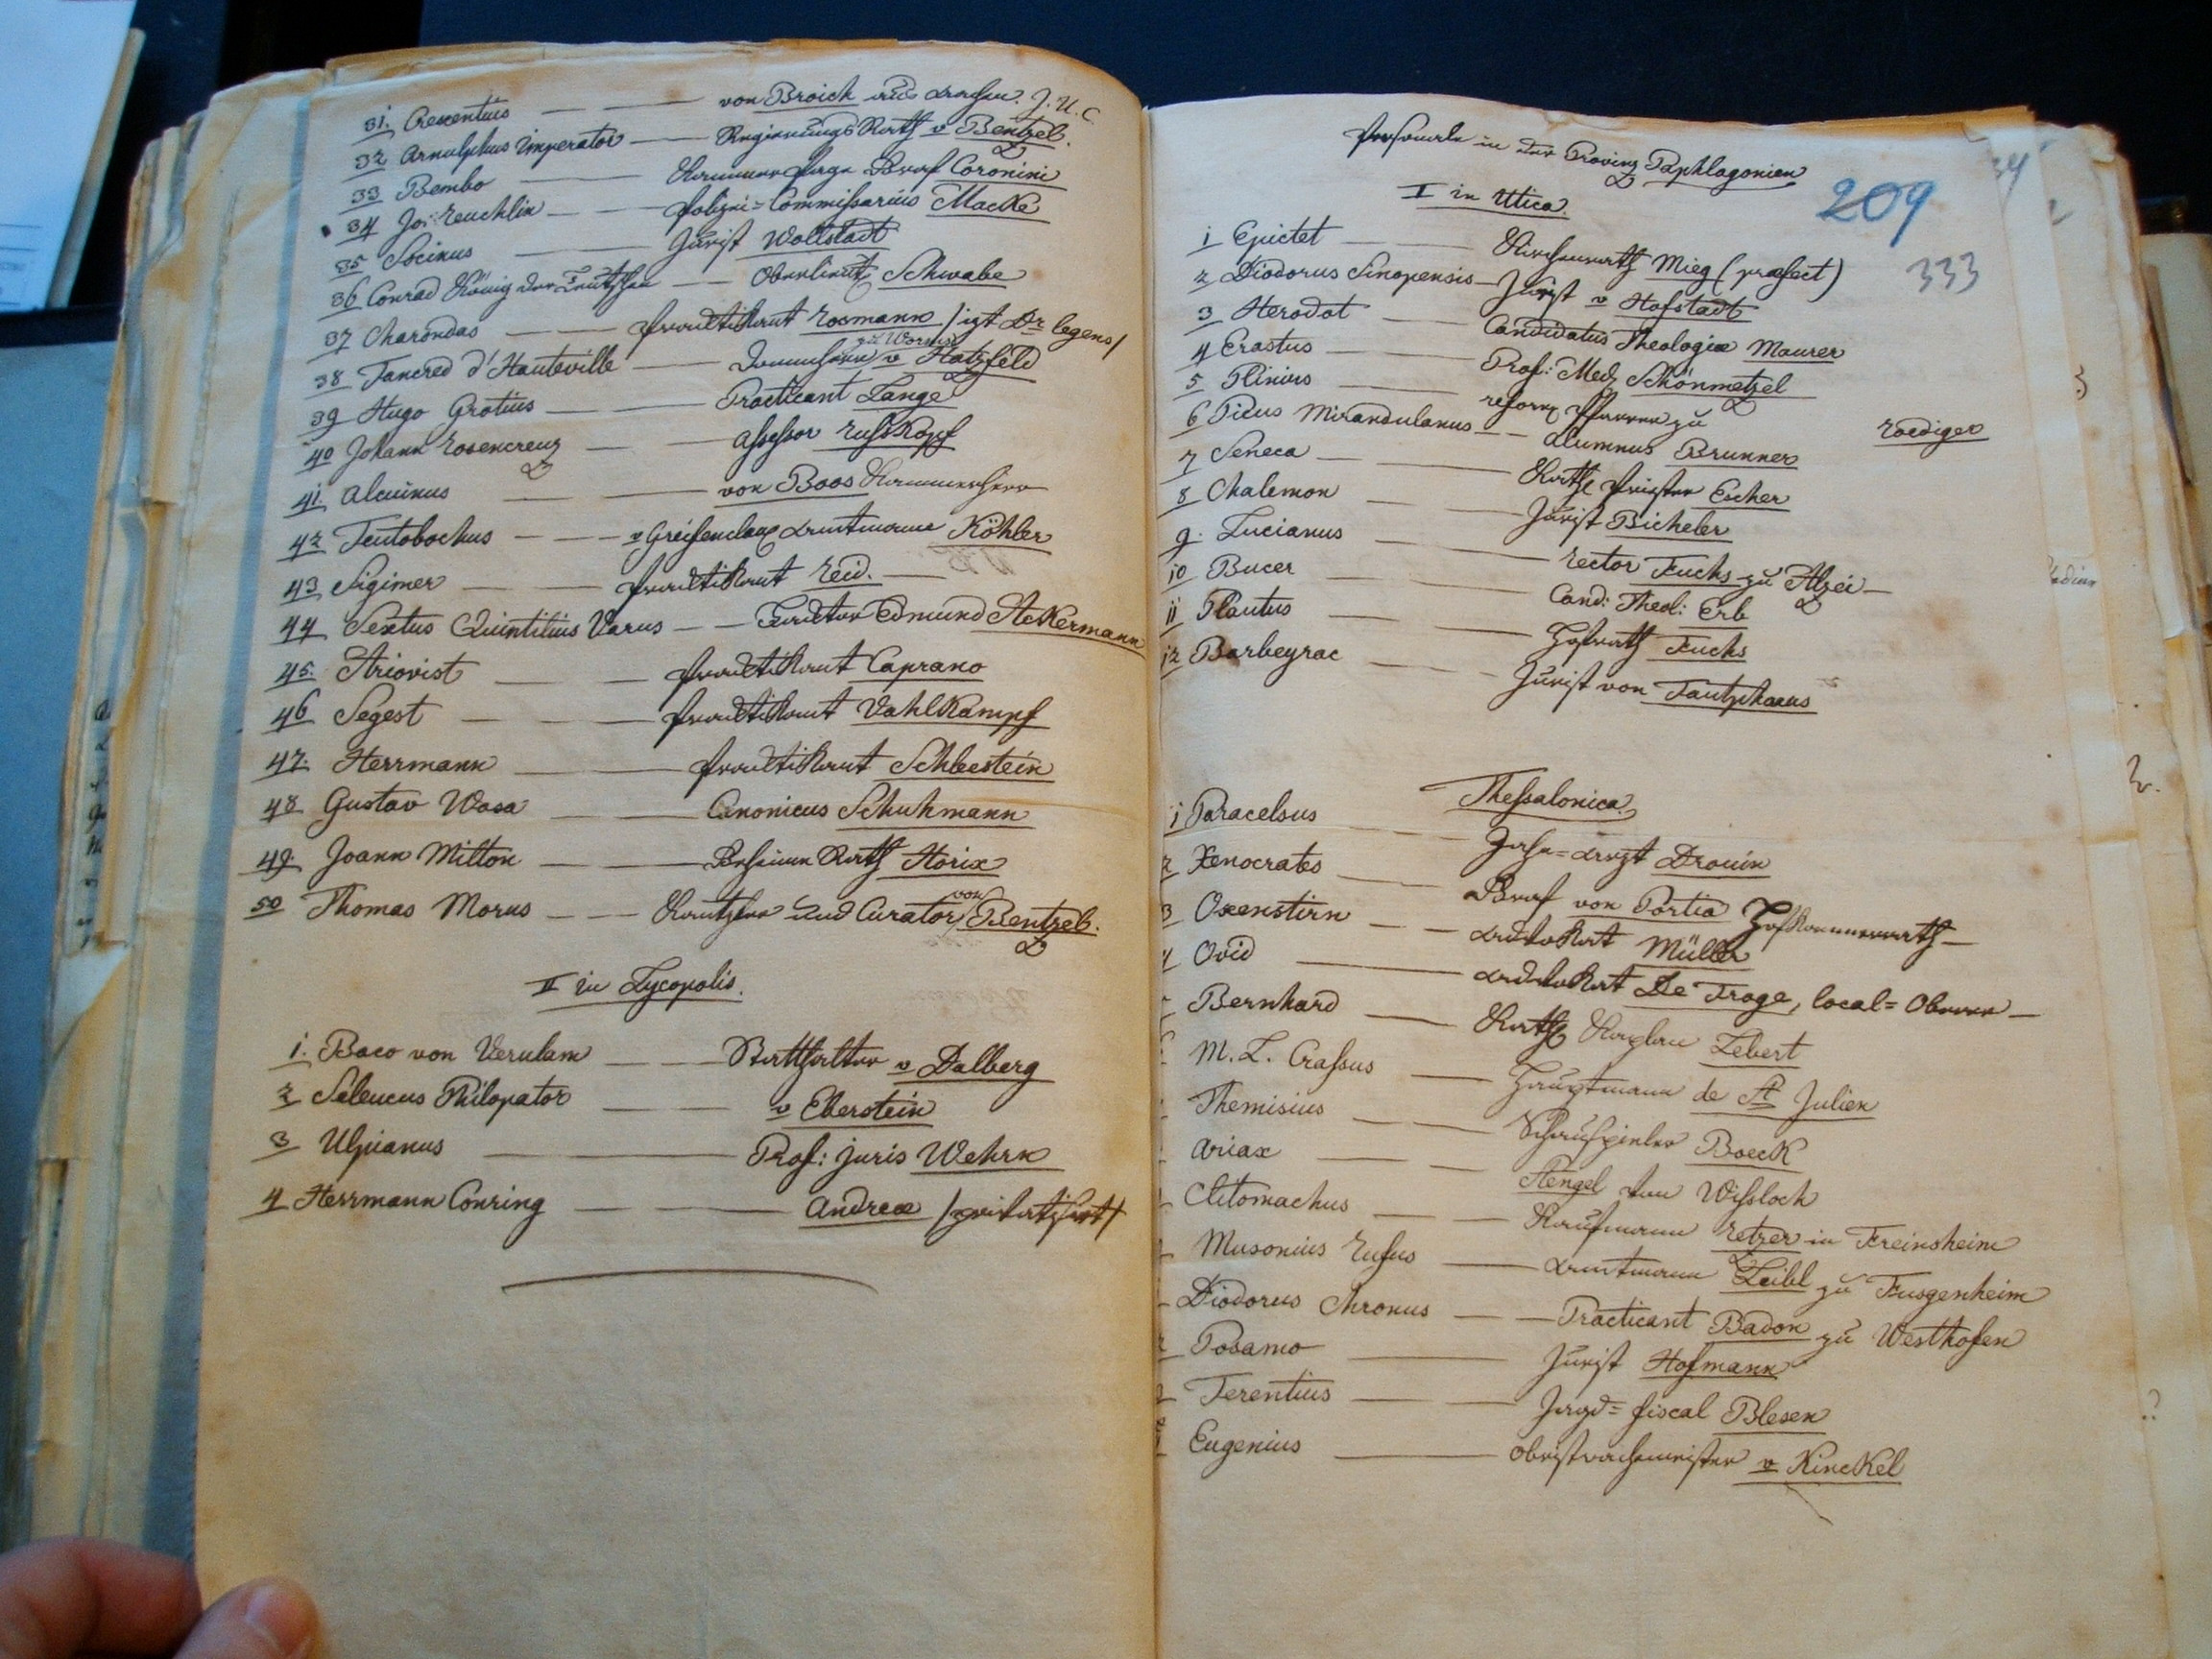
Featured image: Item: Q4545 last page and Item: Q4546 first page: The membership code names used by the Minerval churches of Frankfurt (Epidamnus, continuation from the previous page), Lycopolis (Erfurt), Heidelberg (Uttica) and Thesalonica (Mannheim).

Die Illuminatenakten Online: Einige Bemerkungen zu den ersten knapp 16.000 Datensätzen des FactGrid

in English

Das FactGrid (noch immer ohne ein eigenständiges Design) erhielt in den letzten Wochen seine ersten Projektdaten – Daten aus der Illuminatenforschung Halles und Gothas der letzten 20 Jahre, die hier kurz umrissen seien.

Rudimentär sind in diesem Stadium noch die Datensätze zu den gut 2.000 gelisteten Personen. Etwa 1.350 von ihnen waren Illuminaten, die übrigen zumeist Personen, die von ihnen in Briefen erwähnt wurden. Wir schrecken im Moment vor der Eingabe der uns vorliegenden runderen Datensätze zurück, da sie weit interessanter in einer Kooperation mit der GND und unterstützt durch Katrin Möllers Hallenser Projekt zu Erwerbsbiographien geschähe. Verhandlungen in beide Richtungen laufen. Rudimentär sind im selben Moment auch die gut 2,000 Titel Forschungsliteratur zum Illuminatenorden gelistet. Auch hier wurde uns klar, dass es interessant wäre, diese Arbeit von vornherein an bibliothekarische Katalogsysteme anzulehnen.

Im Zentrum bietet das FactGrid indes nun die gut 9.000 Dokumente, die aktuell in Forschungskreisen mit dem Illuminatenorden und ihren Aktenkonstellationen in Verbindung gebracht werden: Dokumente aus den Nachlässen Adam Weishaupts, Johann Joachim Christoph Bodes, der Gothaer Loge „Zum Compaß“, Ernsts II. von Sachsen-Gotha-Altenburg, sowie der 1786 und 1787 geschehenen Veröffentlichungen aus Bayern.

Etwa 3.000 dieser Dokumente sind sehr viel eingehender erfasst. Sie geben in ihrer obersten Schicht Einblick in Gothas Illuminatenforschung der letzten fünf Jahre: Unter der Projektleitung Martin Mulsows untersuchten Markus Meumann und ich von Nachwuchsforschern unterstützt „Illuminatenaufsätze“, mit ihrem Schwerpunkt im 13. Band der „Schwedenkiste“. Unsere Arbeit griff schnell in die benachbarten Bände aus. Christian Wirkner erschloss dabei in mehreren Schüben die Sitzungsprotokolle sowie einzelne Stränge der Betreuungskorrespondenz zwischen Mitgliedern und den „Unbekannten Oberen“ – den Austausch von „Quibus Licet“ und „Reprochen“. Der Gothaer Schwerpunkt liegt mithin in den Bänden 11 bis 16 der „Schwedenkiste“.

Das von uns aufgebaute „Illuminatenwiki“, die Gotha Illuminati Research Base, wirkte unerwartet in die Forschung hinein. Mit ihm kamen die Datensammlungen Hermann Schüttlers und Reinhard Markners ins Gehege, die bis in das Jahr 1998 zurückgehen. Hermann Schüttler publizierte 1991 das erste Kompendium zu den Mitgliedern des Ordens (und arbeitete diese bereits in die Gotha Illuminati Research Base ein: Die Mitglieder des Illuminatenordens). Gemeinsam mit Reinhard Markner erschloss er ab 2000 in großem Umfang die Ordenskorrespondenz. Eine Access Datenbank kam aus seiner Hand von hier aus in das Startangebot für das FactGrid – im FactGrid regulär mit der qid Item:Q11305 als Forschungsleistung ausgewiesen:

Hermann Schüttler zu diesem Datenbestand:

1. Was ist drin? Briefe vor allem aus a) dem Teilnachlaß von Adam Weishaupt im Staatsarchiv Hamburg, Depositum der „Vereinigten Fünf“ (Logen) Hamburg, sowie b) der „Schwedenkiste“, d.i. dem Nachlaß von Johann Joachim Christoph Bode, vermehrt um Papiere von Ernst II. von Sachsen-Gotha-Altenburg im Staatsarchiv Preußischer Kulturbesitz Berlin, zuvor Staatsarchiv der DDR, Merseburg. Dazu vereinzelt Material mit eindeutig illuminatischem Bezug verschiedenster Provenienz.
2. Wer hat wieviel von wann bis wann daran gearbeitet? Die Daten wurden während der Laufzeit des Projektes im IZEA zwischen Anfang 2000 und Mitte 2005 von Hermann Schüttler erfaßt und danach von Reinhard Markner teilweise ergänzt.
3. Welche Archive wurden besucht? Staatsarchiv der Freien und Hansestadt Hamburg, Geheimes Staatsarchiv Preußischer Kulturbesitz, Berlin, Bayerisches Hauptstaatsarchiv, München (Briefe Weishaupt im Bestand „Kasten Schwarz“), Pfälzische Landesbibliothek, Speyer (Nachlaß Schwanckhardt).
4. Welche Veröffentlichungen knüpfen sich daran? Die Titel, die sich jeweils unter der qid Item:Q11305 zur gesamten hier erbrachten Forschungsleistung gelistet finden.

Das FactGrid kann damit erstmals den Eisberg so halbwegs bemessen und im Projekt der Illuminatenakten Online in den Metadaten vorlegen. Zukünftige Projekte können von hier aus fortfahren. Mit ganz anderer Dynamik ließe sich das große hier angelegte Raster indes füllen, wenn wir mit der Datenbank die Digitalisate aller Dokumente zugänglich machen könnten. Das aber wird nur in einem Projekt denkbar werden, für das die Großlogen und Archive, in deren Eigentum respektive Besitz sich die meisten der Akten heute befinden, noch zu gewinnen bleiben.

Der kreative Part der Arbeit kann damit beginnen

Gegenüber dem bisherigen Wiki ist das FactGrid an einer Stelle strukturell im Nachteil: Das Wiki macht Transkripte und Zusammenfassungen von Hunderten Dokumenten sowie detaillierte Informationen zu Sitzungen des Ordens zugänglich (hier eine Musterseite zu einem Dokument – dem Dokument 70 im 13. Band der Schwedenkiste – im alten Wiki; hier die Datensammlung zum selben Dokument im FactGrid: Item:Q6641). Spannend wäre es, diese Texte und Informationen in der Datenbank selbst verfügbar zu machen. Wir werden zwei Werkverträge ausschreiben, einerseits um das alte Wiki zu entlasten, in dem wir Metadaten großflächig und laufend aktuell aus der Datenbank einspielen. Ein komplementärer Werkvertrag wird der Frage gelten, wie wir das konventionelle Wiki zur Vermeidung doppelter Arbeit im FactGrid (respektive in einer eigens zu gründenden FactGrid Ressource für Objektrepräsentationen) verlustfrei aufgehen lassen könnten (siehe hier die Vorformulierungen zu diesen beiden Werkverträgen).

An einer anderen Stelle ist die Datenbank dem bisherige MediaWiki bei weitem überlegen: Mit ihr ist die verfügbare Materiallage im großen Raster erfasst, in dem sich weiterforschen lässt – und die Tür geöffnet zum Data-Mining. Man wird nun daran gehen können, die gesamte Aktenproduktion kartographisch wie auf Zeitleisten zu erfassen. Man wird (insbesondere sobald die Personeninformationen zu den Berufen detaillierter eingegeben sind) durchleuchten können, wer mit wessen Fürsprachen welche Karrieren im Orden machte und dabei welche Netze des ordensinternen Austauschs generierte.

Gefragt sind damit zum einen Gruppen, die mit eigener Forschung im Feld weitermachen und zum anderen Data-Miner, Datenvisualisierer – und wir sind natürlich gespannt, welche Informationen sie dort sichtbar machen werden, wo wir bislang vor allem Detailinformationen mit dem gröberen Bauchgefühl der Beziehungen im Orden nachgehen. Der FactGrid Blog wird eine gute Adresse sein, um Daten-Analysen vorzulegen, die SPARQL-Begeisterte nun weit besser durchführen können als die Forscher hinter dieser Datenressource.

Mehr

In alphabetischer Reihenfolge: Lorenza Castella, Erik Liebscher, Reinhard Markner, Markus Meumann, Martin Mulsow, Hermann Schüttler, Olaf Simons und Christian Wirkner

Featured Image: Item:Q4545 letzte Seite und Item:Q4546 erste Seite: Die Mitgliederaufschlüsselungen der Minervalkirchen Frankfurt (Epidamnus, Fortsetzung von voriger Seite), Lycopolis (Erfurt), Heidelberg (Uttica) und Thesalonica (Mannheim).

2018-06-11/12: Daten in das FactGrid füllen — praktischer Workshop der Gothaer Forschungsstelle Illuminatenforschung

Liebe Erfurter und Gothaer FactGrid Interessierte,

in den letzten Wochen arbeiteten wir im engeren Kreis an der Einrichtung einer WikiBase-Instanz (der Software hinter dem Wikidata-Projekt) auf dem Server der Uni Erfurt: https://database.factgrid.de/

Es gab einige technische Schwierigkeiten bei der Anpassung der Tools an die neue Server-Umgebung zu bewältigen, doch sind wir seit einigen Tagen soweit, dass die Grundausstattung läuft: QuickStatements steht für den massenweisen Datenimport zur Verfügung. Der Query Service läuft, so dass wir SPARQL-Abfragen von Daten hinkriegen. Das Design (Logo etc.) ist noch offen – was im Moment den Vorteil hat, dass alles wie bei Wikidata aussieht. Matti Blume arbeitet daran, die Datensätze des Illuminatenprojektes für den Projektstart in die Datenbank zu füllen.

Vom Montag den 11. auf Dienstag den 12. Juni 2018 wollen wir gemeinsam mit Matti Blume und Sandra Müllrick am Forschungszentrum Gotha einen Workshop veranstalten, auf dem er praktischen Unterricht in der Befüllung der Datenbank erteilen wird:

  • Wie verändert man einzelne Daten?
  • Wie fügt man über QuickStatements Datenmassen in die Datenbank ein? (Auf dieser Seite ein paar Tutorials: https://factgrid-tools.geschichte.uni-halle.de/blog/archives/811)
  • Wie legt man dazu Properties (Eigenschaften) für Items an?
  • Wie organisieren wir unsere Properties am besten (von dem weit größeren Wikidata-Projekt lernend)?

Projekte, die am Forschungszentrum Gotha und an der Uni-Erfurt im Feld Geschichte und den benachbarten Kulturwissenschaften Datenbankleistung suchen, sind eingeladen, hier praktische Einblicke zu gewinnen. Hilfskräfte, die uns beim Betreuen der Ressource in Zukunft zur Verfügung stehen wollen (und Interesse an den Digital Humanities für die eigene spätere Arbeit haben) betrifft dieselbe Einladung.

Wir werden am Montag einleitend die Software vorstellen und im Austausch mit den Anwesenden ausloten, zu welchen Projekten sie sich eignet. In einem zweiten Arbeitsblock wird es darum gehen, vorbereitete Daten in die Datenbank zu füllen und die Arbeit zu überprüfen. Das wird im Wesentlichen auch das Programm für Dienstag sein, nun mit dem Ziel, Unabhängigkeit bei der Arbeit mit der Datenbank zu gewinnen. Die Uhrzeit für den Beginn der Veranstaltung Montag-Vormittag/Mittag wird im Vorfeld bekannt gegeben.

Die Weitergabe dieser Post an Datenbank-Interessierte ist ausdrücklich erwünscht. Für Voranmeldungen bis zum Mittwoch, den 6. Juni wären wir dankbar, auch für persönliche Notizen zur Hardware: Die Software lässt sich vom Laptop (über Eduroam) bedienen. Wir wollen zusehen, dass wir Computerarbeitsplätze im Forschungszentrum für die Teilnehmer frei halten.

Mit den besten Grüßen,
Olaf Simons

[per e-mail distribuiert]

Zeitplan

Montag, 11. Juni, Pagenhaus des FZG, Seminarraum

(13:15 – 13:40) Olaf Simons: Begrüßung. Kurze Projektgeschichte, eingehenderer Blick auf die Datenblättern aus dem Illuminatenprojekt, die das erste Unterrichtsmaterial geben werden.

(13:45 – 14:15) Sandra Müllrick: Eine kurze Vorstellung von Wikidata und der Wikibase Software. Die Datenbank, die Benutzer editieren können. Versionsgeschichte, Transparenz aller Editiervorgänge über Recent Changes. Triples als Statements. Abfragen über SPARQL, mehrsprachige Datenblätter im Reasonator. Was kann eine Datenbank, was ein reguläres Wiki (wie wir es im Illuminatenprojekt hatten) nicht kann?

(14:25 – 14:45) Praxisteil 1: Wie geht man strategisch vor, wenn man Tabellen aus einem Forschungsprojekt vor sich hat und diese in eine Wikibase Datenbank überführen will? Wie legt man Properties an? Wie behält man Überblick über schon existierende Properties? Wie geht man strategisch vor, wenn man einen solchen Datenberg einarbeiten will?

(15:00 bis zum Erschöpfungsbeginn) Praxisteil 2: Koordinierter Versuch, möglichst viel unserer Daten über QuickStatements in das System zu bringen. Wenn man Tabellenspalten in massenweise Triples überführt – wie legt man die Items an, wie die Properties? (Tutorials unter anderem hier: https://factgrid-tools.geschichte.uni-halle.de/blog/archives/811). Aufgaben für Einzelne oder Zweiergruppen.

Gemeinsames Abendessen

Dienstag, 12. Juni, Pagenhaus des FZG, Seminarraum, respektive Hauptgebäude, Besprechungsraum

(9:00 – 10:30, FZG Hauptgebäude, Besprechungsraum) Planungstreffen: Sandra Müllrick Mitglieder des Forschungszentrums und der Forschungsbibliothek. Projektpläne. Welche Entwicklungen können wir aus eigenen Mitteln finanzieren – wo brauchen wir (etwa bei der Suche von Werkvertragsnehmern) Hilfe von Wikimedia, respektive der Community? Welche Entwicklungen würde Wikimedia gerne anstoßen?

(Parallell 9:00 – 11:00) Praxisteil 3: Fortsetzung von angefangenen Eingaben und individuelle Beratung, insbesondere falls Mitspieler eigene Datensätze in die Datenbank bringen möchten.

(11:15 – 12:00) Praxisteil 4: Wo befinden sich die eingegebenen Daten nun? Was kann man mit ihnen bereits machen? Vielleicht finden wir einige interessante SPARQL-Abfragen.

(12:30 – 13:00) Resümee: Ideen, Desiderate, Pläne.


Google Spreadsheets and Illuminati Project Data

Dataset Google Spreadsheet Content What could be visualised? Web Form to build
Documents produced in the Illuminati Order Mostly Schwedenkiste, Illuminati materials from various archives and those documents that were already published in the late 1780s Network information. Caution: We are operating with fragmented and highly selective data. Describe an archival document
Illuminati members and others A list of the c. 1350 members of the order (including names belonging into the wider context), mostly research (stated in col. AJ) by Hermann Schüttler (2016). — The geographical spread of the Order on the central European map: col. AB to be matched with col. AG
— Already existing Wikidata and GND data sets linked in cols. M and N.
— Age structure of the members col. AC
— Percentage of aristocracy cols. J-L
Write a CV
The order had a complex grade system that created careers within the order, people could also get into different official positions Give information about an Illuminati career
Illuminati Events Mostly protocols of gatherings of “Minerval Churches” under Bode’s supervision. (Missing: Hermann Schüttler’s information about gatherings of the “Minerval Church” in Frankfurt/Main) Give information about a session (as type of an event)
Organisations
Publications  from: Forschungsliteratur

Bildnachweis

Kopfzerbrechen Nr. 6: Dokumente des Illuminatenordens erfassen

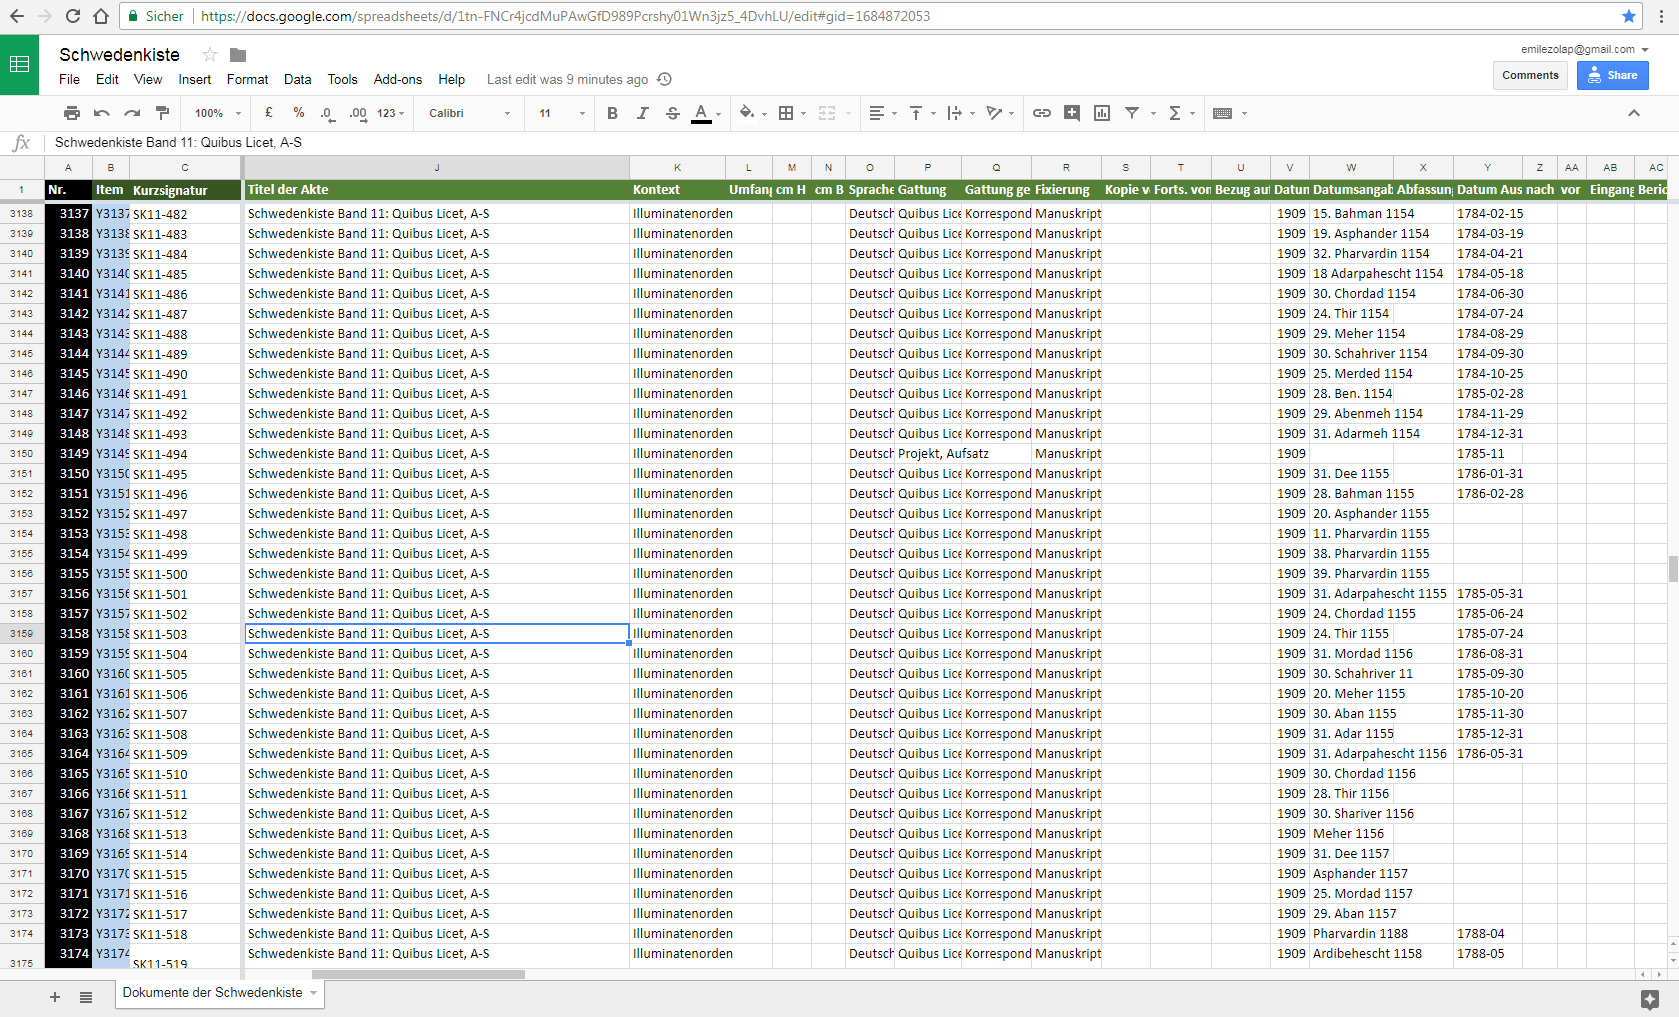
Im Verlauf unserer Arbeit legten wir zur Orientierung innerhalb der Schwedenkiste dieses Spreadsheet an. Jede Zeile (ab 24) ist ein Dokument innerhalb eines der 20 Bände der Schwedenkiste; dem folgen noch einige weitere Dokumente unserer Recherchen.

In der Visualsisierung der Datenbankinformation wird man später zu jedem Dokument eine Seite haben wollen mit Metadaten, Digitalisaten, Transkript, Übersetzung ins Englische.

Die Datenstruktur würde, von unserer Excelliste kommend, übersichtlich diese Felder haben, von denen einige unorthodox sind – der Orden verschlüssele Datums- und Ortsangaben, die Namen von Sendern und Empfängern wurden verschlüsselt, wichtiger noch: Sender schrieben regelmäßig an den Orden, ohne zu erfahren, wer dort ihre Briefe öffnete (das indes wissen wir, nachdem wir die Innenorganisation kennen).

Groberfassung

1. Kurztitel
2. Level: Archivbestand/ Akte/ Dokument/ Abschnitt in einem Dokument [ideal: Pulldownmenü zur Bestimmung der Erfassungsebene]
3. included in (in welchem Archivbestand findet sich die Akte, in welcher Akte das Dokument, in welchem Dokument der Abschnitt der hier erfasst wird?)

3a. dortige Position
3b. Seiten oder Blattangabe
4. Digitalisat online
5. Transkript online
6. Veröffentlichung

6a. Stellenangabe (Seiten von bis)
7. Übersetzung

7a. Stellenangabe (Seiten von bis)
7b. Sprache der notierten Übersetzung
8. Forschung

8a. Stellenangabe (Seiten von bis)

Objektbeschreibung

9. Umfang der Akte, des Dokuments, des Abschnitts (in der Regel eine Seiten- oder Blattzahl)
10. Format [unterschiedliche Angaben denkbar: 2°, 4°, 8°, DIN A…, cm x cm]
11. Manuskript/ Manuskript mit Noten/ Typoskript/ Druck/ Formular (mit Eintragungen)/ Schattenriss/ Zeichnung (mit Text)/ Konvolut
12. Handschrift
13. Sprache

Autor

14. Autor

14a Autor Selbstaussage (“Name vorenthalten, sprich anonym”, Initialen, Pseudonym…)
14b. Verantwortende Insitution
15. Absendeort

15a. Geo Kordinate
15b. Absendeort in seiner unklaren Nennung
16. Absendedatum / Enddatum der Komposition

16a Genauigkeit (ca./ recte/ fraglich)
16b Datierungsangabe laut Dokument
16c Abfassungsbeginn (z.B. bei Tagebüchern oder Briefen, die über Tage hinweg verfasst werden)
16d. terminus post quem (was ist das Datum, nach dem dieses Dokument verfasst sein muss)
16e. terminus ante quem (was ist das Datum vor dem dieses Dokument verfasst sein muss)

Empfänger

17. Empfänger

17a. abweichende Adressierung
17b. adressierte Institution
18. Ort Empfänger

18a. Geokoordinate
19. Eingangsdatum
20. Weitere Rezipienten (besonders wichtig bei den Illuminatenakten, wo man Briefe an den Orden adressiert, auf dass “Unbekannte Obere” sie lesen – die wir wiederum identifizieren können)

Inhalt

21. Textsorte standardisiert [hier muss Auswahl erstellt werden]
21. Textsorte Selbstaussage
22. Titel
23. Inhalt
24. Berichtsgegenstand [FactGrid-Id von Ereignis etwa bei Treffen, Konferenz etc.]

24a. Berichtszeitraum von
24b. Berichtszeitraum bis

Kontext

25. Antwort auf
26. Rezension von/ Gutachten zu
27. Fortsetzung von
28. Dokument ist [Auswahl:] Konzeptschrift zu/ Kopie von/ Reinschrift von/ Zusammenfassung von/ Übersetzung von/ Katalogeintrag zu

28a. Dokument zur vorigen Spalte
29. Bearbeiter/ Übersetzer (Information zur vorvorigen Spalte)
30. Querbezüge
31. Genannte Personen

Provenienzinformation nach Verlust des Objektes oder des Quellennachweises

32: Verlust/ zu recherchieren/ privat
33: Status seit wann
34: Grund (etwa Bombardierung des Archivs – Möglichkeit eines Ereignislinks)
35: Paralellüberlieferung (woher kommen die Informationen, die wir heute über das Dokument haben)

35a: Stellenangabe zu vorigem (Seite Default)

Provenienz bei vorliegendem Dokument

36. Besitzer / Archiv

36a. Geo-Koordinate
37. Besitz von/seit

37a. Besitz bis
38. Bestand
39. Signatur
40. Verzeichnis
41. Zugänglichkeit (öffentlich zugänglich/ eingeschränkt öffentlich zugänglich/ privat/ geheim)
42. Eigentümer
43. Wechsel gegenüber voriger Provenienz [Kauf/ Schenkung/ Leihgabe/ Enteignung/ Aneignung/ Raub]

FactGrid-interne Information

44. Erschließung (Namen derer, die die Erschließungsinformationen lieferten, mit Jahresangaben)
45. Forschungskontexte (hier können Forschungsprojekte Materialcorpora für ihre Recherchen generieren)
46. Template (für eine Darstellung etwa im Article Placeholder)
47. Digitalisat (wichtig, wo wir nicht-öffentliche Bilddateien von unseren Servern benennen)
48. Achtung! (Raum für Bearbeitungsnotizen)

Die zentrale Frage dieses Kopfzerbrechens ist: Wie stimmen wir diese Liste mit bereits bestehenden Wikidata-Feldern ab? Wie erstellen wir hierfür eine Eingabeschablone, die – etwa bei einer Crowd-Erschließung – die richtigen Fragen übersichtlich stellt?

Wie generieren wir aus den Daten im Verlauf ansprechende Seiten zu den Dokumenten, die deren Lektüre zu einer angenehmen Erfahrung macht? Mit welcher Gestaltung würde man Übersetzungen einspielen (die Übersetzung ins Englische ist das größte Desiderat des öffentlichen Austauschs über die Illuminaten). Magnus Manskes Reasonator machte gute Vorschläge was die Gestaltung von Seiten aus Wikidata anbetrifft.

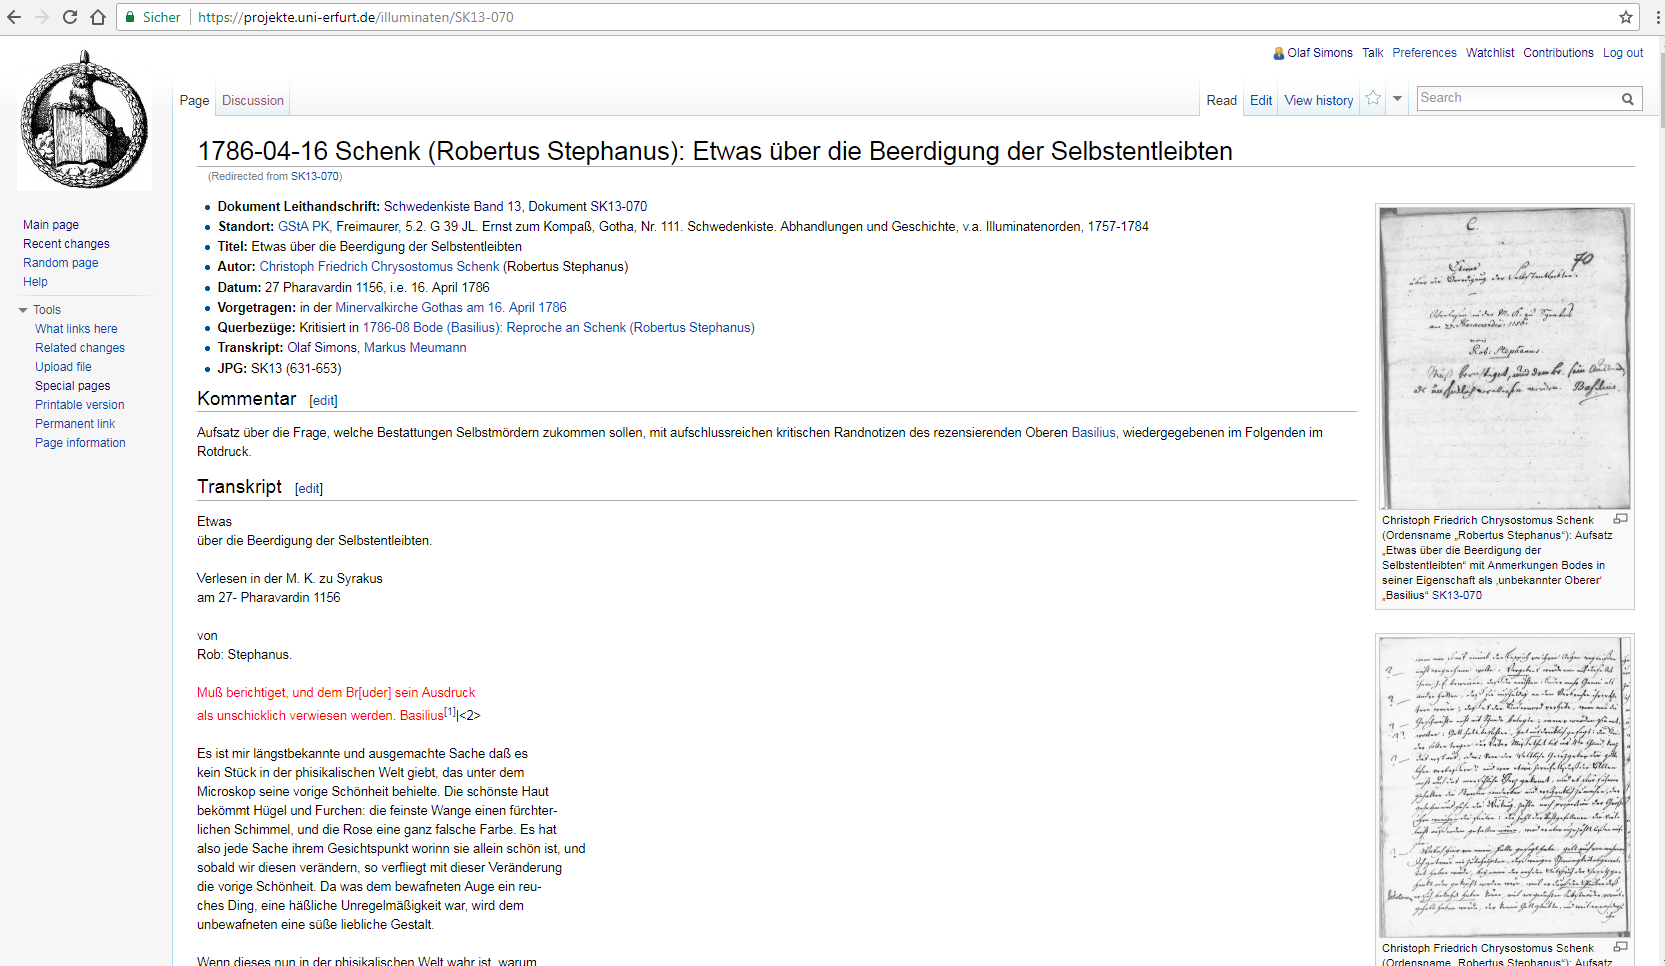
Bisher sehen unsere Seiten zu Dokumenten – unbefriedigend – so aus:

Screenshot SK13-070 https://projekte.uni-erfurt.de/illuminaten/SK13-070

Kopfzerbrechen Nr. 4: Organigramme

In Google Books findet sich eine kleine Serie der Herzoglich-Sachsen-Gotha- und Altenburgischer Hof- und Adreß-Kalender:

Die Serie von 1768 bis 1825: https://digital.slub-dresden.de/werkansicht/dlf/54350/1/ /
https://zs.thulb.uni-jena.de/receive/jportal_jpvolume_00240779

Die Publikationen waren nicht ungewöhnlich. Man entnahm ihnen nach dem kalendarischen Vorspann und den Informationen über die Post-
und Botenverbindungen Überblick über den Aufbau des gesamten Staats und seiner Landeskirche samt den Namen und Posten aller Amts- und Würdenträger bis hinab zu den Angestellten, die der Herrschaft auf dem Schloss aufwarteten.

Netzwerkdarstellungen wurden in den letzten Jahren populär. Sie erlauben es, Knoten in größeren Kommunikationsgefügen auszumachen. Insbesondere informelle offene Korrespondenzgefüge gewinnen hier Transparenz.

Tatsächlich wissen wir aber dank solcher Kalender und vergleichbarerer Publikationen über die Interaktionsgefüge weit mehr. Wir verfügen über Organisationspläne aus staatlichen und kirchlichen Behörden, wir kennen die Gefüge der Armee, größerer Anstalten wie kleinerer Firmen, kennen die Positionen in geheimen und nicht geheimen Gesellschaften, die Gremien und Ausschüsse von Parlamenten und Parteien und so fort.

Eine der interessantesten Leistungen des FactGrids könnte darin liegen, diese Gefüge mit den Personendaten und Archivalien zu erfassen. Hier sind Organisationsstrukturen ausgewiesen samt Titeln, Positionen und den Namen der Amtsinhaber. Wie müsste die Dateneingabe aussehen, um aus ihr Organigramme für jeweils gewünschte Zeitschnitte zu generieren – mit Links zu den Personen und zu Schriftstücken ihrer Hand?

Die Adress-Kalender erfassen, wie der größte Arbeitgeber im frühneuzeitlichen Staat mit der Bevölkerung seines Territoriums verwoben war: Welcher Prozentsatz der Stadt- und der Landbevölkerung stand in Dienstverhältnissen zum Hof? Wie verliefen – hier wird die Serie der Kalender aufschlussreich – Karrieren bei Hof? Welche Positionen erweisen sich als sozial durchlässiger als andere?

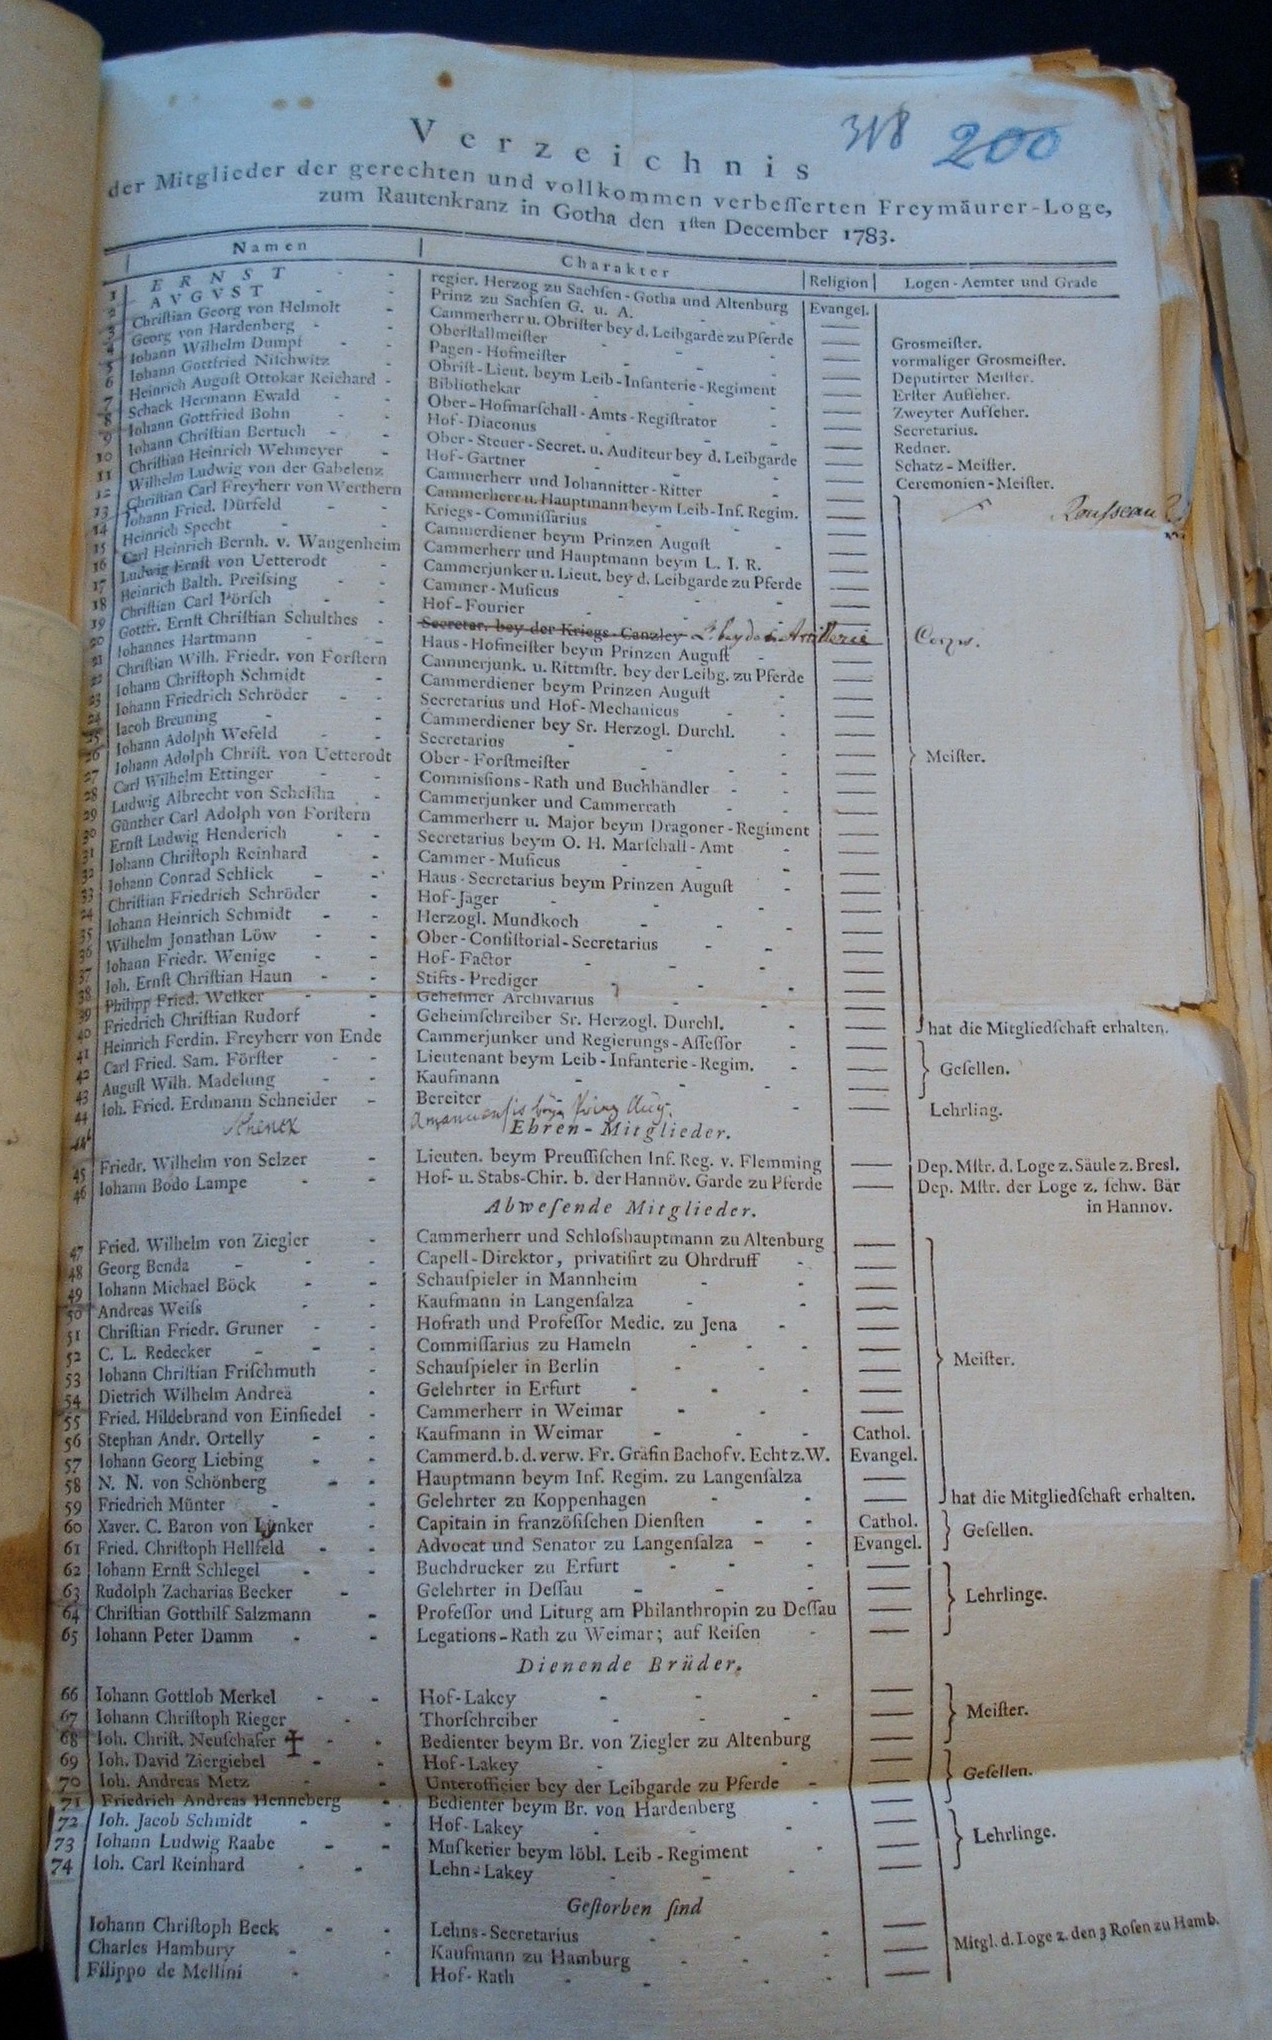
Wie sind – wenn wir Organisationsgefüge miteinander korrelieren – Gothas Freimaurer mit Staat und Kirche des Herzogtums verwoben? In wieweit überlappen sich Kreise des Klubbs, der Thee-Gesellschaft, der Besucher der wissenschaftlichen Vorlesungen des Hofarchivars Ludwig Christian Lichtenbergs in der Stadt, der Illuminaten im Haus des Schlosshauptmanns Christian Georg von Helmolt mit staatlichen Strukturen? Welche Mitgliedschaften waren Eintrittskarten in Karrieren, welche persönlichen Kontakte öffneten Türen?

Aus den Akten des Illuminatenordens Schwedenkiste Band 10, 200: Die Mitgliederliste der Gothaer Freimaurer-Loge von 1783. Deutlich sichtbar: Führende Hofbeamten treffen sich in der Loge wieder – aber nicht alle… Vergrößern

Übersichtlichkeit werden Organigramme generieren, sobald sie mit der Aktenüberlieferung korreliert werden, und man auf die Schnelle in die Arbeit von Behörden Einblick nehmen kann.

Bleibt die zentrale Frage: Was muss wie eingegeben werden, um welche Darstellungen zu erlauben und welche Fragen stellen zu können?

Struktur Stadtverwaltung Gotha, Organigramm 2017 http://www.gotha.de/rathaus-politik/stadtverwaltung/organigrammaktenplan.html

Kopfzerbrechen Nr. 2: Subskribentenlisten

Dem letzten Kopfzerbrechen sehr ähnlich ist dieses: Viele Bücher der (frühen) Neuzeit enthalten Subskribentenlisten. Der Verleger sichert die Publikation ab, indem er vorab um eine Meldung aller Interessenten am kommenden Buch bittet. Sie erhalten das Buch zu günstigeren Konditionen; der Verleger kann sich im selben Moment seines Absatzes sicher sein.

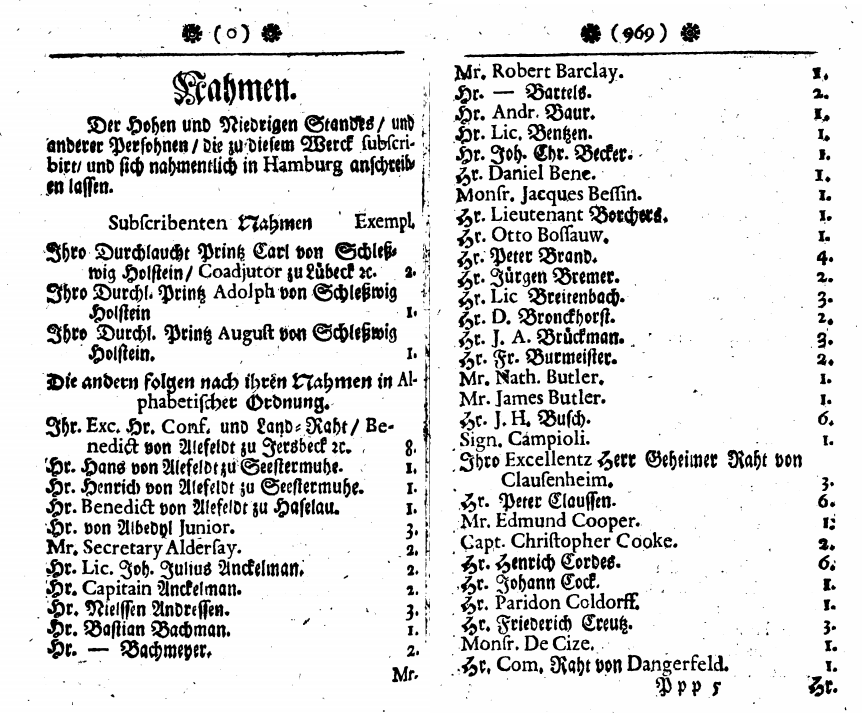
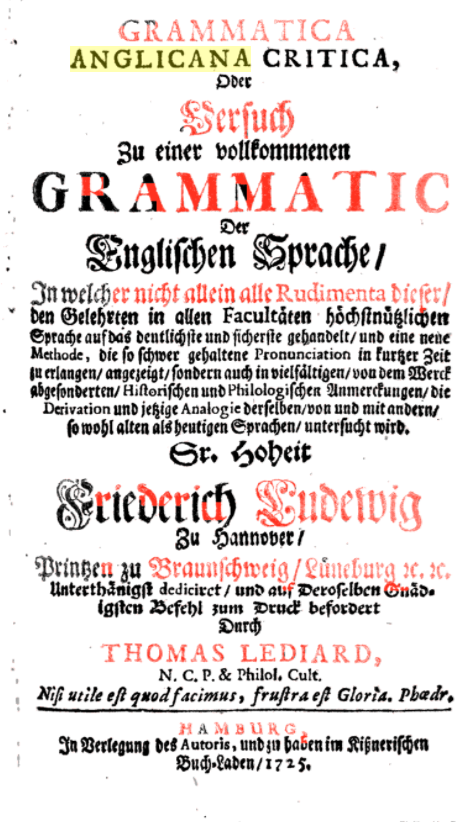
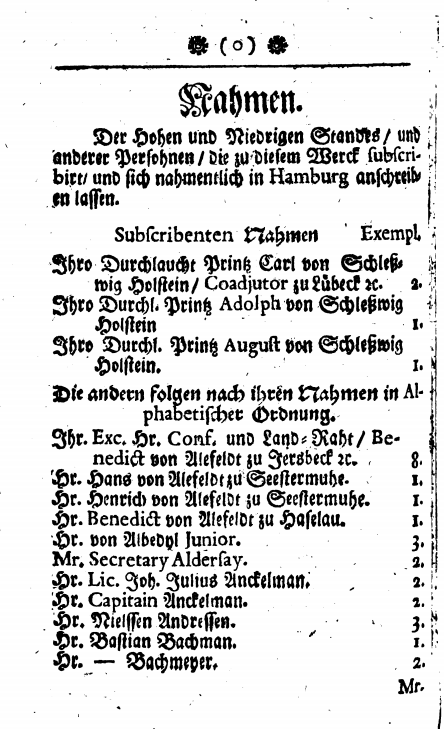
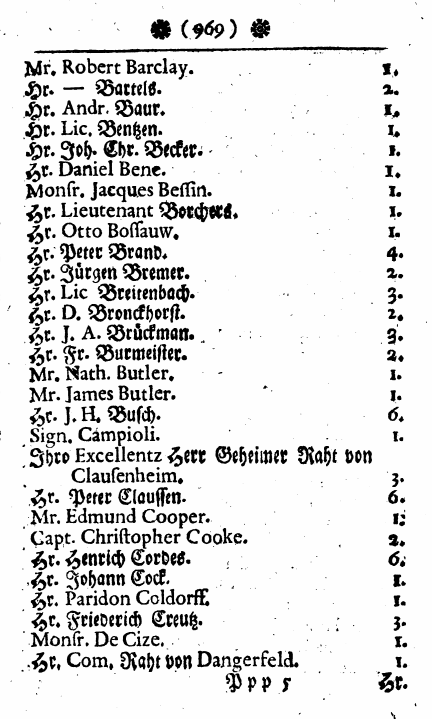
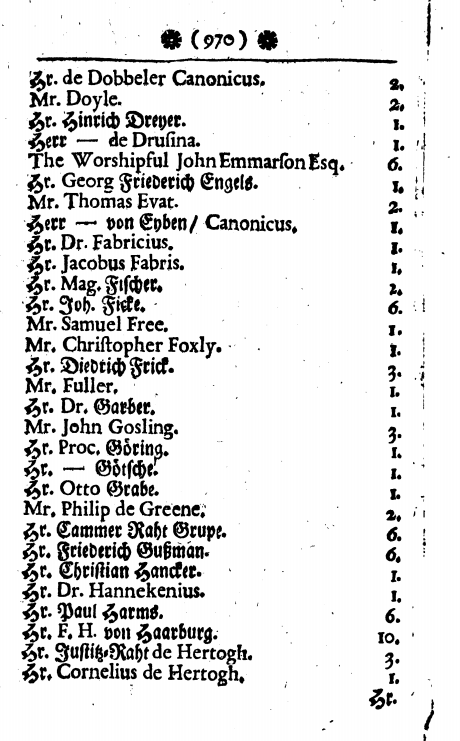
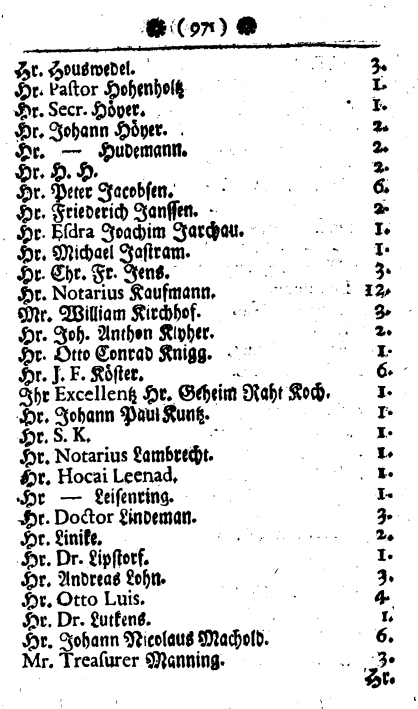
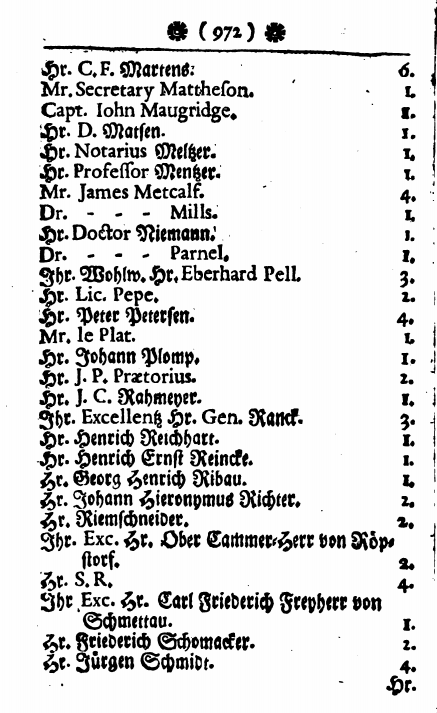
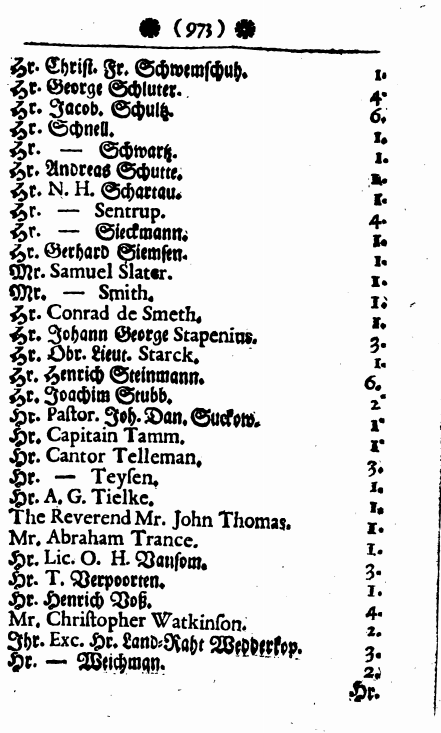
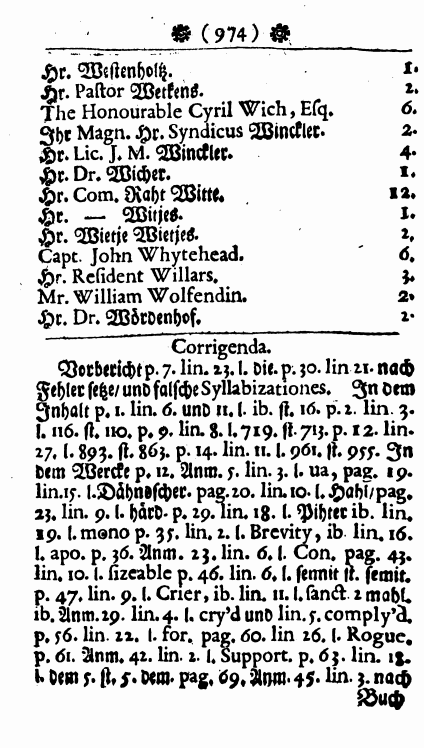
In vielen Büchern des 18. Jahrhunderts sind diese Listen am Ende abgedruckt. Es sind spannende Listen, da wir hiermit für eine ganze Zahl von Büchern – theoretisch – sehr genau wissen, wer sie in der ersten Welle las. Unten inseriere ich die Subsriptionsliste aus Thomas Lediards Grammatica Anglicana (Hamburg: Kißnerscher Buchladen, 1725). Für die nächsten Jahre wurde dies das beste Englischlehrwerk auf dem deutschen Markt.

Wer glaubt, Bücher werden damals nur von hohen Standespersonen gelesen, irrt. Diese machen als abgesetzter Zirkel den Anfang. Es folgen alphabetisch die übrigen Leser: gute 180 Namen, oft mit Vornamen, mit Angaben der Bestellmengen, zuweilen mit Angaben des Berufs.

„Hr. Cantor Tellemann“ ist natürlich der in Hamburg ansässige Georg Philipp Telemann – 1725 demnach begierig, Englisch zu lernen,doch brauchte er dafür gleich drei Exemplare? Hr. Dr. Fabricius wird Johann Albert Fabricius sein, „Mr. Secretary Mattheson“ der Sekretär und Korrespondent des englischen Gesandten, Komponist und Musikkritiker – Johann Mattheson, verheiratet mit einer Engländerin und 1742 der Übersetzer der Pamela ins Deutsche.

Das Auflösen der Namen mit dem individuellen Namensvorrat des Historikers ist müßig. Man müsste die Namen mit Datenbanken abgleichen. Die Eröffnung gibt an, dass alle Genannten sich in Hamburg erreichen ließen. Das ist sowohl eine interessante Beobachtung für den, der sich fragt, wie 1725 Subskriptionen zustande kommen (demnach primär über die Werbung vor Ort), wie eine Hilfe beim Abgleich mit Wikidata und der GND. Die Lage sieht in späteren Listen komplexer aus.

Man würde definitiv die gesamte Liste eingeben. Erst mit ihr weiß man, wie viele Subskribenten es gab, und kann Vergleiche mit anderen Subskriptionsprojekten ziehen.

Es wäre interessant, Namen mit den geringen Informationen, die man hat, einzufüllen und auf die schrittweise Identifikation zu warten, auf die Anreicherung von Information. Man wünschte sich eine Schablone für Subskriptionslisten, um beim Eingeben nicht unnötig viele Parameter berücksichtigen zu müssen, und würde in einem zweiten Lauf, die Datenbank bitten, mögliche Treffer zu nennen.

Im Verlauf könnte man vielleicht soziologische Querschnitte geben. Wie alt ist man, wenn man 1725 in Hamburg Englisch lernt? Wie viele Engländer (sind diese nebenbei Sprachlehrer?), wie viele Deutsche spricht das Buch an? In welchen Berufszweigen lernt man die Fremdsprache, die in den nächsten 200 Jahren die globale Lingua Franca wird?

Die Subskribentenliste von Thomas Lediards Grammatica Anglicana (Hamburg: Kißnerscher Buchladen, 1725), S. 968-974

auf Google Books