Vom 19. Jahrhundert bis in die Gegenwart gab es Projekte, die für bestimmte Zeiträume oder komplett, gedruckte Editionen von Schul- oder Universitätsmatrikeln hervorbrachten. Für die Erfassung dieser Massendaten in digital auswertbare Datenbanken findet sich in diesen gedruckt vorliegenden Editionen großes Potential: einerseits in der einfacheren technischen Erschließbarkeit (im Vergleich zu den handschriftlichen Quellen), andererseits da für diese Projekte oft mehr Quellen herangezogen wurden als die eigentlichen Matrikel und durch das Record Linkage auf dem Papier wertvolle Zusatzinformationen gewonnen werden können. Als Beispiel seien hier die ersten beiden Bände der gedruckt vorliegenden Matrikel der Universität Halle genannt für die Fritz Juntke in den 1950er Jahren zahlreiche weitere Literatur sowie Quellen aus den Archiven der Universität sowie der Franckeschen Stiftungen heranzog, um die reinen Matrikeldaten noch weiter anzureichern. Ebenso nahm Charlotte Preuß für den zweiten (noch nicht digital erschlossenen) Band für die Zeit von 1731 bis 1740 bereits einen Abgleich mit gedruckt vorliegenden Matrikeln anderer Universitäten vor. Beide hier genannten Bearbeiter wiesen jedoch in den Editionen darauf hin, keine Vollständigkeit in diesem Bereich für sich reklamieren zu wollen oder zu können.
Für den ersten Band der Halleschen Matrikel, der den Zeitraum der Universitätsgründung bis 1730 umfasst, ist in den letzten zwei Jahren erstmals dieser Schritt vom Scan der gedruckten Matrikel über die Texterkennung und Strukturierung der Daten, deren Upload und Verbindung mit vorhandenen sowie neuen Daten in FactGrid, erfolgreich umgesetzt worden.
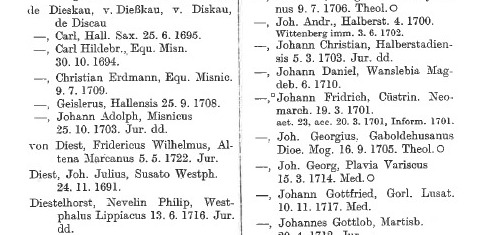
Die Matrikeledition von Juntke ist so aufgebaut, dass alle Namen nicht chronologisch, sondern alphabetisch in zwei spalten pro Seite hintereinander weg aufgeführt werden. Diese wurden in einem ersten Schritt vollständig gescannt (Siehe Abb. 1), um dann weiter bearbeitet werden zu können.

Abb. 1: Beispielseite aus Fritz Juntke (Bearb.): Matrikel der Martin-Luther-Universität Halle-Wittenberg, Bd. 1: 1690-1730 (Halle: 1960).
Im nächsten Schritt wurden für die Texterkennung die einzelnen Scans jeder Doppelseite in Buckets der Daten-Cloud Amazon S3 hochgeladen, um sie dort zu speichern und dann mit der Software von Amazon Textract weiterverarbeitet zu werden. Die Wahl fiel zum damaligen Zeitpunkt auf diese Software, da neben der reinen Texterkennung auch ein Machine-Learning-Service in die Software integriert ist, so dass nicht nur der reine Text erkannt wurde, sondern auch Layoutelemente und die Struktur der Daten in ihrer gedruckten Form mit erfasst werden konnten (Siehe Abb. 2).
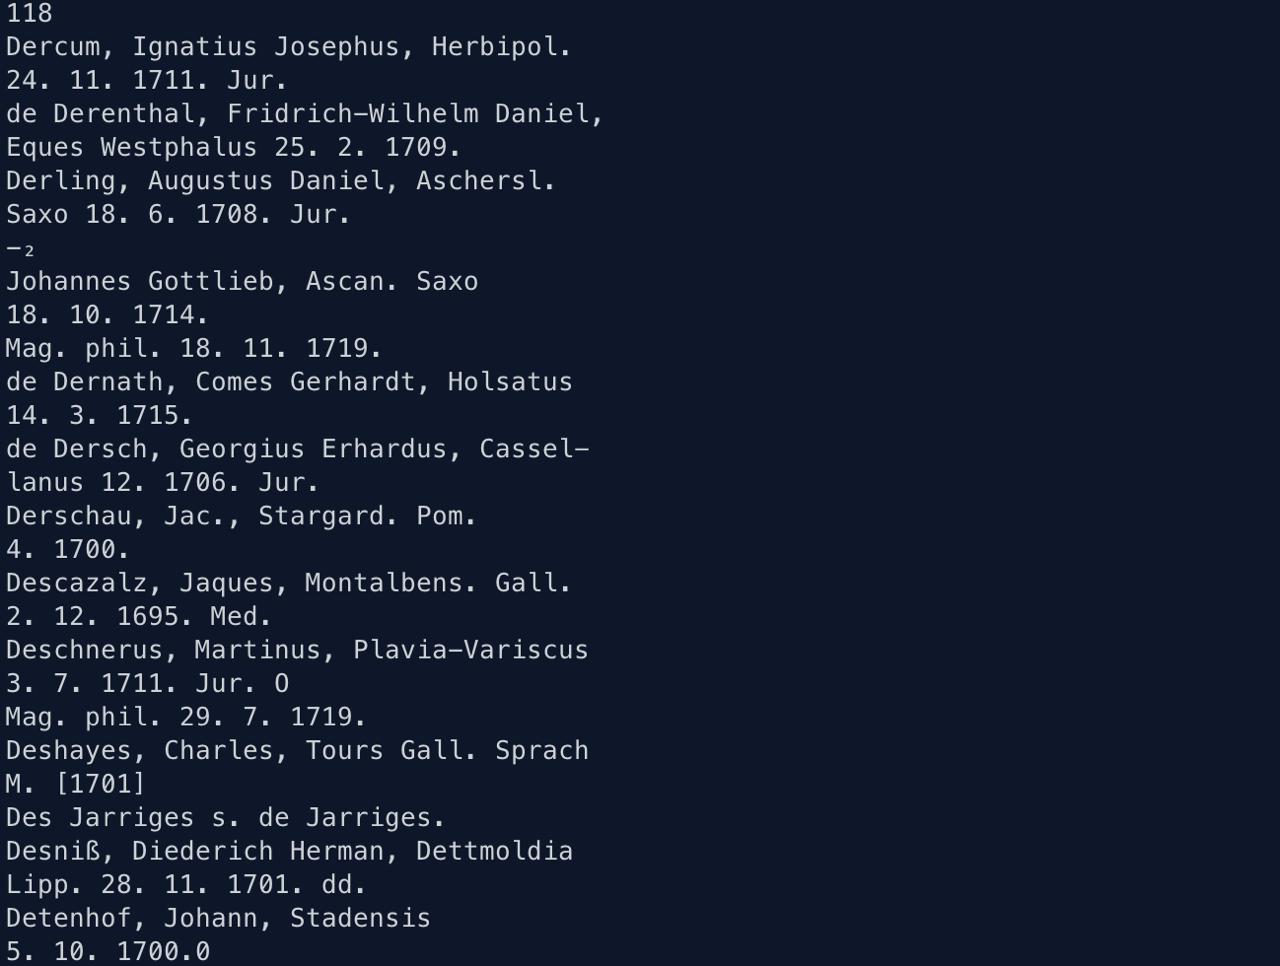
Abb. 2: Rohtext-File nach der Texterkennung.
In diesen Rohtext-Files waren im nächsten Schritt manuell alle Sinneinheiten (Studenteneinträge) durch einfache Leerzeilen von einander zu trennen, da einzelne Einträge bereits in der Edition über mehrere Zeilen hinweg verlaufen können. Diese einzelnen Einträge folgen basierend auf der Struktur der Matrikeledition der Abfolge Familienname, Vorname(n), Herkunftsort, Immatrikulationsdatum, Studienfach, weitere Informationen. Ein Großteil dieser Sinneinheiten wurde bereits durch die Software von Amazon Textract erkannt und durch Kommata voneinander getrennt. Bei der Erkennung und Abtrennung insbesondere der Immatrikulationsdaten, wo die Ausgangssoftware noch keine zufriedenstellenden Ergebnisse lieferte, wurden im nächsten Schritt die Daten mittels eines Perl-Scripts (Siehe Abb. 3) reformatiert, um jeden Eintrag in einer Zeile zu haben und um mittels Mustererkennung fehlende Kommata zur Trennung der Daten zu setzen.
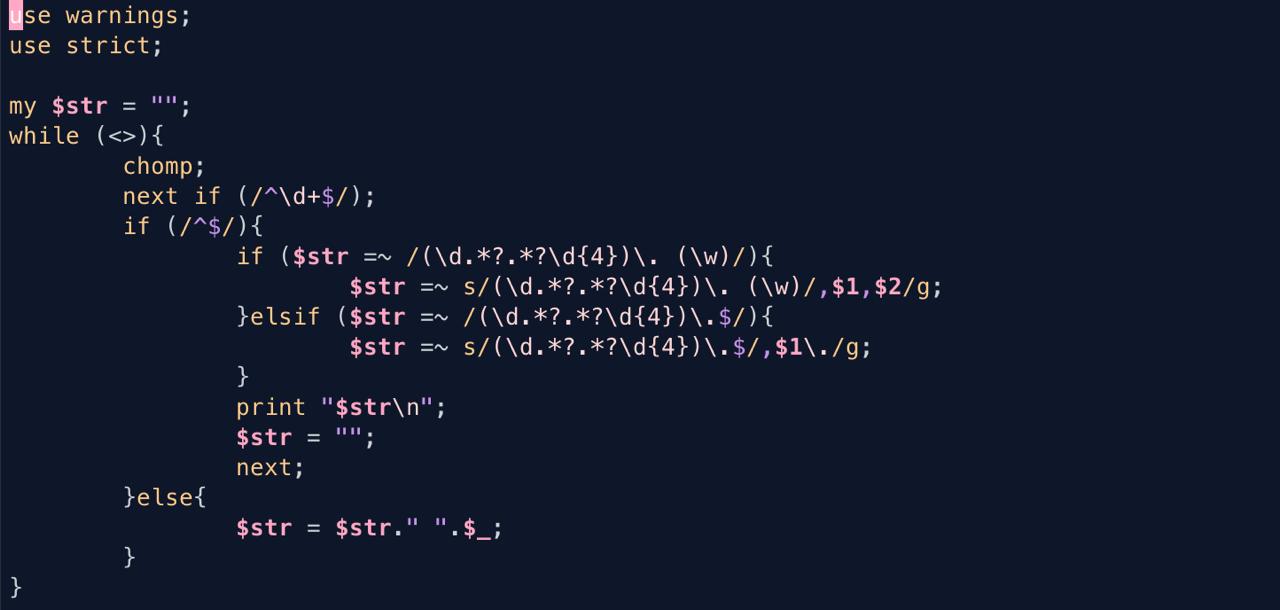
Abb. 3: Skript zur Strukturierung der Daten.
Das daraus erzielte Ergebnis ließ sich dann in eine strukturierte Tabelle überführen und wurde nach Korrekturlesen und wenigen manuellen Verbesserungen für den Upload in Factgrid vorbereitet, wo der Datensatz veröffentlicht und nachhaltig weiter nutzbar und in verschiedenen Formaten herunterladbar vorliegt. Siehe dazu folgenden Blogbeitrag: Die Matrikel der Universität Halle (1690-1730) in FactGrid