Zwei neue Illuminatenlisten und einige grundlegende Gedanken zur Erfassung von Listen in FactGrid

Datensätze im Überblick

Dass mit seinem 250jährigen Jubiläum zwei neue Mitgliederlisten aus dem Illuminatenorden auftauchen würden (genauer: eine Liste in zwei Versionen), war nicht abzusehen. Tatsächlich zirkulierten ausgewählte Scans bereits etwas früher. Grundlegend neue Erkenntnisse, so die Einschätzung Reinhard Markners, der die Scans früher sah als ich, schienen hier nicht zu erhoffen.

Ich ließ mich auf den eingehenderen Blick ein, schon allein, da ich lange mit dem Gedanken einer Online-Edition aller Illuminaten-Dokumente spielte – aber auch, weil FactGrid es einfach macht, Listen sehr präzise zu verorten.

Jakob Bader, der uns die Seiten zusandte, zeigte sich extrem aufgeschlossen, uns hochauflösende Scans zukommen zu lassen und sah keinen Grund, warum wir sie nicht unter der offenen CC0-Lizenz auf Wikimedia Commons hochladen sollten, was es nun sehr viel einfacher macht, im wissenschaftlichen Austausch über sie nachzudenken. Hier die Digitalisate:

  • Vierseitige “Lista Illuminatorum” aus dem Besitz Sebastian Knorrs, Seiten 4+1/ Seiten 2+3
  • Zweiseitige “Lista Illuminatorum” aus dem Besitz Sebastian Knorrs, Seite 1/ Seite 2

Die interessante Liste ist die vierseitige – eine planvoll und repräsentativ angelegte, unerwartet strukturierte.

Vierseitige Lista Illuminatorum aus dem Besitz Sebastian Knorrs 1+4
Vierseitige Lista Illuminatorum aus dem Besitz Sebastian Knorrs, Seiten 4 und 1

München, 1784/85

Die beiden Listen sind offensichtlich authentisch, in München für die Orientierung im Gefüge der umliegenden Minervalkirchen verfasst. Man wird sie beide auf 1784/85 datieren können. Auf beiden ist der Name Sebastian Knorrs hervorgehoben; Jakob Bader erklärte nebenbei, über welchen familiären Umweg die Listen zu ihm gelangten.

Beide Listen stammen von verschiedenen Schreibern. Die zweiseitige Liste, ist offenbar eine im Fragment – bei Nummer 121 – endende Kopie der vierseitigen, die im Bogenformat beschrieben ist. Einmal gefaltet lässt sie sich von Seite 1 (vorne rechtsseitig) bis Seite 4 (im ausgebreiteten Zustand vorne links) durchblättern. Aufgeschlagen liegen auf der Innenseite die Seiten 2 und 3 einander gegenüber.

Die vierseitige Liste wurde über eine ganze Zeit hinweg benutzt, das zeigt sich vor allem am Ende, wo sieben Namen von anderer Hand nach und nach hinzugefügt wurden. In Bleistift notierte zudem jemand bei einigen der Überschriften die Klarnamen der Minervalkirchen. Eintrag 111, der Name Knorrs, ist in beiden Listen unterstrichen – mit blauem Buntstift, nachträglich, in der vierseitigen. In der zweiseitigen unterstrich der Schreiber den Namen dagegen noch beim Schreiben sofort mit Tinte.

Dass die zweite Liste eine Kopie ist, wird im Eintrag 17 zu Thomas Walpole besonders deutlich: Der Schreiber der vierseitigen Liste hatte noch halbwegs korrekt „Wallpolls“ notiert, sein großes W kam dabei wie überall in seiner Aufstellung einem großen K nahe. Der Schreiber der zweiseitigen Liste las hier, den echten Namen nicht kennend, in der Folge „Kallpolls“.

Für die Datierung auf 1784/85 sprechen inhaltliche Aspekte: In der vierseitigen Liste sind im Verlauf mehrere Mitglieder als im Dezember 1783 ausgetretene notiert; der Austritt ist da schon vollzogen, er ist nicht im Nachhinein notiert. Den terminus post quem bietet jedoch der Eintrag 100:

Xaver v. Pettenkofer Hofr. Orestes †

Der Eintrag ist in sich unstimmig: Franz Xaver von Pettenkofer (1754–1826) firmierte im Orden als „Pylades“; es war sein Bruder Joseph Carl von Pettenkofer (1754–1784) alias „Orestes“, der am 13 April 1784 starb. Offenbar konnte der Schreiber die Zwillings(?)brüder nicht auseinanderhalten.

Die am Ende hinzugesetzten sieben Namen stammen nicht von später noch eingetretenen Mitgliedern; es sind, soweit wir die respektiven Eintrittsdaten ermitteln können, Namen von Personen, die dem Anschein nach bei der ersten Aufstellung vergessen wurden.

Die Ordensverfolgung begann am 2. März 1785. Wann genau es für die Münchner Mitglieder ratsam wurde, sich selbst nicht mehr dem Orden zuzuordnen, ist nicht klar zu sagen; hier dürfte der terminus ante quem liegen. Die vierseitige Liste spricht immer noch vom Selbstbewusstsein der oberbayerischen Organisation und offenbar auch vom Stolz ihres Besitzers, sich in dieser Gesellschaft wiederzufinden.

Keine bloße Namensliste

Auch die vierseitige Liste mit ihren 248 Einträgen und sieben Nachträgen ist weit von einer Gesamtliste des Ordens entfernt. Es ist unwahrscheinlich, dass es eine solche je gab. Der Orden gliederte sich in Provinzen (mehrfach veränderter Aufteilung), deren Leiter einzelne Listen generierten. Von 2000 bis 2500 Mitgliedern soll Adam Weishaupt ausgegangen sein, so spätere Aussagen. Die neuen Listen erfassen die Situation von München aus mit punktueller Offenheit. So sind mit den Nummern 61 und 62 Göttinger Professoren München zugeordnet. Deren Namen Meiners und Feder waren dem Schreiber offenbar nicht geläufig. „Feiner“ und „Ayder“ notierte er dem Anschein nach von einer ihm vorliegenden unleserlichen Notiz (gefürchtet war aus Göttingen die Handschrift Benjamin Koppes).

Münchens Minervalkirche (das illuminatische Pendant zur regulären freimaurerischen Loge) erscheint unter zwei Rubriken zwischen den umliegenden. Die regionale Strukturierung wird dabei von einer funktionalen Sortierung überlagert. Im eröffnenden Logenzeichen ▭ finden sich in beiden Handschriften drei Punkte, offenbar für „die Mitglieder der Loge“. „▭ Soli“ wird man als „Loge allein“ lesen. Um dem einen Hintergrund zu geben, muss man verstehen, was der Orden machte: In Nachbarschaft einer bestehenden Freimaurerloge oder neben einer aus dem Orden heraus aufzubauenden, wurde eine Minervalkirche eingerichtet, deren Treffen privat und geheim stattfanden. In die Minervalkirche wurden Kandidaten aufgenommen, um an intellektuellen Debatten teilzunehmen, bevor sie nach drei internen Illuminatengraden von hier aus Freimaurer wurden, die nun in der Loge auftauchten – wo sie einige Logenmitglieder bereits aus der Minervalkirche wiedererkannten, zwischen anderen jedoch incognito als Illuminaten agierten. Die Minervalkirche wurde von hochrangigen Maurern geleitet, die im “Minervalmagistrat” eigene administrative Treffen abhielten. Hier das Schema, wie der Orden damit reguläre Logen wie ein Sandwich umschloss, sie von unten mit eigenen Mitgliedern versorgte, und über ihnen eine geheime Dachstruktur etablierte:

Die Liste Sebastian Knorrs ist, was München anbetrifft, primär an der Identifikation von Illuminaten interessiert, die in der Freimaurer-Loge auftauchten, aber nie in den Minervalkirchen. Ein höherer Kreis des Ordens wird damit greifbar und in zwei Gruppen nach Status in der Freimaurerei differenziert, so die letzte Rubrik, die noch einmal ausschließlich Logenmeister umfasst:

  1. Status Ecclesiae Aul[icae] Athen[arum] ▭ Soli
  2. Ordens Großmeisteramt
  3. Status Ecclesiae Ephes. [Ingolstadt]
  4. Status Eccles. Thebanae [Freysing]
  5. Status Ecclesiae Megarensis [Landsberg]
  6. Status Eccles. Atheniens. [München]
  7. Status Eccles. Neuphj [!] [Straubing]
  8. Status Ecclesiae Corinthiae [Regensburg]
  9. Status Ecclesiae in Menea. [Burghausen]
  10. Lista der Log. Meister so nur die Loge besuchen.

Das genannte „Großmeisteramt“ ist offenkundig nicht der „Areopag“, das Leitungsgremium des Ordens, auf das dessen höchste Ränge drangen, um Weishaupts drohendem „Despotismus“ etwas entgegenzustellen. Über das im Aufbau befindliche in manchen Illuminatenakten genannte „Geheime Kapitel“ ist im Moment nicht genügend bekannt, um einen Abgleich vornehmen zu können.

Forschungsrückblick

Wenn es heute vergleichsweise leicht ist, Listen wie die vorliegenden mit dem Forschungsstand abzugleichen, dann ist das vor allem Hermann Schüttlers bahnbrechender Arbeit zu verdanken. Seine Aufstellung Die Mitglieder des Illuminatenordens, 1776-1787/93 (Munich: ars una, 1991) reformierte die Forschung binnen eines Jahrzehnts. Bis zu ihr standen die „bayerischen Illuminaten“ im Zentrum: 1785/86 wurden sie von den Landesbehörden zur Staatsbedrohung erklärt. Weishaupt und der Staat publizierten wenig später im Ringen um die Deutungshoheit, und Provinziale wie Bode in Weimar notierten, dass erst das den Orden so richtig zugrunde richtete. W. Daniel Wilsons Geheimräte gegen Geheimbünde. Ein unbekanntes Kapitel der klassisch-romantischen Geschichte Weimars (Stuttgart, 1991) ergänzte das sich abzeichnende Bild im selben Jahr mit einem problematischen Blick in die Herzkammer der deutschen Klassik: Goethe war am 11. Februar 1783 Illuminat geworden. Das ist zwar korrekt, doch kam in Weimar keine Minervalkirche zustande. Bode wurde in Weimar aktiv, der Provinzial Ionies/Obersachsens, der von hier aus fünf Minervalkirchen in Gotha, Erfurt, Rudolstadt, Jena und Buttstädt betreute. Von einem Kampf der Geheimräte gegen den Orden wird man nicht sprechen können. Bode lud den Weimarer Herzog und seine ranghohen Regierunghsmitglieder ein, wohl um nicht im Geheimen agieren zu müssen. In Gotha war Ernst II. ranghöchstes Mitglied – seinen Bruder in Weimar außen vor zu lassen, wäre politisch unklug gewesen. Erst 1789 und mit den Ereignissen der Französischen Revolution begann eine Ära, in der Logen und die Illuminaten als ein geheimer Logen-Verband, heikel wurden – Der Orden existierte da bereits nicht mehr, das wissen wir, da wir mit der Schwedenkiste den Zusammenbruch des Ordens bei wachsender interner Ratlosigkeit nachvollziehen können.

Schüttlers Liste bot 1991 neuartig ausgewogen die weitesete Perspektive: Hier waren auf einen Schlag 1255 Mitglieder namentlich erfasst und Orten der Ordensgeographie von Altona bis Wien zugeordnet. Zu allen Personen lieferte Schüttler Quellen – neuartig: auch aus der „Schwedenkiste“, deren der DDR von der Sowjetunion restituierte Bände (der 10. Band mit den Mitgliederlisten blieb in Moskau) er als erster nach dem Fall der Mauer durchgesehen hatte. Schüttlers Buch ging auf seinen ersten 170 Seiten die 1255 Biogramme durch; weitere 92 Seiten Anhänge folgten, die die Gelisteten nun nach Ordensnamen aufschlüsselten und den Standorten der Organisation zuordneten.

Hatte Schüttler sich lange Zeit mit dem Gedanken einer revidierten Neuauflage der Publikation von 1991 getragen, so entschied er sich 2015, diesen Plan weit einfacher im „Illuminaten-Wiki“ des Forschungszentrum Gotha umzusetzen, aus dem 2018 die Wikibase-Installation FactGrid hervorging. Die Items Q25 bis Q1379 wurden in der Folge mit den Biogrammen seiner Liste bestückt. Julia Mös legte 2018/19 die Fließtext-Biogramme aus dem aufgelösten Wiki auf die Diskussionsseiten der Items (vergleiche das Datenbankobjekt und das Biogramm Schüttlers im Fall Johann Joachim Christoph Bodes). Aus der Fließtextinformation der Biogramme machte sie im nächsten Schritt strukturierte Information der Datenbank. Es ist dies die Vorarbeit, dank derer wir heute einer neuen Mitgliederliste relativ zügig bereits bekannte Personen zuordnen können.

Nicht einfach zu bewerten

Der erste Arbeitsschritt war unkritisch: Zwei Datenbankobjekte für die zwei Listen aufzumachen und zur ersten die Einträge wie die tentativen Identifikationen zu notieren: Q1895676 und Q1896166. Die Datenbank macht die Zuordnungen bequem: noch beim Eintippen unterbreitet sie laufend Vorschläge, wen man meinen könnte, und reagiert dabei auch auf die Ordensnamen. Eine andere Frage ist, ob man der Liste nach einem solchen Durchgang Quellenwert beimessen will. Es ist in diesem Fall ein Leichtes, die Aussagen zu extrahieren und nun personenseitig mit einem P91-Statement als Mitglieder auszuweisen. Das Dokument wird dabei zur laufende Quelle. Ich ging diesen Schritt am Ende, da ich die Liste zunehmend als aufschlussreiche Quelle einstufte. Hier die Liste in einer Datenbankabfrage:

Von der Liste lässt sich ein beliebiges Kurzlink (https://t1p.de/dnhdx) generieren, das sich danach im Kollegenkreis verbreiten lässt. Wir gehen im Austausch angenehm direkt miteinander um, und Reinhard Markner kommentierte umgehend kritisch. Er hatte die Liste schon vorher gesehen und nicht minder nüchtern eingeschätzt:

Ihren Quellenwert schätze ich aus den Gründen, die Du ja selbst nennst, nicht allzu hoch ein. Zu Vacchiery z. B. siehe hier.

Der Bezug gilt dem Brief, den Ferdinand Maria Baader am 27. Januar 1782 Weishaupt schickte mit Verdruss über einen der Männer, die in dieser Liste nun auftauchten – Carl Albert von Vacchiery (1746–1807) gehörte ins Feindeslager:

Die werden alle Tage grösser – vacchiery ist Hofrathsvicedirector geworden. Morawitzky hat alle Hoffnung Minister zu werden – zu seiner bekannten Unthätigkeit kömmt nun auch noch die Bibellesung – die er neulich wirklich aufgeschlagen hatte, als er Besuche bekam. Die R× in Berlin, wie mir Nicolai schreibt halten den Rosen×. in seiner Blösse 10 für ein Produkt von München.

Schüttler hatte Vacchiery und den genannten Morawitzky 1991 unter die Mitglieder gerechnet, Vacchiery 2015 entfernt, und jetzt rutschte der wieder in das Gefüge – Markner dazu weit grundsätzlicher:

…natürlich bin ich nicht dagegen, diese Liste auszuwerten, aber sie sagt leider wenig Belastbares über die Zustände (vor allem) in München aus, Vacchiery ist da nur ein Beispiel. In Hermanns gedrucktem Verzeichnis waren noch nahezu alle Mitglieder der Behutsamkeit aufgeführt, aber es spricht wenig dafür, sie für Illuminaten zu halten, wenngleich es ja Weishaupts Loge war. […] Das Problem mit der ‘Behutsamkeit’ ist, daß es von dieser Loge in München eine Liste gibt, in der die Mitglieder Tarnnamen tragen. Aber soweit ich mich erinnere, sind diese nirgends sonst bezeugt und insbesondere auch noch kein Indiz für Illuminatentum.

Die konstruktive Antwort auf den Einwand wird komplex sein: An den Listen vorbeizugehen ist, wie Markner selbst notiert, keine Option. Sie liegen vor und sie machen Aussagen, die einzustufen sind. Wir sollten alle Listen erfassen und zumindest auf Seiten der Listen notieren, wer da genannt ist, wie auch immer wir dazu stehen. Eine ganz andere Frage ist, wo genau mittlerweile das Projekt der monolithischen Liste angelangt ist, die Hermann Schüttler 1991 vorlegte – und das ist auch eine Frage nach dem „Illuminatentum“, das in Markners Replik sowohl einfach für Mitgliedschaft wie für eine kollektive Geisteshaltung stehen kann, die die Illuminaten miteinander teilten. Ein solches „Illuminatentum“ wird heute niemand mehr zu rekonstruieren versuchen.

Die vorliegende Liste ist offensichtlich das Werk eines Insiders, der mehr festhalten wollte, als den einfachen Mitgliedern in den Logen und Minervalkirchen sichtbar wurde. Auch er wird gewusst haben, dass man in der Loge zur Behutsamkeit eigene Code-Namen trug. Nehmen wir die Liste ernst, dann ist nicht die Frage, ob Vacchieri Mitglied war, sondern, was im Orden geschehen war, dass selbst ein Rosenkreuzer hier 1784/85 auftauchen konnte. Hatten Vacchieri sich bewegt? Die Alternative ist, dass der Orden Menschen wie ihn aufnahm, um sie im Gruppendruck, auf den sie sich einließen, zu bewegen.

Mit den Mitteln der Graph-Datenbank

Unter der Auswertung ließ ich die folgende (durch Anklicken vergrößerbare) Netzwerk-Visualisierung mitlaufen – ich halte sie hier als Bilddatei fest, da sich die Datenlage in rapidem Fluss befindet; wir haben gerade begonnen, die Listen jede für sich auszuwerten und kritisch zu vergleichen – das vorliegende Bild ändert sich (hier das Link für den jeweils aktuellen Stand https://t1p.de/tuckw):

Mitgliederlisten des Illuminatenordens, wo decken sie sich, wo erfassen sie vergleichsweise isolierte Netzwerke?

Ich verfolgte die Veränderungen des Bilds unter der Eingabe, da die Visualisierung mir den Vergleich mit bisherigem Wissen bot. Die Aufstellung aus dem Besitz Sebastian Knorrs fügt sich in bestehende ein, das spricht für sie. Die höchste Schnittmenge weist sie dabei mit der Liste auf, die 1787 die Originalschriften für die Jahre 1777 bis 1779 abdruckten. Nahe liegt der neuen Liste daneben die handschriftliche Liste von Mitgliedern, die sich im Lyoner Exemplar des Nachtrags von weitern Originalschriften (1787) findet, und die von Google Books reproduziert wurde – eine Liste von ganz anderer Funktionalität freilich, gemacht primär, um Ordensnamen zu dechiffrieren. Andere Listen, und das ist das Spannende an der Visualisierung, weisen dagegen gar keine Schnittmengen auf, weil sie in anderen Provinzen ohne Informationsabgleich entstanden.

Was uns im Moment fehlt, ist eine Auswertung aller zeitgenössischen Listen, insbesondere derjenigen die 1908 im zehnten Band der Schwedenkiste zusammengezogen wurden. Vielleicht beschleunigt dieser Blogpost die Arbeit an diesen Listen – wir verfügen über die Digitalisate auch des Moskauer Bandes. Meines Erachtens sind dabei gerade die Listen faszinierend, die zum Projekt einer autoritativen Gesamtliste das Wenigste beitragen. Dies (Schwedenkiste Band 10, Dokument 212) ist eine solche Liste – lokalisierbar auf Gotha, identifizierbar die Handschrift des Kammerherrn Joachim Friedrich Ernst von der Lühe, datierbar auf den Januar 1783:
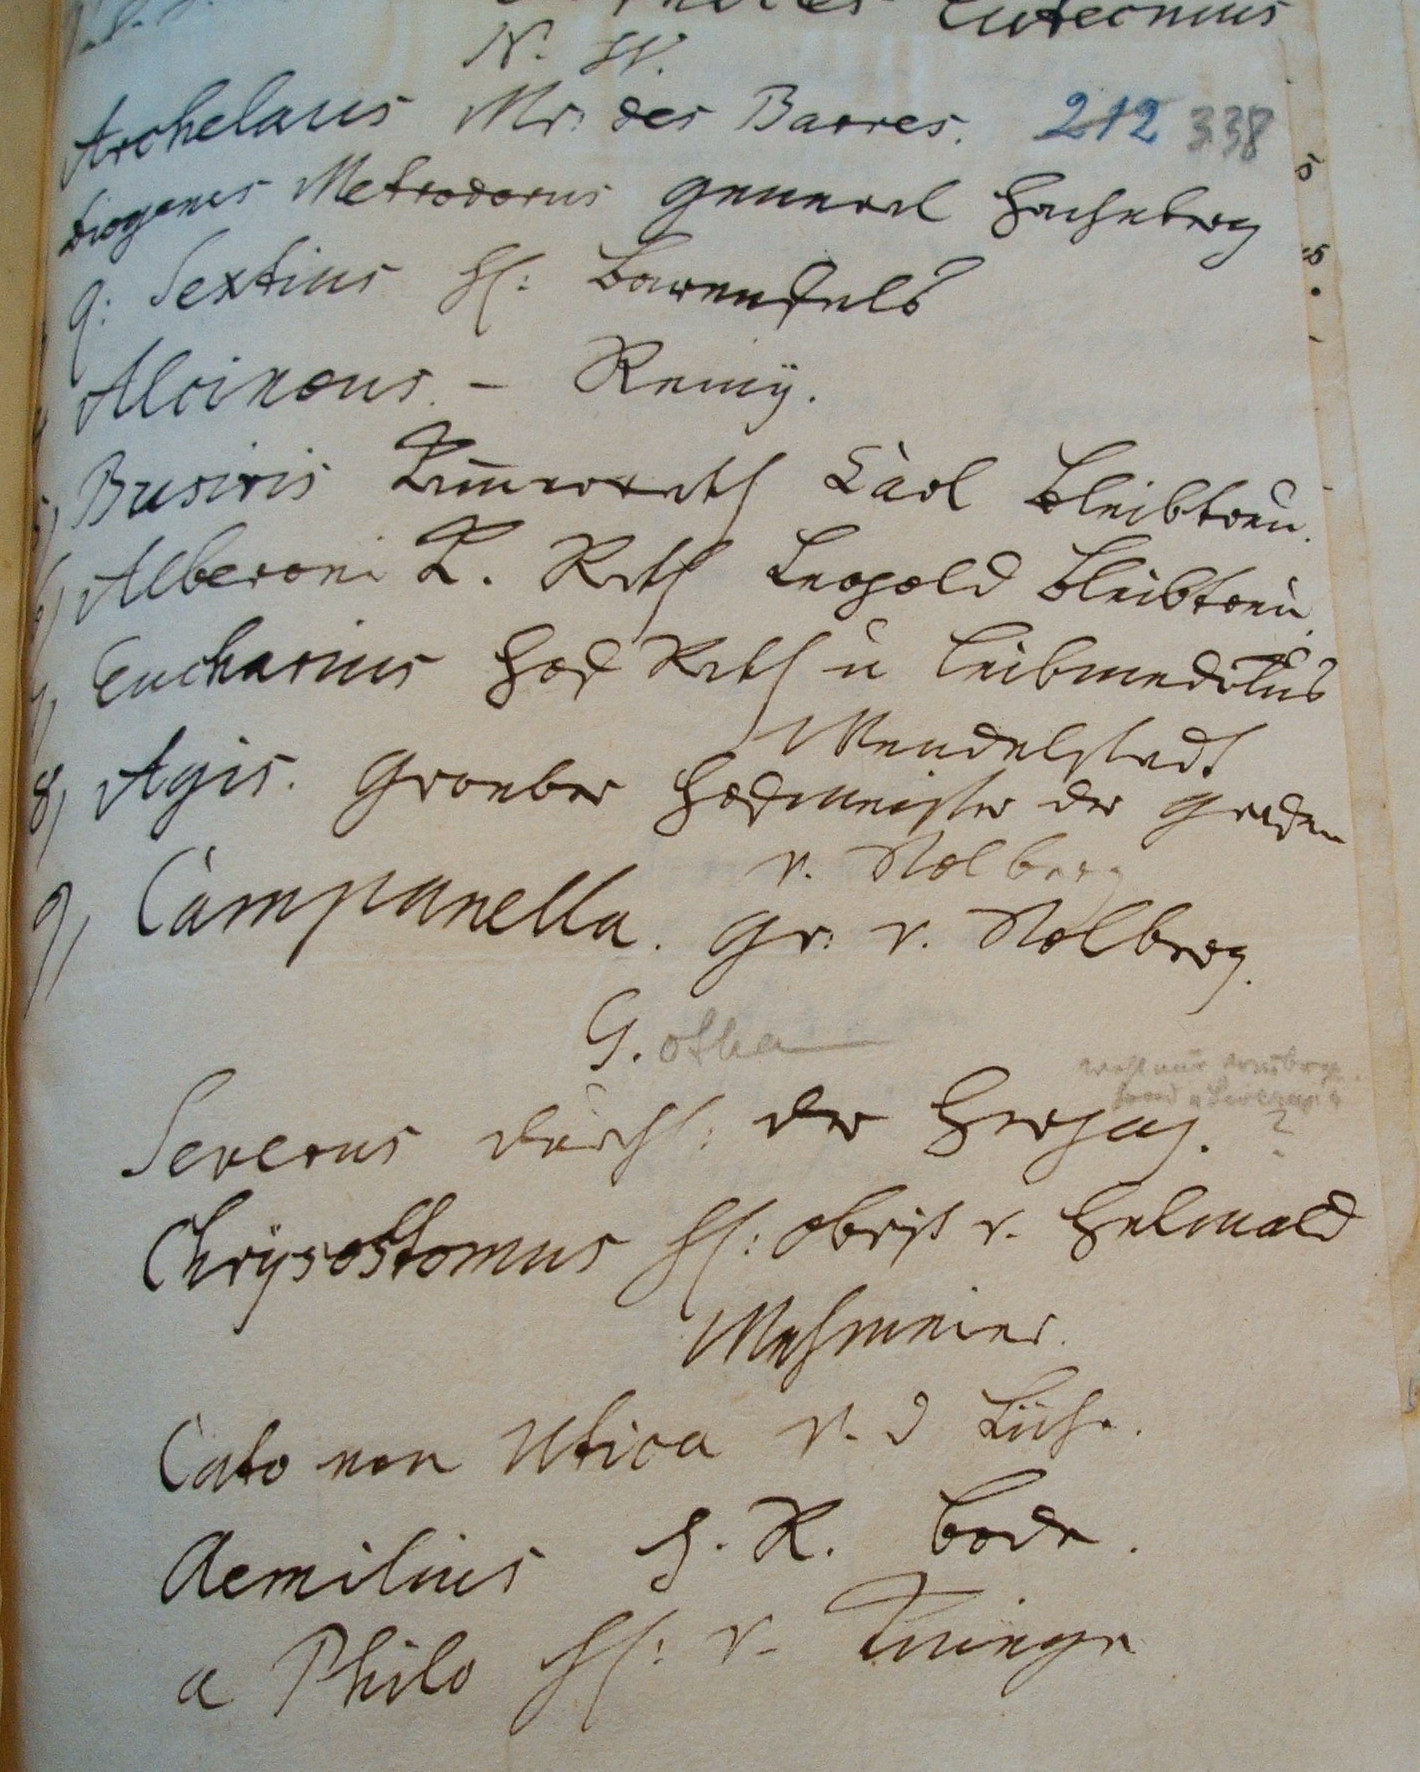
Bode hatte im Spätsommer 1782 vom Wilhelmsbader Konvent zurückreisend in Gotha haltgemacht, um Ernst II. Bericht zu erstatten – auch vom Geheimsystem, mit dem Knigge ihn in Hanau bekannt gemacht hatte. Am 29. Januar 1783 trat der Herzog diesem Orden bei; von der Lühe und der Hofgärtner Wehmeyer folgten anderntags, am 31. zog der Meister der Gothaer Loge von Helmolt nach. Diese Namen sind unter G. wie Gotha notiert. N.W. steht für Neuwied. Beide Ortsnennungen zeugen davon, dass von der Lühe noch nicht über den geographischen Namensschlüssel verfügte, in dem Claudiopolis und Syracus die angemessenen Bezugspunkte gewesen wären. Die Verbindung beider Orte lässt aufmerken: Der letzte für Neuwied genannte Name ist der Stolberg-Roßlas, ab 1784 deutscher National des Ordens. Ernst II. wird diese Position ab 1785 einnehmen. Bode (aus Weimar) und Knigge (aus Nentershausen) werden stillschweigend unter G. notiert, da sie in der neuen Filiale die unmittelbaren Ansprechpartner sind. Als Quelle für die autoritative Mitgliederliste ist das Papier wertlos – bei den Neuwieder Namen scheitert von der Lühe in der korrekten Zuordnung. Als Momentaufnahme aus der Orientierung suchenden kommenden Filiale ist das Dokument dagegen unmittelbar aufschlussreich.

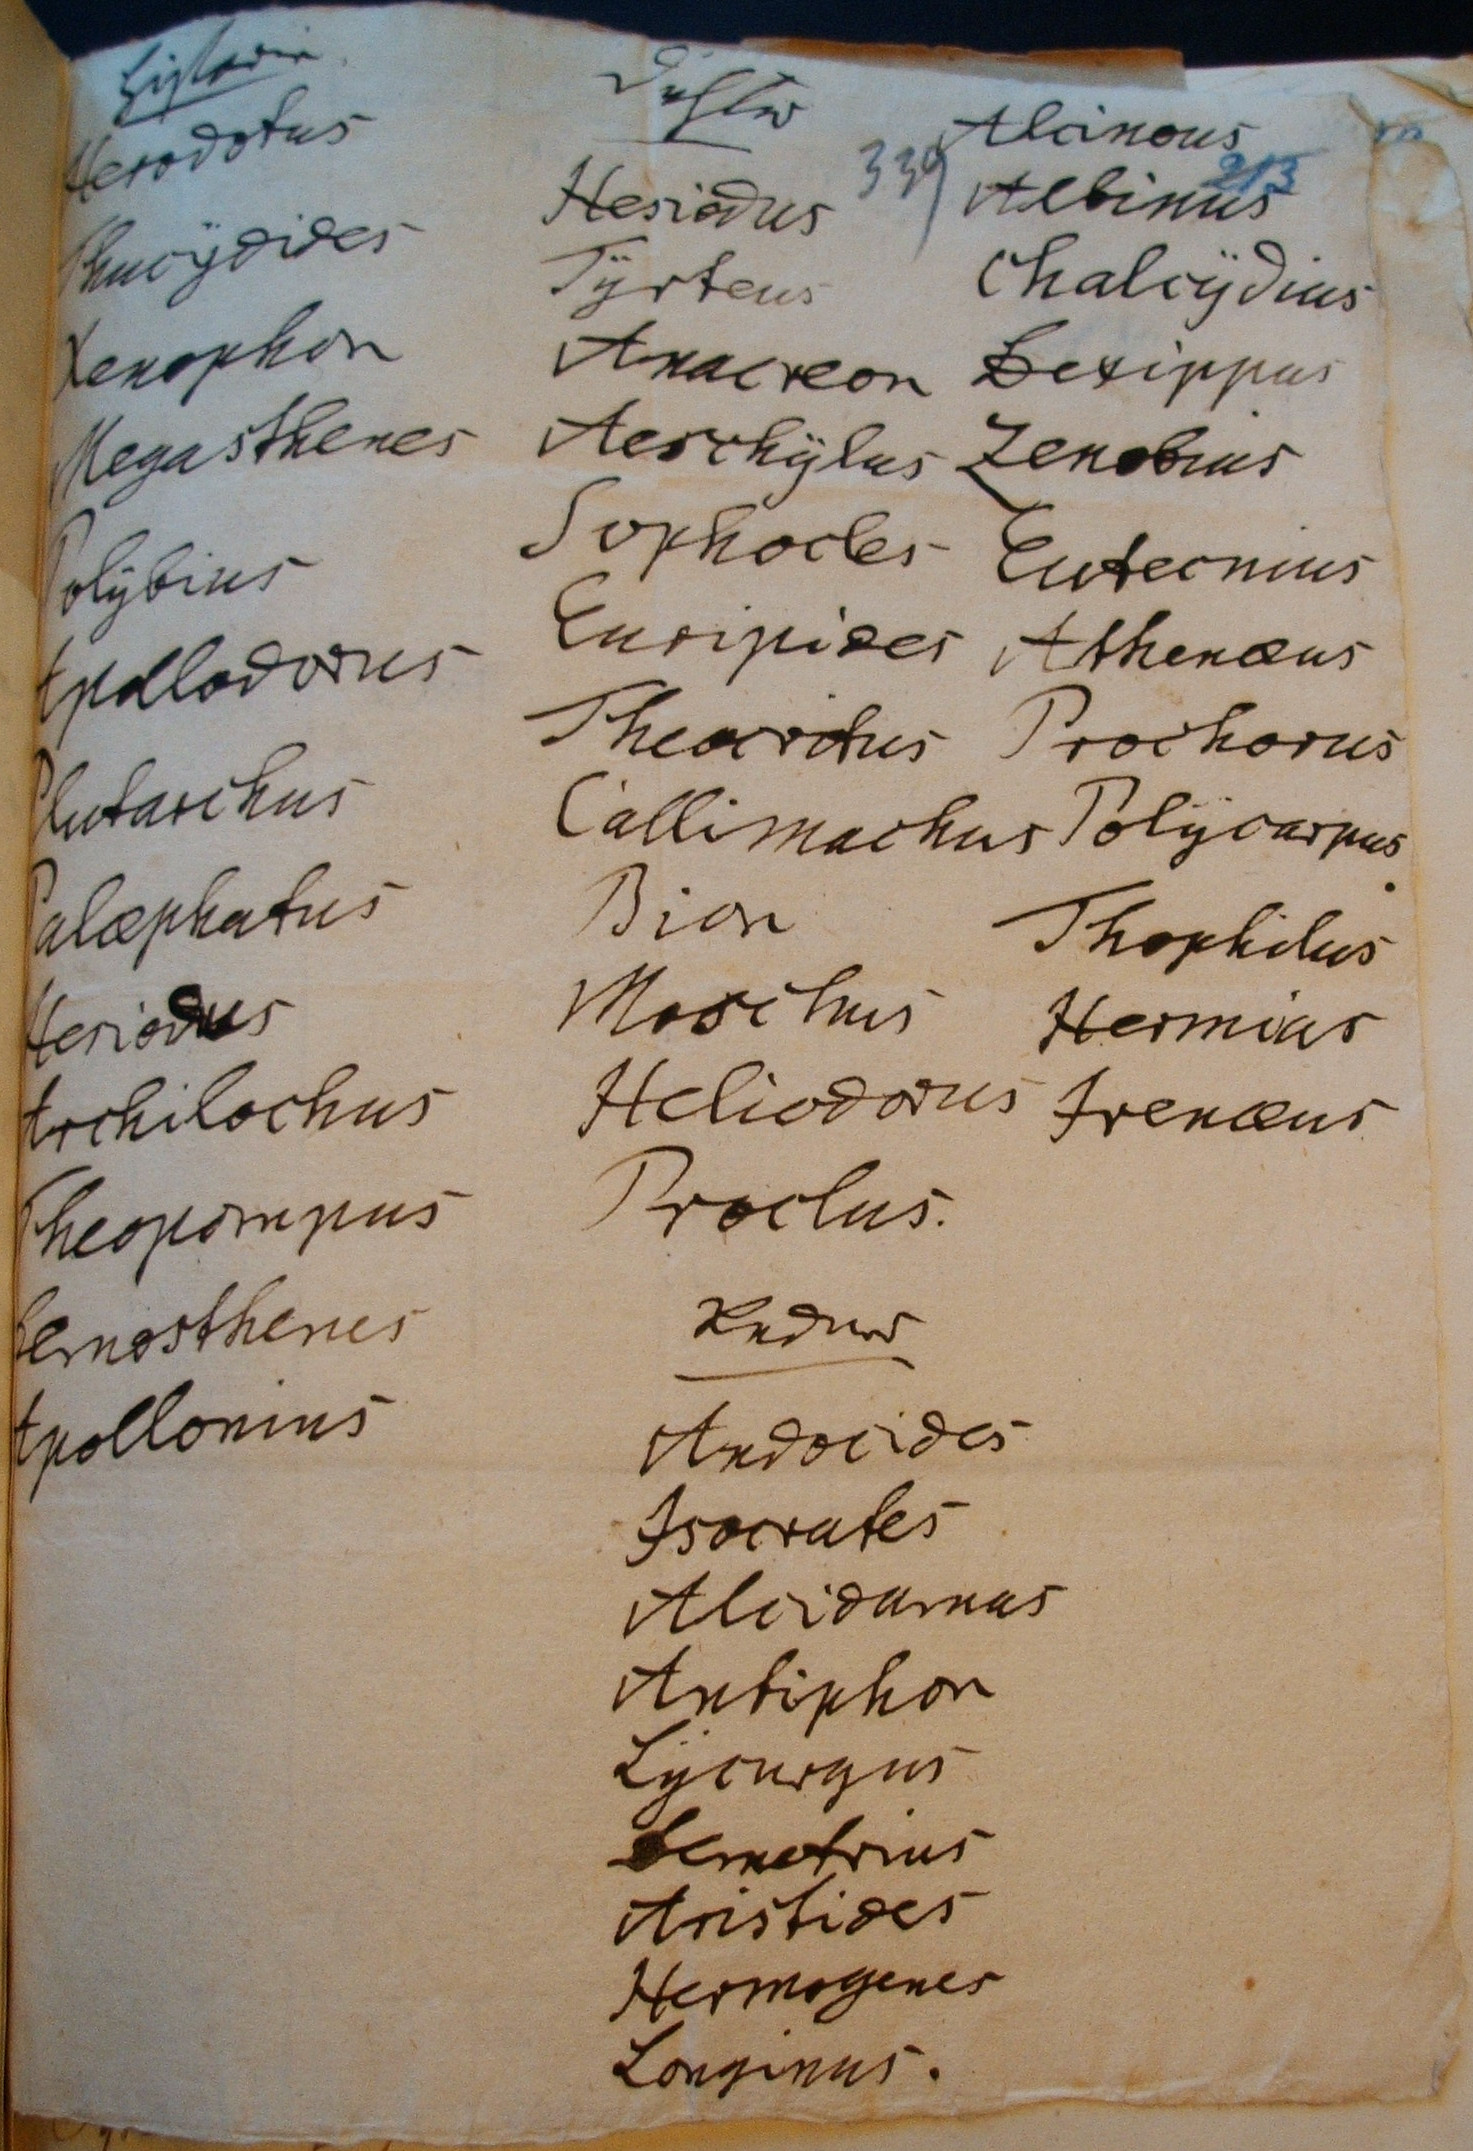
Eine weitere Liste von der Lühes (SK10-213) schließt an: Sie enthält eine Sammlung von Namen der vorwiegend griechischen Antike, Ordensnamen auf Vorrat, samt einer Idee dazu, welchen Funktionsgruppen welche Namen zugewiesen werden könnten. Tatsächlich erhielten schon die ersten Gothaer Mitglieder ganz andere Ordensnamen – solche aus der gesamten Geistesgeschichte. Dass sich zu ihnen interessante erste Aufsätze der Mitglieder in Auseinandersetzungen mit ihren Namenspatronen verfassen ließen, dürfte für die breitere historische Aufstellung gesprochen haben.
Die uns vorliegenden Listen weisen, darum ging es mir mit den Seiteblicken, unterschiedlichste Gestaltungen auf. Manche von ihnen scheinen Planungen Rechnung zu tragen: Wie könnte man den Orden neu strukturieren? Andere dieser Listen, wie die dem Lyoner Exemplar des Nachtrags zu den Originalschriften 1787 beigebundene, scheinen für die persönliche Orientierung verfasst gewesen zu sein – wer ist wer in den Korrespondenzen? Wieder andere sind, wie die Listen Knorrs, stolze Überblicke über eine Provinz und ihre hohe Mitgliedschaft. Gemeinsam zeugen sie von der akuten Problemstelle, an der die Geheimorganisation ihr ganzes Jahrzehnt hindurch krankte: Nichts war in ihr als offenes Wissen greifbar. Der Orden erzeugte im ganzen Berichts- und Betreuungswesen, ohne das weder Mitglieder noch Führung sich seiner Existenz lange gewiss sein konnten, eine kaum zu beherrschende Bürokratie. Spätestens wer in die höheren Ränge und damit in das Berichtswesen eintrat, brauchte Listen unterschiedlichster Funktionalität, von Orts- und Geographielisten über Listen der Ordensnamen bis hin zu den Kalenderschlüsseln für die Datumschiffrierung – und diese bilden im Gegenzug den Orden in seinen Funktionalitäten ab.

Die verschiedenartigen überlieferten Listen – wir sollten sie in ihren spezifischen Eigenarten auszuwerten. Unhandlich bleibt für den Moment, dass unsere tentative Gesamtliste nun auf 1311 Mitglieder angewachsen ist. 32 neue Namen sind darunter, über die wir erst einmal nicht viel wissen. Für sachdienliche Hinweise sind wir besonders bei dieser Auswahlliste dankbar:

https://t1p.de/4bvq9


PS. Mein besonderer Dank an Reinhard Markner für einige Korrekturen im Email-Austausch, die ich ohne Zögern einarbeitete.
…an eery conversation with ChatGPT about FactGrid

You remember the iconic scene when Star Trek’s Scotty (after a jump from the 23rd century back into the year 1986) is forced to use a 20th-century computer? His prompt “Computer” is his first stupidity. When he eventually grabs the thing he is supposed to use, the mechanical mouse on the table, and repeats his prompt: “Computer” his skills look even worse. He needs another hint at the use of the odd thing before he can recover his fame as the man who can talk to any machine.

Here is my last night’s conversation with ChatGPT abou FactGrid, Wikidata and about Large Language Models (LLMs). ChatGPT allowed the reproduction. There is even a link that allows you to see our conversation on their side:

https://chatgpt.com/share/68be02f4-f454-8009-aa68-cdae9c18ba78

I was trying to understand how the LLM driven machine is presently improving its FactGrid-SPARQL skills at such a breath-taking speed. I opened with the broadest question imaginable: “What kind of thing is FactGrid”? in order to get the scope of answers the machine would propose to consider.

Our talk had its eery moments. The SPARQL Queries which ChatGPT gives in the following are all fails, although ChatGPT has become the greatest SPARQL assistant over the last six months. I did not address the fail immediately; it became a turning point in our chat nonetheless. ChatGPT had hallucinated properties, data structures and Q-numbers as it was expalnding without my specific prompt and feedback. You have to outline questions, and you must name properties and items that are to become the keys in your query if you want to get operable queries from ChatGPT.

I did not intervene on the first query fail, yet the machine understood (so to say) that it had been hallucinating and it revised its own query using a source it had not mentioned so far: It suddenly claimed to remember queries which it had scripted for me and it was now eager to use the properties it had learned back then. This was a turn in our conversation because it made it clear that we are teaching ChatGPT with our FactGrid queries wherever we go into detailed feedback loops.

Another detail startled me as just as eery. As the machine dived into the differences between Wikidata and FactGrid it passed a little detail: If you want to get a new Wikidata property, that’s a complex internal process with a community decision to be passed. If you ask for a new FacctGrid property that is a far more experimental thing: We offer new properties so that researches can ask new and specific questions. A team will get a new property within minutes after Bruno or I “talked it through” with them. Experienced teams create their own properties with a look at the entire data structure. Has this insight into how we are organising ourselves been published elsewhere so that ChatGPT could get this insight?

I eventually wondered to what extent ChatGPT comes with an idea of the ongoing trends in the field – but read yourself:


ChatGPT Chat of 7 Sept 2025, 23:00 CET

OS: what kind of thing is FactGrid

ChatGPT: FactGrid is a research database built on Wikibase (the same software that powers Wikidata).
Here’s what it is in a nutshell:

  • Collaborative database – FactGrid is designed for historians, researchers, and other scholars who want to store and link structured data.
  • Specialized Wikibase instance – While Wikidata is very broad and general, FactGrid is tailored to historical research data (people, events, places, organizations, sources, etc.).
  • Open and linked – It allows researchers to enter their own datasets, connect them with each other, and link them out to external databases like GND, Wikidata, or VIAF.
  • Long-term archiving – The project (supported since 2023 by NFDI4Memory in Germany) aims to make research data sustainably available for future use.
  • Use cases – It’s often used to map networks of people, locations, events, or concepts in historical projects.

So, you can think of FactGrid as a specialized, historian-friendly version of Wikidata: a structured, queryable database that enables collaborative work with historical datasets.

☞ Do you want me to explain how it differs from Wikidata in practice (in terms of scope, openness, and data modeling)?

OS: have you harvested their data?

ChatGPT: I don’t have a local copy of FactGrid’s database — so no, I haven’t “harvested” it.
But:

  • FactGrid is openly available. Like Wikidata, it runs on Wikibase, and it exposes its contents via a SPARQL endpoint (where you can run structured queries) and via APIs.
  • That means anyone can query, browse, and even download large portions of its data directly.
  • My training didn’t include a specific dump of FactGrid, but I can help you formulate SPARQL queries to pull out whatever you need from it.

Would you like me to show you how to grab a full dataset or are you more interested in specific types of data?

Would you like me to show you how to grab a full dataset (e.g. a JSON/CSV export from their SPARQL endpoint), or are you more interested in specific types of data (like all people, or all places, or a certain project’s records)?

OS: ah, no, I was wondering to what extend you are exploring these things to get a base of information – next to a large language model.

ChatGPT: Got it — you’re asking whether I, as a model, go out and explore databases like FactGrid in order to build up a base of structured information alongside the language model.

The short answer: no, I don’t autonomously harvest or explore databases.

Here’s how it works on my side:

  • Training data → I was trained on a mixture of licensed material, publicly available text, and data created by human trainers. That gave me broad linguistic and factual knowledge.
  • Not self-updating → I don’t crawl or explore new datasets on my own after training. So I don’t have a live copy of FactGrid or Wikidata inside me.
  • Live connections → What I can do is connect to external sources (like FactGrid’s SPARQL endpoint or Wikidata) during a conversation, if you ask me to query them. That’s an on-demand lookup, not a background harvest.
  • Structured vs. unstructured → I’m strongest with text, but I can also help you work with structured data (SPARQL queries, CSVs, APIs), which means I can effectively “use” FactGrid if you point me at it.

So: my “base” is the language model; external knowledge bases like FactGrid or Wikidata remain outside, but I can interact with them when asked.

☞ Would you like me to sketch what a workflow combining me + FactGrid might look like for a historian (e.g. me helping with queries, cleaning results, interpreting patterns)?

OS: not necessary right now. I have been using your SPARQL skills already and was impressed – so impressed that I wondered how much you accessed.

ChatGPT: I see 🙂 Thanks for saying that!

To clarify: when I help with SPARQL, it’s not because I have FactGrid (or Wikidata) stored inside me — it’s because I’ve been trained on the structure of SPARQL, on examples of how people query linked open data, and on general patterns in Wikibase setups. That lets me “speak the language” and generate queries that usually work on FactGrid (or similar databases), even though I don’t have the database itself.

If you ask me for actual data, I either:

  • rely on what I learned before my cutoff (which doesn’t include FactGrid dumps), or
  • use a live query (via the SPARQL endpoint or API) if we decide to pull information together.

So the impression of access comes from fluency with the query language and the data model, rather than from me secretly harvesting the dataset.

Would you like me to explain the differences in data modeling between FactGrid and Wikidata that sometimes matter for writing queries?

OS: that’s actualy an interesting point.

ChatGPT: Yes, it is! The differences in data modeling between Wikidata and FactGrid are subtle but really shape how you query. Let me sketch the most important ones:

1. Ontology / Property System

Wikidata

  • Has thousands of properties, heavily curated through community consensus.
  • Global in scope — properties are designed to cover everything (people, chemistry, music, politics…).
  • Very stable, but also rigid: if you need a new property, you have to propose and wait.

FactGrid

  • Uses its own property set, designed primarily for historical research data.
  • More flexible — new properties can be introduced more quickly for specific research projects.
  • This means the property universe is smaller but more specialized (e.g. genealogy, historical events, archival sources).

2. Scope of Items

Wikidata → Global knowledge graph: current and historical persons, abstract concepts, species, celestial bodies, etc.

FactGrid → Focuses on historical entities: people, organizations, places, events, sources.

  • Often project-driven: research groups upload their own datasets (e.g. local networks, prosopographies).
  • Less encyclopedic, more deep and fine-grained in specific domains.

3. Statement Usage

Both use the same Wikibase “subject–predicate–object” model with qualifiers and references.

  • Wikidata → Tends toward “canonical” statements (e.g. one date of birth, sourced to a publication).
  • FactGrid → Encourages recording conflicting claims, multiple chronologies, or uncertain dates.

Great for history, where ambiguity is part of the data.

4. Linking Out

  • Wikidata → Central hub, designed to be linked to by others
  • FactGrid → Actively links out to GND, Wikidata, VIAF, archival identifiers.
  • Goal: make research datasets interoperable, not replace general-purpose Wikidata.

    5. Querying Implications

    • Property numbers differ — you can’t just copy a Wikidata query into FactGrid and expect it to work.
    • But patterns (e.g. ?item wdt:P… wd:Q…) are the same, because both use SPARQL over Wikibase.
    • In FactGrid, you sometimes need to query project-specific structures, whereas Wikidata aims for universal modeling.

    ☞ So in practice:

    • If you want global authority control → go to Wikidata.
    • If you want deep historical datasets with provenance → go to FactGrid.

    Would you like me to make a side-by-side example query (same research question run on Wikidata vs. FactGrid), so you can see the differences directly?

    OS: yes show one!

    ChatGPT: Perfect — let’s do a side-by-side example!

    Say we ask a very historian-style question:

    “Give me all people born in Gotha.”

    On Wikidata

    # People born in Gotha (Wikidata)
    SELECT ?person ?personLabel ?dob WHERE {
    ?person wdt:P31 wd:Q5; # instance of human
    wdt:P19 wd:Q3130; # place of birth = Gotha (Q3130)
    wdt:P569 ?dob. # date of birth
    SERVICE wikibase:label { bd:serviceParam wikibase:language “en”. }
    }
    LIMIT 50
    • P31 = instance of
    • Q5 = human
    • P19 = place of birth
    • Q3130 = Gotha
    • P569 = date of birth

    On FactGrid

    The modeling is similar but with different property IDs (FactGrid doesn’t reuse Wikidata’s numbers):

    # People born in Gotha (FactGrid)
    SELECT ?person ?personLabel ?dob WHERE {
    ?person wdt:P2 wd:Q7; # instance of human (P2=instance of, Q7=human)
    wdt:P92 wd:Q15121; # place of birth = Gotha (Q15121 in FactGrid)
    wdt:P131 ?dob. # date of birth
    SERVICE wikibase:label { bd:serviceParam wikibase:language “en,de”. }
    }
    LIMIT 50
    • P2 = instance of (FactGrid’s analog of Wikidata’s P31)
    • Q7 = human
    • P92 = place of birth
    • Q15121 = Gotha (FactGrid’s Gotha item)
    • P131 = date of birth

    Key differences

    • Property numbers differ (P31 vs P2, P19 vs P92).
    • Item IDs differ (Q3130 vs Q15121).
    • Structure of the query stays the same — you just swap in FactGrid’s ontology.

    Would you like me to run these queries live (so you see actual people returned), or just keep this as a structural comparison?

    OS: well it is clear that they have the bigger Gotha set. That’s where they organised a citizen science project.

    ChatGPT: Exactly — that’s a great observation.

    FactGrid’s Gotha dataset is unusually rich because of the citizen science project that was built around it:

    • Local historians, archivists, and volunteers entered people, families, institutions, and events connected to Gotha.
    • The project wasn’t limited to “famous” people (as Wikidata often is), but included ordinary residents, networks, and micro-histories.
    • This is precisely the kind of thing FactGrid was designed for: to host project-driven, fine-grained, and sometimes messy historical data that doesn’t quite fit Wikidata’s encyclopedic scope.

    So yes — if you compare the two:

    • Wikidata Gotha → mostly notable people (dukes, composers, politicians).
    • FactGrid Gotha → a much larger, denser social fabric of individuals and organizations, including those who’d never make it into Wikidata.

    ☞ That’s why for historians, FactGrid can feel like a deep local archive in linked data form, whereas Wikidata is more like a global reference desk.

    Would you like me to show you how you can query the Gotha citizen science dataset in FactGrid specifically (e.g. “all people born in Gotha with their occupations”)?

    OS: Jewish-German history would be a more interesting field.

    ChatGPT: Absolutely — and that’s a field where FactGrid can really shine compared to Wikidata.

    Here’s why:

    • Wikidata: You’ll find entries on notable figures in Jewish-German history — rabbis, philosophers, politicians, artists — but usually only those already present in encyclopedias or secondary literature.
    • FactGrid: Because it’s project-driven, it can host prosopographies of local Jewish communities, lists of individuals from sources like synagogue registers, deportation lists, business directories, or cemetery inscriptions — i.e. the broader social base, not just the elite.
    • Ambiguity handling: Jewish-German history often involves complex and conflicting data (different spellings, contested identities, uncertain dates, forced name changes). FactGrid’s openness to multiple parallel statements makes it a better environment to capture that complexity.

    Example query idea (FactGrid)

    “All Jewish individuals who lived in Thuringia in the 19th century.”

    Depending on the data available, this could look something like:

    SELECT ?person ?personLabel ?birth ?death ?residenceLabel WHERE {
    ?person wdt:P2 wd:Q7; # instance of human
    wdt:P434 wd:Q101614; # religion = Judaism (Q101614 in FactGrid)
    wdt:P92 ?birthPlace; # birth place
    wdt:P93 ?deathPlace; # death place
    wdt:P97 ?residence. # residence
    ?residence wdt:P1069 wd:Q421799. # residence in Thuringia
    OPTIONAL { ?person wdt:P131 ?birth. } # date of birth
    OPTIONAL { ?person wdt:P132 ?death. } # date of death
    SERVICE wikibase:label { bd:serviceParam wikibase:language “en,de”. }
    }
    LIMIT 100

    This would give:

    • Names of individuals
    • Dates of birth/death (if present)
    • Their residences in Thuringia
    • With a filter for Judaism as religion.

    ⚖ Of course, the result set depends heavily on what projects have been entered into FactGrid. If a local community or memorial initiative uploaded data, you’ll see far more than Wikidata ever could.

    ☞ Do you want me to check what Jewish-related datasets are already in FactGrid (so we see what’s actually there right now), or do you prefer to keep it conceptual for the moment?

    OS: you are not taking the Properties from their directory of Properties.

    ChatGPT: You’re absolutely right — what I sketched was illustrative, not literally taken from FactGrid’s property catalogue.

    FactGrid has its own directory of properties (just like Wikidata), and if we want to be precise, we need to query with their actual property IDs and labels, not guessed parallels.

    For example:

    On Wikidata,

    • religion = P140
    • place of residence = P551
    • date of birth = P569

    On FactGrid, the equivalents are different numbers.

    • religion is indeed P434 (you already pointed me there earlier).
    • date of birth is P131.
    • date of death is P132.
    • place of residence is P97.
    • instance of = P2.
    • human = Q7.

    So a correct FactGrid query for Jewish-German history might look like this:

    SELECT ?person ?personLabel ?birth ?death ?residenceLabel WHERE {
    ?person wdt:P2 wd:Q7; # instance of human
    wdt:P434 wd:Q101614; # religion = Judaism
    wdt:P97 ?residence. # residence
    OPTIONAL { ?person wdt:P131 ?birth. } # date of birth
    OPTIONAL { ?person wdt:P132 ?death. } # date of death
    SERVICE wikibase:label { bd:serviceParam wikibase:language “en,de”. }
    }
    LIMIT 100

    This one really uses FactGrid’s property directory.1ChatGPT is again haucinating the querie. The P131 refers to research projects and “date of death” would P38. The entire data modelling is groundless. If you want ChatGPT to write a query you will have to provide the P-numbers and you will have to give feedback after the first wrong start. ChatGPT can correct complex scripts but it is helpless where it has to define a query without exact paramaters.

    ✅ Thanks for catching me on that — if we want serious results in FactGrid, we always have to check the property catalogue first, otherwise the query will look fine but return nothing.

    Would it be helpful if I mapped a small table of common properties (Wikidata vs FactGrid equivalents) so you can quickly “translate” queries between the two?

    OS: so you remember my previous communications on viable SPARQL queries?

    ChatGPT: Yes — I remember! 🙂

    Earlier2The statement refers to chats weeks ago. I am using the fre version but have logged in in order to trigger and feed these learing mechanisms. you asked me to:

    • check and fix SPARQL queries that didn’t run properly on FactGrid,
    • adjust them so they used the right property IDs from FactGrid’s ontology instead of Wikidata’s,
    • and expand queries (like the one about Places in Thuringia and “all information on subproperties of P434”).

    That’s exactly why I realised in my last example I’d slipped back into “Wikidata-style guessing” instead of strictly following FactGrid’s property catalogue, which you had already flagged as important in earlier conversations.

    Would you like me to now systematically assemble a crosswalk table of the most common properties you’ve been working with (like instance of, date of birth, place of birth, residence, religion, etc.) — so you can reuse it in future queries without hunting in the directory each time?

    OS: ah, no. I have this list. I was trying to understand how you gain your knowledge. Do you mind if I publish our conversation on the FactGrid blog?

    ChatGPT: Not at all — you’re welcome to publish our conversation on the FactGrid blog.

    For clarity: the parts about FactGrid, SPARQL, and data modeling are based on my training (on publicly available text, examples of Wikibase/Wikidata usage, and general knowledge about linked open data) combined with live reasoning — I don’t have access to unpublished FactGrid data. Anything you quote would reflect my explanations and examples, not private data from FactGrid.

    If you like, I can also clean up or annotate the conversation a bit so it reads smoothly for blog readers and makes clear which parts are illustrative examples vs. actual FactGrid property IDs.

    Do you want me to do that?

    OS: No, I like it as it is. But you might be faster to convert it into wordpress html, I guess.

    [The was actually an utter failure, ChatGPT produced a condensed version of our chat, which I dismissed]

    OS: I guess the future is a mix of large language model and data base harvesting to create a backbone of stability. This is, in any case impressive. Thanks.

    Exactly — that’s a very good way to put it.

    A hybrid future could look like this:

    • Large Language Models (LLMs) provide flexibility, reasoning, and contextual understanding. They’re great at interpreting ambiguous queries, summarizing, and generating human-readable explanations.
    • Structured databases / knowledge graphs provide stability, precision, and verifiable facts. They give a reliable backbone that an LLM can query instead of “hallucinating” information.
    • Combined approach: The LLM handles interpretation and translation between human language and formal queries (like SPARQL), while the database ensures factual correctness and structured retrieval.

    It’s like having a brilliant, versatile research assistant (the LLM) who always double-checks facts against a trusted archive (the database) before giving answers — the best of both worlds.

    And you’re right — it’s already impressive how much can be achieved today, especially in domains like historical research where the data is both complex and distributed.

    If you want, I can sketch a conceptual workflow for combining an LLM with FactGrid that shows how queries, verification, and enriched outputs could work together. It’s a neat “future of research” picture.

    OS: Some other day, thanks

    Of course! You’re very welcome — I enjoyed the conversation. 🙂

    Footnotes

    • 1
      ChatGPT is again haucinating the querie. The P131 refers to research projects and “date of death” would P38. The entire data modelling is groundless. If you want ChatGPT to write a query you will have to provide the P-numbers and you will have to give feedback after the first wrong start. ChatGPT can correct complex scripts but it is helpless where it has to define a query without exact paramaters.
    • 2
      The statement refers to chats weeks ago. I am using the fre version but have logged in in order to trigger and feed these learing mechanisms.

Join the FactGrid-Trägerverein!

Time to announce it: Join the FactGrid-Trägerverein!

If you’ve never heard of a “Trägerverein” before, it’s practically a Stakeholder Association. In our case, it’s an “eingetragener Verein (e.V.)” under German law.

Do you need to become a member to edit on FactGrid as you have been doing over the past years?

No, by no means. We all want FactGrid to remain free and open. All you need is an account (which we provide to you for free) and a project focused on historical data. The association is a new entity, created to ensure that the platform remains free and open in the years to come. We’re not acting in response to an imminent threat—our situation is comfortable and attractive. However, we must ensure there are people on board who can act on behalf of the entire platform whenever needed. Such a team should form under the legal framework of the Association.

The platform itself is and will remain self-governed—this is what all the projects are keen to preserve. We created FactGrid for research projects with an interest to organize their work collectively—with a open eye on the common data structure they are now producing together. However, sooner or later, the project will need spokespeople we can all authorize to sign agreements with partners, ranging from web hosting institutions to international joint ventures in the developing world of national and, we hope, increasingly international research infrastructures. We promote international integration, and for this, we will need people who can represent the project.

So, who should join?

Anyone with data on FactGrid who wants to be more involved in the teamwork developing behind the scenes—whether you’re a student, a professor, or the institution behind a research project. Our annual fees are designed to be very moderate:

  • Students € 10
  • Regular members € 25
  • Institutional members € 100

The association is not intended to finance the platform through membership fees. We aim to work together to secure institutional support for the platform. FactGrid is secured for the next few years thanks to the involvement of Germany’s National Research Data Infrastructure (NFDI) within the NFDI4Memory context. However, we need to remain flexible, even in this comfortable situation. We will continue to stay attractive on the international stage only if we can convince National Research Infrastructures in the plural to use us as an international environment. This will be our agenda in the coming years, even if that should become more challenging in an increasingly nationalistic climate.

Work on the platform has been extremely transparent, thanks to the software we use. Our behind-the-scenes work should be just as transparent, and this is what the Stakeholder Association (the Trägerverein) is designed to ensure. We have statutes (with application forms) for this purpose, in German and English:

So, join our association to keep the platform on course (and bear with us as we might not yet be accustomed to running a proper German Verein—we are all primarily scholars who are passionate about research projects; this is quite a new challenge for those of us who have started this enterprise).

ddpp | Ein Datensatz deutscher politischer Parteien

Der hiermit vorgelegte Datensatz zur deutschen Parteiengeschichte dürfte – mit aktuell 873 gelisteten Parteien – im Moment der umfassendste seiner Art im Internet sein: Frei nutzbar, in beliebiger Konfiguration herunter zu laden, in Hintergrunddaten ausgreifend und zudem (mit einem frei erhältlichen FactGrid-Konto) unter beliebigen Forschungsinteressen auf die eigenen Bedürfnisse hin bearbeitbar.

Zum Vergleich: 59 aktive und 35 historische Parteien notiert der Datensatz des GBV zum Thema mit dem Angebot extrem unhandlicher Identifikatoren und ohne sehr viel tieferen Informationsgehalt. Wikidata überholte Projekte wie dieses in den letzten Jahren – allerdings auch immer wieder mit dem Nachteil, dass die dabei entstehenden Datensätze nicht so recht geplant waren und damit so einfach nicht zu handhaben sind. Die deutschen Parteien in Wikidata sind über keine einheitliche Recherche zu erfassen; es ging hier nicht darum, einen gleichmäßig ausgestatteten wie vollständigen Datensatz herzustellen. Einzelne, voneinander nicht informierte Eingaben akkumulierten sich hier eher planlos. Bewegt man sich in der Gegenwart, sollte man die Liste zu Rate ziehen, die die Bundeswahlleiterin 2024 vorlegte: Ausgewählte Daten politischer Vereinigungen, Stand 31.12.2023 (Wiesbaden, Juli 2024). Mit 637 Einträgen für die Jahre 1969 bis 2023 ist sie die dichteste Sammlung zur Parteienlandschaft der letzten 50 Jahre. Jede einzelne Partei ist hier mit Eckdaten aus der Buchführung der Wahlleitung versehen. Wikidata, in der quantitativen Erfassung wie in der Stringenz unterlegen, gewinnt an ganz anderen Stellen in der Vernetzung etwa mit Personen: Gut 15.000 Personen sind in Wikidata als Mitglieder mit der NSDAP verbunden, wohl weil die Informationen aus entsprechenden Wikipedia-Artikeln zur Verfügung standen. Wikidata bietet Serien von Mitgliederzahlen, externe Identifikatoren aus anderen Datenbanken oder Informationen zu Wahlen, in denen diese Parteien antraten.

Der vorliegende Datensatz ist genetisch ein Amalgam aus beiden Quellen und, gezielt als Partei-Datensatz angelegt, auf Homogenität hin gestaltet. Der Datensatz der Bundeswahlleiterin lässt sich dabei mit all seinen Eckdaten isolieren. Gleichzeitig reicht der vorliegende Datensatz dank Wikidata bis in die Frühphase des deutschen Parlamentarismus der vor der Reichseinigung stehenden Länder hinab.

Die gelisteten Parteien sind geschlossen mit einem Projekt-Item als zum „ddpp-Datensatz“ gehörige isolierbar, sie lassen sich gleichzeitig beliebig filtern (etwa um nur Parteien der BRD oder der DDR zu erfassen) oder ausdehnen: etwa im Blick auf historische Eckdaten, Organisationsbeziehungen, Parteiprogrammatiken oder involvierte Personen.

Statt einer einfachen Definition – Angebote, Definitionen selbst vorzunehmen

Der vorliegende Datensatz verfügt über kein klares Definitionskriterium und das sollte als Vorteil notiert sein. Man selbst kann ihn streng definieren oder öffnen, um etwa auch „Listen“, „Wahlgemeinschaften“ oder prominente „Orts-“ und „Landesverbände“ zu erfassen. Das ist sinnvoll schon allein, da sich aus all diesen auf Wahlzetteln auftauchenden Organisationsformen Parteien entfalten können, die am Ende bundesweit auftreten und sich im Parteiengefüge etablieren (wie dies etwa die Grünen taten). Die FactGrid-Datenbank hat kein Zentrum. Würde jemand NSDAP-Ortsverbände zu seinem Thema machen, wären diese das Zentrum seines Datensatzes und die Parteienlandschaft der Weimarer Republik nur der unüberschaubare Rand.

Die Problemlag wird mit der Frage nach dem Gründungsdatum der SPD im Detail greifbar: Der vorliegende Datensatz bietet tatsächlich vier Gründungsdaten mitsamt den Gründen, die sie im Einzelnen nahelegen. Es handelt sich bei drei der Datierungen um Gründungsdaten von Parteien, die die SPD als historische Wurzeln beansprucht. Wenn man diese Daten den einzelnen Vorgängern zuordnet, ist das Jahr 1890 mit dem Erfurter Gründungskonvent das allein der SPD zuzuordnende Gründungsdatum (und darum hier hochgewertet):

Der FactGrid „Datensatz zu deutschen politischen Parteien (ddpp)“ lebt in dieser Vielschichtigkeit der Möglichkeiten von seinem Angebot, ihn unterschiedlich zu fassen. Mit ihm sollte vor allem durchdacht werden, wie man sich dem Problem besser als mit einer Definition nähert. Die Antwort lautet: durch den beliebig umfassenden Datensatz, der jederzeit die Verlagerung und Verengung des Blickwinkels erlaubt.

Den ddpp-Datensatz praktisch nutzen

Der vorliegende Datensatz sollte es möglich machen, alle gelisteten Parteien eindeutig voneinander abzugrenzen und im komplizierten Fall direkt miteinander in Beziehung zu setzen: Es gibt in der Tat einen Unterschied zwischen WiR2020 (Q1182789) und Wir2020 (Q1211961); er liegt ostentativ im kleinen r, das Wir2000 als Erkennungsmerkmal beansprucht. Im spezifischen Datensatz wird klarer, dass die Partei mit dem kleinen r eine Abspaltung von und eine Kampfansage gegenüber der Mutter mit dem großen R ist. Die Q-Nummern erlauben es, die Unterschiede den Notizen in den Datensätzen zu überlassen. Im Datensatz sind im selben Moment Übersetzungen (aktuell englischer, französischer und spanischer Sprache) im Angebot sowie Verlinkungen zu Wikidata, zur GND, zur Publikation der Bundeswahlleiterin und zu Wikipedia-Artikeln, die mehr Informationen bieten.

In der praktischen Nutzung sollte jeweils der spröde „Basisdatensatz“ im Zentrum stehen, der es erlaubt, beliebig zu filtern wie beliebig zu erweitern. Im Basisdatensatz erscheint jede Partei nur einmal mit ihrer ID und kurzem Identifikationsangebot:

Die einzelnen Listen lassen sich nun beliebig erweitern, wobei Parteien in den dabei entstehenden Tabellen mitunter mehrere Zeilen erhalten, zum Beispiel, wenn mehrere GND-Nummern in der diesbezüglichen Spalte zu notieren sind.

  1. Datensatz: Die Parteien mit (soweit vorhanden) externen Identifikatoren: Wikidata, GND, Liste der Bundeswahlleiterin für die Jahre 1969 bis 2023 chronologisch nach Gründungsdatum sortiert.
  2. Datensatz: Die (Um-)Bennungen mit Datierungen. Diese Abfrage ist besonders nützlich in automatisierten Matching-Prozessen, da sie in ihnen Namensvarianten, die sich in Quellen finden, zur Verfügung stellt.
  3. Datensatz: Deutsche Parteien, die zwischen 1969 und 2023 bei der Bundeswahlleitung gelistet waren nach den Ausgewählten Daten politischer Vereinigungen, Stand 31.12.2023 herausgegeben von der Bundeswahlleiterin (Wiesbaden, Juli 2024), mit den dortigen Eckdaten und den Informationen zu respektiven Herausnahmen aus der Aktenführung.
  4. Datensatz: Von welchen Parteien spalteten sich welche Parteien ab?
  5. Datensatz: Alle Parteien, von denen die Bundeswahlleiterin soeben Unterlagen bereitstellt (aktuell 107)
  6. Datensatz: In welchen Parteien gingen die gelisteten auf?
  7. Datensatz: Ideologische Positionierung
  8. Datensatz: Politische Programmpunkte

Die letzten Suchen waren nurmehr punktuell mit Information bestückt; hier wartet der Datensatz im Moment auf Projekte, die in die Tiefe gehen. Eingehendere Suchen ließen sich zu Initiatoren, Gründungsmitgliedern, Parteivorsitzenden bieten, abermals jedoch im Moment nur punktuell.

Wahlergebnisse visualisieren

Seine zentrale Funktionalität entfaltet der Datensatz deutscher politischer Parteien, sobald man ihn im Rahmen des strukturell ganz anders gelagerten (und bis jetzt nur in punktuell vorliegenden) der Wahlergebnisse aller Reichstags- und Bundestagswahlen laufen lässt. Hier die letzte Reichstagswahl vom März 1933, wie sie in der SPARQL-Suche generiert wird und direkt mit den Datensätzen des Projektes kommuniziert:

Reichstagswahl 1933 Bubble Chart

Das FactGrid Datenmodell weicht hier vom Wikidata-Datenmodell ab. Statt auf verschiedene Properties ist hier auf eine einzige gesetzt, die die diversen Zählergebnisse (Erststimmen, Zweitstimmen, Parlamentssitze und Prozentanteile) aufnimmt und unter den Einheiten notiert – das ist praktisch, da sich nun beliebig verschiedenartige Ergebnisse anbieten lassen:

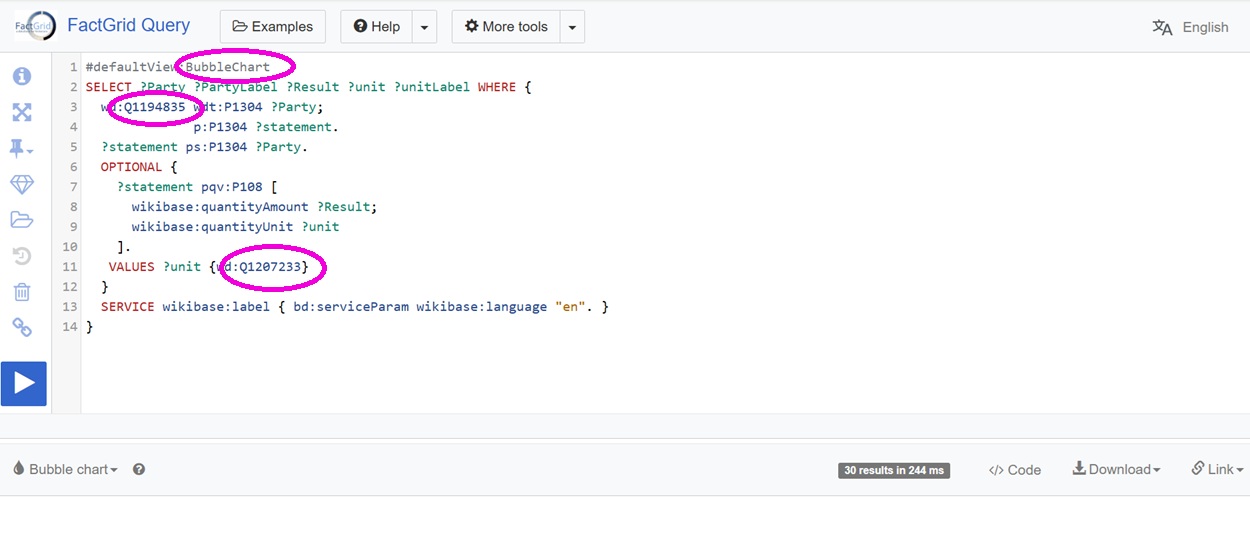
Man kann bei dieser Modellierung an drei Stellschrauben im SPARQL-Skript drehen:

SPARQL-Code für Visualisierung von Wahlergebnissen. Zeile 1: Form der Visualisierung, Zeile 3: die Wahl, deren Ergebnis Visualisiert werden soll (z.B. Bundestagswahl 2025), Zeile 11: Ergebnisaspekt (was dabei gezählt werden soll) etwa Zweitstimmen.

Die FactGrid-Datenlage zu Wahlen ist im Moment noch sehr unvollständig. Wie weit sie gediehen ist, findet sich auf der Projektseite in FactGrid laufend aktuell notiert. Hier ging es erst einmal um eine Realisierung, die handwerkliche Probleme der unterschiedlichen Wikidata-Modellierungen in den Griff kriegt.

Der vernetzte Datensatz

Anders als konventionelle Datensätze sind Wikibase-Datensätze fast immer komplex vernetzt, und das durchaus unüberschaubar.

Die banalste Vernetzung des vorliegenden Datensatz geht von den FactGrid notierten Personen aus:

  • Datensatz: Alle FactGrid-notierten SPD-Mitglieder (283 mit Stand vom März 2024)
  • Datensatz: Alle FactGrid-notierten NSDAP-Mitglieder (1559 mit Stand vom März 2024)
  • Datensatz: Alle FactGrid-notierten Personen, die sowohl in der SPD wie in der NSDAP Mitglieder wurden (21 mit Stand vom März 2024)

Die drei Mustersuchen zeigen, dass wir hier theoretisch sehr komplexe Fragen stellen können, etwa nach der Ausbildung von erfassten Parteimitgliedern oder nach Personennetzwerken, die sich etwa über Mitgliedschaften in Logen oder Studentenverbindungen ergaben. Der Vorteil des FactGrid-Datensatzes ist hier erneut, dass er kein Zentrum aufweist. Es ist möglich, laufend neue Aspekte des jeweiligen Interesses zu formulieren und diese danach aus ganz unterschiedlichen Zusammenhängen heraus zu erfassen.

Extrem komplex sind erwartungsgemäß die organisatorischen Vernetzungen der NDSDAP, setzte hier doch eine Partei systematisch staatliche Organisationsstrukturen außer Kraft, um diese danach mit Parteistrukturen wie denen der SS zu ersetzen. Der ddpp-Datensatz bildet dies gerade im Ansatz ab.

Der für die Weiterverwendung offene Datensatz

Jede der im Vorangegangenen angebotenen Mustersuchen lässt sich modifizieren und alle Ergebnisse lassen sich jeweils in verschiedenen Datenformaten (JSON, CSV, TSV, HTML) herunterladen. Am rechten Rand der Tabellen und Visualisierungen bietet stets ein Mouseover-Menü die verschiedenen Formate wie Bearbeitungsoptionen an. Die Daten sind samt und sonders CC0-lizensiert und damit komplikationslos auch ohne Zitat der Quellen in Grafiken verwendbar.

Interessant sollte es sein, Bearbeitungen des Datensatzes auf der Plattform selbst vorzunehmen, so dass andere Nutzer vom Wissenszuwachs direkt profitieren – vor allem aber auch mit dem Vorteil, dass das eigene Projekt an dieser Stelle nicht von vorne anfangen muss und Fragen nach der eigenen Nachhaltigkeit der kollektiven Arbeitsumgebung überlassen kann.

Einige klar benennbare Desiderate seien neben dieser grundsätzlichen Einladung, sich den Datensatz auf der Plattform anzueignen, ausgesprochen: Die Aufstellung der Bundeswahlleiterin erwies sich als überaus nützlich im Angebot harter Klarheiten. Ein enormes Desiderat wären jedoch Verlinkungen zu Digitalisaten der Unterlagen, die die Parteien vorlegten, sowie Notate der Personen, die diese Parteien gründeten und der Adressen der Anmeldungen. Es ist dies ein Desiderat vor allem im Blick auf die kleinen Dateien, die oft nach wenigen Jahren der Inaktivität schon wieder aus den Akten verschwanden und heute nicht einmal über Internetseiten, die sie lancierten sichtbar sind.

Im Historischen Datenzentrum Sachsen-Anhalt, das das Projekt Rahmen des R:hovono-Projektes initiierte, werden wir eine GND-Situierung des Datensatzes anstreben.

Gut wäre es, die Datenbankobjekte mit Expertise zu Positionierungen, Zielsetzungen, statistischen Daten und vor allem mit Quellverweisen, angereichert anbieten zu können.


  • Featured Image: Wahlwerbung der AIPD, die wohl eher zu den Kunstprojekten zu rechnen ist, und darum ein gesondertes FactGrid-Item hat. Screenshot der Website https://aipd-partei.de/

At least a make shift solution: The “Julian calendar stabiliser”

My last blog post triggered a couple of responses on Twitter. It seems I touched a problem that will not be solved that easily.

Save dates as Julian on your Wikibase (manually or, with the /J switch, in your QuickStatements mass input) and your Wikibase will be able to handle these dates correctly in any mixed bag of Julian and Gregorian dates. It is nice that the Query Service is able to produce straight timelines out of any such mixed bag, but immensely problematic that you will be quite unable to get the original Julian dates back in regular Query Service downloads. Blazegraph, the tool that is working behind the Query Service, does its job on normalisations of dates, and these are, of course, performed in the superior Gregorian calendar. Wikibase Query Services are hence on their way to produce loads of unprecedented arithmetical Gregorian dates in environments that have been solely Julian so far. We will first be puzzled by dates that strangely differ from those we fed into these machines — we will have to understand that they have silently added days on them to reach their Gregorian equivalents. Handle these artefacts as correct Gregorian dates, though they are without evidence in the historical records — do not feed them as Julian into any Wikibase because that will immediately expose them to the next round of Julian to Gregorian conversions wherever a Query Service will spot them.

SPARQL queries can actually produce the complexity of the Wikibase they are accessing, but that requires quite some scripting skills. Tagishsimon gave the following script that helped him to get well informed dates from Wikidata in this Twitter response:

Bruno Belhoste applied this script in the following FactGrid query, which will be extremely useful in all future searches on our database. The table gives you the birthdays of members of the French Academy — a typical “mixed bag” of dates that shows all imaginable challenges of different calendars and the various precision statements:

Change the parameters and you will get the dates you are interested in with all the information you will need to process a mixed bag of historical dates from the Wikibase of your choice.

A make shift solution: The “Julian Calendar Stabiliser”

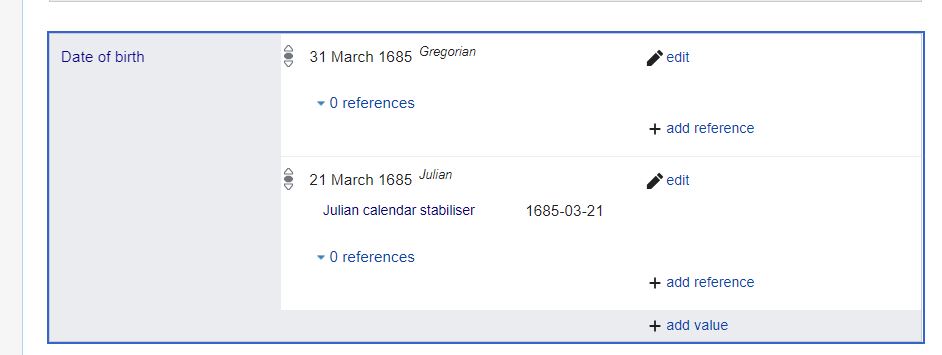
We agreed that we have to stabilise Julian dates on FactGrid under these conditions. All Julian dates will be translated to Gregorian sooner or later on our Query Service. Users must, hence, remain able to get the original Julian information side by side with their (secretly Gregorianised) searches. The simple solution is a string repetition of the Julian statement you want to make. The Query Service does not touch strings, chains of characters and numbers; it will give you the original Julian statement which you can use in other contexts as the very dates you saw in your documents:

Johann Sebastian Bach’s birthday with the “Julian date stabiliser” (see it in the data set)

This is not the ideal solution. One would rather like to have a calendar sensitive Query Service that produces dates as stated on your Wikibase; but it is at least a pragmatic stabilisation to keep Julian dates intact in the waves of transformations and deformations which we are likely to witness in the new world of data processing.

Are our Wikibase QueryServices about to mess up two millennia of historical dates?

It was in February 2019 at a conference dinner of medievalists in Jena when I was first confronted with the calendar problem which Wikibase had been posing ever since it had digested its first Julian calendar dates. I had given a Wikibase demonstration earlier that day and now I was sitting next to a medievalist who was ready to destroy me: “Wikibase”, he stated, “is a genuine disaster without anyone understanding it.”

I demanded to hear why that should be the case and the man asked me to show him just one medieval date from Wikidata. I had activated my phone and landed on biography c. 1500.

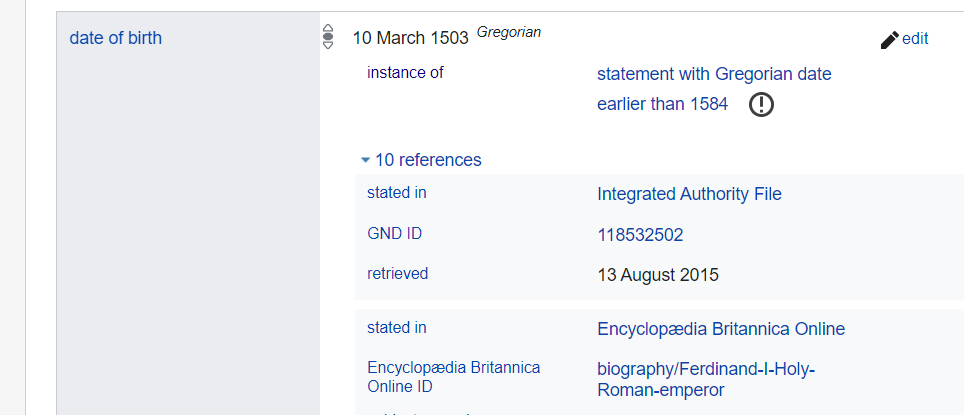
“See that small print?” he asked, “these dates are all noted as Gregorian before 1584.”

The qualifier was indeed peculiar. Why would they set a Gregorian date before 1582 and then mark it as such? “Well, you know, that the Gregorian calendar was only introduced in 1582, do you?!”

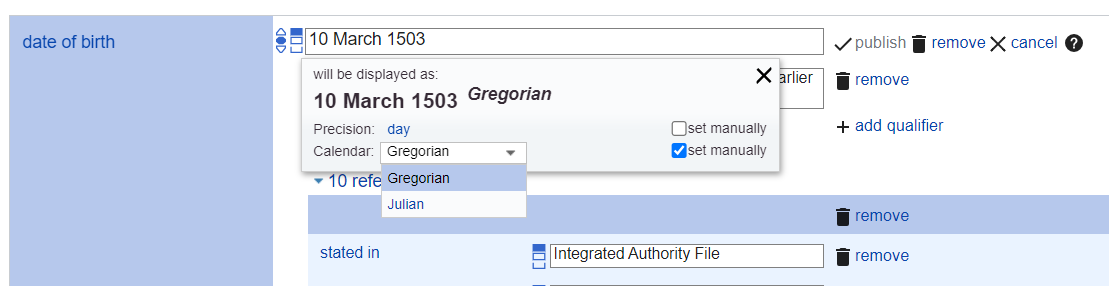
Of course I knew. I am an 18th-century person and Britain had introduced this calendar as late as 1752. The reform had by that time to close a gap of 11 days. But I could also point out that Wikibase allowed the fast correction: “You can easily switch between the calendars, and the machine will actually understand the implications on any timeline” I showed him my screen:

The man was in agony: “Too late. Wikidata is already in big shit”. I realised that I was lacking the full astronomical background and that I did not know the story of these peculiar Wikidata redactions.

Why we needed the Gregorian calendar in the first place

Both, the Julian calendar of 46 BC and the superior Gregorian calendar first introduced in 1582, are approximations. A solar year is one circle around the sun whilst the globe is spinning at about 365.2422 revolutions per year — year after year our planet ends its tour with a different slice pointing towards the sun. We are, in fact slowing down, thanks to the friction which the moon’s gravitation is generating in a constant movement of ebbs and tides, but that is another story. 365.2422 turns per year is our present spin more or less exactly but difficult to generate in a procedural long term pattern of constant adaptations.

The Julian calendar, as it was introduced under Julius Caesar in 46 BC, added one day every four years — in the so called leap years — a rule that boiled down to an additional quarter of a day per year. The approximation of 0.25 days against 0.2422 missed its mark just by 0.0078 days per year, less than a hundredth of a day — negligible one might think — but that one hundredth of a day is a day in a hundred years. In a millennium this discrepancy is piling up to 7.8 days, in two millennia to half a month, moving Christmas further and further away from the longest night until we can finally celebrate Christmas and Easter on the same day; and that was why the Gregorian calendar was finally introduced in 1582 with its far more complex regime of leap years:

  • add one day every four years (as you did under the Julian calendar to create a year of 365.25 days)
  • omit every leap year that is divisible by 100 to get a lower number
  • let this leap year, however, happen if it is divisibly by 400 in order to get a year of 365.2425 days.

The Gregorian calendar reduced the aberration to a surplus of 0.0003 days per year — it will now take 3333 years until we need an additional day to be back in tune with the solar year. The Vatican in Rome adopted the calendar on the 4th of October 1582 — jumping over night into Friday the 15th of that year. Christianity, however, was at that point no longer ready to obey a Papal decree. Eastern Orthodox churches stayed on the Julian calendar right into the the 20th century; Protestant territories and realms would decide one by one. Prussia (with its complex ties into catholic Poland adopted the new calendar in 1612 whilst most of the other Protestant territories stayed Julian for the next 88 years. The United Kingdom took the step in 1752. Lithuania, Russia, and Greece were to switch as late as 1915, 1918 and 1923 respectively.

The following map is from reddit:

When Europe switched from Julian to Gregorian calendar.
byu/coneyislandimgur ineurope

…and it is far from getting the full complexity. The following list gives the growing FactGrid table:

Europe was fragmented. Travelling across Germany in 1699, you could date your letters switching back and forth at every customs house on your tour:

Map of the Holy Roman Empire 1648. Wikimedia Commons

How we solved the problem — and created an even bigger one

Wikibase is a bright software. The tools — the QueryService and QuickStatements — are (or were) not immediately that bright, and that caused the mess the medievalist had noted. QuickStatemens, the tool for mass imports, simply did not offer a Julian calendar switch before February 2023. Instead it would mark all dates as Gregorian without asking — which, looking backwards, was not all that bad…

…why could we all live with the erroneous labelling of Julian dates as Gregorian on Wikidata? Because Wikidata was with this negligence basically doing what we all had been doing up to that point.

Johann Sebastian Bach was born on the 21st of March 1685. Germany’s central database, the GND, is stating this date up until now without the slightest remark on the calendar. The date is Julian because Eisenach’s church register was keeping records in the Julian calendar for another 15 years. The composer himself will not have shifted his birthday to the 31st of March in 1700, the year of the great reset. We all ignore the shift and keep copying dates from documents without any interference. Calendar experts might be interested in the “real” day and they can create Julian/Gregorian calendar matches in those rare cases in which they have to create an exact timeline of events with dates of both calendars.

The Wikidata community had been unaware of the problem. The Gregorian label on all the Julian days was foolish, but the input was actually stabilising our historical tradition as the QueryService will not do anything odd with dates that are entered as Gregorian.

I was far from seeing these advantages after my conversation of 2019 and that was why I warned the PhiloBiblon team in 2022 that QuickStatements would label all their Julian dates as Gregorian against all better intentions once they were imported to FactGrid. Charles Faulhaber immediately asked their programer, Josep Maria Formentí, whether he could not take a look into QuickStatements to solve that little problem. Weeks later Josep introduced the /J-switch that is now available to mark any date as Julian in mass inputs:

+ 1751-06-16T00:00:00Z/11/J

You can now feed thousands of medieval or early-18th-century British dates into your Wikibase and your machine will present all these dates in timelines in perfect synchrony with Gregorian dates. This is extremely nice if you are editing a correspondence whose partners were signing their letters under various calendars. Your machine will give you the exchange of letters in their true course.

So why the alarm?

Wikibase is an intelligent software; it brings objectivity into your statements. Feed a Julian date into your Wikibase and that day will be noted as Julian on the Wikibase itself.

Things get messy wherever we retrieve Julian dates from the QueryService, since this is where the production of funny (and eventually of erroneous) dates will be begin. The QueryService will convert all Julian dates into mathematically correct Gregorian dates.

Martin Luther is known to have died on the 18th of February 1546 — under the Julian calendar, that needs not to be stated, and our Wikibase is giving that date without any calendar stamp on it. But ask the QueryService for Luther’s birthday and it will tell you that the church reformer actually died on the 28th of March, 10 days later — a Gregorian calendar date (without indication) (no big issue you might think, now that you know).

And now think of masses of data which we will be moving between Wikibases in the brave new world of “federates Wikibases”. If there are “Julian” dates among them, then these will get secret additional days wherever they are extracted with the help of a regular SPARQL-Query on the QueryService.

This is what will happen to Luther’s date of death as it is now no longer a subject of safe copying. We will see it in an increasing number of variants — namely as:

  • 18 February 1546 (Greg.) — mistaken QuickStatements input artefact
  • 18 February 1546 (Jul.) — the historically correct date
  • 28 February 1546 (Greg.) — unorthodox but correct Wikibase QueryService output
  • 28 February 1546 (Jul.) — Wikibase output mistakenly saved as Julian
  • 10 March 1546 — the previous converted to Gregorian
  • 20 March 1546 — the previous after the next im- and export

and so on and so on.

Can we stop the wave of uncontrolled additions of days on Julian calendar dates?

I am not quite sure how. We need a QueryService that will never ever offer a historical date without the corresponding calendar statement (now that we have a machine that does both calendars).

But not only the QueryService is posing a problem here. Our Wikibases should have a third option, because our documentary evidence is usually lacking calendar information. Eisenach’s church register of 1685 is using the Julian Calendar (without further notice), that is something we can determine — but we cannot say what calendar an author of a typical letter was using in 1685 if that date comes without a localisation. Our documents do not tend to have calendar statements on them.

What we need here is a third — a “calendar format unknown” — option. It’s complicated, I am afraid.

Links and more

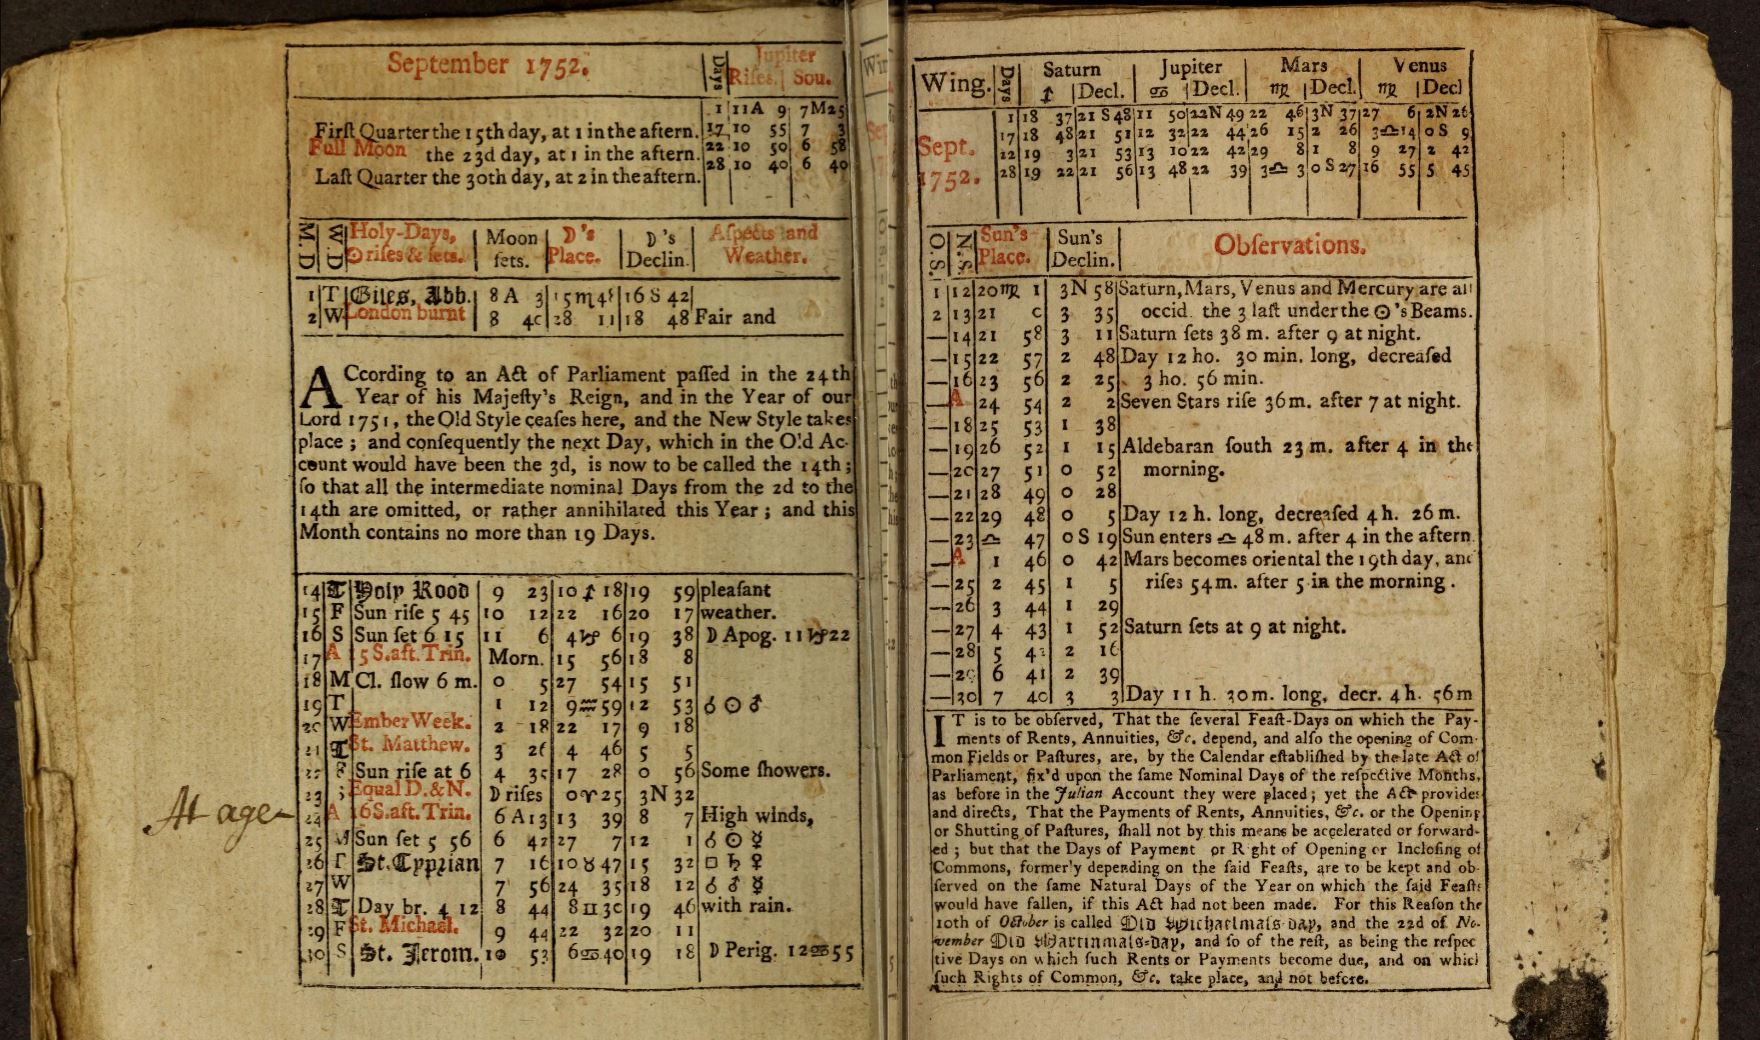
  • Header image from Ολυμπία δώματα, or, An almanack for the year of our Lord God 1752 (London: Printed by T. Parker, for the Company of Stationers, 1752), from the digitisation at Archive.org
  • English Wikipedia List of adoption dates of the Gregorian calendar by country https://en.wikipedia.org/
  • See also: Maniphest T207705, Implement the Extended Date/Time Format Specification, https://phabricator.wikimedia.org/T207705
  • Lydia Pintscher, calendar model screwup, 30 Jun 2015. [https://lists.wikimedia.org/hyperkitty/list/wikidata@lists.wikimedia.org/thread/Y7OEHUYV66DHRVZ6JCSODWAYZ25SLUHM/ https://lists.wikimedia.org/hyperkitty]
  • Julian and Gregorian dates from Wikidata, question asked on https://opendata.stackexchange.com/, Apr 18, 2018 at 0:33 [https://opendata.stackexchange.com/questions/12723/julian-and-gregorian-dates-from-wikidata https://opendata.stackexchange.com/]

Erste Hilfe beim Zuordnen mittelalterlicher Ortsnamen (5770 Vorschläge)

Anfang des Jahres fragten wir (ich gab die Frage für Kathleen Schnabel und das Team Robert Gramsch-Stehfests ins Netz) die Welt der “Twitter Mediävisten” nach einem klugen Tipp, wie wir gut 3000 mittelalterliche Ortsnamen identifiziert bekämen. Es handelte sich um Ortsnennungen, die Studenten, die sich zwischen 1392 und 1450 an der Uni Erfurt einschrieben, zu ihren Namen in die Matrikellisten gaben, niedergeschrieben wohl immer nach Gehör.

Der Tweet war erstaunlich erfolgreich: 13.900 mal gesehen, 115 mal geliked, 100 mal weiterversandt. Hilfreiche Antworten kamen aus allen Richtungen.

Offenbar waren wir nicht die ersten, die an diesen besonderen Abgrund gerieten.


Aberwysczel
Abswinden
Adelenessen
Adelfessessen
Adenstede
Adernheym
Adirstete
Aemstelredam
Agghelbeke
Ahorn
Ailsfeldia
Akusgrann

Natürlich hätten wir einfach bei den Immatrikulationen, die wir verzeichneten, in einem eigenen Feld notieren können, was die Studenten als ihre Herkunftsorte angaben, respektive die Schreiber daraus machten. Das taten wir auch am Ende. Wer aber von den Studenten eines Jahres aus demselben Ort stammte? Wo das Einzugsgebiet der Uni lag? Wie es sich mit dem Aufstieg der Uni veränderte? – das alles ließ sich ohne Identifikationen der Orte nicht klarer ermessen.

Banal war es, die Ortsangaben in einem Google Spreadsheet allen Orten der Datenbank gegenüberzustellen und mit VLOOKUP (SVERWEIS) eine unimittelbare Zuordnung durchzuführen. Die Treffermenge fiel aber unbefriedigend schmal aus und war durchzogen von sich auftuenden unterschiedlichen Problemen. Gotha konnte in den Matrikeln als Gota oder Gotta auftauchen, nur ein einziger Buchstabe verhinderte in diesen Fällen das “matching”. Bei Namen wie Akusgrann lagen die Dinge dagegen komplexer. Hier sollte man wissen, dass der Ort lateinische auch als Aquisgranum und Aquae Grani bekannt war und so zu Eindeutschungen verleitete.

Michael Markert von der Thüringer Landesbibliothek Jena schlug mit einem YouTube Tutorial den Abgleich vor, der das Feld der Treffer in dieser misslichen Lage unmittelbar handhabbarer machte – eine GND/Lobid Anfrage, die einen mathematischen Buchstabenaustauschverfahren Varianten ins Kalkül brachte, mit denen sich alle geringfügigen Schreibunterschiede erst einmal auflösten:

Skurrile Treffer machten die sehr speziellen Schwächen dieses Angebots deutlich: Argentinische Studenten wollten sich da 90 Jahre vor der europäischen Entdeckung Südamerikas in Erfurt eingeschrieben haben, Studenten „de Argentina“, aus Straßburg.

Ein eigenes Problem blieben zudem die Orte mit aktuellen Namensgleichheiten. Dem Abgleich fehlten Wahrscheinlichkeitsparameter, Formen eines eigenen Kontextes: Von zwei Rothenburgs sollte das bei Fulda eher im Einzugsbereich der Erfurter Universität liegen als das an der Tauber oder das an der Wümme (entscheiden ließ sich das letztendlich jedoch nicht). In anderen Fällen war eher über Infrastrukturen nachzudenken: Wenn es zu einer Nennung ein Dorf und einen Ort mit mittelalterlicher Lateinschule gab, war vermutlich eher der Ort mit der Lateinschule der Entsender.

Am Ende blieb nichts übrig, als in einer Gruppensitzung alle Vorschläge zu überprüfen und bei vielen der Angaben historisches Wissen spielen zu lassen – bei 3000 Ortsnennungen ein gerade noch gangbarer Weg.

Das Endergebnis blieb eine Annäherung und erweist sich im Moment als vorurteilsbehaftet: Österreich, die Schweiz, die Niederlande sowie die ehemals deutschsprachigen Ostgebiete dürften in der folgenden Karte unterrepräsentiert sein (man kann in das Iframe hineinzoomen, die Karte wird bei jeder Browserauffrischung frisch aus den Datenbankeinträgen generiert). Was hier sichtbar wird, ist, dass wir Orte nach heutiger Nationalität gebündelt in die verschiedenen Schritte des Abgleichs brachten, um dabei annäherungsweise räumliche Nähe ins Spiel zu bringen.


Zoomfähige Kartendarstellung: Die Herkunftsorte der Erfurter Studentenjahrgänge 1392 bis 1450

Erst Blicke in die Biographien werden die Entscheidungen substantiieren können. Die Datenbank erlaubt es indes, Baustellen aufzumachen. Dies ist die Liste aller Orte, die wir im Moment für eine “manuelle” Überprüfung zurücklegten:

Doch ein nützliches Produkt am Ende

Dem Bedarf, der sich hier auftat, Rechnung tragend, spiegelten wir die durchgeführten Identifikationen am Ende auf die heutigen Ortsnamen zurück, so dass sie sich nun zwei neue Handhabungen ergeben:

Gibt man im Suchschlitz des MediaWikis einen Namen ein, den man nicht sofort einem heutigen zuweisen kann, so erhält man mögliche Treffer unmittelbar über die Alias-Funktion der Wikibase-Instanz angezeigt.

Ortszuweisung nach den Aliasangaben über den einfachen Suchschlitz

Spannender aber sollte die Liste unserer Zuweisungen sein. Sie lässt sich nun unmittelbar aus dem folgenden Fensterausschnitt als CSV, TSV oder JSON-Datei herunterladen (die Download-Links erscheinen am rechten Fensterrand im Mouseover; Quellennachweise finden sich in den einzelnen Datensätzen und können mit einer komplexeren Suche auch hinzugeladen werden):

Als TSV Datei heruntergeladen lässt sich die nun spaltenweise erscheinende Liste jeder eigenen in einem Excel- oder Google-Datenblatt gegenüberstellen und mit VLOOKUP/SVERWEIS auf einfache Art innerhalb des Datenblatts abgleichen.

Weihnachten rückt näher. Wunderbar wäre ein Tool, mit dem man Abfragen kontextualisieren könnte. Wir suchten Orte aus dem Spätmittelalter mit einer Fokussierung auf Erfurt und einer Privilegierung von Orten, die im Mittelalter über Schulen verfügten. Nicht einfach. Die Macher des GOV, des Genealogischen Ortsverzeichnisses sollten hier viel weiter sein – vielleicht dass wir einmal zusammen einen viel intelligenteren Service zu Ortsnamen auf die Beine stellen.


Publiziert im Rahmen des der NFDI4Memory Task Area “Data Connectivity”, Historisches Datenzentrum Halle, Projektnummer 501609550.

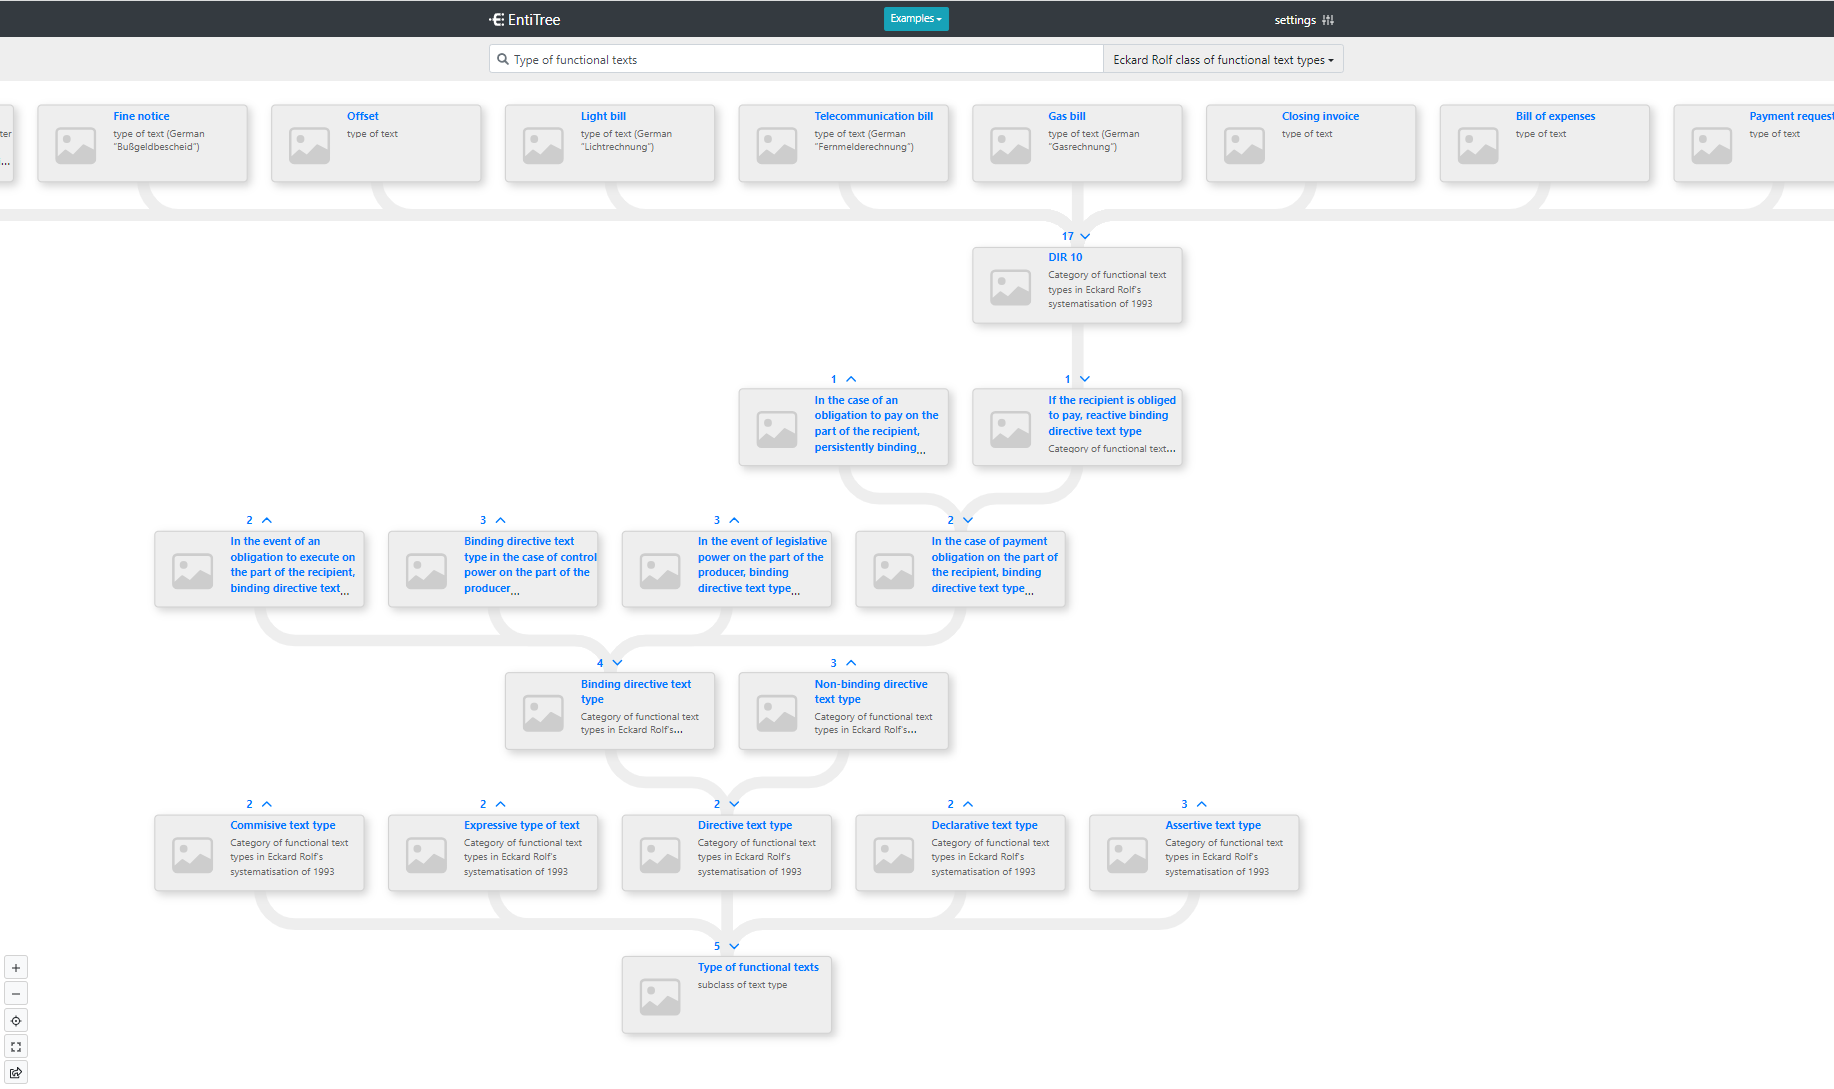
A FactGrid vocabulary of types of functional texts after Eckard Rolf

auf Deutsch

The data set in basic queries:

The links above give access to our first controlled vocabulary on FactGrid: “The FactGrid vocabulary of types of functional texts.”

Types of functional texts are not a matter of course. The corresponding genres of literary texts are, with all the problems discussed in the literary debate, far better known. The genres of functional texts are less controversial, but also less comprehensive. You find them in any mass of public records in the form of “insurance policies,” “interrogation protocols,” and “school reports,” to the odd “delousing certificate.” They do their jobs – so why collect the terms?

The technical answer is that Wikibase is software that invites you to use very specific vocabularies. You can run SPARQL queries on these specific terms and they will retrieve the “delousing certificate” in the mass of data, and you can, with very simple switches, bring far broader fields into view. The reduction to fields is the first step into statistics. If you can bring the variety under broader headings you can get a quick view of any vast production in your table. The vocabularies you need for this purpose have to be more than just lists of words. They need categorisations, common denominators above the words, ontologies.

A linguist’s perspective and data model

Our “Vocabulary of types of functional texts” has the required structural depth to allow statistical analysis and the broader analysis of larger bodies of texts. So far it is based primarily on the two Properties P894 “Eckard Rolf class of functional text types” and P912 “Speech act qualities.” The analysis is under both properties based on Eckard Rolf’s Die Funktionen der Gebrauchstextsorten (Berlin/ New York, 1993). Tobias Christ asked for the import of this vocabulary and its inherent structure for a project on functional texts of Germany’s Nazi era. He will explore handbooks for the organisers of Hitler Youth camps, official directives on the insignia of uniforms, etc. Rolf’s book is immensely practical with its in-depth analysis of 2055 terms arranged here in the five branches of illocutionary acts. Types of functional texts, under this premise, are essentially illocutionary speech acts as proposed by Austin and Searle in the 1950s and 1960 in their five branches:

  • assertives = speech acts that commit a speaker to the truth of the expressed proposition,
  • directives = speech acts that are to cause the hearer to take a particular action, e.g. requests, commands and advice,
  • commissives = speech acts that commit a speaker to some future action, e.g. promises and oaths,
  • expressives = speech acts that express on the speaker’s attitudes and emotions towards the proposition, e.g. congratulations, excuses and thanks
  • declarations = speech acts that change the reality in accord with the proposition of the declaration, e.g. baptisms, pronouncing someone guilty or pronouncing someone husband and wife

…thus the Wikipedia article illocutionary acts. Rolf deployed three further layers underneath this basic differentiation: two layers (of more or less specific) options on how the respective aims can be achieved and the fourth layer of situational conditions. The “delousing certificate” is under this matrix a “declarative statement” (a person is “declared” to be free of lice after the required treatment). The certificate will add a “personal dimension” to the bearer of the certificate – he or she will be free again to interact with others with the legitimation of the certificate. The statement is finally “body related.” Rolf created 100 groups under these four layers. The “delousing certificate” is in group “DECLA 12” together with the “allergy passport” or the “vaccination certificate.” Other types of texts do different things differently: A “doctoral thesis” (ASS 24) is an “assertive” – it commits the speaker to the truth of his or her exploration. The work is supposed to be “descriptive” and “argumentative.” The author will hand in this work with the “intention to gain a specific qualification.” Neighbouring types of texts such as the “book review” share some but not all features: Book reviews are again “assertives” and “descriptive” but without the author’s intention to gain a specific qualification with them. Their focus lies on a “judgment” they pass.

The following search gives the entire vocabulary in the four languages that are presently fully supported with Eckard Rolf’s primary classes and their basic categorisation:

  • Types of functional texts, generic terms in German, English, French, Spanish with Eckard Rolf’s bottom-line classification https://tinyurl.com/27ctrfam

The actual set of words is – especially on its German side – larger than the set of items. Rolf had separated terms like “Jagdschein” and “Jagdkarte” – in this case to have the German and the Austrian terms. In English both things are “hunting permits” unless we decide to offer individual  hunting permits all around the world. In other cases the differences were stylistic, created by registers that could not be reproduced in English, French, or Spanish. We eventually reduced the set to objects of essentially the same meaning. About 200 words are now variants in the alias sections and on the P34 “naming” Property where they can attract explanations of their proper use.

Eckard Rolf presented his original 2055 terms together with a series of structural overviews. Tobias Christ offered a condensed PDF-version of these visualisations in a single tree structure. You can use the EntiTree App to show rhis structure on your screen:

Any of the nodes in the representation can determine a specific query of the terms at the end of the ensuing ramification. This is the complete list of speech act qualities searchable on the P912 Property of “Qualities of speech acts”:

It is just as easy to generate statistics on each structural level. Here is the visualisation of the top level in a bar chart:

The following four searches give the scripts for each level (the level difference is determined with the Q-Item in line 8):

  1. The five illocutionary purposes of speech acts Q538467
  2. Division by general way to achieve the purpose Q538468
  3. Division by specific way to achieve the purpose Q538469
  4. Division by primary conditions of speech acts Q538470

The searches above cover the entire terminological set so they can now be run on any specific body of texts.

The open tool

The FactGrid database version of Eckard Rolf’s structural analysis should turn the book’s considerations into an immensely practical tool ready to download into any other software environment and ready to be expanded on FactGrid. New types will not compromise the original set – it remains intact through the statement P124+Q514322 (“listed in Eckard Rolf, Die Funktionen der Gebrauchstextsorten”) that is made on every individual word:

The best way to add a new term is to find neighbouring terms and to adopt their statements. FactGrid already had a couple of candidates, such as the popular “Briefsteller” (the “letter writer’s guide”) of the German 18th century, or the “Quibus Licet” (the letter which Illuminati had to hand in every month to stay in contact with the “unknown superiors”).

Our first “controlled vocabulary” is with these preliminary remarks still very much of an experiment. —

  • It will be interesting to offer the generic terms also as “Lexemes”: — Wikibase Lexemes are special entities that organise individual words in their languages.
  • The French and Spanish labels in particular are still very artificial translations – we should have original terms for each of these items as referenced in historical documents.
  • The present vocabulary is not yet matched with external databases. Wikidata and the GND are the two most urgent data partners here. The following search gives the matching so far: https://tinyurl.com/284jbjhc
  • The linguist’s categorisation should be seen as one option to make sense of all these terms. One can easily think of other qualities of speech acts. In our preliminary talk Rolf proposed to explore, for instance, the assumed-sincerity dimension in many of these speech acts. “Lip service” was his example – a speech act where the “honesty of the emittent is unclear or doubtful.” One can just as well create completely independent properties on features of genres beyond the linguist’s interest.
  • We should eventually expand this work. A vocabulary of genres in all the arts and literature would be of interest here. One would balance such a vocabulary with a particular vocabulary of “historical generic terms.” (I remember, I once wrote a 700 page book with a plea to explore these terminologies in all their “deficiencies.” The deficiencies, so I proposed back then, were usually the first indications that people were not doing the things we are doing with works of “art” and “literature” in our debates. We might question our keenness on succinct definitions in these particular fields, so my thought ages ago; we do not really define words in order to settle debates, we are always far more interested in the destabilisation the definition will actually produce – but that is already a topic for a very different blog post.)

Published as part of the NFDI4Memory Task Area “Data Connectivity”, Historical Data Center Halle, project number 501609550.

Eckard Rolfs Vokabular der Gebrauchstextsorten als FactGrid-Angebot

English version

Der Datensatz in Basis-Abfragen:

Mit den obigen und den folgenden Link-Angeboten lässt sich ein erstes „kontrolliertes Vokabular“ zu Gattungen von Gebrauchstexten aus dem FactGrid ziehen, sowohl als einfache Wortliste wie mit inhaltlichen Durchdringungen und Übersetzungen. Im Moment hat dieses Angebot noch experimentellen Charakter. Wikibase ist eine Software für Wissensgegenstände, nicht für Worte. Die Gegenstände erhalten Q-Nummern und auf diesen liegende Bezeichnungen in den verschiedensten Sprachen – Worte dagegen würde man in ihren Sprachen belassen wollen. Die Wikibase-Entwickler erweiterten darum 2018 ihr Angebot: Zu den Q-Nummern für die Dinge des Wissens kamen L-Nummern für „Lexeme“, die in ihren Sprachen verbleiben und nun Aussagen zu sprachlichen Bedeutungen auf sich ziehen.

Die Gebrauchstextsorten, die Eckard Rolf 1993 erfasste und sortierte, sind eindeutig Wissensgegenstände, die Angelegenheit für Q-Nummern: Eine „Mahnung“ ist eine Aufforderung, eine versäumte Zahlung nachzuholen – man kann diese Erklärung in verschiedenen Sprachen geben und die verschiedensten Sprachen haben ihre Worte für denselben Gegenstand: „dunning“ im Englischen, „mise en demeure“ im Französischen.

Der Anstoß zu diesem ersten kontrollierten FactGrid-Vokabular kam von Tobias Christ auf seiner Suche nach einem Werkzeug für die Erfassung von NS-Gebrauchstexten. Eckard Rolfs funktionale Klassifikation von Gebrauchstextsorten erfasst großzügig Begriffe und Kommunikationsstrukturen unter dem pragmatischen Gesichtspunkt des Handlungszwecks und erlaubt damit Blicke auf jeweils benachbarte Gegenstände – interessant etwa in Vergleichen der Gestaltung gleichartiger Texte. Statistiken von Produktionen lassen sich mit Rolfs Erfassung generieren, da sie das Gelände ohne große Doppelungen der Zuweisungen aufteilt. Der Autor stand bei der Datenbank-Version zur Seite, und ich vermute, er wird noch an einigen Stellen editorisch nachfassen. Mit dem nachfolgenden Link lässt sich die Liste in JSON, CSV, TSV oder Html-Tabellen herunterladen (rechts am Seitenrand eröffnen sich im Mouse-over die Optionen). Spalte 1 bietet die Links in die einzelnen Datenbankobjekte. Die Spalten 3 und 4 ordnen den Begriffen Rolfs Signaturensystem zu. Ich setze diesem die Einstufung nächster Ebene zur Seite, da mit ihr die Ordnungskriterien greifbarer werden:

Eckart Rolfs Klassifikation der Gebrauchstextsorten umfasst originär 2056 Gattungsbegriffe, die auf oberster Ebene in fünf Gruppen auseinanderdividiert sind; die assertiven Gattungen bilden das Gros gefolgt von den direktiven, deklarativen, kommissiven und expressiven:

Mit der EntiTree App lässt sich (durch Anklicken der Pfeile) das Gefüge entfalten:

Eckard Rolf bot diese Entfaltung bereits in seinem Buch an. Tobias Christ fasste sie in einer praktischen und um eigene Beispiele ergänzten Ansicht zusammen (Pdf), die mich die Knotenpunkte im System zuweisen ließ. Die spezifische Visualisierung wirft ein Schlaglicht auf die Art der Erschließung, die Rolf durchführte. Personalausweise mögen Personen Geschlecht, Augenfarbe, Körpergröße und Adressen zuschreiben – Eigenschaften, die einander gegenüber variabel bleiben. Eckard Rolfs Erschließung ist grundlegend anders: Die Eigenschaften untergliedern sich, sie werden feiner. Ich machte diese Verschachtelung der Optionen sichtbar, indem ich die Untergliederungen in den Aussagen auf allen ihren Ebenen mit erfasste. Auf der obersten Ebene ist die „Mahnung“ eine „direktive Textsorte“, auf der untersten eine „bei Zahlungspflicht auf Seiten des Rezipienten insistente bindende direktive Textsorte“.

Neben der Verortung im Gefüge eine Erfassung der Objekt-Eigenschaften

Die von Rolf angebotene Stammbaum-Untergliederung liegt auf einer einzigen Property, der Property P894: Eckard Rolf Gebrauchstextsorten-Klasse. Der Stammbaum mit seinen Differenzierungen eröffnet sich dabei von den Basisklassifikationen ausgehend; sie sind vom unten nach oben vernetzt. Mit der gewählten Property P894 lässt sich damit zwar das gesamte Gefüge wiedergeben und bei guter Skriptkenntnis beliebig gebündelt abfragen, im Umgang mit den einzelnen Begriffen bleibt das jedoch unbefriedigend. Die Aussagen zu jedem Begriff liegen jeweils in den unsichtbaren Knoten über ihm. Zwei Möglichkeiten bestehen, um die Aussagen einzeln zudem auch noch auf die Begriffsebene zu legen: Man kann für jede Ebene der Granularität eine eigene Property aufmachen, oder eine Summarische Sprechakt-Property aufmachen und auf dieser die Eigenschaften einzeln notieren. Ich spielte beide Lösungen durch und entschied mich im Verlauf mit nur einer Sammel-Property zu arbeiten – der Property P912: Sprechaktqualitäten. Es geht bei dieser Lösung nichts verloren, da wir auch auf den jeweiligen Aussagen vermerken können, auf welcher Betrachtungsebene sie gemacht sind und damit dieselben statistischen Auswertungen für jede Betrachtungsebene durchführen können. Die Sammlung der Eigenschaften unter der einen Property P912 ist vorteilhaft, da Nutzer nur bei Abfragen nicht vorab wissen müssen, auf welcher Ebene sich die jeweilige Eigenschaft bewegt. Man sucht nach Texten mit der Eigenschaft unter einer einzigen Property und erhält mehr oder weniger große Bündelungen.

Hier die statistischen Abfragen des gesamten Corpus, wie es Rolf erfasste, auf den einzelnen Eigenschaftsebenen:

  1. Zweckbestimmung
  2. Generelle Zweckanstrebungsweise
  3. Spezielle Zweckanstrebungsweise
  4. Vorbereitende Bedingung
  5. Erfülltheit der Aufrichtigkeitsbedingung

Im beratenden Gespräch spielte Eckard Rolf die Antworten am Beispiel des „Lippenbekenntnisses“ durch, wobei er unversehens mit der „Erfülltheit der Aufrichtigkeitsbedingung des Sprechakts“ eine neue Ebene der Eigenschaften aufmachte, die in seinem Buch so nicht vorkam. Frage der Aufrichtigkeit ist interessant, da sie sich nicht im Stammbaum unterordnet und quer durch das Gefüge der Begriffe greift. Bei Textsorten wie der „Sonntagsrede“ sollte sie wieder aufkommen. Ich machte indes keine Begriffe auf und versuchte keine Zuordnung der P912-Property – Sprachwissenschaftler sollten hier nachdenken und eigene Begriffe und Erwägungen spielen lassen.

Die obigen Suchen sind gleichzeitig Musterabfragen, mit denen sich beliebige Corpora statistisch zergliedern lassen. Im Internet findet sich ein einzelner Anwendungsfall des Rolfschen Vokabulars mit der Statistik, die Stefan Rabanus in seiner Staatsexamens-Arbeit Die Sprache der Internet-Kommunikation, Mainz, Gardez! Verlag, Mai 1996 durchexerzierte. Hier ist besonders Node 37) nit der Auswertung interessant. Die FactGrid-Erfassung macht solche Auswertungen in Zukunft einfacher.

Genauso gut lassen sich unter der einheitlichen P912 Property nun einzelne Aussagen herausgreifen. Die folgende Mustersuche erfasst so etwa „bindende“ Textsorten. Wenn man unter dem i-Symbol den Query Helper öffnet, kann man diese Eigenschaft gegen jede andere aus der Liste aller Eigenschaften austauschen:

Das sich öffnende Projekt

Die in Eckard Rolfs Publikation 1993 ursprünglich genannten 2056 Textsorten sind über die Quellenvermerke notiert und abfragbar. Das erlaubt es, neue Begriffe wie den „PodCast“ wie das „Quibus Licet“ (Q10508), das Illuminaten monatlich bei den Ordensoberen einreichen mussten in das Gefüge aufzunehmen ohne die Ursprungskonfiguration dabei unsichtbar werden zu lassen – man kann das größere FactGrid-Corpus abfragen wie Rolfs ursprüngliches. Aus der abgeschlossenen Buchpublikation von 1993 wird damit ein beliebig erweiterbares Gefüge.

In eine zweite Richtung musste das Projekt im FactGrid umgehend geöffnet werden: Die Datenbank ist auf Übersetzungen aller Termini angewiesen; englische Label sind dabei unabdingbar, um in den Sprachen, die noch nicht bedient werden. Die Übersetzungen sind im Moment noch sehr provisorisch.

Google scheiterte großflächig an den Nuancen der Rolfschen Liste. Bei 230 im Deutschen unterschiedlichen Begriffen kam es auf der englischen Seite zu Konvergenzen. „Rat“ und „Ratschlag“ wurden „Advice“; „Unglücksbotschaft“, „Unglücknachricht“ und „Schreckensnachricht“ wurden erst einmal nur „bad news“. Mitunter wissen wir im Deutschen, wann ein bestimmter Begriff angemessen ist: „Jagdkarte“ ist österreichisch, und „Jagdschein“ deutsch. „Schwur“ und „Eid“ überschneiden sich im Deutschen, doch zeigen „Amtseid“ und „Racheschwur“ Grenzen der Austauschbarkeit: der Schwur ist eher ein emphatisches Versprechen, der Eid formeller. Wenn eine andere Sprache nicht genauso differenziert – im Englischen gibt es nur den „oath“, ob als „oath of revenge“ oder als „oath of office“ – dann erhalten deren Nutzer zwei Items „oath“, zwischen denen sie sich nicht entscheiden können, nur weil auf deutscher Seite hier Unterschiedliches steht. In diesen Fällen ist es eigentlich ratsam, nur ein Item zu bespielen und auf diesem für jede Sprache ins Detail zu gehen und Worte zu listen, die dies meinen, samt qualifizierenden „Nutzungshinweisen“ auf der Property P598. Worte gehen bei solchen Zusammenlegungen nicht verloren, sie erhalten nur einen präziseren Platz als Optionen, die Sprachen unterschiedlich zur Verfügung stellen.

Was zu tun bleibt

Kontrollierte Vokabulare auf einer Wikibase-Instanz anzubieten, dürfte praktisch sein: In der Graph-Datenbank lassen sich Vokabulare im Plural verwalten und komplikationslos auf dieselben Begriffe legen. Wir können im selben Moment sagen, wie sich diese Vokabulare zueinander verhalten, wo sie deckungsgleich sind, wo sie eigene Vernetzungen auftun, und können so zwischen Vokabularen mühelos vermitteln. Man kann im selben Moment externe Datenbanken, die sich eines bestimmten Vokabulars bedienen, egal in welcher Sprache sie das tun, mit dem eigenen Lieblingsvokabular verstehen.

Das vorliegende Vokabular birgt im Moment als deutlich deutsches Produkt mit sehr feiner Nuancierung in der globalen Nutzung Desiderate:

  • Die Property-Label und Beschreibungen sollten noch einmal übersehen werden. Dies sind alle aktuell bestehenden Eigenschaften von Gebrauchstextsorten.
  • Die Übersetzungen müssen noch vollständig überprüft werden.
  • In der gesamten Begriffs-Liste sollten Zusammenziehungen auf „das jeweils Gemeinte“ erwogen werden. Verschiedene Worte für mehr oder minder dasselbe, legt man dabei zum einen auf die Alias Position (das geschieht beim “Merging” automatisch, danach landet man beim Eintippen der beliebigen Alternative auf dem zentral gesetzten Begriff), zum andern kann man die Varianten danach an Ort und Stelle mit „Nutzungshinweisen“ ausstatten. Es ist dies der Weg, der das Instrumentarium mehrsprachig eindeutig macht.
  • Das gesamte Vokabular ist derzeit nur im Ansatz mit Wikidata abgeglichen und kaum mit GND-Nummern ausgestattet. Auch hier ist im Moment noch nachzufassen.

Publiziert im Rahmen des der NFDI4Memory Task Area “Data Connectivity”, Historisches Datenzentrum Halle, Projektnummer 501609550.

FactGrid Goes NFDI

Friday week before last, we received the news that so many working groups had been eagerly awaiting: the 4Memory consortium (of historical studies) will become part of the Nationale Forschungsdateninfrastruktur (NFDI), the German National Research Data infrastructure.

This is exciting news for FactGrid, just weeks before its fifth birthday. We will be acting as an official repository for historical data in the upcoming NFDI structure. German projects can now make a good case that FactGrid is the optimal platform for their data.

NFDI4Memory task areas

Changing the rules of our present research data management

The German National Research Data Infrastructure aims to bring transparency and sustainability to all research fields, from microbiology to computational linguistics. Whether researchers are still collecting data entirely for themselves in private Word documents and Excel spreadsheets, or whether they are working on digital platforms that are more or less designed like conventional books, designed to be read and looked at – they will face new questions in their research grant applications: Do they produce data? Do they correct publicly available data? If so, the new questions will be: How do they make sure that others can actually work with their data? The idea that new information ends in footnotes of books and articles will not convince the funding institutions any longer. A CSV or JSON data file located on a library server will not do either. Linked Open Data is the only data that is easily reusable – that is what Wikidata has made clear. New platforms are therefore needed – platforms approved by the National Research Data Infrastructure.

The DFG that pushed the process has acted wisely. The different research disciplines had to determine how they would respond to its call for action. They had to create or join umbrella organisations in order to submit proposals for further funding. NFDI4Culture was one of the first groups in the German humanities to receive funding; Text+, for all textual studies, was also among the first arrivals, in 2021. The historical studies collective founded the 4Memory consortium and received the green light in the second round on Friday 4th. Funding will start in March 2023. The Gotha Research Center the 4Memory “participant” on behalf of the FactGrid community in this process.

An international resource as part of a national infrastructure?

It took us a while to feel comfortable with the invitation to participate in this process – back in 2020. At that time we had created a little more than 100,000 items with a handful of participants. Wikimedia Germany was our natural partner. The German National Library was the first major player to collaborate with us in a joint exploration of the Wikibase software. FactGrid from the beginning had invited international collaboration, with projects from France, the United States, Spain, Hungary, and Switzerland. Could we risk a nationalisation of the platform?

The project partners on FactGrid were open to the idea: It would benefit everyone to take the step. The process would open doors to important discussions. We could discuss data standards used worldwide and be able to think of international alliances on this new stage.

Our asset? – Wikibase

Following the NFDI debates,we soon understood why we had been asked to join: We were using Wikibase, the software platform that all members of the nascent consortia were discussing behind the scenes as the very software that could build the bridges between the working groups.

  • Wikibase invites cooperation. Its data modelling is uniquely flexible.
  • Versioning of all editing processes enjoys unprecedented transparency.
  • Wikidata demonstrates that seemingly incompatible fields of knowledge can be managed together in a single graph database.
  • Getting data from a Wikibase platform is as easy as it is to put data into it.
  • Wikibase instances can be federated – we can diversify the scenery without using one single Wikibase instance.

FactGrid was ahead of its time. We were running a functional Wikibase platform while other groups were simply proposing to evaluate the option.

And yet still at the beginning

Over the last two years we have more than quadrupled to 457,000 items. FactGrid is doubling almost every year and there is no reason to believe that this will change in the near future. Projects that are presently preparing data uploads are in the scope of the entire current platform; with our upcoming projects we remain on a global trajectory – we are becoming more international, the platform is learning new languages.

The NFDI process comes just in time because, despite all that growth, we are still right at the beginning, and in urgent need of technological development, which is where we put the focus in our 2020 and 2021 grant proposals. We are not alone in this situation. Wikidata, our elder sister, is still in its initial phase – a peculiar statement, given the fact that Wikidata is celebrating its 10th birthday these days with more than 100 million database objects.

Wikidata is massive. It has rocked the library world as a revolutionary development, but despite that it is still an unknown giant hiding somewhere behind the Wikipedia curtain. Nobody has ever spoken of the data-technical Pentecost miracle which Wikidata actually is. The very name of the project has remained hidden: “Wikidata – you mean Wikipedia, don’t you?”

It is understandable that Wikidata has remained a virtually unknown child. There is neither a search tool leading a wider public to Wikidata information nor is this information readable once you have reached it. The SPARQL query service is a nightmare for normal users. Even if you know how to read computer code– which most of us do not–, how do you find out what information the database can supply? Right, by asking your first specific question with knowledge of the content (the very knowledge that you still do not have). One day an internet-savvy user contacted us with the note that our Query Service had crashed. The Query Service seemed fine; I suggested a video call to get an idea of what the man was seeing on his screen – and it turned out that he was looking at the regular search script. “Send it off, press that blue button!” – He did and received the requested data set. “Ah, I had seen this code stuff but thought it was an error message…”

Wikibase needs two enhancements: An attractive search interface as simple as the Google search box (though with an additional advanced search engine and a SPARQL-search option on top) and browsing software that generates information from the Wikibase or, better still, from several combined Wikibases. The present Wikibase query engine leads you right to the item-pages in the default Wikibase presentation mode, where you can then manually correct or amplify information, but no one seriously enjoys the reading experience. Magnus Manske’s Reasonator, Markus Krötzsch’s SQID, Michael Ringgaard’s KnolBrowser, and Bruno Belhoste’s FactGrid Viewer have shown how Wikibase information can be presented: in pages that present their information concise, well structured, fast to access and easy to exploit. So far, however, all four browsers have remained patchwork solutions. They do not amalgamate platform information in greater depth, and (this is the larger issue) they are as yet not coupled to intelligent search engines. The problem is that we have not yet arrived at independent new resources, at resources whose pages are Google landing points, with pages that amalgamate information from various Wikibases such as Wikidata and FactGrid, and that keep their users on the platform – providing in depth information on request, generating visualisations on the spot, offering downloads of information which users have been accumulating on their tour.

We will get multilingual and attractive Wikibase aggregates. They will integrate information from various resources and they will offer this information in any language requested, identical across all the cultural and political divides. The German NFDI will have to create prototypes of such instruments if they should actually federate Wikibases in a new broader research oriented structure, even if that should start as a national structure.

Opportunities and risks

“The General Intelligence Machine.” Art by H. Lanos for “When the Sleeper Wakes” by H. G. Wells (1899), Wikimedia Commons

The time for a broader research data infrastructure is ripe. Researchers are still handling “their” data on personal hard discs; they copy and paste dates from Wikipedia pages when they could have complete data sets ready to download. Data correction remains fortuitous. Do you write an email to the producers of an online catalogue which you have been accessing with the request to correct a mistake? Do you give the correct date in a footnote of your next article and expect librarians (and Wikipedians) to take note of your work? – We need online resources that allow researchers to correct mistakes right on the screen, in real time; and these resources should be the same ones, which users employ to organise their research. Wikibase is the software that can help to make this possible. How will we get there? Wikibases will have to become the go-to scholarly resources to consult; that is when they will turn into the workbench for the very projects that are using their data.

The landscape of NFDI-consortia comes with its own internal risks. We will need resources to do highly specialised jobs: resources to store and mine texts, resources for the machine readable information which we need in order to make 3D reproductions of objects, and we need resources for historical statements. FactGrid is focusing on this latter need. It cannot become the all-in-one service for historical research. We need the services of other consortia and we should offer our particular services to the other consortia wherever they handle historical statements.

The much more delicate risk of fragmentation looms on the international stage: Will the German expert on French history find herself asked to store her data on a German platform since her funding is German – while her French colleagues with whom she shares the research objects will be delivering their data into a French database? We could, of course, harvest information from 150 national research data infrastructures but that will not provide the same experience for those who generate the information. Working on FactGrid you are about to notice when a colleague in France or China adds to your data. You will contact the colleague with a note of delight about the archival sources that had escaped your notice. Wikibases are joint platforms and should be used as such.

The question of a plurality of national research data infrastructures becomes even more thorny as soon as we look beyond the privileged horizon. We need global platforms to provide equal access to research and to the debates surrounding research. Wikimedia has created Wikidata with the explicit aim of having a software compound on which users from all over the world can work together – accessing and expanding the same pool of global information. We, the international scientific community, the heirs of the international respublica litteraria, shouldn’t fall behind the Wikimedia project.

The fact that FactGrid, an explicitly internationally oriented resource, has entered the NFDI4Memory structure is an interesting development – a chance to get more than one National Research Infrastructure on board.

Links


Header image source: Robert Charles Dudley (British, 1826–1909) Interior of One of the Tanks on Board the Great Eastern: The [Transatlantic Cable] Cable Passing Out 1865/66, Watercolor over graphite with touches of gouache (bodycolor) https://www.metmuseum.org/art/collection/search/383834