FactGrid GYIK – Miért használjam a FactGridet a kutatási projektemhez?

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).

in English
auf Deutsch
en français

  1. Mi a FactGrid?
  2. Miért használjam a FactGridet a saját kutatásomhoz?
  3. Miért ne egyből a Wikidatát használjam?
  4. A FactGrid ingyenes – hogy működik ez?
  5. Mihez kezdhetek az unortodox kutatási témákkal?
  6. Milyen segédeszközöket biztosít a szoftver?
  7. Mit tegyek, ha a saját platformomon szeretném megjeleníteni az adatvizualizációm?
  8. A FactGrid CC0-licenc alatt teszi közzé az adatokat – ez azt jelenti, hogy lemondok a kutatásom jogairól?
  9. Mi történik, ha szeretném az adataimmal egy másik platformon folytatni a munkát?
  10. Mi történik, amikor FactGrid-felhasználók a “helyes” dátumról vitatkoznak?
  11. Miért kockáztassam meg az átláthatóságot rögtön a projektem kezdetétől?
  12. Mi kell ahhoz, hogy a FactGrid befogadja a projektem?

Mi a FactGrid?

A FactGrid egy Wikibase-alapú platform történeti adatokkal dolgozó projekteknek számára, amely egyszerre hagyományos wiki és adatbázis. Az oldalon állításokat rögzíthetsz az általad feltöltött vagy téged érdeklő elemekről, majd ezeket szinte bármilyen nyelven tudod használni és megjeleníteni.

A platform szervezője a Gotha Kutatóközpont, a szervert pedig ThULB Jena biztosítja.

Együttműködésben a Wikimédia Németországgal és a Német Nemzeti Könyvtár GND-adatbázisával szeretnénk elhelyezni a platformot mint kutatási adatokra építkező erőforrást a kialakulóban lévő, összekapcsolt Wikibase-oldalak rendszerében.

Miért használjam a FactGridet a saját kutatásomhoz?

A fő érv a FactGrid mellett a verhetetlenül rugalmas szoftver, a Wikibase, amelyet a Wikimédia Németország segítségével, elsődleges felhasználási helyén, a Wikidatán kívül, egy kísérleti projekt keretében implementáltunk:

  • Egy olyan szoftvert keresel, amely gyakorlatilag bármilyen nyelven tud beszélni? Egy platformot, ahol felvihetsz adatokat a saját nyelveden, mások pedig a saját anyanyelvükön olvashatják ugyanezt, és fordítva? Ez a szoftver a Wikibase.
  • Egy olyan szoftverre van szükséged, amivel átlátható módon koordinálhatsz egy egész kutatói csapatot? A Wikibase-zel ez ugyanolyan könnyű, mint a Wikipédia szoftverével, a MediaWikivel.
  • Egy olyan adatbázisszoftvert keresel, amely tud mindent, amire egy digitális bölcsészeti adatbázisnak szüksége lehet: kapcsolatháló-elemzés, térképes megjelenítés, komplex összekapcsolt keresések, megjelenítés többféle idővonalon? Egy szoftver, amely szinte emberi nyelvként működik, és még teljes körű adatbázis szolgáltatással is rendelkezik? A Wikibase ez a szoftver.
  • Szeretnél egy előző projektedből származó adatgyűjteményre építeni? A Wikibase-en lehetséges a nagy mennyiségű, automatizált adatbevitel.
  • Szeretnél biztosra menni, hogy más projektek is hozzáférnek az adataidhoz, és ténylegesen fel is tudják használni azokat? A platformról könnyen letöltheted az összes adatot, hogy offline, Excelben vagy bármilyen más online projektben dolgozhass velük.
  • Szeretnél teljesen új kérdéseket feltenni a kutatásodban? A Wikibase-en bármelyik elemet összekapcsolhatod bármiféle állítással.
  • Aggódsz, hogy mi történik majd az adataiddal miután véget ér a kutatásod finanszírozása? Támaszkodj egy platformra, ahol nem egyedül dolgozol, ami olyan licenc alatt működik, amely lehetővé teszi másoknak is, hogy folytassák a munkát az adataiddal és eszközeiddel.

Ha hosszú távú perspektívát keresel, akkor ezt szeretnénk nyújtani a Német Nemzeti Könyvtárral való együttműködésünkkel. A platform egyik támpillére a GND-adatgyűjtemény lesz, ami által széles körben használható eszközként működhetünk. Továbbá célunk ezzel, hogy fontos szereplőjévé váljunk az összekapcsolt Wikibase-rendszerek kialakuló világának.

Miért ne egyből a Wikidatát használjam?

Ez egy teljesen jogos kérdés. Vannak olyan projektek (amelyek elsősorban csak felhasználják adatokat), amelyekhez a Wikidata megfelelőbb platformot nyújt. Az FH Potsdam “Archivführer zur deutschen Kolonialzeit” nevű projektje remekül illusztrálta annak szépségét, amikor közvetlenül Wikidatára dolgozunk – erről beszélgettünk Uwe Junggal, aki bemutatta, milyen technikai megoldásokat használtak Potsdamban.

Ugyanakkor alapvetően két dolog van, amiket nem fogsz tudni sem a Wikidatán, sem egy GND-hez hasonló platformon csinálni: a Wikimédia-projektek (és a GND) szigorú szabályokkal rendelkeznek arról, hogy nem közölhető saját kutatómunka, és döntéseiket nevezetességi kritériumok alapján hozzák meg, ami nem enged teret tetszőleges adatbázis-elemek létrehozásának vagy tárgyak közötti kísérleti kapcsolatok tesztelésének.

A Wikidata és a GND olyan információkra koncentrálnak, amelyeket már korábban publikáltak és a kutatást nem végző alkalmazottak már közzétett kutatásokból viszik fel az adatokat. Ezeken a platformokon nem tudsz létrehozni munkahipotézisként szolgáló állításokat a kutatásodhoz. Nem hozhatsz létre elemeket kizárólag azzal a céllal, hogy majd statisztikai elemzést végezhess rajtuk a munka egy jóval későbbi szakaszában.

A FactGriden bátorítjuk a platform használatát heurisztikus kutatási eszközként.

  • Létrehozhatsz elemeket az adatbázisban függetlenül attól, milyen relevanciájuk lenne egy enciklopédiában vagy könyvtári katalógusban.
  • Megkockáztathatsz ideiglenes kronológiákat, egyéni feltevéseket kiinduló hipotézisként.
  • Használd a FactGridet nem konvencionális állításokhoz, amelyek jelenleg csak a saját kutatási projekted számára érdekesek – a szoftver lehetővé teszi ezt a fajta szabadságot.
  • Hozz létre adatbázis elemeket, amelyek részletezik, a kutatásod során milyen adatgyűjteményeket módosítottál jelentős mértékben. Ezáltal könnyen benyújthatod ezt az adott elemet mint a kutatásodat összegző “mappát” a téged finanszírozó intézménynek.
  • A platformon megkockáztathatsz bármilyen új tézist, és egy saját adatbázis elemben összegezheted mint “mikro-publikációt”, ezáltal is láthatóvá téve a hozzájárulásod.

A FactGrid ingyenes – hogy működik ez?

A szoftver ingyenesen használható, és folyamatosan fejlesztik a Wikimédia projektek közösségei, illetve a Wikibase-t használó intézmények.

A FactGrid platformot a Gotha Kutatóközpont szolgáltatja az Erfurti Egyetem virtuális szerverén. A német URL évi 36 eurós költséget jelent, ezt a Gotha Kutatóközpont fedezi.

Az összes Wikidata-segédeszköz a felhasználóink rendelkezésére áll. Ezek biztosítják az átlag digitális bölcsészeti projekthez szükséges összes funkciót.

Mivel mind a szoftver, mind az eszközök nyílt forráskóddal rendelkeznek, bármilyen általad kedvelt szoftverrel módosíthatod őket, ha új alkalmazási módra van szükséged.

Ha saját eszközeiddel is hozzájárulsz a nyílt rendszerhez, biztosíthatod, hogy jövőbeli projektek is használhatják és fejleszthetik ezeket.

Amennyiben olyan technikai megoldásokra törekszel, amelyeket később anyagi haszonért értékesíthetsz, a szoftver licence ebben sem fog meggátolni. Szabadon kereskedelmi alapokra helyezhetsz bármit, amit nyílt forráskóddal építettél.

Mihez kezdhetek az unortodox kutatási témákkal?

A Wikidata úttörő adatmodellel rendelkezik. A felhasználó gyakorlatilag csak kapcsolatokat hoz létre Q-számok között (vagy kapcsolatokat Q-számok és időpontok, Q-számok és földrajzi koordináták, Q-számok és médiafájlok, Q-számok és URL-ek között).

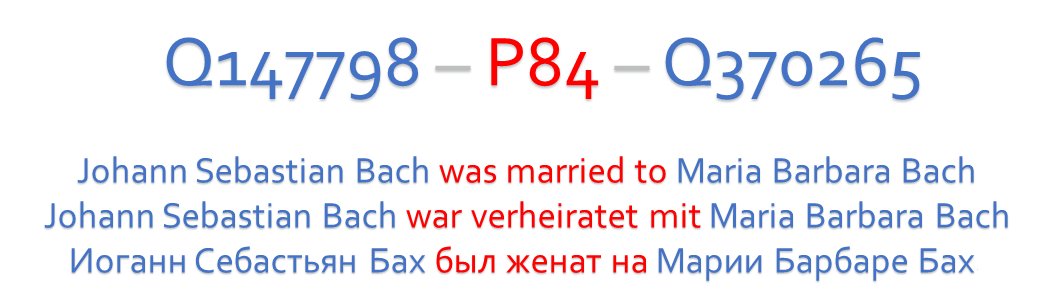
A szoftver maga nem tudja, milyen típusú kapcsolatokat hozol létre – ezek szintén csak P-számok: a Q1 – P1 – Q2 egy ún. “triple”, ami jelentheti, hogy “Johann Sebastian Bach (Q1) fia (P1) Carl Philipp Emanuel Bach (Q2)”, de azt is, hogy “Az archívumban talált, XY raktári jelzetű levél (Q1) állítólagos feladási helye (P1) München (Q2).”

Q-számokat bármihez hozzárendelhetünk – emberekhez, dokumentumokhoz, eseményekhez, eszmékhez… Te döntöd el, milyen P-számokra van szükséged az általad kívánt állításokhoz. Az elemeket nem egy rögzített, módosíthatatlan kategóriarendszerben kell meghatároznod, a létrehozott állításaid pedig új árnyalatot és szilárdságot adnak az új vagy meglévő elemekhez. Ne aggódj, ha nem rögtön az első napon áll össze az adatmodelled. Hozd létre folyamatosan az állításokat, amikor csak szükséged van rájuk, közben figyeld, hogy érik el a kritikus tömeget, amellyel kiértékelhetővé válnak.

Minden állítás “minősíthető” – “Johann Sebastian Bach (Q1) felesége (P2) Maria Barbara Bach (Q2) házasság kezdete (P2) 1707. október 7. (dátum),  házasság vége (P3) 1720. július 5 körül (dátum).” Ezeket az állításokat ugyanakkor hivatkozásokkal is elláthatjuk: “erre bizonyíték (P4) XY egyházi évkönyv (Q3)”,”állítás forrása (P5) XYZ Bach-életrajz (Q4)”.
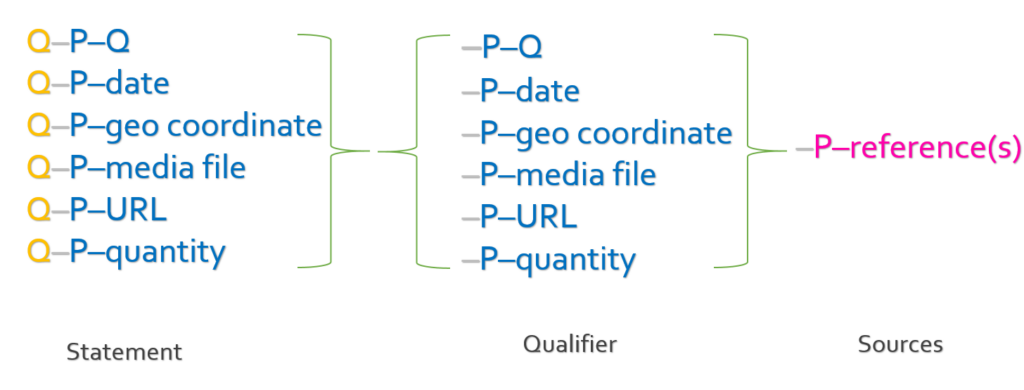
A rendszerben lehetséges egymással versengő értékeket megadni, mindössze külön-külön forrásmegjelölést kapnak, illetve rangsorolni is lehet őket.

Ilyen mélységben meghatározott triple-ekkel gyakorlatilag bármilyen állítást létrehozhatsz, ami viszont még fontosabb, ezzel lehetőséged nyílik állításokat létrehozni bármely nyelven. A rendszer Q- és P-számokkal működik, minden egyéb pedig címke, amit azon a nyelven adhatsz meg, amelyet fel szeretnél kínálni a felhasználónak. Ezen felül a szoftver automatikusan lefordítja a dátumokat és mértékegységeket az adott nyelv által használt formátumra. Ez a titka annak, hogy a Wikibase-platformokat mindenki a saját nyelvén szerkesztheti, miközben az egész világon olvasható szinte bármilyen nyelven.
Milyen segédeszközöket biztosít a szoftver?

Készíthetsz adatbázis-bejegyzéseket egyesével: nyisd meg a szerkeszteni kívánt elemet, menj a beviteli lap aljára, és kattints az “állítás hozzáadása”-linkre. Itt kell megadnod, milyen állítást szeretnél létrehozni. Nem szükséges fejből tudnod a P-számot, kezdd el begépelni a tulajdonság nevét a saját nyelveden, majd válassz a felkínált lehetőségek közül az automatikus befejezéshez. A platform tudni fogja az adott állítás P-számát. Az állítás második részét a következő szövegdobozban adhatod meg, szintén elég elkezdeni begépelni.

Excel- és CSV-listákból, automatikus bevitellel is készíthetsz adatbázis bejegyzéseket. (Itt találod a beviteli felületet, itt pedig egy rövid útmutatót hozzá.)

Az adatbázis-lekérdezéseket SPARQL nyelven kell megfogalmazni. Ez (sajnos) nem egy könnyű keresőnyelv, de végső soron annyira komplex, mint a futtatni kívánt keresések.

A SPARQL-t használók nem feltétlen tudnak SPARQL-forráskódot írni. Általában keresési mintákat tudsz használni, amik megmutatják, hol kell változtatnod a bevitt szövegen, hogy lefuttathasd a saját keresésed.

Amennyiben pontosan tudod, milyen típusú keresési lekérdezést kell futtatnia a felhasználóidnak, készíthetsz a könyvtárak megszokott online felületeihez hasonló, egyéni beviteli maszkokat, amelyek majd SPARQL-ben kommunikálnak az adatbázissal.

A szoftvercsomag tartalmaz illusztrációs lehetőségeket térképekhez, idővonalakhoz, hálózatokhoz, genealógiai kapcsolatokhoz, grafikonokhoz, stb. Nem kell letöltened egyéb, külső alkalmazásokat. A SPARQL-en keresztül kérheted az általad kívánt reprezentáció létrehozását. Gyönyörű bemutatót láthatsz vizualizációkból, ha felkeresed a Wikidata Scholia-projektjét.

Mit tegyek, ha a saját platformomon szeretném megjeleníteni az adatvizualizációm?

Ennek nincs technikai akadálya. Uwe Jung demonstrálta, hogyan használja az FH Potsdam felülete a Wikidatát adattárként úgy, hogy közben a felhasználók nem látják a háttérben lévő adatbázist.

Nincs semmi gond azzal, ha a FactGridet külső adattárként használod, és a saját kutatási projekted az egyetemed szerverén építed fel, ahol célzott adatbázis-hozzáférést teszel lehetővé saját keresősablonon keresztül.

A FactGrid CC0-licenc alatt teszi közzé az adatokat – ez azt jelenti, hogy lemondok a kutatásom jogairól?

Ha a Creative Commons 0-licencet választod, továbbra is teljes szabadsággal használhatod az adataidat, amire csak szeretnéd  – te irányítasz, és nem a kiadó vagy az adatokat kezelő platform. Ezen felül a CC0 azt jelenti, hogy az adataid szabadon felhasználhatóvá válnak mások által is. Mivel a közösség így bármikor kijavíthatja az észrevétlenül maradt hibákat, csökken annak a kockázata, hogy hosszabb távon elavuljon a kutatásod.

Néhány megfontolandó tényező: Tudósok számára első pillantásra a CC BY 4.0-licenc tűnik kedvezőnek. Ez engedélyezi az ingyenes felhasználást, amennyiben az megfelelően módon megjelöli a forrást. A gyakorlatban ez működhet szövegeknél (mint ez a blogposzt), mivel itt egyértelmű, hogy milyen hivatkozást szeretnénk látni: a nevünk megadásával, a publikáció címével, a kiadás helyével és dátumával. De szeretnéd, hogy az adataid idézetként szerepeljenek, például egy vizualizációban? Egy 1753 júniusában Párizsból Berlinbe küldött levél a térképen egy vonalként szerepel – hogyan lássuk el ezt megfelelő jegyzetekkel? Hogyan idézzenek téged, ha csak javításokat végeztél egy adathalmazon? Az “Így add tovább”-licencek még problematikusabbak: ezek az adatok szabadon hozzáférhetők bárki számára, amennyiben a további felhasználók is ugyanezekkel a feltételekkel osztják meg. Ez úgy hangzik, mint a szabad felhasználás melletti határozott kiállás. De egy al-felhasználó hogyan tudja biztosítani, hogy az ő al-felhasználói is betartják a licencbe foglalt feltételeket (főleg ha ez az al-felhasználó CC0 alatt teszi közzé az adatokat)? Az al-felhasználóknak általában azt tanácsolják, ne használjanak adatokat CC-BY vagy CC Így add tovább licenccel rendelkező platformokról.

A Wikidatával és a Német Nemzeti Könyvtárral közös vállalkozásunk egyetlen lehetőséget hagyott számunkra: hogy partnereinkhez hasonlóan szabadon felhasználhatóvá tegyük az adatainkat. A CC0-licenc által nem biztosított, hogy a további felhasználók is feltüntetik majd, ki gyűjtötte az adatokat, illetve felhasználásuk feltételeit.
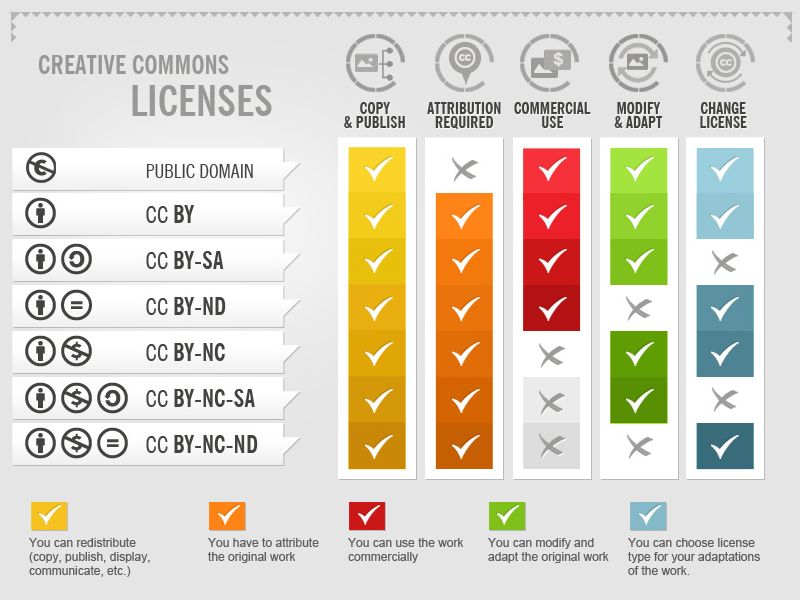
A gyakorlatban a legtágabb nyílt licenc nem jelenti azt, hogy a FactGrid-adatok szerző nélküliek, épp ellenkezőleg. Mi azt szorgalmazzuk, hogy hivatkozzunk a kutatásra, és megelőlegezzük, hogy a Wikidata és a GND is boldogan feltünteti, ha a kutatás a mi platformunkról származik.

A FactGriden minden szerkesztéshez kapcsolva van a szerző neve. Ha egy kutatási projekt lényeges mértékben járult hozzá egy adatgyűjteményhez, akkor ezt jelezhetik egy külön jegyzetben, amelyet tovább lehet adni adatátvitelnél.

A Wikidatához vagy a GND-hez hasonló adatbázisok amúgy érdekeltek is a kutatások hivatkozásában – ez hozzájárul az adataik szilárdságához. A FactGrid abban a különleges helyzetben van, hogy mindkét szervezet számára olyan platformot szolgáltat, ahol a felhasználók olyasmiket csinálhatnak, ami saját, nagyobb platformjaikon nem engedett.

Mi történik, ha szeretném az adataimmal egy másik platformon folytatni a munkát?

Mivel szerzői jogi korlátozások nélkül vitted fel az adatokat, szabadon dolgozhatsz velük bárhol máshol. Valójában örülünk is, ha afféle inkubátor lehetünk kutatási adatok számára.

Mi történik, amikor FactGrid-felhasználók a “helyes” dátumról vitatkoznak?

A szoftver lehetővé teszi az egymásnak ellentmondó adatok kezelését – ez különösen fontos a történelmi kutatás területén, ahol gyakran találunk egymásnak ellentmondó forrásokat anélkül, hogy biztosan tudjuk, melyikük állítása igaz. A szoftverrel reprodukálhatjuk az ellentmondásos helyzetet, az állításokat pedig külön-külön alátámaszthatjuk hivatkozásokkal. Az eltérő állításokat súlyozhatjuk is egymáshoz képest – például a jelenleg irányadó állítást az egyéb variánsokkal szemben, vagy akár minősítőkkel az egyéni kiértékeléshez.

Tekintsük inkább érdekes helyzetként arra, amikor két kutató eltérő eredményekre jut. Sokkal rosszabb, amikor egy olyan platformon hibázol, ahol sosem lesznek kijavítva, és hitelteleníthetik az egész munkádat.

Miért kockáztassam meg az átláthatóságot rögtön a projektem kezdetétől?

Ez kemény dió, valószínűleg ez gátolja meg a legtöbb projektet, hogy használja a FactGrid erőforrásait. Az alternatíva egy platform, amihez csak a jelszóval rendelkező csapat férhet hozzá a projektet lezáró publikáció határidejéig. Így, szól az érv, semelyik versengő projekt sem tudja elcsaklizni a kutasi eredményeket. Senki sem látja, hol hibáztál az elején. Senki sem rögzíti, melyik adatot vitték fel asszisztensek és melyiket a projektvezető – ehhez hasonlók a feltételezett előnyei a nem átlátható munkának egy olyan platformon, amely csak a finanszírozás végével lesz online elérhető.

Az átlátható kutatás saját biztosítékokkal rendelkezik. Ha egy találsz egy minden eddigit felülíró dokumentumot vagy rögzítesz egy úttörő kapcsolódási pontot, akkor itt a lehetőség, hogy a saját nevedhez és projektedhez kösd az állítást. Ha holnap valaki ellátogat ugyanabba az archívumba és szintén felfedezi, amit te – pech, hiába. Te már rögzítetted a megfigyelést a platformon, amit a laptörténetben lekövethető változtatás minden kétséget kizáróan bizonyít.

Mindeközben a kollektív platform  meghívásként is működik az együttműködésre. Tedd egyértelművé a többi csapat számára, min dolgozol, hogy felvehessék veled a kapcsolatot.

Egy elméletileg biztonságos, csak a projekt végén nyilvánosságra hozott weboldal kockázatai komolyak. A felhasználókkal ekkor már nem lehetséges ötleteket cserélni. Az internetes jelenlét időzítése a projekt rohanós utolsó heteire esik, amikor már nem lehetséges semmiféle, koncepciót érintő változtatás. Ha a kutatást kizárólag egy könyves publikációhoz végeztétek, bizonytalan marad, mihez kezdjen a csapat a Word- és Excel-fájlokban összegyűjtött adatokkal. Senki sem tudja ekkor felvinni az adatokat egy nagyobb erőforrásba – egy ilyen késői fázisban a harmonizáció szinte megugorhatatlan akadály. Csak reménykedni lehet, hogy a könyv olvasói beszkennelik az összes lábjegyzetet, hogy a bennük lévő korrigálások elérhessék a könyvtári katalógusokat és a különféle Wikimédia-projekteket. A kockázatot itt a könyv jelenti, amely semmiféle hatással nincs a kollektív adatbázisra, illetve a digitális bölcsészet projektek, amelyek publikáció után elavulnak.

A jövő inkább egy újfajta hozzáállásban kell keresni egy közös, nyilvános adatbázis felé. A kutatóknak képesnek kell lenniük javítani és bővíteni ezt az adatbázist bárhol, bármikor hozzáférve. Az szükséges motivációt és biztonságot a kutató környezet jelenti, ahol megjelölhetik és idézhetővé tehetik saját munkájukat. Erre a Wikibase bármely más szoftvernél alkalmasabb.

Mi kell ahhoz, hogy a FactGrid befogadja a projektem?

A FactGrid-platformnak nincs láthatatlan mélyrétege. Bárki lekérdezhet az adatbázisból, és ugyanazt az eredményt fogja kapni akár be van jelentkezve, akár nincs. A személyes felhasználói fiók annyi előnnyel jár, hogy kiválaszthatod a kívánt nyelvet, miközben az adatokat böngészed, illetve lesz egy “szerkesztés”-link minden állítás alatt.

Ha szeretnéd betáplálni az adataid a FactGridbe, és ha szeretnél egy projektet futtatni a platformon, akkor szükséged lesz felhasználói fiókra. Ezt a valódi neved megadásával kaphatsz az adminisztrátoroktól. Ehhez az oldalon találsz egy “Request account” (felhasználó fiók igénylése) szövegű linket. E-mailben is felveheted velünk a kapcsolatot. Projektvezetők kaphatnak adminisztratív fiókokat, amivel kijelölhetnek csapattagokat, projekthez kapcsolódó személyeket.

Miután bejelentkeztél, felvihetsz adatokat nagy mennyiségben vagy végezhetsz meghatározott javításokat bármelyik elemen. Minden változtatásod a felhasználói fiókodhoz lesz kapcsolva. Mások visszavonhatják a szerkesztéseid, de nem nyomtalanul, dokumentálva lesz az elem történetében, mindenki láthatja.

Ha egy összetettebb projekten szeretnél dolgozni, —

  • ami lehet személyes családkutatás,
  • lehet egy egyszeri vizualizáció egy szemináriumi dolgozathoz,
  • vagy akár több ezer tételnyi adat bevitele egy 5 éves projekt folyamán

— egyeztess a többi felhasználóval és a platform szervezőivel. Nem (feltétlen) fogunk egy nyilvános egyetértési nyilatkozatot aláírni, de a blogunkon hírt adhatunk a projektedről, hogy eljusson mindenkihez a platformon. A munka akkor válik igazán izgalmassá, amikor mások befejezett munkáját módosítod, illetve amikor más projektek résztvevőit inspirálod az általad bevezetett modellezés használatára. Nem kötelező átbeszélni az adatmodelleket a többiekkel, de a modellek megosztása segíthet a kutatásodnak új embereket elérni, illetve felhasználhatók lesznek mások által létrehozott lekérdezésekben vagy vizualizációkban.

A szoftvert arra tervezték, hogy kezelni tudja mind az olyan állításokat, amelyek csak számodra érdekesek, mint azokat, amelyek az eredeti kutatási témádnál jóval távolabbra elérnek majd.

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).
Jack Kirby, “The Fourth Dimension is a many splattered thing!”, Alarming Tales, 1 (1957. szeptember).

The first volume of the Thuringian pastor’s book (1500–1920) as a Wikibase data set

auf Deutsch

In a tremendous effort of a year’s work, Heino Richard of the Genealogical Society of Thuringia e.V., step by step translated the first volume of the Thuringian Pastors’ Books (the volume for the former Duchy of Gotha) into data which we could now feed into FactGrid: More than 13,300 database objects are stemming from this work allowing now entirely new explorations of the territory’s social and religious history. We as curious about the joint ventures this work might inspire. There is no reason to fear that the database version will render all further work on the paper-based volumes obsolete; the platform might, however, offer itself to the editors of the Pfarrerbuch as an unexpected aid.

The eight volumes cover all the parishes of the former Thuringian territories from the Reformation to the 20th century. A first survey is opening each volume with a tour through all the parishes and offices giving the lists of the pastors and auxiliaries who held the respective offices. The main part is in each volume devoted to the individual biographies. Genealogy is key: Pastor after pastor we get the parents with their professions, their wives (with their respective parents and backgrounds), and eventually the children (with information about their professions and the families they married into).

“Things, not strings” – database objects instead of names to be merely spelled out

Translating the volumes into FactGrid-Wikibase data became an ordeal with software’s call for database objects to be connected – where the printed volume was just stating names in various strings of letters. One would have wished to get persistent identifiers with these names since almost all these names reappeared in various contexts – as office holders, as the targets of individual biographies and in various related functions as fathers, sons, sons-in-law or fathers-in-law in the other biographies – without any further clarification of the hard identities behind the mentionings. All this was tricky since names were passed across the whole range from fathers to son, or from grandfathers and uncles to grandsons and nephews to name the closer options that would become most difficult to set apart.

1953 church dignitaries became the stock to start with – almost all connected to more than one of the 142 parishes. The set doubled, tripled and quadrupled with the wives, parents and children and their new relatives to a total of 13,344 data records (as of today). All the records had to be connected to birth and death dates, places, information about marriages, terms of office and occupations.

The entire data is still flawed here and there – it will straighten out the the use it will find. A simple check sheds light into the abyss: We still have some 200 personal data records connected to more than one father and one mother. The double records have sprung unto existence wherever we failed to understand that people were the same – a given name missing or an alternative spelling would render the automatic identification impossible. Things are just as tricky where we supposed that we were dealing with a single person whilst we were actually fusing information of two different lives into a single data record.

Merging data sets remains as painful as the reversal since the software does not take much of an effort to keep track of all the consequences to observe when entire branches of families have been duplicated in the course of the input.

Software features one would love to have

The input of genealogical data calls for a module that understands what basically is. The module should generate family trees and warn you before any input that it has found identical family fingerprints: Children from two families are unlikely to share their birthdays; just as they are unlikely to marry into the same families or to share fathers with the same background data. When entering data, the software should highlight congruent structures and help to merge them with look at the entire overlap which it can track far better than any human eye.

The lack of the stand-alone frontend is even more grievous. Those who want to read the database are not interested in the input pages that list the various triples and qualifiers just as we happened to enter them.

Magnus Manke’s “Reasonator” and Markus Krötzsch’s “SQID” demonstrate what Wikidata and Wikibase should receive: an interface that is solely geared towards the display of data. The next generation of such interfaces will do more than just display the statements made on a single item in a better order. Configurable interfaces will gather information from items referring to your query. It is precarious to list 800 letters and publications of a person you are exploring on the person’s item, if you have already created 800 items for all these titles all with in-depth information on the authors, collaborators, publishers, performances, recipients, archival holdings and so on. It should suffice to note a person’s father and mother on the person’s item — once you start giving reciprocal information on the parents’ pages and siblings you are in the middle of a mess of data which you will inevitably fail to keep in congruence.

Lacking a more cohesive interface it remains difficult to present a data set like this one.

So how can one see what’s in it?

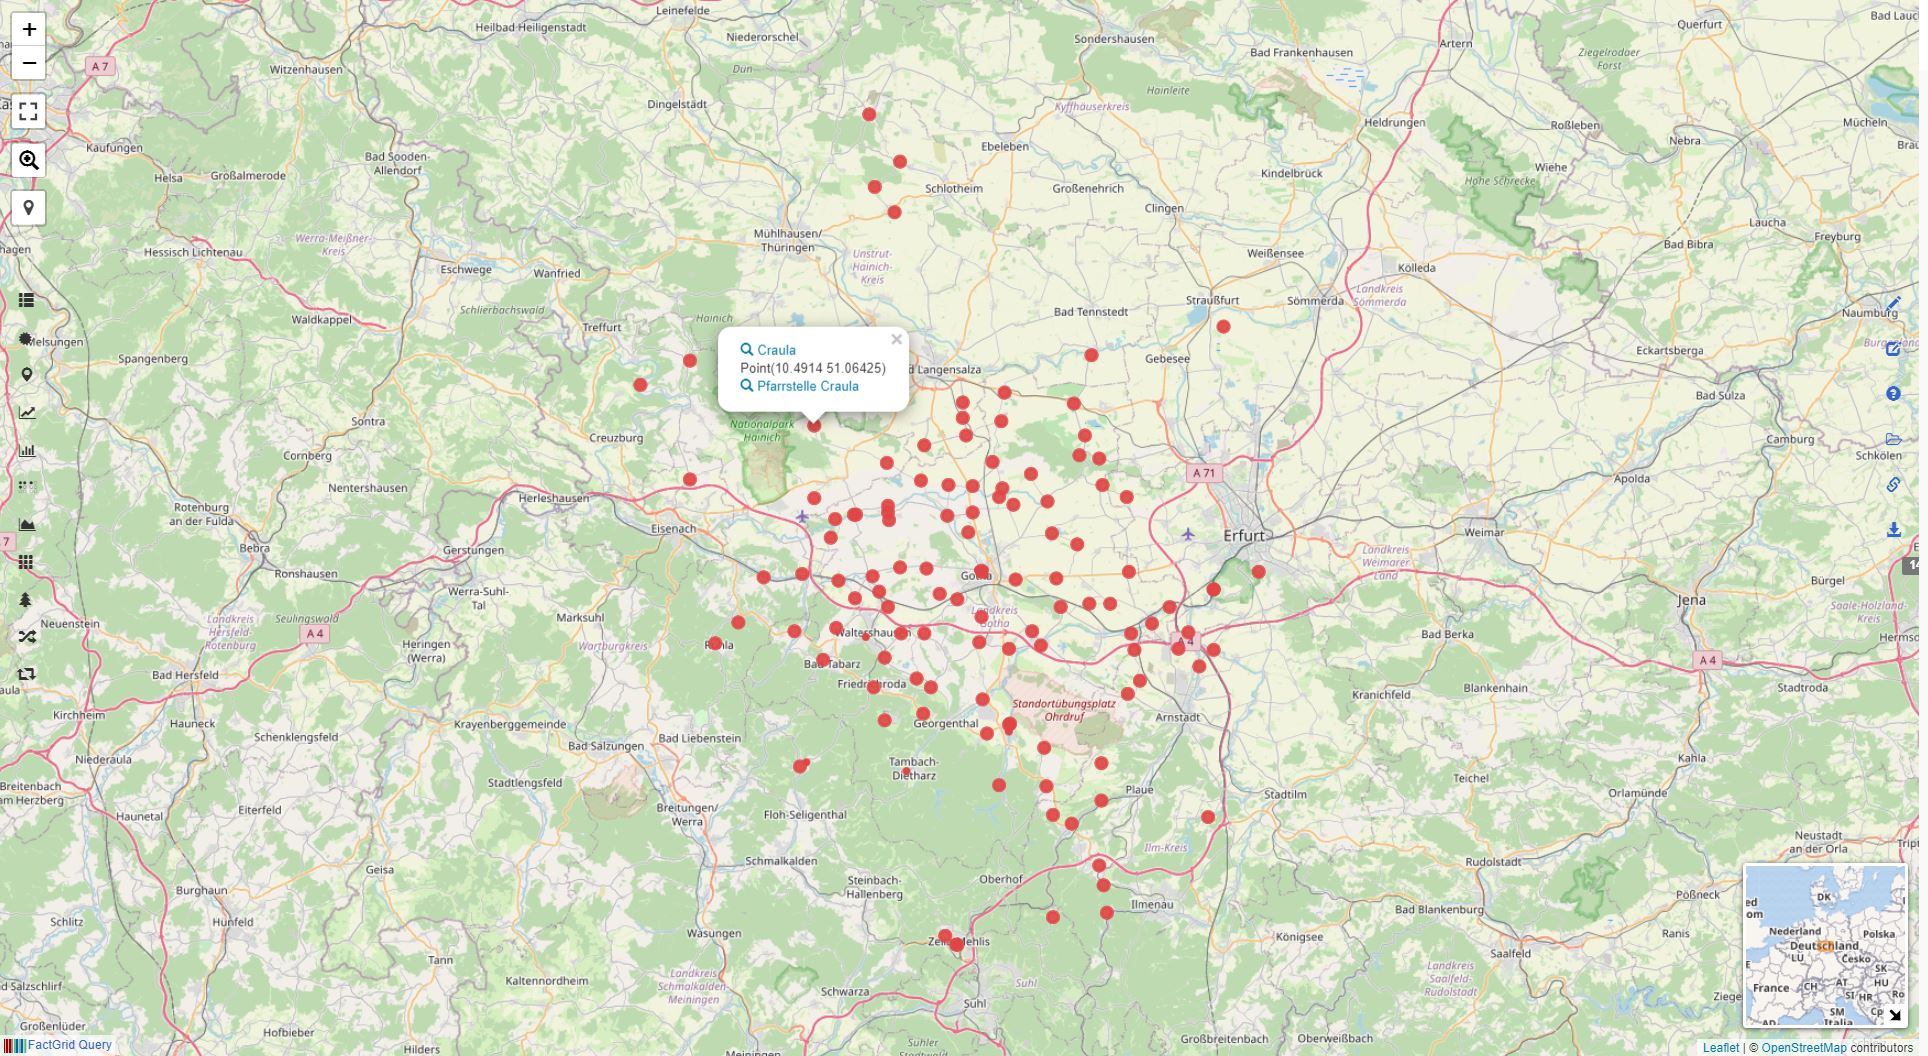
What we can do in the present situation is to give first searches that enable readers to start their own more specific searches – knowing that SPARQL will be a huge put off for the majority of readers. The most practical first search to start with will be the query for all the Protestant parishes of the former Duchy, to appear on a map:

Click the red dots to access to the records of the individual parishes with the lists of pastors registered on the each item.

The table version allows the data to be downloaded as JSON, TSV and CSV data records. TSV, “Table Separated Values”, can be processed in data sheets, whether Excel or Google. The search is sent off with the blue arrow key:

You will have to study an exemplary personal data record before you start your own searches as you need to know how we formulated the triples, i.e. the miniature statements stored in the database, in order to run effective searches as SPARQL queries:

The following query generates a table of all pastors with their birth dates, death dates and parents. With the input help (press the i-Icon to activate it) you can add more table columns to the search in order to get the additional information on children, wives, offices, memberships etc.:

All 13,484 database objects that are using information from the first volume of the Pastors’ Book can be bundled with the P12 (literature) + Q43361 (the first volume of the Thuringian Pastors’ Book) filter.

What is in it to learn?

The Thuringian Pastors’ Book genealogical focus opens up a first interesting perspective: Religion becomes after the territorial decisions of the Reformation increasingly a family institution: You take your religion with you as you receive it at birth. This is even more so with the church hierarchy that evolves. Families become the partners of the territorial churches supplying the students of theology and the pastors for generations. With the database we should become able to ask the more specific questions:

  • What was the exact influence of individual family positions: father, mother, grandfathers, uncles? How did that influence accumulate with more than one pastor in the family?
  • Did the family influence on becoming a pastor decrease over time – with the compulsory education becoming the central provider of professional decisions and career options in the course of the 19th century (and when exactly did such an influence become more noticeable)?
  • To what extent was marrying into a rectory household an advantage – for one’s own career, for the careers of the children?
  • Were local networks as valuable as relationships across spatial distances?
  • To what extent did the ecclesiastical appointments open – geographically? Where did the pastors come from over time?

A project looking for partners

We will have to bring people and institutions together to make our data sets more accessible and the CC0 license is not the threshold here.

(1) It would be an immense gain if could get Wikidata and Histropedia people on board. They are the people who understand the technical side far better than the FactGrid community of the historians; and somehow we should become able to work hands in hands.

(2) It would be a huge win if the resource attracted the team behind the Thuringian pastors books. The software we are using is not really a tool to digest books – it is a tool to facilitate your research. We have the ideal platform one would use to set identifiers and to collect and accumulate information – on the platform with the sources you will not be able to link in the volumes. FactGrid is a team’s tool to be used in the process that prepares a volume.

(3) We would be pleased if we could win the Eisenach State Church Archives for the project. For two years now we have been working with the Church Archive of the City of Gotha, which has started to use the database as its own repository. It would be exciting to widen this project an to get a clearer picture of the whereabouts of archival materials from the 142 parish we have been exploring with this project.

(4) A far broader data networking should add complexity and depth to the work done so far: Our 2000 pastors have written sermons, books, and letters. The Gotha Research Library will keep more of these publications than any other institution. We should be able to match our records to fuse the next layer of networking – the layer of public and private networking via letters and publications into the database with its present genealogical focus. The entire production of books and the links to digitisations is now increasingly done by the VD16, VD17 and VD18 online catalogues and the Kalliope-Database. It would be interesting to connect these records to allow the swift step from personal records to online documents. The Gotha Research Centre will not be able to organise such a projects – it will need partners who adopt the work we did here in a pilot study of the database’s potentials.

If you get interested in the data set and start exploring it, let us know and share your research with us right here on the blog.

Der erste Band des Thüringer Pfarrerbuchs (1500–1920) als Wikibase-Datensatz

English Version

In einer gewaltigen Arbeitsleistung überführte Heino Richard von der Arbeitsgemeinschaft Genealogie Thüringen e.V., Gothaer und Eisenacher Land, im letzten Jahr den ersten Band des Thüringischen Pfarrerbuchs, den Band für das ehemalige Herzogtum Gotha, in eine Version von über 13,300 Datenbankobjekten, die nun ganz neue Auswertungen erlaubt und die vielleicht damit interessante Kooperationen nahelegt. Dass das Datenbankangebot die weitere Arbeit an den Pfarrerbüchern erübrigen wird, steht nicht zu befürchten. Vielleicht aber wird sich das FactGrid den Bearbeitern der Bände als unerwartetes Hilfsmittel anbieten.

Die bisher erstellten acht Bände erfassen von der Reformation bis ins 20. Jahrhundert alle Pfarreien der ehemaligen Thüringer Territorien.

In einem ersten Part sind jeweils die Amtsinhaber nach Pfarreien chronologisch aufgelistet. Ihnen folgen im Hauptteil alphabetisch sortiert die eingehenden Biographien mit extensiven genealogischen Vernetzungen. Notiert werden jeweils die Eltern, die Ehefrauen mit Eltern und die Kinder, nochmals mit Hintergrundinformationen über Berufe, Ehepartner und deren Elternhäuser.

“Things, not Strings!” – Datenbankobjekte statt Namen in Buchstaben

Was in den acht Bänden nicht so schnell sichtbar wird, wurde in der Bearbeitung für das FactGrid zur harten Herausforderung: Wikibase will mit Datenbankobjekten, nicht mit schlichten Namen befüttert sein. Das Thüringer Pfarrerbuch liefert die Namen mit wechselnden Hintergründen (und immer wieder auch variierenden Schreibweisen), doch an keiner Stelle mit stabilen Identifikatoren; und so tauchen dieselben Person jederzeit für sich genommen und in verschiedensten Biogrammen als Väter, Söhne, Schwiegersöhne oder Schwiegerväter auf, ohne dass sogleich klar wird, wer da wer ist. Mit der Datenbankerfassung musste entschieden werden, wann jemand derselbe war – keine einfache Entscheidung, da Namen keine Eindeutigkeit schufen, familiär weitergegeben von Väter an Söhne wie zu Ehren näherer und fernerer Verwandter.

Das Datenvolumen lässt das Dickicht erahnen. Auf die 142 Pfarreien, die zwischen 1500 und 1920 im ehemaligen Territorium bestanden, kamen 1953 Personen als zeitweilige Amtsträger. Mit deren genealogischen Geflechten summiert sich der Personenbestand aktuell auf 13.344 Datensätze, die mit Eckdaten zu Geburt, Tod, Eheschluss und Kindergeburten, Amtszeiten und Berufen auszustatten waren.

Der gesamte Datenkomplex ist noch nicht vollständig konsolidiert. Ein Schlaglicht darauf werfen die Abfragen von Kindern und Eltern: Gut 200 Personendatensätze verfügen derzeit noch über mehr als einen Vater und eine Mutter – Doppelungen zu denen es kam, wenn wir versehentlich unter den Vätern oder Müttern Dubletten anlegten, Datensätze zur selben Person, da erst einmal nicht klar war, dass es sich um dieselbe Person handelte. In anderen Fällen haben Datensätze zwei Mütter oder Väter, da wir bislang verkannten, dass wir hier Biographien hätten trennen müssen – in sie flossen Eltern zweier gleichnamiger, nun zu trennender Personen ein.

Sowohl das Vereinen von Datensätzen wie das Auseinandernehmen sind Arbeiten, bei denen man schnell den Überblick verliert, da die Software nicht erfasst, wo ganze Äste gedoppelter oder zu trennende Information vorliegen und wie mit ihnen am besten zu verfahren ist.

Softwaredesiderate

Für die Eingabe genealogischer Daten wünschte man sich ein Modul, das versteht, was Verwandtschaftsbeziehungen ausmacht, und wie sie in der vorliegenden Datenbank notiert werden. Das Modul sollte Stammbäume generieren und noch im Eingabeprozess warnen, wenn sich familiäre Fingerabdrücke gleichen; es ist unwahrscheinlich, dass Kinder zweier Familien die Geburtstage oder Ehepartner miteinander teilen. Noch bei der Eingabe sollte die Software deckungsgleiche Strukturen aufscheinen lassen und aufzeigen, wie Äste von Information aufeinander zu legen sind.

Unbefriedigend ist bei alledem, dass wir in einer Software ohne stand-alone-Interface arbeiten. Magnus Mankes „Reasonator“ und Markus Krötzschs „SQID“ zeigten, was Wikidata und Wikibase bislang vor allem fehlt: die allein auf die Datennutzung ausgerichtete Oberfläche. Die weiterführende Technologie wird an selber Stelle viel mehr leisten müssen, als Daten aus einem jeweiligen Item besser geordnet wiederzugeben. Interessant werden konfigurierbare Oberflächen, die die Datenbank befragen, und die es erübrigen, Information in ihr gedoppelt abzulegen. Es ist prekär, im Datensatz zu einer Person, sagen wir, 800 Briefe und Publikationen der Person zu listen, wenn man bereits zu diesen 800 Objekten eigene Datensätze anlegte, die weitaus komplexer über Autoren, Beiträger, Adressaten, Verleger, Aufführungsorte, Aufbewahrungsorte, Werkausgaben, Digitalisierte, Transkripte, Übersetzungen und genannten Personen informieren. Im Moment legen wir Informationen doppelt und dreifach ab, allein um im Blick zu behalten, dass sie in der Datenbank vorliegen – mit allen Risiken dabei auseinander laufender Informationsstände.

In der misslichen Lage ist die hiermit vorgelegte Arbeit erst einmal fast nur für Datenfachleute klarer lesbar.

Erste Überblicke und Suchen

Die vielleicht praktischste erste Suche ist die aller protestantischen Pfarrämter des Herzogtums mit der Darstellung auf der Karte:

Jeder einzelne Punkt lässt sich anklicken und birgt den Zugriff auf die Datensätze der Pfarrämter und über diese auf die Amtsinhaber in ihrer jeweiligen Folge.

Die Tabellenversion erlaubt, es die Daten als JSON, TSV und CSV Datensätze herunterzulanden. “Table Separated Values” lassen sich in Datenblättern, ob Excel oder Google Sheets, weiterverarbeiten. Die Suche muss jeweils aktuell mit der blauen Pfeiltaste aktiviert werden:

Es empfiehlt sich, vor jeder weiteren Erkundung einen exemplarischen Personendatensatz zu studieren, um zu erfassen, welche Informationen von uns wie abgelegt wurden – es ist dies das Wissen, das bei jeder SPARQL-Abfrage zum Einsatz kommt:

Die folgende Anfrage generiert eine Tabelle aller Pfarrer mit deren Geburtsdaten, Sterbedaten und Eltern. Mit der Eingabehilfe (das i-Icon aktiviert sie) lassen sich beliebige weitere Tabellenspalten zu Kindern, Ehefrauen, Ämtern, Mitgliedschaften hinzusetzen:

Alle 13.484 Objekte, die den ersten Band des Pfarrerbuchs als Ressource nutzen, lassen jederzeit sich mit der Eingrenzung auf der Literaturangabe bündeln.

Inspiration

Der genealogische Schwerpunkt des Pfarrerbuchs eröffnet eine erste interessanteste Perspektive: Religion ist im protestantischen Raum, mehr als im katholischen, Familiensache. Die territoriale Organisation der religiösen Betreuung findet Pfarrfamilien als organisatorischen Partner. Mit der Datenbankerfassung sollten sich die die härteren Fragen stellen lassen:

  • Wie groß war der spezifische Einfluss von Familienpositionen: Vätern, Müttern, Großvätern, Onkeln?
  • Wie veränderte sich dieser Einfluss? Inwieweit schwand er im Prozess, in dem Bildung klarer eine Angelegenheit der Schulsysteme wurde, die Berufswege unabhängig vom Elternhaus zu ebnen suchen?
  • Inwiefern war die Einheirat in einen Pfarrhaushalt ein Vorteil – für die eigene Kariere, wie die der Kinder?
  • Waren räumlich nahe Vernetzungen gleich viel wert wie Beziehungen über räumliche Distanz hinweg?
  • In welchem Umfang öffnete sich die kirchliche Ämterbesetzung im Verlauf? Wo kamen die Pfarrer her, wie verlagerten sich Herkunftsschwerpunkte?

Projekt auf Partnersuche

Vor allem wird nun die Frage interessant, welche Benutzergruppen wir in Austausch miteinander bringen können.

(1) Ein immenser Gewinn wäre es, könnten wir Geschichtsinteressierte des Wikidata-Projektes und der Histropedia auf den für uns noch durchaus unhandlichen Datenschatz lenken. In beiden Bereichen halten sich die Nutzer auf, die die Technik erst einmal weit besser verstehen als die FactGrid-Community der derzeit etwas über 100 Historiker und Historikerinnen.

(2) Interessant wäre es, das nach wie vor am Thüringer Pfarrerbuchs arbeitende Team für das FactGrid zu gewinnen. Unsere Datenbank sollte sich vor allem als immenser Zettelkasten eignen, in dem sich Informationen ablegen und mit den jeweils aktuellen Quellenbelegen ausstatten lassen.

(3) Freuen würden wir uns, gelänge es uns, das Landeskirchenarchiv Eisenach näher an das Projekt zu binden. Seit gut zwei Jahren arbeiten wir mit dem Kirchenarchiv der Stadt Gotha zusammen, das seinen Aktenbestand im FactGrid verwaltet. Spannend wäre es, zu erfassen, welche Datenbestände aus allen 142 Pfarrämtern heute noch wo liegen. Es ist dies ein im Kirchenarchiv Eisenach soeben koordiniertes Projekt.

(4) Die breite Datenvernetzung wird die bis hierhin getane Arbeit mit Vielschichtigkeit ausstatten: Die von uns erfassten Personen schrieben Bücher und Briefe. Die Forschungsbibliothek Gotha wird von den Publikationen ihres Territoriums mehr als jede andere Institution aufbewahren. Wir sollten hier den wechselseitigen Informationsabgleich zu Wege bringen. Der Abgleich mit dem VD16, VD17 und VD18 und der Kalliope-Datenbestand würde es erlauben, die Datensammlung an die laufende Erschließung von Texten und Dokumenten anzuschließen. Zur genealogischen Vernetzung der Biogramme käme im selben Moment die Vernetzung der jeweiligen öffentlichen Interaktion und persönlichen Korrespondenz. Für die Forschung dürfte es attraktiv sein, mit den Datensätzen Zugriff auf die Digitalisate zu gewinnen, und zu den Personen Texte und Austausch unmittelbar verfügbar vorliegen zu haben.

Wir sind neugierig darauf, wie sich das vorgelegte Datenangebot entfalten wird, und laden dazu ein, Erkundungen der Datensätze noch hier im Blog mit uns zu teilen.