Kopfzerbrechen Nr. 3: Genealogien

Genealogien durchdringen alle Arbeitsgebiete. Wer Bibliothekskataloge durchsucht, erhält Verlagsangaben und bleibt im Dunkeln darüber, wie diese Angaben zusammenhängen.

Genealogien der Geschäftsführung

Dem Buchhandelshistoriker ist klar, dass er hier genealogisch denken muss: Die städtischen Behörden vergaben Lizenzen für den Druck, Verlag und/oder Verkauf von Büchern. Die Lizenzen wurden innerfamiliär weitergegeben vom Vater auf den Sohn oder, bei ausbleibenden Erben, auf die Witwe und die Kinder, bis jemand in das Geschäft einheiratete oder es von auswärts kommend erwarb.

Neue Lizenzen wurden selten eröffnet. Das Interesse des Hofes konnte hier innserstädtische Interessen an der Vermeidung von Konkurrenz außer Kraft setzen. Eine Geschäftsteilung konnte eine Differenzierung in verschiedene Lizenzen mit sich bringen – fortan bestand ein Unternehmen als reine Druckerei, und eines als reines Verlagsgeschäft mit Buchhandlung.

Dutzende von Namen über drei Jahrhunderte ordnen sich, sobald man die Genealogie der weitergegebenen Rechte erfasst, zu wenigen Strängen pro Stadt – das kann wie folgt für München oder Gotha aussehen:

Vergleichbare Darstellungen der Geschäftsbeziehungen sind bereits Teil des ungeborgenen Katalogwissens. Die Kataloge könnten theoretisch auf die Nahtstellen hinweisen, an denen vermutlich ein Wechsel stattfand, ein Name ausläuft, ein anderer anhebt. Letztlich erfordert die Rekonstruktion der Zusammenhänge jedoch eigenes Wissen über Familienbeziehungen und die Zusammenhänge der städtischen Gewerbeakten.

Auf der Ebene der Software benötigte man die passenden Darstellungsoptionen. Vor allem aber braucht man Schnittstellen, an denen Benutzer die Verbindungen herstellen und die Genealogie ordnen können.

Genetische Verhältnisse: Stemmata

Viel komplizierter liegen die Verhältnisse bei den genetischen Zusammenhängen zwischen Buchausgaben. Manche Kataloge scheitern hier schon im Ansatz wie der hinter Google Books. Man versuche etwa, die Nummern eines Journals aus dem 18. Jahrhundert, dessen Digitalisate irgendwie im System stecken, sich der Reihenfolge nach anzeigen zu lassen. Google hilft einem hier mit einem vagen Angebot weiter nach dem Motto „Leser, die dies lasen, könnten auch diese Links interessant finden“.

Doch auch ausgefeilte Kataloge wie der ESTC, das Verzeichnis aller englischen Titel der Jahre 1473 bis 1800, weisen hier rasch unüberschaubar werdende Gebiete auf – dann etwa, wenn minimale Varianten von einer Ausgabe, verschiedene Auflagen und zudem einzelne Teilbände auf ein Jahr fallen wie im Fall der Katalogangabe für Delarivier Manleys Atalantis:
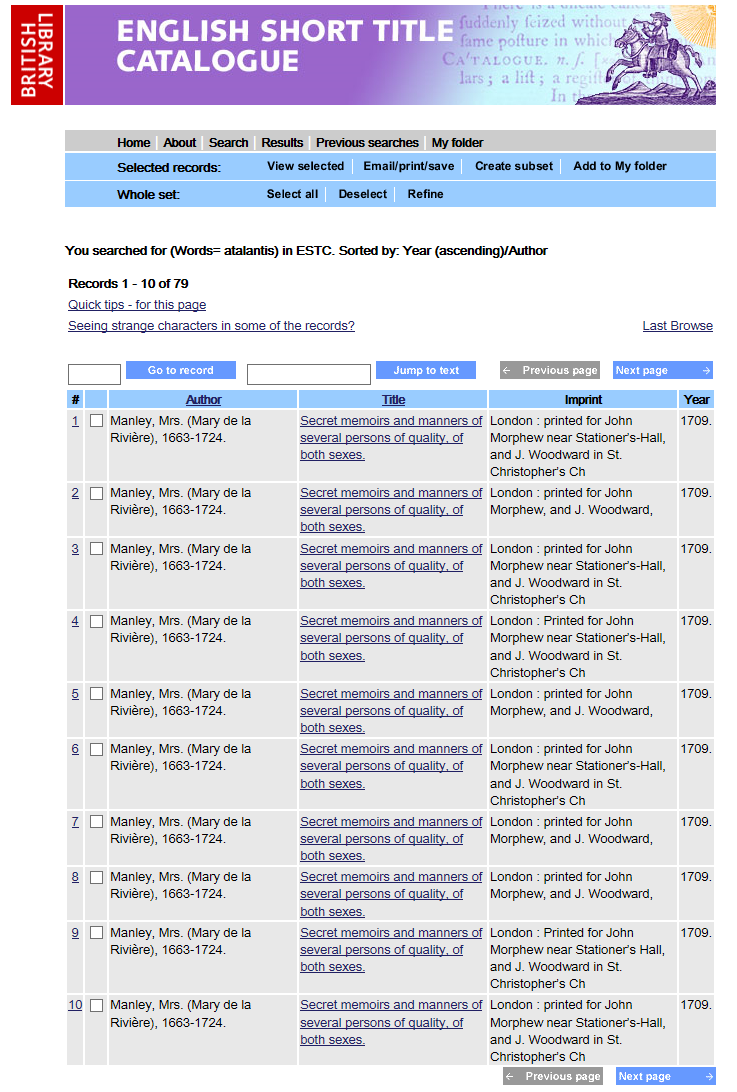
ESTC Suche: “Atalantis”. Auch nach der chronologischen Sortierung bleibt unklar, hinter welchem Link der erste Text liegt.

Man wünschte sich hier nicht minder eine Option der genealogischen Strukturierung: Der erste Band erschien im Mai 1709; im Juli musste er nachgedruckt werden. Band zwei folgte im Oktober. 1710 brachte die Autorin ein Werk heraus, das erst einmal einen eigenen Titel trug: die Memoirs of Europe. Ein halbes Jahr später folgte davon Band zwei. Ab 1715/16 wurden diese Bände in Neuausgaben der Atalantis als deren Folgen III und IV notiert.

Dem Markterfolg wurden ab 1711 auch noch ganz andere Bücher untergeschoben: 1705 war erstmals eine Queen Zarah mit ähnlicher Skandalgeschichte erschienen. Deren zweite Ausgabe kommt 1711 „by way of appendix to the New Atalantis“ heraus. Ein weiterer älterer Titel macht denselben Sprung in den Komplex und vier neue wollen unverzüglich in ihn hinein. Siehe hier die geschlossenere genetische Darstellung: http://pierre-marteau.com/library/e-1709-0004.html.

Der ESTC ist im Kern ein Nationalkatalog. Das wird deutlicher, sobald man die weiteren Titel auf dem europäischen Markt nachweisen will – dem versagt sich der ESTC. In den Niederlanden erfolgte 1713 die Übersetzung der ersten zwei Bände ins Französische. Eine nachweisbare, kondensierte deutsche Fassung datiert vermutlich von 1714 und übersetzt nach der französischen Ausgabe.

Für die beschriebenen genetischen Beziehungen bräuchte man Stemmata, wie sie in der Handschriftenkunde verbreitet sind. Das Komplizierte ist hier, dass die Beziehungen zwischen Titeln immer über das ganze Schema hinweg verlaufen können. Ein Verlag mag bei einer Neuausgabe nach der letzten ihm greifbare Ausgabe setzen. Er könnte jedoch auch auf die Erstausgabe zurückgreifen, oder eine von der Autorin korrigierte spätere. Die moderne „kritische“ Ausgabe wird sich für eine Leitausgabe entscheiden, und Varianten (wenn vorhanden) mit dem Manuskript der Autorin und den ersten und letzten Ausgaben, die sie selbst beeinflusste, erfassen.
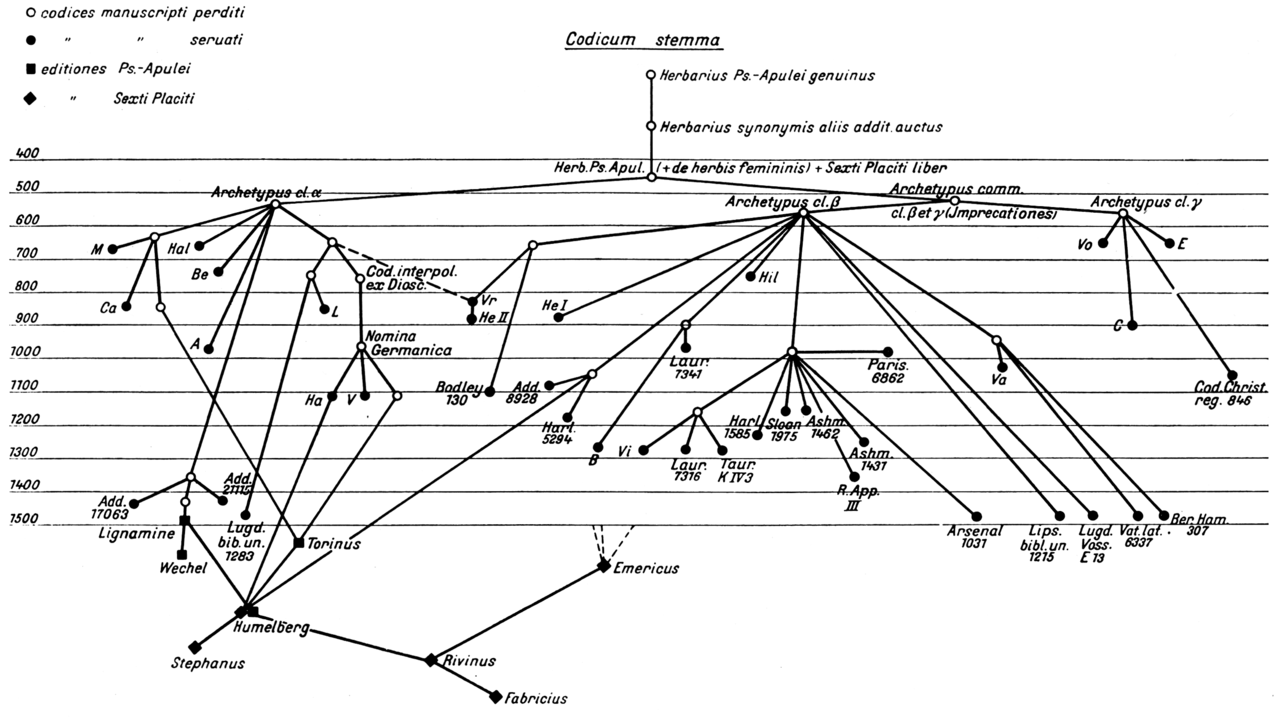
Stemma für die Manuskripte des ‘Pseudo-Apuleius Herbarius’ aus Ernst Howald and Henry E. Sigerist. Antonii Musa De herba vettonica (Leipzig 1927). https://commons.wikimedia.org/wiki/File:Howald-sigerist.png

Wieder wäre einem mit einer Schnittstelle geholfen, die es erlaubte, verschiedene genetische Beziehungen zwischen Ausgaben herzustellen, die dann in einer Visualisierung zum Zuge kämen.

Entwicklungen

Natürlich hofft man auf die Software, die selbst rekonstruiert, wie sich die Dinge ordnen – darum geht es im Umgang mit „Big Data“. Das Spannende an der Wikidata-Software ist jedoch im selben Moment, dass der Benutzer mit ihr sein Wissen viel schneller und härter einbringen und damit die großen Schneisen der Diskussion gezielt und diskutierbar schlagen könnte.


oder:
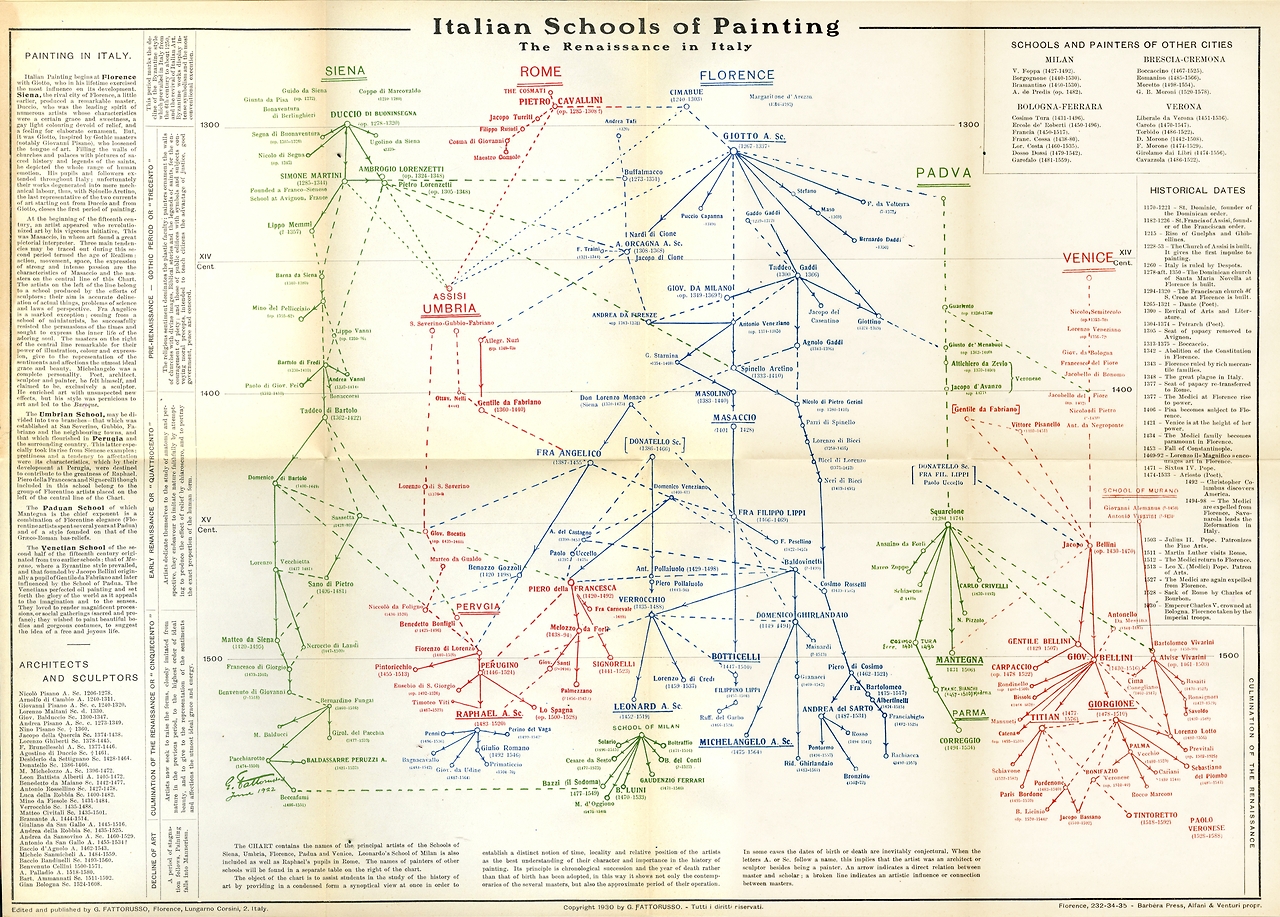
..von hier: https://www.edwardtufte.com/bboard/q-and-a-fetch-msg?msg_id=0000yO
Siehe auch

Kopfzerbrechen Nr. 2: Subskribentenlisten

Dem letzten Kopfzerbrechen sehr ähnlich ist dieses: Viele Bücher der (frühen) Neuzeit enthalten Subskribentenlisten. Der Verleger sichert die Publikation ab, indem er vorab um eine Meldung aller Interessenten am kommenden Buch bittet. Sie erhalten das Buch zu günstigeren Konditionen; der Verleger kann sich im selben Moment seines Absatzes sicher sein.

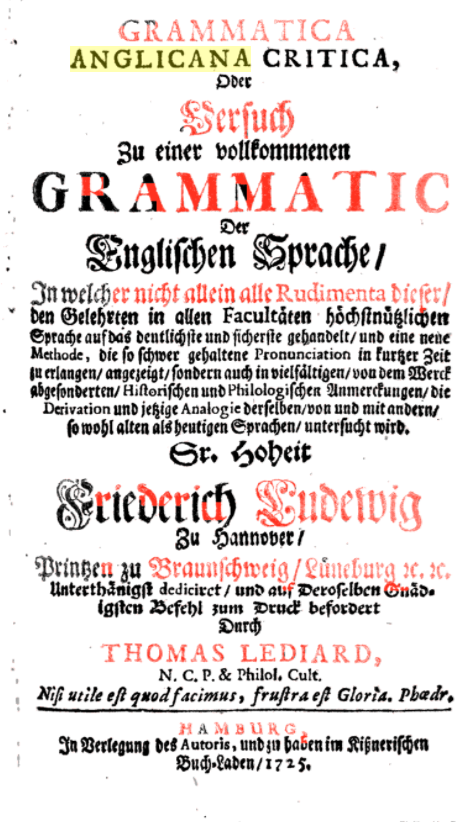
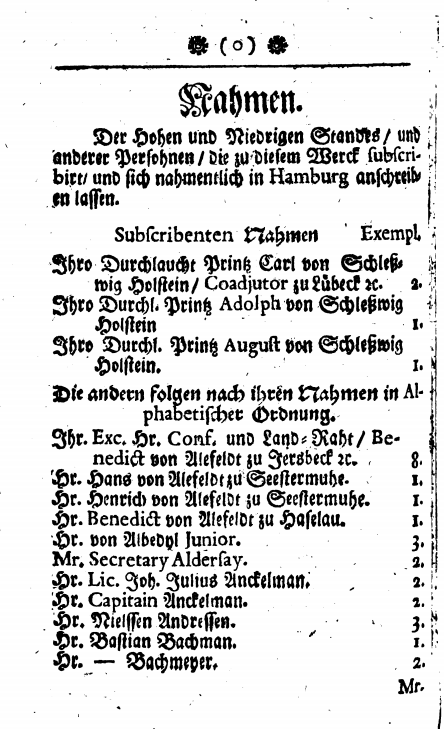
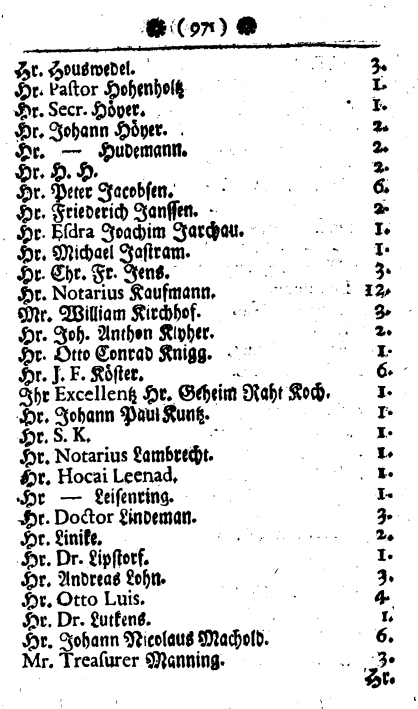
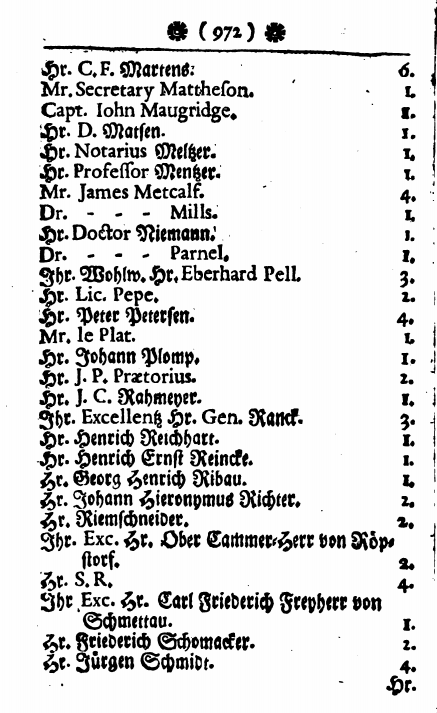
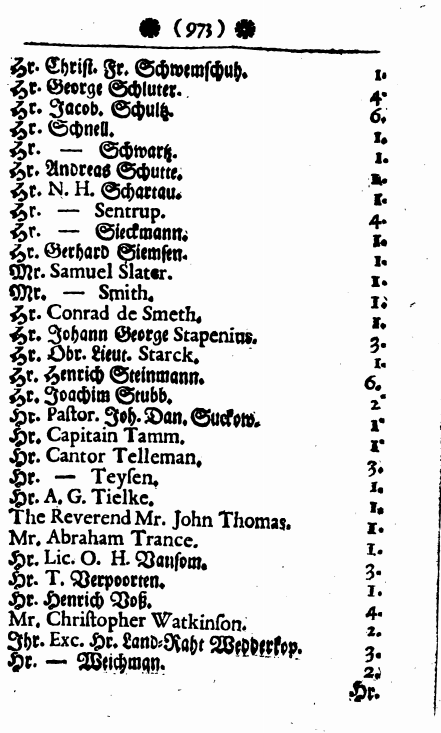
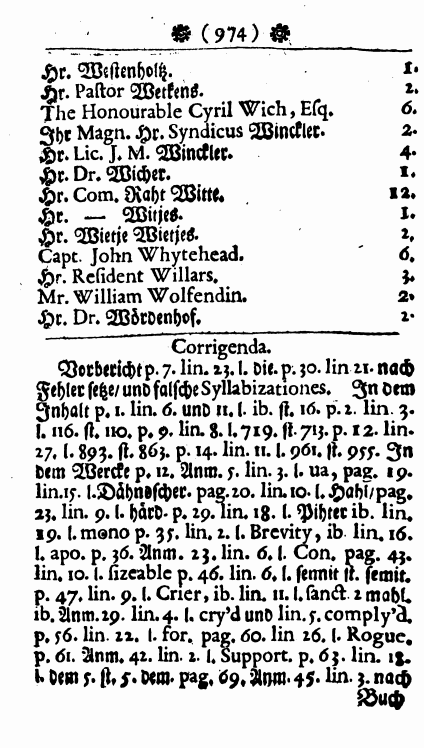
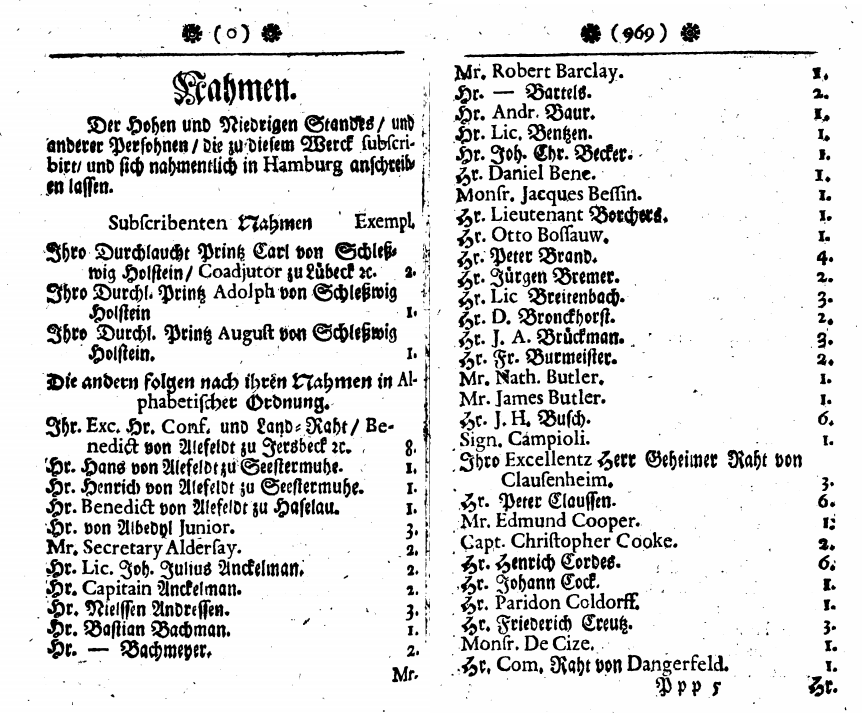
In vielen Büchern des 18. Jahrhunderts sind diese Listen am Ende abgedruckt. Es sind spannende Listen, da wir hiermit für eine ganze Zahl von Büchern – theoretisch – sehr genau wissen, wer sie in der ersten Welle las. Unten inseriere ich die Subsriptionsliste aus Thomas Lediards Grammatica Anglicana (Hamburg: Kißnerscher Buchladen, 1725). Für die nächsten Jahre wurde dies das beste Englischlehrwerk auf dem deutschen Markt.

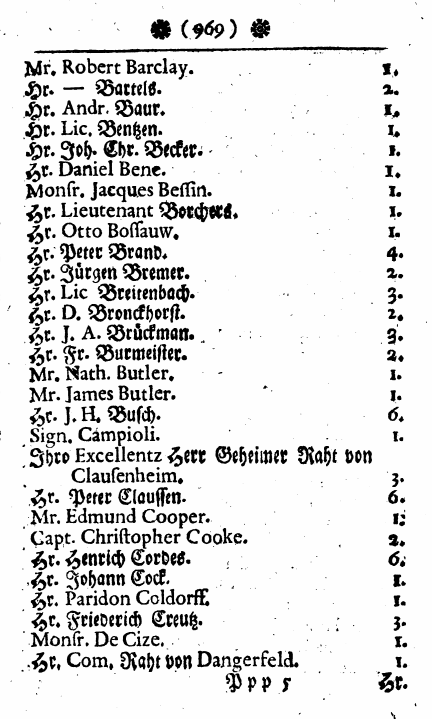
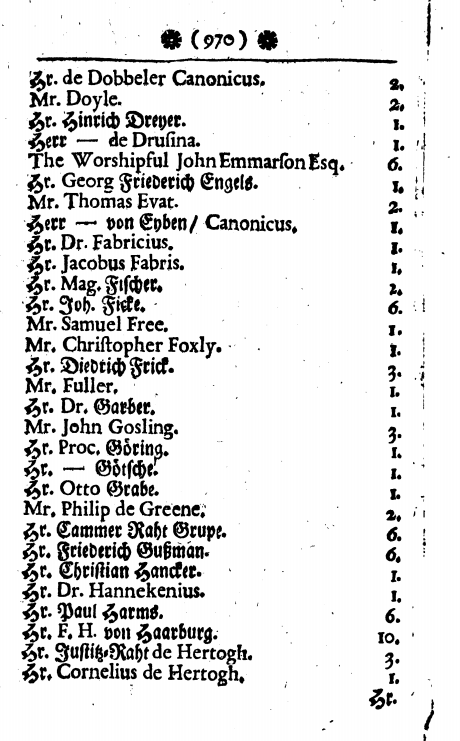
Wer glaubt, Bücher werden damals nur von hohen Standespersonen gelesen, irrt. Diese machen als abgesetzter Zirkel den Anfang. Es folgen alphabetisch die übrigen Leser: gute 180 Namen, oft mit Vornamen, mit Angaben der Bestellmengen, zuweilen mit Angaben des Berufs.

„Hr. Cantor Tellemann“ ist natürlich der in Hamburg ansässige Georg Philipp Telemann – 1725 demnach begierig, Englisch zu lernen,doch brauchte er dafür gleich drei Exemplare? Hr. Dr. Fabricius wird Johann Albert Fabricius sein, „Mr. Secretary Mattheson“ der Sekretär und Korrespondent des englischen Gesandten, Komponist und Musikkritiker – Johann Mattheson, verheiratet mit einer Engländerin und 1742 der Übersetzer der Pamela ins Deutsche.

Das Auflösen der Namen mit dem individuellen Namensvorrat des Historikers ist müßig. Man müsste die Namen mit Datenbanken abgleichen. Die Eröffnung gibt an, dass alle Genannten sich in Hamburg erreichen ließen. Das ist sowohl eine interessante Beobachtung für den, der sich fragt, wie 1725 Subskriptionen zustande kommen (demnach primär über die Werbung vor Ort), wie eine Hilfe beim Abgleich mit Wikidata und der GND. Die Lage sieht in späteren Listen komplexer aus.

Man würde definitiv die gesamte Liste eingeben. Erst mit ihr weiß man, wie viele Subskribenten es gab, und kann Vergleiche mit anderen Subskriptionsprojekten ziehen.

Es wäre interessant, Namen mit den geringen Informationen, die man hat, einzufüllen und auf die schrittweise Identifikation zu warten, auf die Anreicherung von Information. Man wünschte sich eine Schablone für Subskriptionslisten, um beim Eingeben nicht unnötig viele Parameter berücksichtigen zu müssen, und würde in einem zweiten Lauf, die Datenbank bitten, mögliche Treffer zu nennen.

Im Verlauf könnte man vielleicht soziologische Querschnitte geben. Wie alt ist man, wenn man 1725 in Hamburg Englisch lernt? Wie viele Engländer (sind diese nebenbei Sprachlehrer?), wie viele Deutsche spricht das Buch an? In welchen Berufszweigen lernt man die Fremdsprache, die in den nächsten 200 Jahren die globale Lingua Franca wird?

Die Subskribentenliste von Thomas Lediards Grammatica Anglicana (Hamburg: Kißnerscher Buchladen, 1725), S. 968-974

auf Google Books

Kopfzerbrechen Nr. 1: Gothas Wohnhäuserverzeichnisse 1828, 1841, 1846

Gothas Stadtarchiv überließ uns zur weiteren Arbeit drei Exceltabellen, die die Angaben aus den Gothaer Wohnhäuserverzeichnissen der Jahre 1828, 1841, 1846 enthalten.

Die Daten sind ein spannendes Problem für das aufzubauende FactGrid.

Gothas Häuser sind nach Straßen geordnet einfach gezählt von Nr. 1 bis Nr. 1296. Wir können über eine Umrechnungstabelle die genauen Geo-Koordinaten geben und dort, wo Gebäude unverrückt stehen, auch die heutigen Adressen nennen. Für die Fleischgasse (seit 1894 Hünersdorfstraße benannt nach Karl Heinrich Hünersdorf) macht die Tabelle 1828 etwa die Angaben, die ich am Ende gleich tabellarisch liste.

Problemstellung

Die Liste bietet regulär nur Nachnamen, manche doppelt. Viele dieser Namen tauchen 20 Jahre später in der Nachfolgeliste wieder auf. Wir wissen nicht, wann sie Wohnadressen notieren und wann Hausbesitzer. Man wird diese Namen samt und sonders in der Datenbank haben wollen, um sie im Lauf der Zeit mit Informationen anreichern zu können.

Manche Namen tauchen auch in der GND und Wikidata auf. Wir werden versuchen mit einem Import eine Landschaft bereits bekannter Personen zu liefern in der mögliche Treffer komfortabler zu identifizieren sind.

Wie aver handhabt man blanke Nachnamen in der Hoffnung auf eine spätere Anreicherung, sprich so, dass anderen Mitspielern auf derselben Plattform im Verlauf ein rotes Lämpchen leuchtet, wenn es sein könnte, dass bereits eine rudimentäre Information zu der Person ihres Interesses vorhanden ist?

Datenexzerpt aus dem Wohnhäuserverzeichnis von 1828, Gothas Fleischgasse

Hausnummer Name Beruf Sonstiges
907 Gayer Kaufmann
908 Gayer Kaufmann
909 Schuchardt Schuhmacher
910 Gams Kaufmann
911 Zeyß Obermarktmeister und Schnittwarenhändler
912 Schmidt Goldarbeiter
913 Thorwarth,sen. Seiler
914 Kaiser Schuhmacher
915 Straube Gürtlerswitwe
916 Fischer Kürschner
917 Schäfer Hofhautboist, Witwe
918 Friede Tuchmacher
919 Kiel Buchbinder
920 Holstein Nagelschmidt
921 Blumenau pens.Garde-Friseur
922 Krause Zinngieser
923 Müller Büchhändler und Antiquar
924 Möller Bürgerluitenant und Tuchhändler
925 Jusatz Rathsbaumeister und Kupferschmidt
926 Görlach Klempner
927 Thomas Posamtier
928 Schack,Carl Bäcker
929 Rüger Victualienhändler
930 Klug Seifensieder
931 Merbach Zinngieser, Witwe
932 Kohlstock,sen. Drechsler

Featured Image

Stadtplan von Gotha aus dem Brockhaus von 1910.

2017-12-1/2: Erster FactGrid Workshop in den Räumen der Wikimedia Deutschland, Berlin: Planungsseite

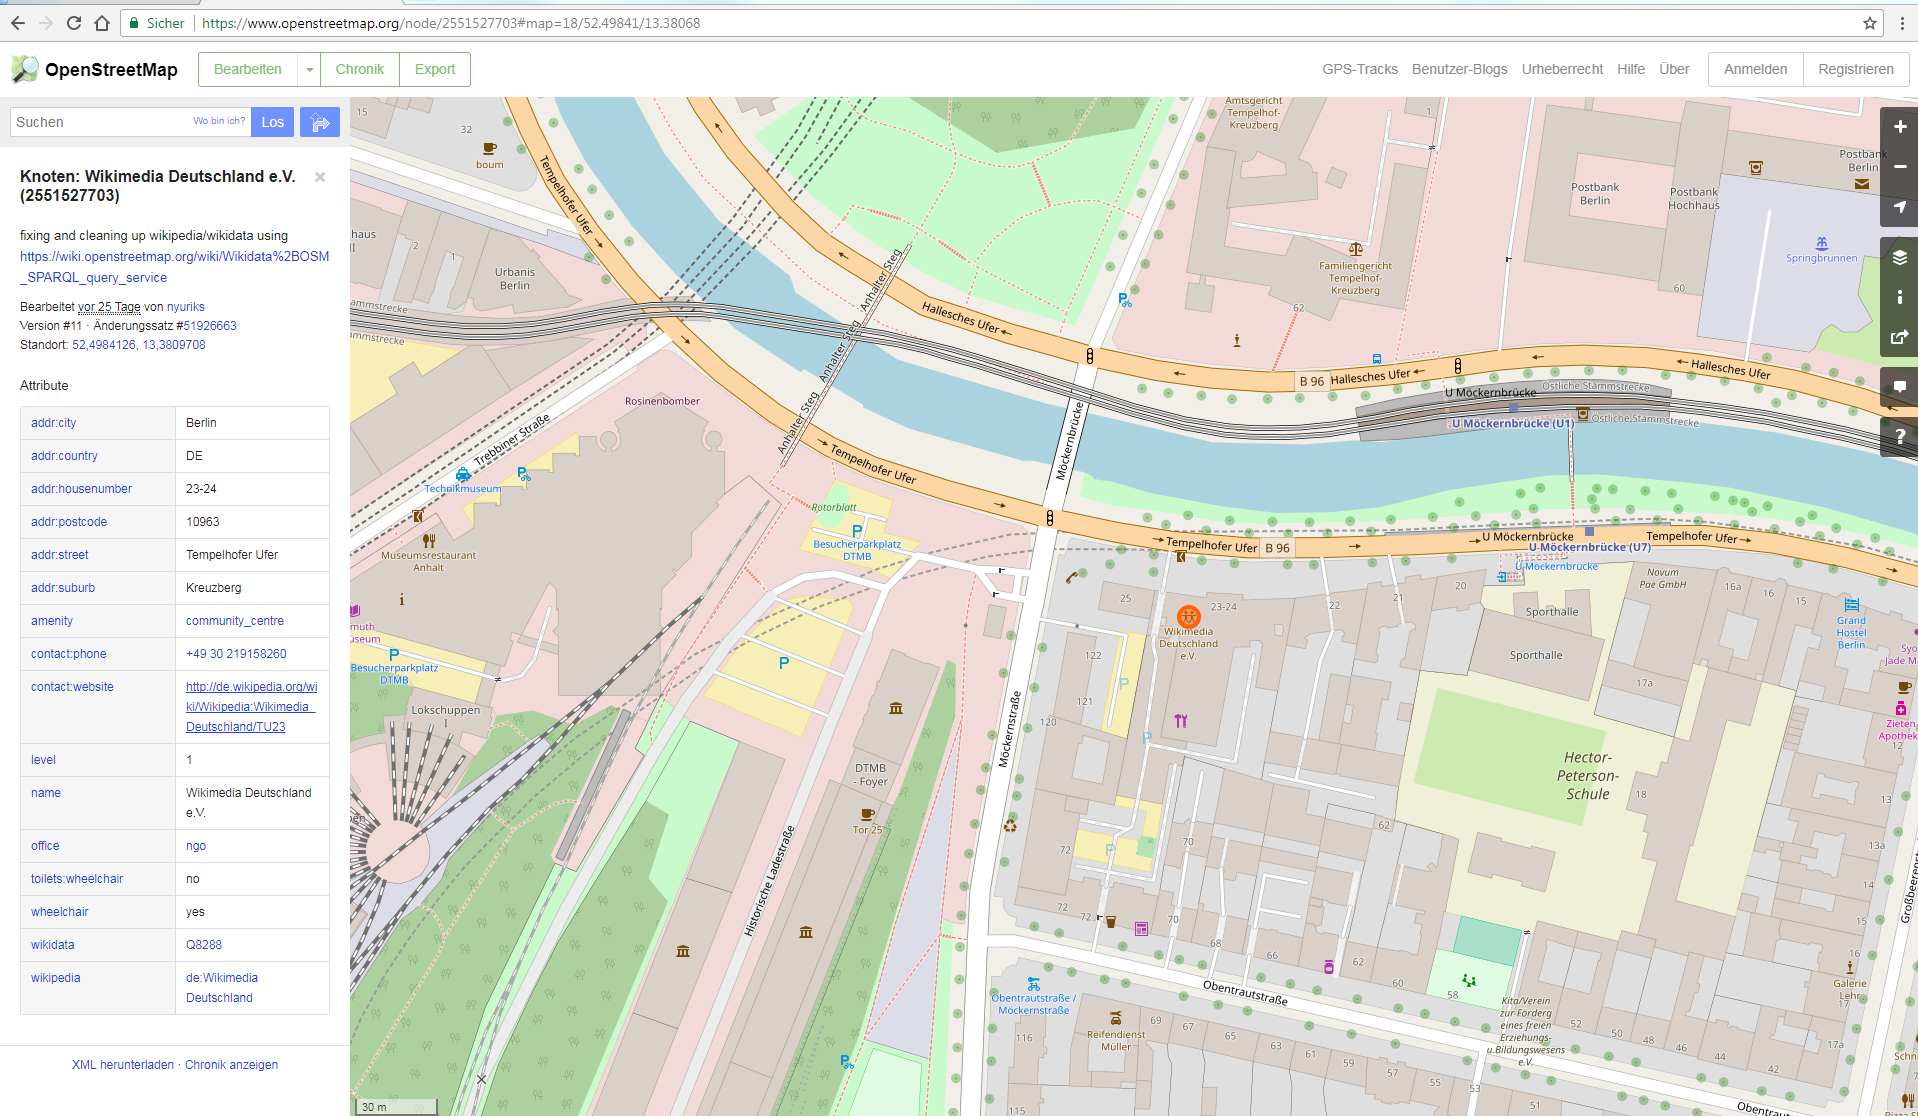
Veranstaltungsort: Tempelhofer Ufer 23-24, 10963 Berlin
Zeit: Freitag, 1.12.2017, 13:00-18:00 und Samstag 2.12.2017, 9:00-13:00
Kartenansicht: https://www.openstreetmap.org/node/2551527703#map=18/52.49841/13.38068

Vom 1. auf den 2. Dezember 2017 veranstalten das Forschungszentrum Gotha und, gastgebend, Wikimedia Deutschland einen ersten gemeinsamen Workshop des FactGrid-Projektes in den Berliner Räumen der WMDE Geschäftsstelle.

Unser Ziel ist es, Wikidata-Entwickler, Wikidata-Begeisterte und Wissenschaftler, die die Software im FactGrid-Projekt in der Forschung zum Einsatz bringen wollen, zu einem ersten größeren Ideenaustausch zusammenzubringen.

  • Was würden (Geistes-)Wissenschaftler mit einer solchen Datenbanksoftware in Forschungsprojekten gerne bewerkstelligen können?
  • Was kann die Software bereits heute?
  • Was müsste man entwickeln?
  • Was sind Entwicklungen, die ohnehin von Wikimedia geplant sind?
  • Mit welchen gemeinsamen Projekten kann die Wikidata/Wikipedia-Community für eine Plattform gewonnen werden, die sich gezielt der “original research” im Geflecht der Wikimedia-Projekte anbieten soll?
  • Inwieweit kann das FactGrid Projekt bestehende Datenressourcen (Wikidata, GND, Sammlungen bibliographischer Daten etc.) konstruktiv nutzen?
  • Wie werden sich FactGrid-Daten in Wikidata nutzen lassen?

An der Software interessierte (Geistes-)Wissenschaftler sollen in den zwei Tagen die Gelegenheit finden, Akteure des Wikidata- und Wikipedia-Feldes näher kennenzulernen und Kontakte zu knüpfen für gemeinsame Projekte – und für Aufträge auf Werkvertragsbasis im anspruchsvolleren Fall, in dem die gemeinsame Software komplexere Aufgaben bewerkstelligen soll.

Generell Interessierte aus dem größeren Wikipedia Bereich sind herzlich eingeladen, mit uns darüber nachzudenken, welchen Raum ein von Wissenschaftlern initiiertes Projekte im größeren Feld der Wikimedia-Projekte gewinnen könnte.

Die eingehenderen Veranstaltungsinformationen werden hier und auf einer parallelen Wikimedia-Seite/Anmeldungen laufend aktualisiert.

Kontaktadressen:
Nicola Zeuner, nicola.zeuner@wikimedia.de
Olaf Simons, olaf.simons@pierre-marteau.com

Ablauf

    Freitag Nachmittag: Kennenlernen

  • Zugverbindung ab Gotha 8:35/ Erfurt 8:58, Berlin Hbf. 11:00
  • Eintreffen/ Mittagessen WAU Hallesches Ufer 32, 10963 Berlin bis 12:45
  • 13:00: Wikimedia Geschäftstelle. Wikidata Vorstellung: Was tut Wikidata im Zusammenspiel mit den Wikipedien? Was sollte man über die Software wissen? Was kann man mit der Software machen? Was wird mit ihr gemacht?
  • Im Lauf des Nachmittags: Projekte der verschiedenen Interessenten. Was für Daten steuern sie bei? Was für Interessen an Datenbankanwendungen haben sie?
  • Gemeinsames Abendessen in der Taverna Athene, Tempelhofer Ufer 12, 10963 Berlin.
  • Samstag Vormittag: Baustellen

  • Nachdenken über ersten vier Werkverträge: Datenimport (hier das Datenangebot des Illuminatenprojekts zur “Schwedenkiste”), Wiki-Integration, Eingabeschablonen, Know-How-Transfer: Hierzu eingehend die Blogposts zu Eingabeschablonen und und zum Ausweis von Original Research sowie die Serie Kopfzerbrechen.
  • Was lässt sich mit der bestehenden Software bereits sehr leicht realisieren?
  • Was müsste erst entwickelt werden? Wo liegen gemeinsame Interessen der Forscher und des Wikidata Teams?
  • Wer kann was? Wie gewinnen Forschungsprojekte Kontakte in die Wikidata Community zu Entwicklern, zu Know-How-Vermittlern, zu Interessierten aus der Wikipedia/Wikidata-Community, die bei bestimmten Forschungsprojekten durchaus gerne mitspielen würden
  • Gemeinsames Mittagessen in der Geschäftsstselle

Eine grundsätzliche Fragesammlung zur Inspiration gibt es auch hier.

Angekündigte Teilnehmer

  1. Lydia Pintscher, Wikimedia Deutschland
  2. Nicola Zeuner, Wikimedia Deutschland
  3. Jens Ohlig, Wikimedia Deutschland
  4. Matti Blume, Wikidata, Werkvertrag in der ersten Projektstufe
  5. Adrian Heine, Wikidata, Werkvertrag in der ersten Projektstufe
  6. Daniel Mietchen, Wikidata, Werkvertrag in der ersten Projektstufe
  7. Lucas Werkmeister, Wikidata, Werkvertrag in der ersten Projektstufe
  8. Olaf Simons, Forschungszentrum Gotha
  9. Markus Meumann, Forschungszentrum Gotha
  10. Erik Liebscher, Forschungszentrum Gotha
  11. Christian Wirkner, Forschungszentrum Gotha
  12. Hendrikje Carius, Forschungsbibliothek Gotha
  13. Daniel Burckhardt, Humboldt Universität, Berlin
  14. ChristianKl, Wikidata Community
Großer Raum der Wikimedia Geschäftsstelle – sieht heute anders aus, Christina Burger auf https://commons.wikimedia.org/wiki/File:Bierkiste_in_neuer_GS.jpg