Kopfzerbrechen Nr. 6: Dokumente des Illuminatenordens erfassen

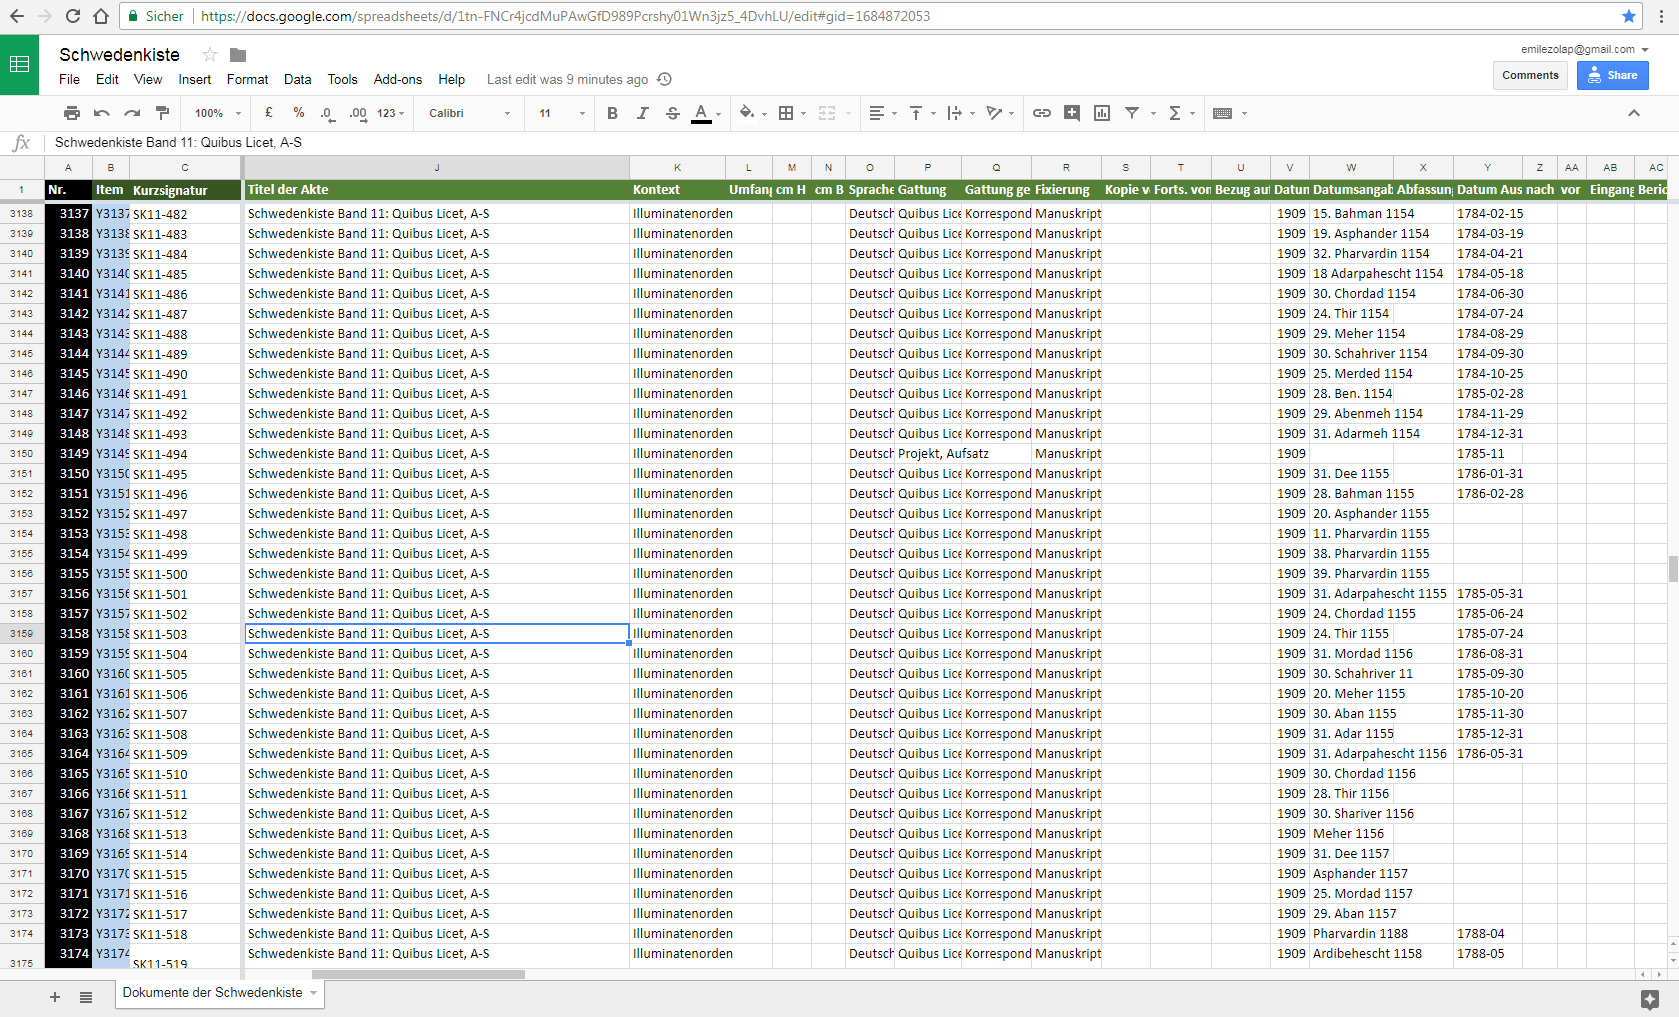
Im Verlauf unserer Arbeit legten wir zur Orientierung innerhalb der Schwedenkiste dieses Spreadsheet an. Jede Zeile (ab 24) ist ein Dokument innerhalb eines der 20 Bände der Schwedenkiste; dem folgen noch einige weitere Dokumente unserer Recherchen.

In der Visualsisierung der Datenbankinformation wird man später zu jedem Dokument eine Seite haben wollen mit Metadaten, Digitalisaten, Transkript, Übersetzung ins Englische.

Die Datenstruktur würde, von unserer Excelliste kommend, übersichtlich diese Felder haben, von denen einige unorthodox sind – der Orden verschlüssele Datums- und Ortsangaben, die Namen von Sendern und Empfängern wurden verschlüsselt, wichtiger noch: Sender schrieben regelmäßig an den Orden, ohne zu erfahren, wer dort ihre Briefe öffnete (das indes wissen wir, nachdem wir die Innenorganisation kennen).

Groberfassung

1. Kurztitel
2. Level: Archivbestand/ Akte/ Dokument/ Abschnitt in einem Dokument [ideal: Pulldownmenü zur Bestimmung der Erfassungsebene]
3. included in (in welchem Archivbestand findet sich die Akte, in welcher Akte das Dokument, in welchem Dokument der Abschnitt der hier erfasst wird?)

3a. dortige Position
3b. Seiten oder Blattangabe
4. Digitalisat online
5. Transkript online
6. Veröffentlichung

6a. Stellenangabe (Seiten von bis)
7. Übersetzung

7a. Stellenangabe (Seiten von bis)
7b. Sprache der notierten Übersetzung
8. Forschung

8a. Stellenangabe (Seiten von bis)

Objektbeschreibung

9. Umfang der Akte, des Dokuments, des Abschnitts (in der Regel eine Seiten- oder Blattzahl)
10. Format [unterschiedliche Angaben denkbar: 2°, 4°, 8°, DIN A…, cm x cm]
11. Manuskript/ Manuskript mit Noten/ Typoskript/ Druck/ Formular (mit Eintragungen)/ Schattenriss/ Zeichnung (mit Text)/ Konvolut
12. Handschrift
13. Sprache

Autor

14. Autor

14a Autor Selbstaussage (“Name vorenthalten, sprich anonym”, Initialen, Pseudonym…)
14b. Verantwortende Insitution
15. Absendeort

15a. Geo Kordinate
15b. Absendeort in seiner unklaren Nennung
16. Absendedatum / Enddatum der Komposition

16a Genauigkeit (ca./ recte/ fraglich)
16b Datierungsangabe laut Dokument
16c Abfassungsbeginn (z.B. bei Tagebüchern oder Briefen, die über Tage hinweg verfasst werden)
16d. terminus post quem (was ist das Datum, nach dem dieses Dokument verfasst sein muss)
16e. terminus ante quem (was ist das Datum vor dem dieses Dokument verfasst sein muss)

Empfänger

17. Empfänger

17a. abweichende Adressierung
17b. adressierte Institution
18. Ort Empfänger

18a. Geokoordinate
19. Eingangsdatum
20. Weitere Rezipienten (besonders wichtig bei den Illuminatenakten, wo man Briefe an den Orden adressiert, auf dass “Unbekannte Obere” sie lesen – die wir wiederum identifizieren können)

Inhalt

21. Textsorte standardisiert [hier muss Auswahl erstellt werden]
21. Textsorte Selbstaussage
22. Titel
23. Inhalt
24. Berichtsgegenstand [FactGrid-Id von Ereignis etwa bei Treffen, Konferenz etc.]

24a. Berichtszeitraum von
24b. Berichtszeitraum bis

Kontext

25. Antwort auf
26. Rezension von/ Gutachten zu
27. Fortsetzung von
28. Dokument ist [Auswahl:] Konzeptschrift zu/ Kopie von/ Reinschrift von/ Zusammenfassung von/ Übersetzung von/ Katalogeintrag zu

28a. Dokument zur vorigen Spalte
29. Bearbeiter/ Übersetzer (Information zur vorvorigen Spalte)
30. Querbezüge
31. Genannte Personen

Provenienzinformation nach Verlust des Objektes oder des Quellennachweises

32: Verlust/ zu recherchieren/ privat
33: Status seit wann
34: Grund (etwa Bombardierung des Archivs – Möglichkeit eines Ereignislinks)
35: Paralellüberlieferung (woher kommen die Informationen, die wir heute über das Dokument haben)

35a: Stellenangabe zu vorigem (Seite Default)

Provenienz bei vorliegendem Dokument

36. Besitzer / Archiv

36a. Geo-Koordinate
37. Besitz von/seit

37a. Besitz bis
38. Bestand
39. Signatur
40. Verzeichnis
41. Zugänglichkeit (öffentlich zugänglich/ eingeschränkt öffentlich zugänglich/ privat/ geheim)
42. Eigentümer
43. Wechsel gegenüber voriger Provenienz [Kauf/ Schenkung/ Leihgabe/ Enteignung/ Aneignung/ Raub]

FactGrid-interne Information

44. Erschließung (Namen derer, die die Erschließungsinformationen lieferten, mit Jahresangaben)
45. Forschungskontexte (hier können Forschungsprojekte Materialcorpora für ihre Recherchen generieren)
46. Template (für eine Darstellung etwa im Article Placeholder)
47. Digitalisat (wichtig, wo wir nicht-öffentliche Bilddateien von unseren Servern benennen)
48. Achtung! (Raum für Bearbeitungsnotizen)

Die zentrale Frage dieses Kopfzerbrechens ist: Wie stimmen wir diese Liste mit bereits bestehenden Wikidata-Feldern ab? Wie erstellen wir hierfür eine Eingabeschablone, die – etwa bei einer Crowd-Erschließung – die richtigen Fragen übersichtlich stellt?

Wie generieren wir aus den Daten im Verlauf ansprechende Seiten zu den Dokumenten, die deren Lektüre zu einer angenehmen Erfahrung macht? Mit welcher Gestaltung würde man Übersetzungen einspielen (die Übersetzung ins Englische ist das größte Desiderat des öffentlichen Austauschs über die Illuminaten). Magnus Manskes Reasonator machte gute Vorschläge was die Gestaltung von Seiten aus Wikidata anbetrifft.

Bisher sehen unsere Seiten zu Dokumenten – unbefriedigend – so aus:
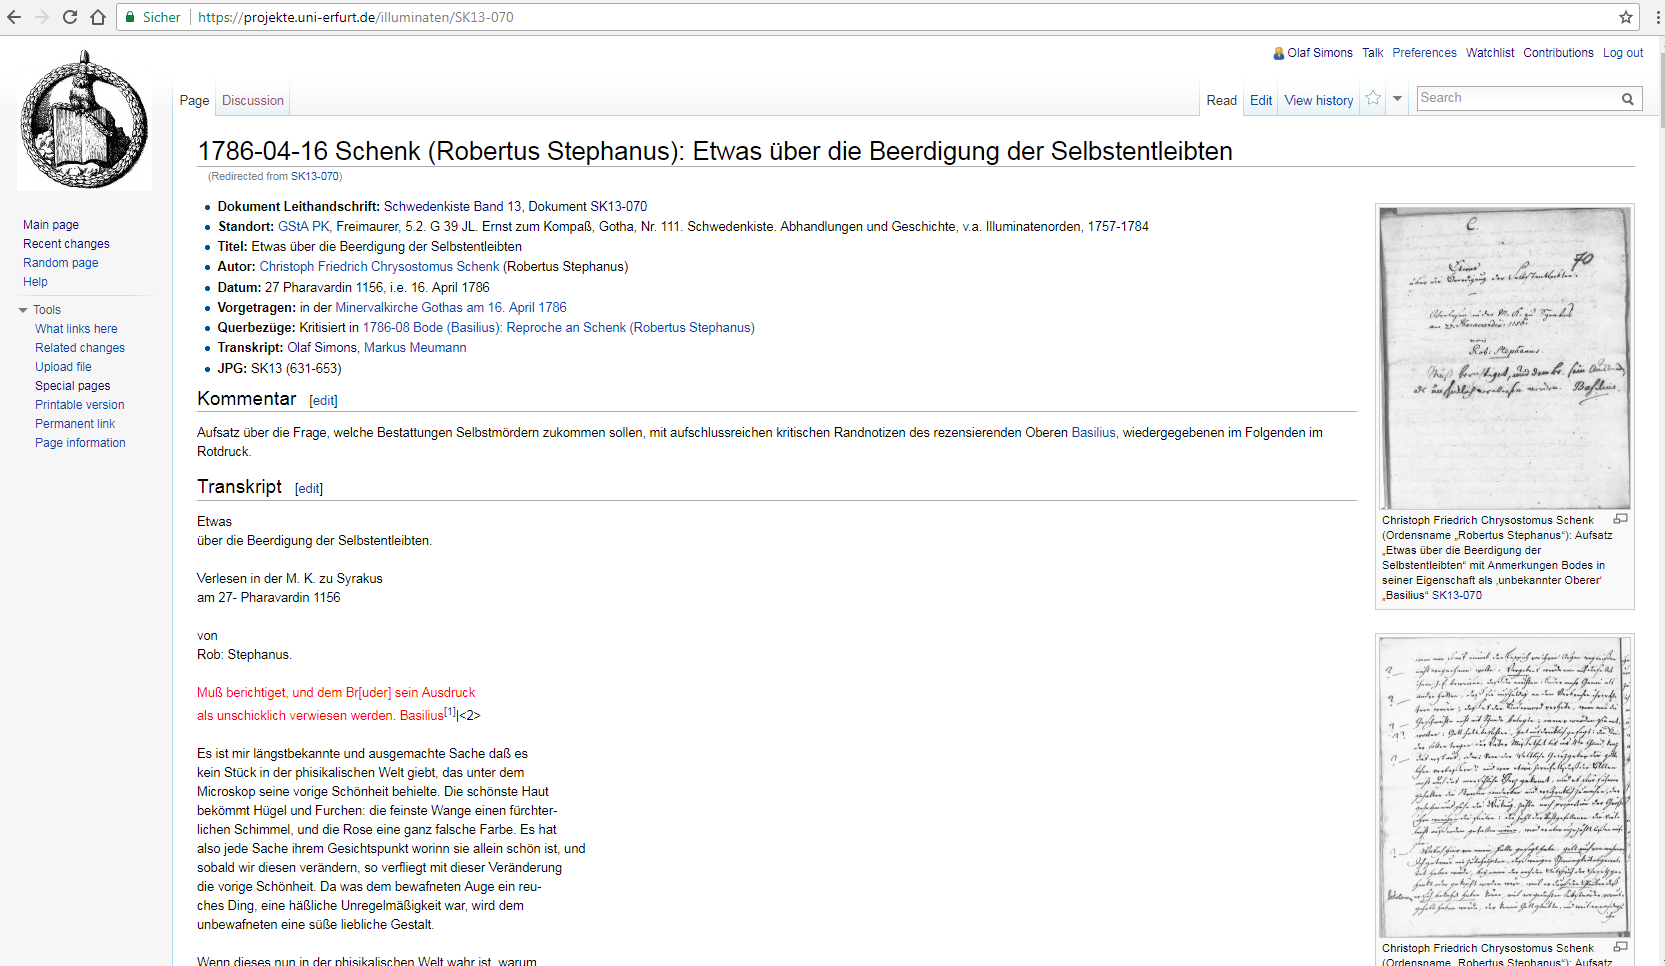
Screenshot SK13-070 https://projekte.uni-erfurt.de/illuminaten/SK13-070

2017-12-1/2: Einige konkrete Fragen für den ersten FactGrid Workshop

siehe https://factgrid-tools.geschichte.uni-halle.de/blog/archives/159

  1. Wäre es sinnvoll, das FactGrid vorab mit ausgewählten (auf Kerndaten reduzierten) Datensätzen aus Wikdata und der GND zu befüllen, um nicht im leeren Raum zu beginnen?
  2. Gäbe es alternativ eine einfache Option, Daten mit den bestehenden Datenbanken abzugleichen und Datensätze ohne Umstände zu übernehmen?
  3. Könnte man den Umgang mit Doubletten – verschiedenen Datensätzen zur selben Person etwa (resultierend aus der Zusammenfügung von Tatenmengen) – nicht zu einem fruchtbaren Problem machen, sprich: die Datenbank einsetzen, um gezielt nach möglichen Übereinstimmungen zu fahnden?
  4. Wie würde man am besten mit ‘tentativen Informationen’ umgehen – mit Personen etwa, von denen man erstmal nur einen Nachnamen, einen Zeitpunkt und Ort in einem ersten Aktenbefund hat? (Siehe das erste und das zweite Kopfzerbrechen hierzu.)
  5. Wäre es nicht klug, Bilddateien und Transkripte in derselben Datenbank zu verwalten? (Siehe das fünfte Kopfzerbrechen.)
  6. Wie gehen wir mit wechselseitigen Beziehungen um? Wenn eine Schablone es erlaubt, zu einer Person Eltern und Kinder zu nennen, wie stellen wir sicher, dass Schablonen zu Kindern wiederum die bereits eröffneten Beziehungen zu den Eltern in den Eingabefeldern haben?
  7. Wenn wir Gegenstände und Eigenschaften definieren, werden wir dafür eigene (sagen wir) X- und Y-Nummern vergeben, um Freiheit bei der Erweiterung und Ausbeutung der Datenlage zu haben? Wenn ja: Wie sichern wir die weitestmögliche Vereinbarkeit mit Wikidata-Einträgen ab?
  8. Magnus Manskes Reasonator erweist sich als ungemein elegantes Werkzeug, um Wikidata-Information enzyklopädisch verfügbar zu machen. Taugt der “article placeholder” als Alternative, wenn wir eine Vermehrung von Plattformen verhindern wollen und wenn wir eine automatische und übersichtliche Datenpräsentation suchen. Braucht Wikidata nicht langfristig einen eigenen “Visualizer”, der die Informationen zu jedem Gegenstand zweckmäßig anordnet und erst beim Editierwunsch in den Bearbeitungsmodus schaltet?
  9. Das FactGrid soll verschiedenen Projekten als gemeinsam betriebene und angereicherte Plattform dienen. Wie machen wir es möglich, dass das jedes einzelne Projekt die Ressource unter seinem eigenen Focus ausbeuten kann? Wie ermöglichen wir Suchen, die etwa speziell im Aktenbestand bleiben, der vorher als die thematisch relevante Datenlage eines Projekts definiert wurde?

Kopfzerbrechen Nr. 5: Dokumente, Transkripte und aus ihnen bezogenen Informationen zusammenhalten

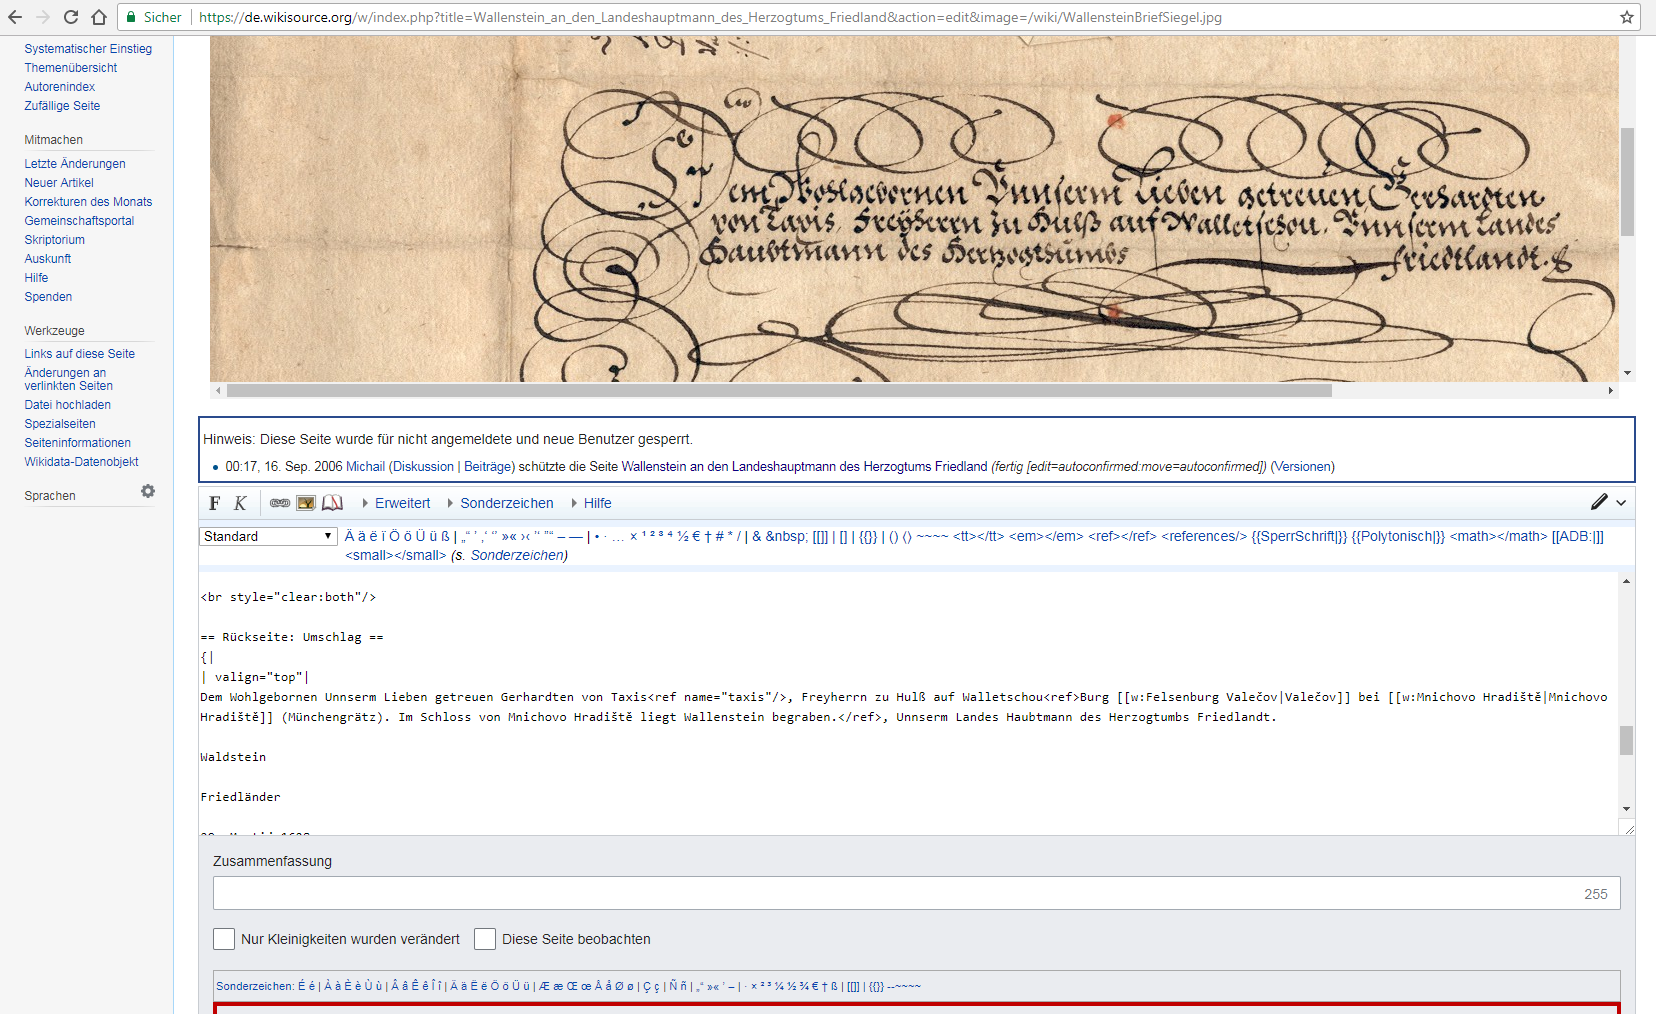
Wikisource Screenshot mit Bilddatei und Bearbeitungsfenster für das Transkript im Original
Das ist die mühsame Arbeit des Historikers wie des Hobby-Forschers, der etwa Kirchenbücher auf den Spuren seiner Familie auswertet: Man hat ein Dokument. Wenn es älter ist, entziffert man es, indem man es nebenbei notdürftig transkribiert. Mitunter muss man es nebenbei in eine lebende Sprache übersetzen, bevor man im letzten Schritt Informationen aus dem Dokument zieht (und sich notiert, wie man die Information nachher zitiert).

Sollten wir das Projekt der Illuminatenakten Online in einer größeren Kooperation mit den zu beteiligenden Partnern zuwege bringen, werden wir zu alledem noch die Scans der einzelnen Dokumentenseiten zu verwalten haben. Was wäre praktischer für deren Verwaltung als die bereits benutzte Datenbank? Eigene Wikis aufsetzen mit der Wikisource-extension, die es erlaubt, einen Scan neben einem Transkriptionsfenster zu sehen, hieße die Plattformen planlos zu vermehren.

Interessant ist die all-in-one-solution. Sie öffnet den Weg in die Volltextsuche; vor allem aber behält man mit ihr stets die Arbeitsschritte beieinander. Im raschen Zugriff lässt sich erfassen, welche Informationen aus welcher Datenlage gezogen wurden. Beim seltsamen Befund ist man schnell an der Quelle, die falsch gelesen oder fehlinterpretiert worden sein muss. Die Metadaten zum Objekt, die man vor allem mit der Datenbank verwalten möchte, bleiben dicht bei der Objektbearbeitung.

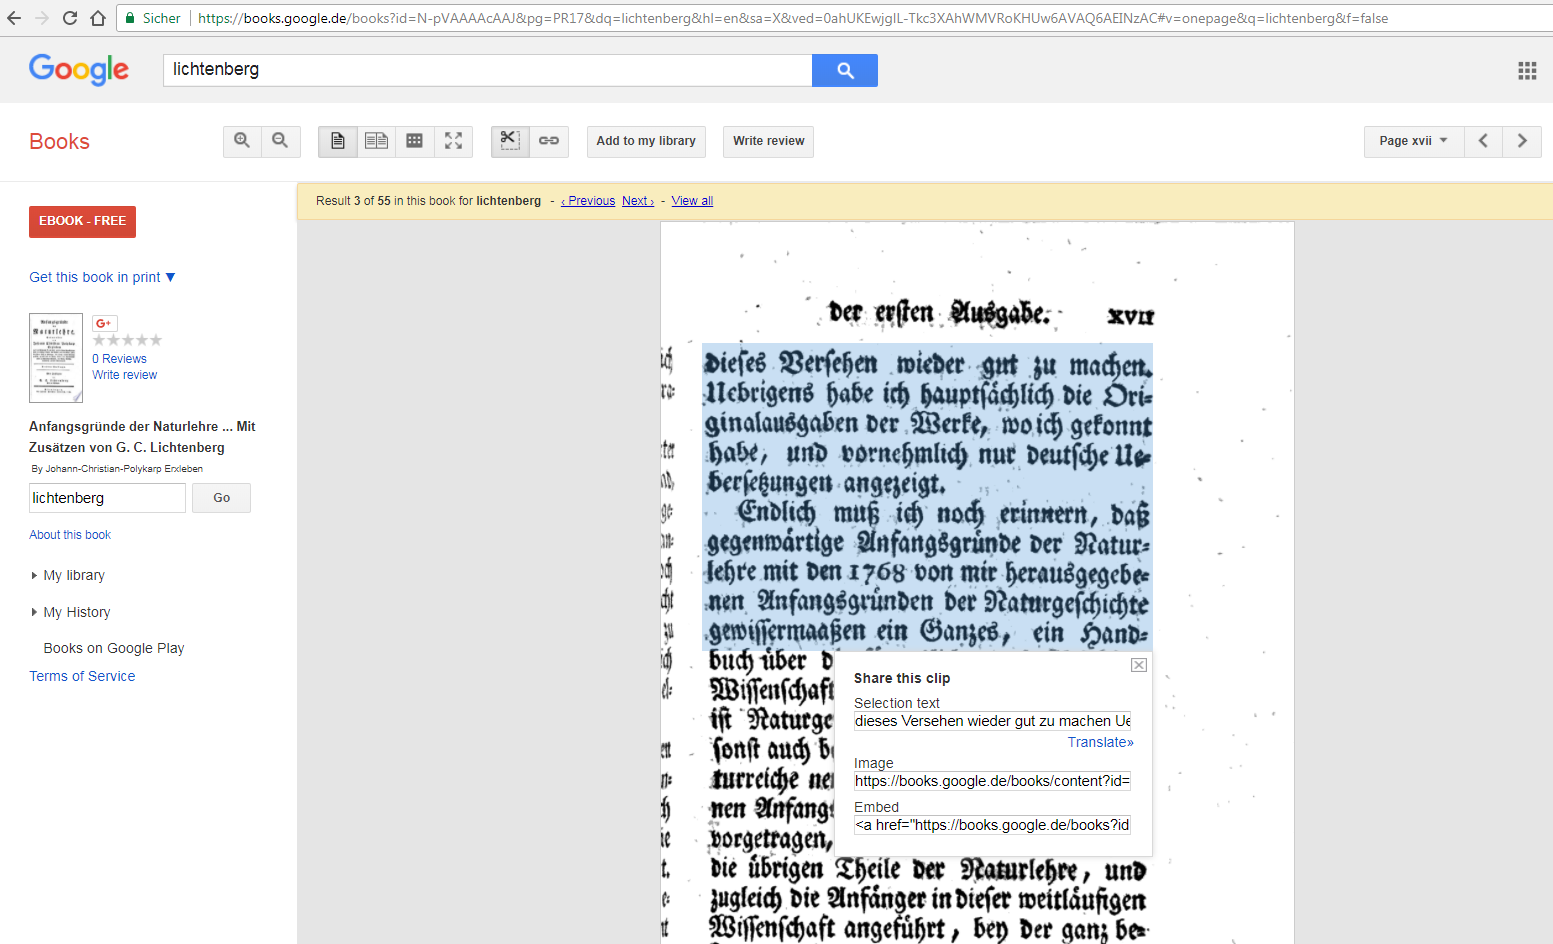
Vielleicht würde man mit Sichtfenstern arbeiten wollen, die man in verschiedenen Tabs, mitunter auch auf zwei Bildschirmen, nebeneinander nach eigenen Wünschen anordnen könnte. Angenehm wäre es, wenn man die Information von anderen Datenbanken einbinden könnte: Oft wünscht man sich eine Funktion, um eine bereits vorhandene Texterkennung – sie läuft bei Google Books und Archive.org im Hintergrund der Scans mit – einfacher bei der eigenen Arbeit benutzen zu können. Man korrigiert schneller als man selbst schreibt.

Screenshot aus Google Books: Man kommt an die OCR zu einzelnen Textpassagen, kann sie aber nicht bearbeiten. Vergrößern / Google Books

Das sind gleich mehrere Baustellen für ein längeres Kopfzerbrechen.

Kopfzerbrechen Nr. 4: Organigramme

In Google Books findet sich eine kleine Serie der Herzoglich-Sachsen-Gotha- und Altenburgischer Hof- und Adreß-Kalender:

Die Serie von 1768 bis 1825: https://digital.slub-dresden.de/werkansicht/dlf/54350/1/ /
https://zs.thulb.uni-jena.de/receive/jportal_jpvolume_00240779

Die Publikationen waren nicht ungewöhnlich. Man entnahm ihnen nach dem kalendarischen Vorspann und den Informationen über die Post-
und Botenverbindungen Überblick über den Aufbau des gesamten Staats und seiner Landeskirche samt den Namen und Posten aller Amts- und Würdenträger bis hinab zu den Angestellten, die der Herrschaft auf dem Schloss aufwarteten.

Netzwerkdarstellungen wurden in den letzten Jahren populär. Sie erlauben es, Knoten in größeren Kommunikationsgefügen auszumachen. Insbesondere informelle offene Korrespondenzgefüge gewinnen hier Transparenz.

Tatsächlich wissen wir aber dank solcher Kalender und vergleichbarerer Publikationen über die Interaktionsgefüge weit mehr. Wir verfügen über Organisationspläne aus staatlichen und kirchlichen Behörden, wir kennen die Gefüge der Armee, größerer Anstalten wie kleinerer Firmen, kennen die Positionen in geheimen und nicht geheimen Gesellschaften, die Gremien und Ausschüsse von Parlamenten und Parteien und so fort.

Eine der interessantesten Leistungen des FactGrids könnte darin liegen, diese Gefüge mit den Personendaten und Archivalien zu erfassen. Hier sind Organisationsstrukturen ausgewiesen samt Titeln, Positionen und den Namen der Amtsinhaber. Wie müsste die Dateneingabe aussehen, um aus ihr Organigramme für jeweils gewünschte Zeitschnitte zu generieren – mit Links zu den Personen und zu Schriftstücken ihrer Hand?

Die Adress-Kalender erfassen, wie der größte Arbeitgeber im frühneuzeitlichen Staat mit der Bevölkerung seines Territoriums verwoben war: Welcher Prozentsatz der Stadt- und der Landbevölkerung stand in Dienstverhältnissen zum Hof? Wie verliefen – hier wird die Serie der Kalender aufschlussreich – Karrieren bei Hof? Welche Positionen erweisen sich als sozial durchlässiger als andere?

Wie sind – wenn wir Organisationsgefüge miteinander korrelieren – Gothas Freimaurer mit Staat und Kirche des Herzogtums verwoben? In wieweit überlappen sich Kreise des Klubbs, der Thee-Gesellschaft, der Besucher der wissenschaftlichen Vorlesungen des Hofarchivars Ludwig Christian Lichtenbergs in der Stadt, der Illuminaten im Haus des Schlosshauptmanns Christian Georg von Helmolt mit staatlichen Strukturen? Welche Mitgliedschaften waren Eintrittskarten in Karrieren, welche persönlichen Kontakte öffneten Türen?

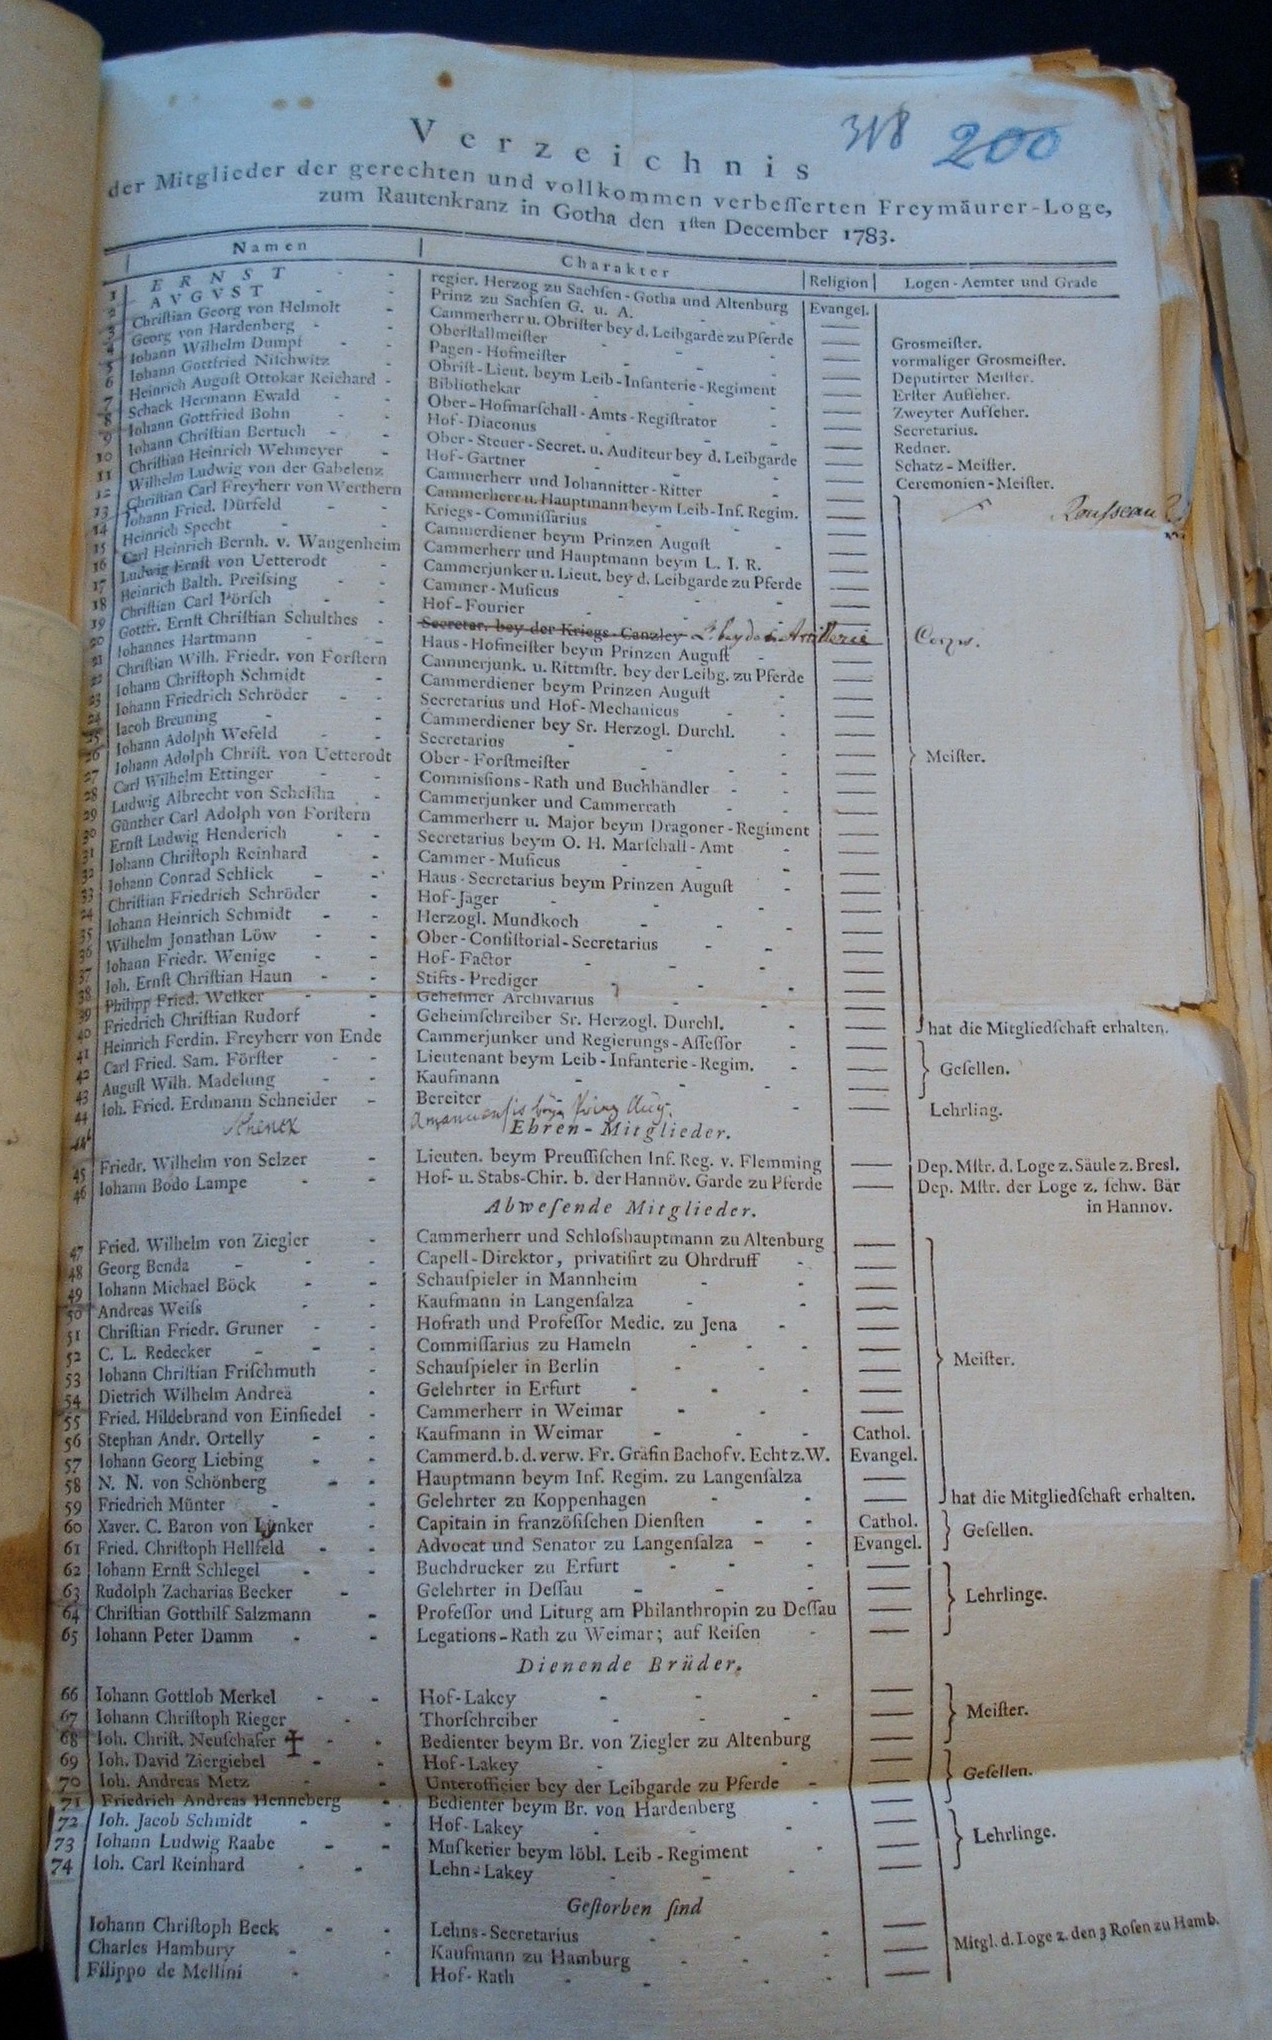
Aus den Akten des Illuminatenordens Schwedenkiste Band 10, 200: Die Mitgliederliste der Gothaer Freimaurer-Loge von 1783. Deutlich sichtbar: Führende Hofbeamten treffen sich in der Loge wieder – aber nicht alle… Vergrößern

Übersichtlichkeit werden Organigramme generieren, sobald sie mit der Aktenüberlieferung korreliert werden, und man auf die Schnelle in die Arbeit von Behörden Einblick nehmen kann.

Bleibt die zentrale Frage: Was muss wie eingegeben werden, um welche Darstellungen zu erlauben und welche Fragen stellen zu können?

Struktur Stadtverwaltung Gotha, Organigramm 2017 http://www.gotha.de/rathaus-politik/stadtverwaltung/organigrammaktenplan.html