The first volume of the Thuringian pastor’s book (1500–1920) as a Wikibase data set

auf Deutsch

In a tremendous effort of a year’s work, Heino Richard of the Genealogical Society of Thuringia e.V., step by step translated the first volume of the Thuringian Pastors’ Books (the volume for the former Duchy of Gotha) into data which we could now feed into FactGrid: More than 13,300 database objects are stemming from this work allowing now entirely new explorations of the territory’s social and religious history. We as curious about the joint ventures this work might inspire. There is no reason to fear that the database version will render all further work on the paper-based volumes obsolete; the platform might, however, offer itself to the editors of the Pfarrerbuch as an unexpected aid.

The eight volumes cover all the parishes of the former Thuringian territories from the Reformation to the 20th century. A first survey is opening each volume with a tour through all the parishes and offices giving the lists of the pastors and auxiliaries who held the respective offices. The main part is in each volume devoted to the individual biographies. Genealogy is key: Pastor after pastor we get the parents with their professions, their wives (with their respective parents and backgrounds), and eventually the children (with information about their professions and the families they married into).

“Things, not strings” – database objects instead of names to be merely spelled out

Translating the volumes into FactGrid-Wikibase data became an ordeal with software’s call for database objects to be connected – where the printed volume was just stating names in various strings of letters. One would have wished to get persistent identifiers with these names since almost all these names reappeared in various contexts – as office holders, as the targets of individual biographies and in various related functions as fathers, sons, sons-in-law or fathers-in-law in the other biographies – without any further clarification of the hard identities behind the mentionings. All this was tricky since names were passed across the whole range from fathers to son, or from grandfathers and uncles to grandsons and nephews to name the closer options that would become most difficult to set apart.

1953 church dignitaries became the stock to start with – almost all connected to more than one of the 142 parishes. The set doubled, tripled and quadrupled with the wives, parents and children and their new relatives to a total of 13,344 data records (as of today). All the records had to be connected to birth and death dates, places, information about marriages, terms of office and occupations.

The entire data is still flawed here and there – it will straighten out the the use it will find. A simple check sheds light into the abyss: We still have some 200 personal data records connected to more than one father and one mother. The double records have sprung unto existence wherever we failed to understand that people were the same – a given name missing or an alternative spelling would render the automatic identification impossible. Things are just as tricky where we supposed that we were dealing with a single person whilst we were actually fusing information of two different lives into a single data record.

Merging data sets remains as painful as the reversal since the software does not take much of an effort to keep track of all the consequences to observe when entire branches of families have been duplicated in the course of the input.

Software features one would love to have

The input of genealogical data calls for a module that understands what basically is. The module should generate family trees and warn you before any input that it has found identical family fingerprints: Children from two families are unlikely to share their birthdays; just as they are unlikely to marry into the same families or to share fathers with the same background data. When entering data, the software should highlight congruent structures and help to merge them with look at the entire overlap which it can track far better than any human eye.

The lack of the stand-alone frontend is even more grievous. Those who want to read the database are not interested in the input pages that list the various triples and qualifiers just as we happened to enter them.

Magnus Manke’s “Reasonator” and Markus Krötzsch’s “SQID” demonstrate what Wikidata and Wikibase should receive: an interface that is solely geared towards the display of data. The next generation of such interfaces will do more than just display the statements made on a single item in a better order. Configurable interfaces will gather information from items referring to your query. It is precarious to list 800 letters and publications of a person you are exploring on the person’s item, if you have already created 800 items for all these titles all with in-depth information on the authors, collaborators, publishers, performances, recipients, archival holdings and so on. It should suffice to note a person’s father and mother on the person’s item — once you start giving reciprocal information on the parents’ pages and siblings you are in the middle of a mess of data which you will inevitably fail to keep in congruence.

Lacking a more cohesive interface it remains difficult to present a data set like this one.

So how can one see what’s in it?

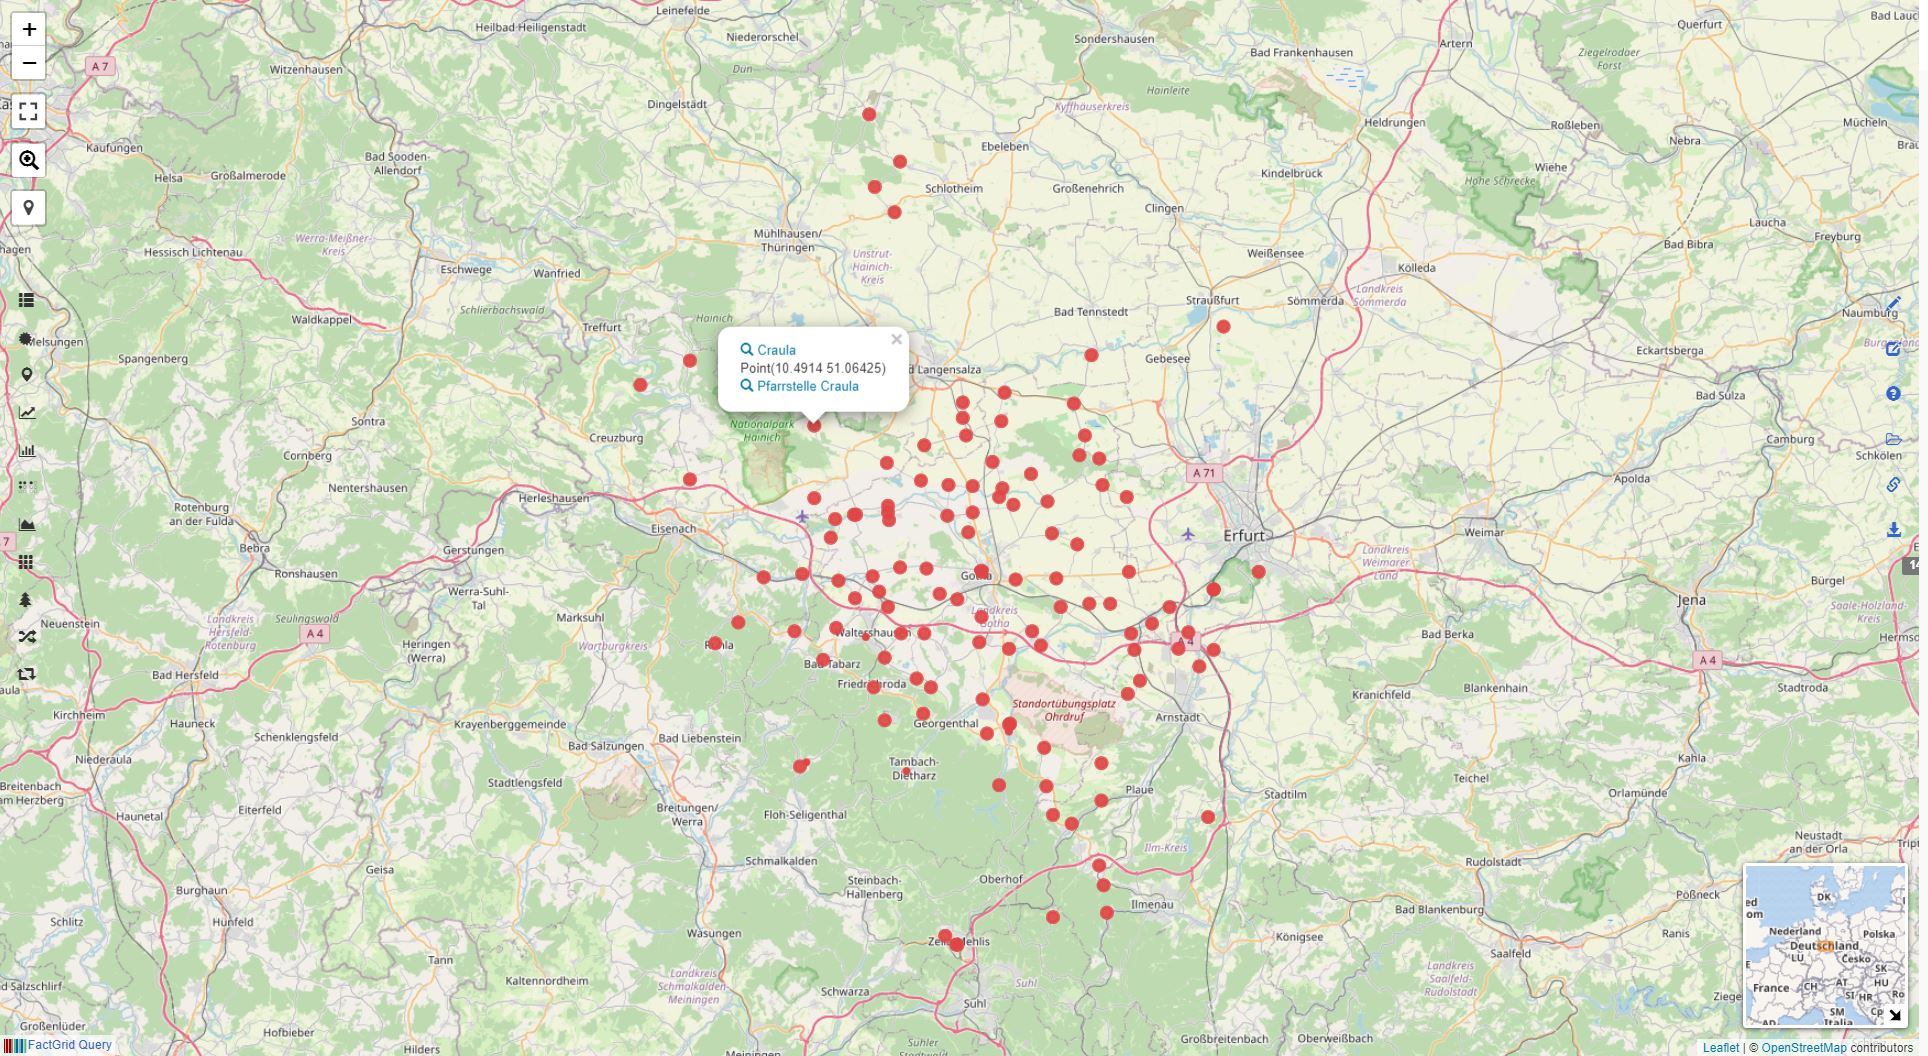
What we can do in the present situation is to give first searches that enable readers to start their own more specific searches – knowing that SPARQL will be a huge put off for the majority of readers. The most practical first search to start with will be the query for all the Protestant parishes of the former Duchy, to appear on a map:

Click the red dots to access to the records of the individual parishes with the lists of pastors registered on the each item.

The table version allows the data to be downloaded as JSON, TSV and CSV data records. TSV, “Table Separated Values”, can be processed in data sheets, whether Excel or Google. The search is sent off with the blue arrow key:

You will have to study an exemplary personal data record before you start your own searches as you need to know how we formulated the triples, i.e. the miniature statements stored in the database, in order to run effective searches as SPARQL queries:

The following query generates a table of all pastors with their birth dates, death dates and parents. With the input help (press the i-Icon to activate it) you can add more table columns to the search in order to get the additional information on children, wives, offices, memberships etc.:

All 13,484 database objects that are using information from the first volume of the Pastors’ Book can be bundled with the P12 (literature) + Q43361 (the first volume of the Thuringian Pastors’ Book) filter.

What is in it to learn?

The Thuringian Pastors’ Book genealogical focus opens up a first interesting perspective: Religion becomes after the territorial decisions of the Reformation increasingly a family institution: You take your religion with you as you receive it at birth. This is even more so with the church hierarchy that evolves. Families become the partners of the territorial churches supplying the students of theology and the pastors for generations. With the database we should become able to ask the more specific questions:

  • What was the exact influence of individual family positions: father, mother, grandfathers, uncles? How did that influence accumulate with more than one pastor in the family?
  • Did the family influence on becoming a pastor decrease over time – with the compulsory education becoming the central provider of professional decisions and career options in the course of the 19th century (and when exactly did such an influence become more noticeable)?
  • To what extent was marrying into a rectory household an advantage – for one’s own career, for the careers of the children?
  • Were local networks as valuable as relationships across spatial distances?
  • To what extent did the ecclesiastical appointments open – geographically? Where did the pastors come from over time?

A project looking for partners

We will have to bring people and institutions together to make our data sets more accessible and the CC0 license is not the threshold here.

(1) It would be an immense gain if could get Wikidata and Histropedia people on board. They are the people who understand the technical side far better than the FactGrid community of the historians; and somehow we should become able to work hands in hands.

(2) It would be a huge win if the resource attracted the team behind the Thuringian pastors books. The software we are using is not really a tool to digest books – it is a tool to facilitate your research. We have the ideal platform one would use to set identifiers and to collect and accumulate information – on the platform with the sources you will not be able to link in the volumes. FactGrid is a team’s tool to be used in the process that prepares a volume.

(3) We would be pleased if we could win the Eisenach State Church Archives for the project. For two years now we have been working with the Church Archive of the City of Gotha, which has started to use the database as its own repository. It would be exciting to widen this project an to get a clearer picture of the whereabouts of archival materials from the 142 parish we have been exploring with this project.

(4) A far broader data networking should add complexity and depth to the work done so far: Our 2000 pastors have written sermons, books, and letters. The Gotha Research Library will keep more of these publications than any other institution. We should be able to match our records to fuse the next layer of networking – the layer of public and private networking via letters and publications into the database with its present genealogical focus. The entire production of books and the links to digitisations is now increasingly done by the VD16, VD17 and VD18 online catalogues and the Kalliope-Database. It would be interesting to connect these records to allow the swift step from personal records to online documents. The Gotha Research Centre will not be able to organise such a projects – it will need partners who adopt the work we did here in a pilot study of the database’s potentials.

If you get interested in the data set and start exploring it, let us know and share your research with us right here on the blog.
Der erste Band des Thüringer Pfarrerbuchs (1500–1920) als Wikibase-Datensatz

English Version

In einer gewaltigen Arbeitsleistung überführte Heino Richard von der Arbeitsgemeinschaft Genealogie Thüringen e.V., Gothaer und Eisenacher Land, im letzten Jahr den ersten Band des Thüringischen Pfarrerbuchs, den Band für das ehemalige Herzogtum Gotha, in eine Version von über 13,300 Datenbankobjekten, die nun ganz neue Auswertungen erlaubt und die vielleicht damit interessante Kooperationen nahelegt. Dass das Datenbankangebot die weitere Arbeit an den Pfarrerbüchern erübrigen wird, steht nicht zu befürchten. Vielleicht aber wird sich das FactGrid den Bearbeitern der Bände als unerwartetes Hilfsmittel anbieten.

Die bisher erstellten acht Bände erfassen von der Reformation bis ins 20. Jahrhundert alle Pfarreien der ehemaligen Thüringer Territorien.

In einem ersten Part sind jeweils die Amtsinhaber nach Pfarreien chronologisch aufgelistet. Ihnen folgen im Hauptteil alphabetisch sortiert die eingehenden Biographien mit extensiven genealogischen Vernetzungen. Notiert werden jeweils die Eltern, die Ehefrauen mit Eltern und die Kinder, nochmals mit Hintergrundinformationen über Berufe, Ehepartner und deren Elternhäuser.

“Things, not Strings!” – Datenbankobjekte statt Namen in Buchstaben

Was in den acht Bänden nicht so schnell sichtbar wird, wurde in der Bearbeitung für das FactGrid zur harten Herausforderung: Wikibase will mit Datenbankobjekten, nicht mit schlichten Namen befüttert sein. Das Thüringer Pfarrerbuch liefert die Namen mit wechselnden Hintergründen (und immer wieder auch variierenden Schreibweisen), doch an keiner Stelle mit stabilen Identifikatoren; und so tauchen dieselben Person jederzeit für sich genommen und in verschiedensten Biogrammen als Väter, Söhne, Schwiegersöhne oder Schwiegerväter auf, ohne dass sogleich klar wird, wer da wer ist. Mit der Datenbankerfassung musste entschieden werden, wann jemand derselbe war – keine einfache Entscheidung, da Namen keine Eindeutigkeit schufen, familiär weitergegeben von Väter an Söhne wie zu Ehren näherer und fernerer Verwandter.

Das Datenvolumen lässt das Dickicht erahnen. Auf die 142 Pfarreien, die zwischen 1500 und 1920 im ehemaligen Territorium bestanden, kamen 1953 Personen als zeitweilige Amtsträger. Mit deren genealogischen Geflechten summiert sich der Personenbestand aktuell auf 13.344 Datensätze, die mit Eckdaten zu Geburt, Tod, Eheschluss und Kindergeburten, Amtszeiten und Berufen auszustatten waren.

Der gesamte Datenkomplex ist noch nicht vollständig konsolidiert. Ein Schlaglicht darauf werfen die Abfragen von Kindern und Eltern: Gut 200 Personendatensätze verfügen derzeit noch über mehr als einen Vater und eine Mutter – Doppelungen zu denen es kam, wenn wir versehentlich unter den Vätern oder Müttern Dubletten anlegten, Datensätze zur selben Person, da erst einmal nicht klar war, dass es sich um dieselbe Person handelte. In anderen Fällen haben Datensätze zwei Mütter oder Väter, da wir bislang verkannten, dass wir hier Biographien hätten trennen müssen – in sie flossen Eltern zweier gleichnamiger, nun zu trennender Personen ein.

Sowohl das Vereinen von Datensätzen wie das Auseinandernehmen sind Arbeiten, bei denen man schnell den Überblick verliert, da die Software nicht erfasst, wo ganze Äste gedoppelter oder zu trennende Information vorliegen und wie mit ihnen am besten zu verfahren ist.

Softwaredesiderate

Für die Eingabe genealogischer Daten wünschte man sich ein Modul, das versteht, was Verwandtschaftsbeziehungen ausmacht, und wie sie in der vorliegenden Datenbank notiert werden. Das Modul sollte Stammbäume generieren und noch im Eingabeprozess warnen, wenn sich familiäre Fingerabdrücke gleichen; es ist unwahrscheinlich, dass Kinder zweier Familien die Geburtstage oder Ehepartner miteinander teilen. Noch bei der Eingabe sollte die Software deckungsgleiche Strukturen aufscheinen lassen und aufzeigen, wie Äste von Information aufeinander zu legen sind.

Unbefriedigend ist bei alledem, dass wir in einer Software ohne stand-alone-Interface arbeiten. Magnus Mankes „Reasonator“ und Markus Krötzschs „SQID“ zeigten, was Wikidata und Wikibase bislang vor allem fehlt: die allein auf die Datennutzung ausgerichtete Oberfläche. Die weiterführende Technologie wird an selber Stelle viel mehr leisten müssen, als Daten aus einem jeweiligen Item besser geordnet wiederzugeben. Interessant werden konfigurierbare Oberflächen, die die Datenbank befragen, und die es erübrigen, Information in ihr gedoppelt abzulegen. Es ist prekär, im Datensatz zu einer Person, sagen wir, 800 Briefe und Publikationen der Person zu listen, wenn man bereits zu diesen 800 Objekten eigene Datensätze anlegte, die weitaus komplexer über Autoren, Beiträger, Adressaten, Verleger, Aufführungsorte, Aufbewahrungsorte, Werkausgaben, Digitalisierte, Transkripte, Übersetzungen und genannten Personen informieren. Im Moment legen wir Informationen doppelt und dreifach ab, allein um im Blick zu behalten, dass sie in der Datenbank vorliegen – mit allen Risiken dabei auseinander laufender Informationsstände.

In der misslichen Lage ist die hiermit vorgelegte Arbeit erst einmal fast nur für Datenfachleute klarer lesbar.

Erste Überblicke und Suchen

Die vielleicht praktischste erste Suche ist die aller protestantischen Pfarrämter des Herzogtums mit der Darstellung auf der Karte:

Jeder einzelne Punkt lässt sich anklicken und birgt den Zugriff auf die Datensätze der Pfarrämter und über diese auf die Amtsinhaber in ihrer jeweiligen Folge.

Die Tabellenversion erlaubt, es die Daten als JSON, TSV und CSV Datensätze herunterzulanden. “Table Separated Values” lassen sich in Datenblättern, ob Excel oder Google Sheets, weiterverarbeiten. Die Suche muss jeweils aktuell mit der blauen Pfeiltaste aktiviert werden:

Es empfiehlt sich, vor jeder weiteren Erkundung einen exemplarischen Personendatensatz zu studieren, um zu erfassen, welche Informationen von uns wie abgelegt wurden – es ist dies das Wissen, das bei jeder SPARQL-Abfrage zum Einsatz kommt:

Die folgende Anfrage generiert eine Tabelle aller Pfarrer mit deren Geburtsdaten, Sterbedaten und Eltern. Mit der Eingabehilfe (das i-Icon aktiviert sie) lassen sich beliebige weitere Tabellenspalten zu Kindern, Ehefrauen, Ämtern, Mitgliedschaften hinzusetzen:

Alle 13.484 Objekte, die den ersten Band des Pfarrerbuchs als Ressource nutzen, lassen jederzeit sich mit der Eingrenzung auf der Literaturangabe bündeln.

Inspiration

Der genealogische Schwerpunkt des Pfarrerbuchs eröffnet eine erste interessanteste Perspektive: Religion ist im protestantischen Raum, mehr als im katholischen, Familiensache. Die territoriale Organisation der religiösen Betreuung findet Pfarrfamilien als organisatorischen Partner. Mit der Datenbankerfassung sollten sich die die härteren Fragen stellen lassen:

  • Wie groß war der spezifische Einfluss von Familienpositionen: Vätern, Müttern, Großvätern, Onkeln?
  • Wie veränderte sich dieser Einfluss? Inwieweit schwand er im Prozess, in dem Bildung klarer eine Angelegenheit der Schulsysteme wurde, die Berufswege unabhängig vom Elternhaus zu ebnen suchen?
  • Inwiefern war die Einheirat in einen Pfarrhaushalt ein Vorteil – für die eigene Kariere, wie die der Kinder?
  • Waren räumlich nahe Vernetzungen gleich viel wert wie Beziehungen über räumliche Distanz hinweg?
  • In welchem Umfang öffnete sich die kirchliche Ämterbesetzung im Verlauf? Wo kamen die Pfarrer her, wie verlagerten sich Herkunftsschwerpunkte?

Projekt auf Partnersuche

Vor allem wird nun die Frage interessant, welche Benutzergruppen wir in Austausch miteinander bringen können.

(1) Ein immenser Gewinn wäre es, könnten wir Geschichtsinteressierte des Wikidata-Projektes und der Histropedia auf den für uns noch durchaus unhandlichen Datenschatz lenken. In beiden Bereichen halten sich die Nutzer auf, die die Technik erst einmal weit besser verstehen als die FactGrid-Community der derzeit etwas über 100 Historiker und Historikerinnen.

(2) Interessant wäre es, das nach wie vor am Thüringer Pfarrerbuchs arbeitende Team für das FactGrid zu gewinnen. Unsere Datenbank sollte sich vor allem als immenser Zettelkasten eignen, in dem sich Informationen ablegen und mit den jeweils aktuellen Quellenbelegen ausstatten lassen.

(3) Freuen würden wir uns, gelänge es uns, das Landeskirchenarchiv Eisenach näher an das Projekt zu binden. Seit gut zwei Jahren arbeiten wir mit dem Kirchenarchiv der Stadt Gotha zusammen, das seinen Aktenbestand im FactGrid verwaltet. Spannend wäre es, zu erfassen, welche Datenbestände aus allen 142 Pfarrämtern heute noch wo liegen. Es ist dies ein im Kirchenarchiv Eisenach soeben koordiniertes Projekt.

(4) Die breite Datenvernetzung wird die bis hierhin getane Arbeit mit Vielschichtigkeit ausstatten: Die von uns erfassten Personen schrieben Bücher und Briefe. Die Forschungsbibliothek Gotha wird von den Publikationen ihres Territoriums mehr als jede andere Institution aufbewahren. Wir sollten hier den wechselseitigen Informationsabgleich zu Wege bringen. Der Abgleich mit dem VD16, VD17 und VD18 und der Kalliope-Datenbestand würde es erlauben, die Datensammlung an die laufende Erschließung von Texten und Dokumenten anzuschließen. Zur genealogischen Vernetzung der Biogramme käme im selben Moment die Vernetzung der jeweiligen öffentlichen Interaktion und persönlichen Korrespondenz. Für die Forschung dürfte es attraktiv sein, mit den Datensätzen Zugriff auf die Digitalisate zu gewinnen, und zu den Personen Texte und Austausch unmittelbar verfügbar vorliegen zu haben.

Wir sind neugierig darauf, wie sich das vorgelegte Datenangebot entfalten wird, und laden dazu ein, Erkundungen der Datensätze noch hier im Blog mit uns zu teilen.

Celebrating FactGrid’s Q100000: Conrad Alexandre Gérard

Silently and without any fanfare we have passed the 100,000 mark on FactGrid! The item in question is a person: Conrad Alexandre Gérard. In a way he is the perfect candidate to mark this occasion. FactGrid has been diving into networks obscure and less obscure, and Gerard travels on both sides of this distinction: The first French ambassador to the United States and a person interested in Mesmerism, the world of miraculous cures based on “animal magnetism” in the 1780s. Our project started with the German Illuminati and spread into Freemasonry. In doing so, it broadened its scope to include France and England. Gerard is again a perfect representative of this outlook: born in Masevaux, France, in 1729 he pursued a diplomatic career that brought him to Mannheim and Vienna and eventually to the young United States of America. If our hopes are fulfilled, we will follow in his tracks and extend ourselves westwards and across the Atlantic over the next year.

Conrad Alexandre Gérard, Philadelphia 1779
The 100.000th item was created by Bruno Belhoste who began to fuse the Francophone Harmonia Universalis database into FactGrid from where the Mesmerism of 1780s and 1790s Paris will now radiate outwards and into the network of its French and continental adherents. J.J.C. Bode brought these spheres into exemplary contact on his journey to Paris in the summer of 1787 – in the journey that marked the end of the Illuminati since he subsequently declined to resume his work as the last active secret superior when he returned home later that year. Mesmerising is the right word – a word derived from Franz Anton Mesmer, who will stand in the centre of the exceptional scene that is unfolding here.

FactGrid was established in order to give historical data a wider outreach and deeper impact. It is living up to its promise. We welcome joint ventures between platforms. We love to give data an additional outreach. We hope that we can give data sets wider connections and place them within unexpected and exciting contexts of research; and we hope that we can bring research teams together on this mission. Wikibase is designed to encourage this mission.

Looking back: we grew much faster than expected

Bruno Belhoste’s (and David Armando’s) project will deserve a longer blog post in 2020; it will take him another two or three months to feed all his data into the database and to be able to offer more substantial and significant insights; the present input is just preparing the basic structures one can then begin to interconnect. The 100,000th item is more of an opportunity to look back and to speak about the future as far as we can see it from our current vantage point.

Collective editing on FactGrid started on June 11, 2018. We began with data from the two Illuminati research projects that have dominated the scene since the late 1990s. The Illuminati will remain a construction site as we hope to bring online the entire “Swedish Box” (the core collection of Illuminati documents as amassed by Bode from 1782 until 1789). Berlin’s Lodge “To the Three Globes” and the Privy State Archive in Berlin have given encouraging signs that they would support the digitisation and detailed cataloguing. We will need three years of public funding for a project of these dimensions.

The Wikibase installation also invited local low-level projects that were open to testing and developing this resource. Would the “citizens” of Gotha be able to work on one and the same platform used by scholars in their wider international projects? Gotha’s City Church Archive was willing to bring its catalogue online on FactGrid. Heino Richard of the city’s Genealogy Association began an enormous project and has already transferred about two thirds of the “Pfarrerbuch”, volume one of the former duchy of Gotha’s pastors, into structured database information. The former duchy’s 140 pastorates are the project’s backbone; more than 2000 pastors filled the positions since the Reformation. The database has linked them to their parents, their spouses, their respective families, and Heino Richard is now on his way to add all the children — work which will eventually comprise over 15.000 data sets. Here is a perfect opportunity for scholarly professionals since we are dealing here with a tight network of families marrying among each other for over five centuries. We will add information about the professions to allow the sociological evaluation of these family ties.

The Illuminati allowed for the database to grow and merge with Freemasonry — after all this was what they were doing in the 1780s: infiltrating lodges in the German speaking territories. Hermann Schüttler had already identified members of some 130 lodges. Christian Wirkner brought his dissertation on Göttingen’s two late 18th century lodges into the database with some 800 biographies which inspired Martin Gollasch to widen the scope with his own research on the beginning of German’s student fraternities. We are now beginning to understand how the “Landsmannschaften” and a wider spectrum of quasi masonic organisations which recruited students in the central Protestant university cities, laid the ground on which the early 19th-century “Burschenschaften” emerged in the years of the Napoleonic wars. Martin Gollasch’s data sets are enriched by information about all the smaller, more intimate circles of friends which traveled through these wider organisations as he has been mining contemporary “books of friends”, the “Stammbücher” in which students collected entries from their dearest friends.

Bruno Belhoste’s and David Armando’s Harmonia Universalis data will widen the spectrum. One thing has already happened with this new project: Bruno Belhoste has effectively turned the entire site into a trilingual project: All our properties are now available in German, French and English. The interface is already speaking Russian and Chinese (and more than 100 other languages), so there remains some work to be done.

We would love to turn Magnus Manske’s Reasonator into the standard — multi-lingual — interface for simply viewing FactGrid data; that, however, will need a bit of more work from different sides.

One of the projects is hibernating at the moment: Tim Herb made it possible to quote the entire (Protestant) Bible on FactGrid down to the level of the individual verses. The central idea was here to connect all the people and places mentioned in the Bible and the Quran and thus to transform the Biblical historicity and genealogy into structured information. The project is daunting: Wikibase allows contradicting statements. How would a database fare with the competing chronologies of modern and early modern historians? Our predecessors saw the Bible with its succinct 6000 years of Universal history since the creation of the world as the ultimate historical source. When they made the comparison to the Greek and Roman sources, it seemed to them as if the pagans had nourished blatant mythologies. How would the project develop if it was widened into the Quran? The Bible and Quran project is an open challenge at this point. Being able to quote the Bible down to the level of verses has, in the meantime, the charm of offering concise intertextual connections: We might develop a new focus on “Early Modern Networks of Religious Dissent”. The protagonists of this scene had their favorites among the Biblical Books — Daniel, the Prophets, the Apocalypse. Collecting the references we should be able to see how the Bible was used by competing groups on their respective missions, so there is potential here.

The shadow of history: All the GND’s Masonic lodges on a map. The former German speaking regions are coming back to life. We have to get beyond this map – and our map should have historical layers.

Our work on Freemasonry is ultimately as much of a challenge: We could theoretically invite lodges from all over the world to map their historical membership lists and their institutional networks of affiliations and systems back in time. FactGrid should allow visualisations of the spread of Freemasonry on timelines and maps. We are presently at about 850 lodges mostly in the former German speaking territories thanks to a test input of GND data, and these data are broadly unconnected so far — an invitation to dream of the far bigger project that could explore Freemasonry as part of early modern globalisation.

…and ahead: a year of massive challenges

2019 was still a year of cautious consolidation. We have grown faster than expected but we remained a platform of projects that worked silently side by side and in a spirit of open-minded friendship, interlocking knowledge here and there. All data on FactGrid is so far hand picked in tremendously time-consuming work. The GND-input should change the work flow and it should invite projects to start right in the middle of publicly available knowledge. Ten million data sets of people, organisations and places will create a landscape ripe for immediate cultivation.

A lot of questions are still open in this project: Shall we include the whole GND in order to operate as a complete DNB-filial project? Our initial idea was to restrict FactGrid to the early modern period but even such self-imposed and somewhat arbitrary limitations were open to later revision. 1900 had been the line we would draw back in 2018. Today we are confronted with ideas to open FactGrid for research on the entire range of data harvested at the German National Library. How could we deal with personal information of living people without the National Library centre that is responding to requests to modify these data? The opposite threat is just as crucial: And how will we make sure that the input (no matter where it ends) does not turn FactGrid into an agglomeration of data that only a few SPARQL-specialists will be able to mine and which we can hardly keep fresh and alive on our site?

We will have to generate a wider community. We will have to advertise the project in the wider field of Wikimedia projects in order to attract fans of open knowledge from Wikidata and from the different Wikipedia history projects. We will need technical help during the input and we will need a community that adopts this mass of data and that transforms the massive mound of date into a vibrant intellectual playground.

As FactGrid is not exactly a grass roots project we will have to make sure that historical research, archives and libraries will see us as a resource and as a site of collective work. If you belong to the wider world of historians, librarians and archivists and if you are interested in big data you should feel challenged by a project that will turn public data into a treasure one can now, all of a sudden, revise, enrich and explore with unprecedented freedom.

The project will need a more solid technical basis on this course. We need an interface to meet the wider public: an interface which anyone can handle without SPARQL. The interface should be multilingual and it will look more like the Reasonator than our present Wikidata-style pages, which want to be edited rather than looked at.

So, some quite daunting challenges ahead – but we expect it to be inspiring to confront and eventually master them. The software is incredibly cool. It has been opening doors to us during its first one and a half years and we have every reason to think that it will continue to demonstrate this potential for the next years. Wikibase is on its way to become the software of a wide network of Wikibase instances and we should try to become a research platform in this network.

Eine Sitzung der Gothaer Illuminaten von 1786 — rekonstruiert für die “Lange Nacht der Wissenschaften” der Uni Erfurt, 2019

[kollektive Arbeit Erik Liebscher, Markus Meumann, Olaf Simons] Am 8. November 2019 inszenieren Mitarbeiter und Promovierende des Forschungszentrums Gotha anlässlich der Erfurter “Langen Nacht der Wissenschaften” 2019 eine Sitzung des Illuminatenordens aus dem Jahr 1786 – eine Zeitreise und ein Blick in den geheimnisumwobenen Alltag des Ordens. Wenn die Illuminaten auch ein Geheimorden waren und wenn freimaurerische Riten auch der Öffentlichkeit nicht erklärt werden, so sind wir im doch Rückblick ausnehmend gut in der Lage, zu erfassen, was in den Sitzungen zumindest in der letzten Ordensprovinz „Ionien“ (Thüringen) in den 1780er Jahren geschah. Der Orden hatte eine ausgefeilte Bürokratie. Man protokollierte die Sitzungen und archivierte die vorgetragenen Aufsätze. Die Rituale waren dabei an der Freimaurerei geschult, die man von zwei Seiten organisatorisch umschloss – von unten, indem man Jungmitglieder rekrutierte und auf die Freimaurerei mit drei Schulungs-Graden vorbereitete und von oben, indem man auf die drei Johannisgrade der Freimaurerei ein eigens Hochgradsystem aufsetzte, dessen Mitglieder sich wiederum eigens, außerhalb der infiltrierten Loge trafen. Wir sind Stefan Sarrach von der “Grossen National-Mutterloge zu den drei Weltkugeln” dankbar dafür, dass er mit uns gemeinsam einen Blick in die „Rituale“ warf, die vorgaben, wie Sitzungen regulär zu gestalten waren. Die Bewegungen und Handlungsschritte blieben hier mit Wissen des Freimaurers zu erschließen.

Die Sitzung, die wir auswählen, fand am 28. Dezember 1786 statt, wie immer im zum Park hin vor dem Schloss gelegenen Haus des Obergärtners Wehmeyer. Details sprachen für die Wahl dieser Sitzung: Wir suchten ein Treffen mit überschaubarer Teilnehmerzahl (und müssen in der ausgewählten Sitzung noch immer auf drei Statisten verzichten) und mit spannenden Beiträgen. Die ausgewählte Sitzung war dabei besonders: Einer der „Minervalen“, der 26jährige Johann Georg Geißler („Quintus Cicero“ in Gothas Ordensniederlassung) hatte selbst ein Thema gestellt. In der Regel gaben die Ordensoberen die Arbeiten vor. Geißlers Thema war dabei tiefsinnig:

Soll ich meinem Freunde absichtlich Äuserungen entlocken deren Bekanntwerdung er fürchten muß, um ihn dadurch zu Beförderung eines moralischen guten Endzweckes desto fester an mich zu ketten?

Geißlers Rückblick auf die Geschichte seiner Themenstellung zeigt, dass die Mitbrüder sein Thema erst einmal „dunkel“ fanden. Brisant war es zudem im Orden, in dem doch gerade die geheime Organisation den besonderen Raum für eine vertrautere Freundschaft schaffen sollte, in der sich dann Freiheit des persönlichen — auch einmal gefahrvollerem — Denkens herausfordern ließ. Kann man frei sprechen, wenn man riskiert, dass man damit erpressbar wird? Kann man in einem Orden frei sprechen, der alle Beiträge akribisch auswertet und archiviert und nachher schriftliche Dokumente gegen einen in der Hand hat? Die Fragen stehen im Raum werden aber in dieser Brisanz nicht angesprochen.

Wir wissen, dass Geißlers Aufsatz mit Applaus diskutiert wurde, im Gegensatz zum dem seines um drei Jahre jüngeren Mitbruders August Ludwig Hoppenstedt (Ordensname „Diognet“). Sein Aufsatz ging erst in der zweiten Fassung, die er zum 21. März 1787 vorlegte, zu den Akten, weshalb wir nicht mehr genau erfassen konnten, womit Hoppenstedt Kritik auf sich zog.

Welche Punkte der Ordensstatuten in der Sitzung verlesen wurden, ist nicht exakt notiert. Wir wählten gleich die ersten aus, da sie genau auf das Thema zugeschnitten sind. Unklar bleibt auch wie viel aus Schillers philosophischen Briefen zwischen Julius und Raphael an jenem Spätnachmittag des Jahres 1786 zum Vortrag kam – der Text der Seiten 117 und folgende des dritten Hefts der Thalia schafft mit seinen Erwägungen zum göttlichen höchsten Wesen jedenfalls ein elegantes Gegengewicht zur Ode, die Schack Hermann Ewald (Cassiodor) der Seele widmete.

Wir haben die Texte für die Aufführung im Rahmen der „Langen Nacht“ etwas gekürzt; das Publikum soll hier zwischen vielen Veranstaltungen sich hier zwischen vielen Veranstaltungen hin und her bewegen können. Im Folgenden das Protokoll mit dem Sitzungsablauf und Links zu den archivierten und von uns ausgewerteten Beiträgen, wie sie die „Gotha Illuminati Research Base“ im Erfurter FactGrid erfasst.

Die Teilnehmer

  1. Christian Georg von Helmolt (Chrysostomus), der Superior [Markus Meumann]
  2. Christian Heinrich Wehmeyer (Cleobolus), der Censor [Olaf Simons]
  3. Schack Hermann Ewald (Cassiodor), Quaestor [Martin Mulsow]
  4. Christoph Friedrich Chrysostomus Schenk, Sekretär (Robertus Stephanus) [Marian Hefter]
  5. Johann Georg Geißler (Quintus Cicero) [Erik Liebscher]
  6. August Ludwig Hoppenstedt (Diognet) [Marie Nosper]
  7. Johann Gottfried Bohn (Spanheim) [Rolle nicht besetzt]
  8. Carl Friedrich Ernst von Helmolt (Guido della Torre) [Rolle nicht besetzt]
  9. Friedrich Ernst Carl Mereau (Thuanus) [Rolle nicht besetzt]
  10. Hans Ulrich von Gadow (St. Evremont) [Rolle nicht besetzt]

Das überlieferte Sitzungsprotokoll

Sitzungsprotokoll der Sitzung der Gothaer Minervalkirche vom 28. Dezember 1786.

Die vorgetragenen Texte

Was in der Aufführung nicht ganz erkennbar sein wird

Mehr…

Wikibase Inspiration Panel at WikidataCon, Berlin, 2019-10-25

The recent WikidataCon in Berlin had a special panel on Wikibase installations outside Wikidata. Below the video recording of the session embedded from https://media.ccc.de/

This is the list of the talks with the list of the speakers:

  1. Anila Angjeli + Benjamin Bober, Assessing Wikibase as the core of the French National Entities file
  2. Barbara Fischer + Sarah Hartmann, Authority control meets Wikibase – The German National Library and Wikimedia Deutschland Quest
  3. David Fichtmueller, Using Wikibase as a Platform to Develop a Semantic Biodiversity Standard
  4. Stuart Prior, Wikibase and building a community in Artists’s Publishing
  5. Olaf Simons, Using a Wikibase platform outside the Wikidata environment – why it is cool and where things get difficult


Featured Image: Wikidata Birthday Cake Cutting at WikidataCon 2019-10-25, by Ranjithsiji, Wikimedia Commons

Wikidata & Wikibase for national libraries: the inaugural meeting

At the 2019 Wikimania conference, Europeana – a Europe-wide digital cultural platform – held several associated events, including the inaugural meeting of national libraries which work directly with Wikidata and its underlying software Wikibase. The event was organized by Liam Wyatt in his professional role as Europeana’s Wikipedia liaison. This article was also written in that role and originally published at the Europeana blog.
In his other role as a Wikipedia volunteer he is usually called Wittylama. He is one of the founders of Project GLAM and the original Wikipedian-in-Residence – as a volunteer. Also in this role he was program chairman of Wikimania 2019 –S

At the forefront of innovation

As Wikidata becomes an increasingly large, densely connected, web of linked data, the cultural heritage sector is leveraging the platform more and more. None more so than national libraries, who have been at the forefront of innovations. Thirty institutional representatives participated in this meeting from three continents.

The meeting began with a series of short demonstration talks from institutions already working with Wikidata and Wikibase in-house. These are notable not only for the variety of activities undertaken and the successes already being reported from these young projects, but also for the fact that until recently, they have all been happening largely in isolation with limited knowledge-sharing.

Demonstrations of projects currently underway were given by:

The new director of the National Library of Sweden, Karin Grönvall, on quite literally her first day at the job, also took the time to greet us.

Heading into the meeting, approximately 40% of the attendees reported that their institution had already undertaken export of their own information into Wikidata. Afterwards, more than 50% reported that as a specific result of what they had learned they would now investigate undertaking further exports; over 60% also reported they would now be investigating the Wikibase software for in-house use, and 100% of responses received stated a high satisfaction with the day’s usefulness for their institution.

What’s next: the roadmap

Following the initial presentations, the meeting moved on to discussions informing – and also getting valuable feedback about – the ‘roadmap’: the forthcoming developments in Wikidata and Wikibase.

This began with a section on the work of the Structured Data on Commons project – which is bringing the power of linked data to Wikimedia Commons – and was followed by in-depth discussions of two specific areas of Wikibase software development that are common requests for libraries: permissions and federation.

The former request, permissions, refers to the nuanced read and/or write permissions that cultural institutions would like to provide when managing their own catalogue infrastructure on Wikibase. While in Wikidata the general principle is that everyone can see and edit any part of any item, for libraries this might not be sufficient. Potential outcomes include: designating certain users with advanced permissions to edit specific sections of items, or certain items in entirety; and making certain items or sections of those items visible only to particular users. Having a ‘second opinion’ check-function before a change is published was also discussed. These features might be necessary, for example, in catalogue management where some library staff have the right to edit bibliographic metadata, while other designated staff might have the right to view particularly sensitive information about acquisitions.

The latter request, federation, refers to the principle that multiple Wikibase instances can work with each other – each containing different information, but being able to sync elements so as not to duplicate effort and in order to propagate up-to-date information. However, as Lydia Pintscher – Wikidata product manager – explained to the group, everyone believes federation is a good idea, however everyone also has a different understanding of what it would mean in practice! In the meeting we talked through various practical options of federated Wikibase including but not limited to: shared properties but local items, shared items but local properties, and shared querying.

Strategic papers of interest

Almost simultaneously to this event, the Wikidata team published four strategy papers, including the high-level vision, and a specific paper discussing the future of the Wikibase ecosystem. This latter report provides the specific motivation for why the cultural sector – particularly national libraries – are investigating Wikibase:

This strategy is consistent with the extensively researched Association of Research Libraries April 2019 whitepaper discussing the use of Wikibase and Wikidata in the library context.

For more information about any of the discussions during the Stockholm meeting, please consult the comprehensive notes taken during the day itself.


Originally published at https://pro.europeana.eu/post/wikidata-wikibase-for-national-libraries-the-inaugural-meeting, reposted also at: https://en.wikipedia.org/wiki/Wikipedia:Wikipedia_Signpost/2019-09-30/In_focus

The Illuminati Correspondence Fast Forward

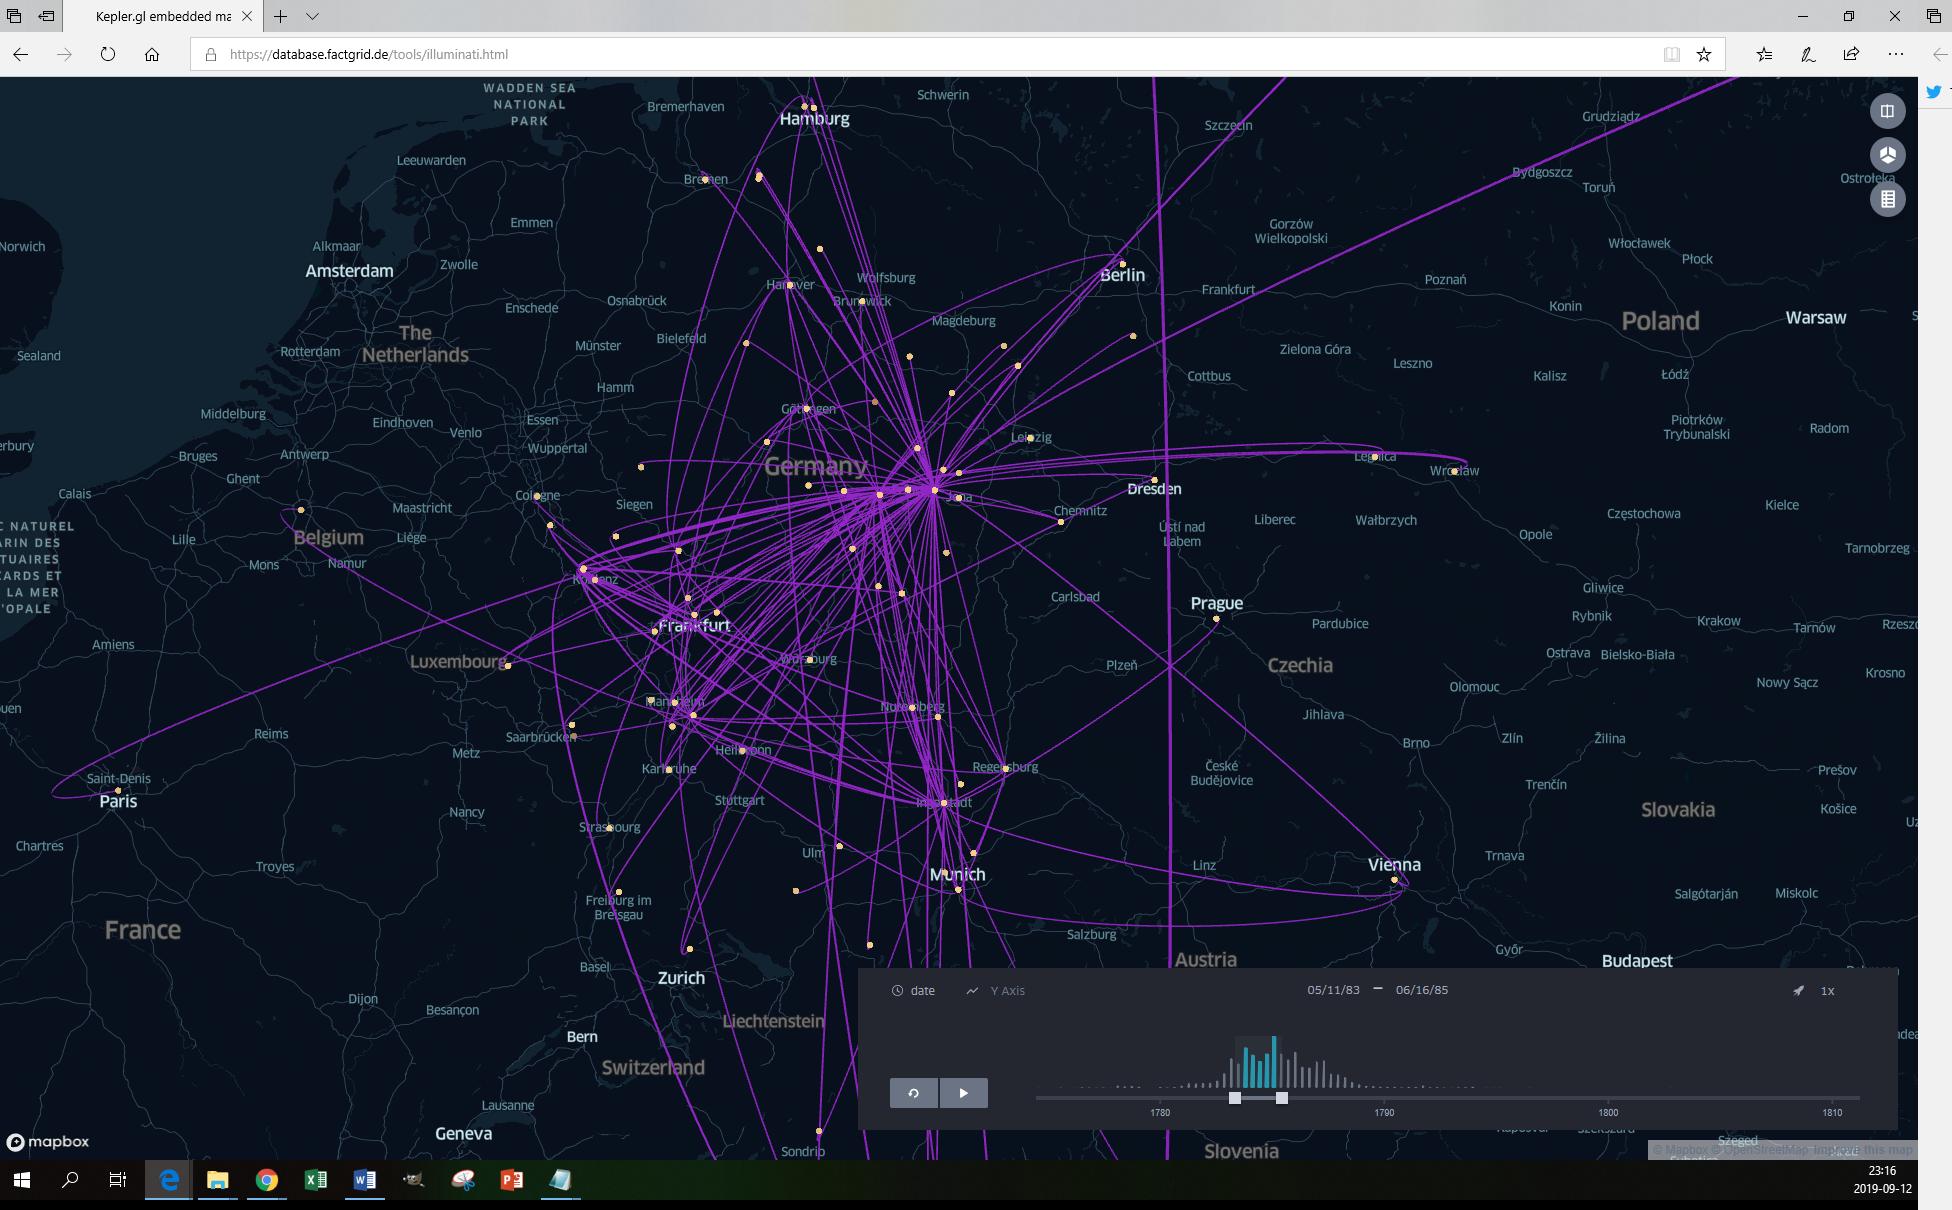
Paul-Olivier Dehaye scripted this visualisation for us (using Uber’s http://Kepler.gl). An html-file that captures all the Illuminati exchanges from the 1770s into the 1790s as far as we have spotted them (there are some misfits in this visualisation which we can now suddenly identify and which need to be eliminated on the database; the visualisation itself is basically a screenshot, it does not adapt to changes in the database).


<click to play>

The idea to represent letters in lines on a map together with a timeline on which the user can set a span that can then be shifted through the timeline – has become a classic in recent years: The Stanford Republic of Letters project seems to have been the first to come up with this visualisation ten years ago

Nodegoat is offering this visualisation as a standard aplication.

The visualisation is cool for correspondences since letters happen to travel on maps from senders to recipients (or to multiple recipients as soon as letters are forwarded – a standard procedure in all hierarchical Illuminati exchanges).

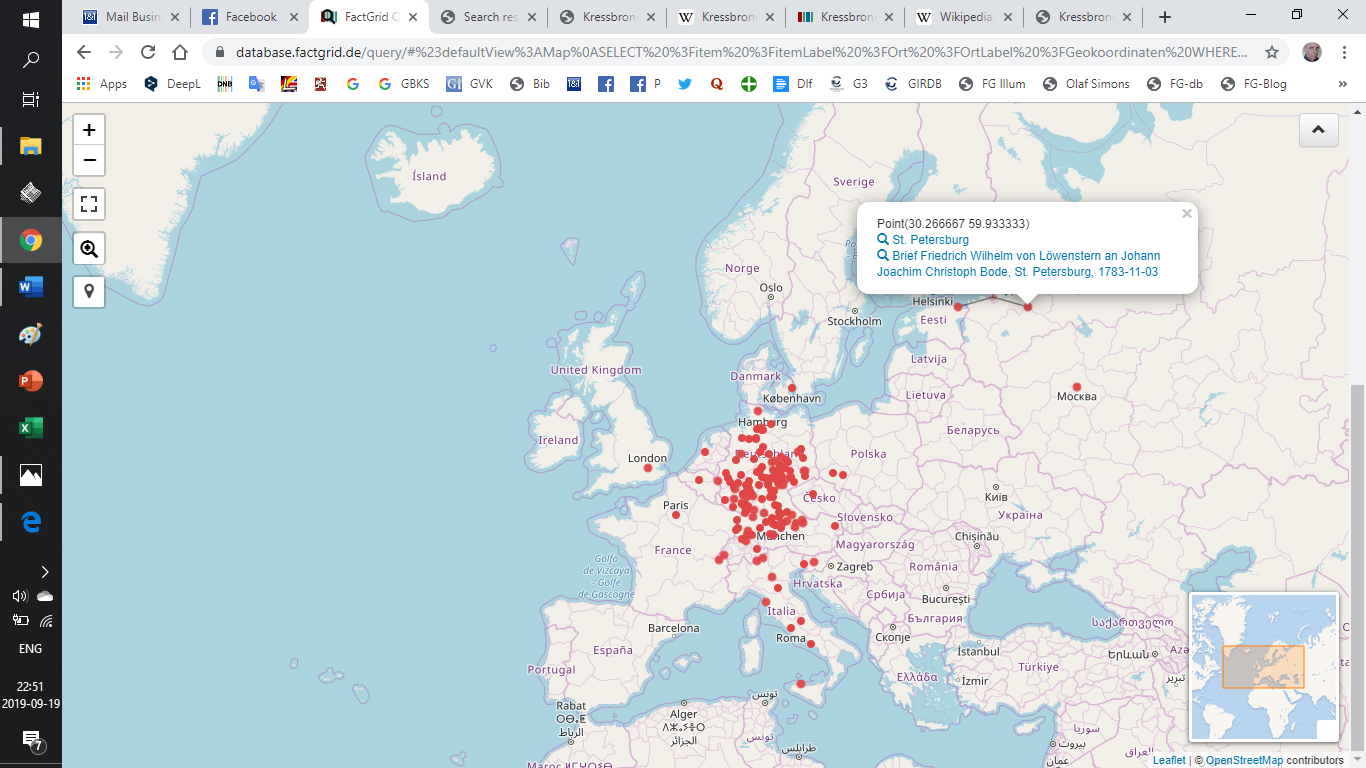
The simple visualisation which the SPARQL query service had yielded was already interesting to look at:

Illuminati Letters – sent from where?

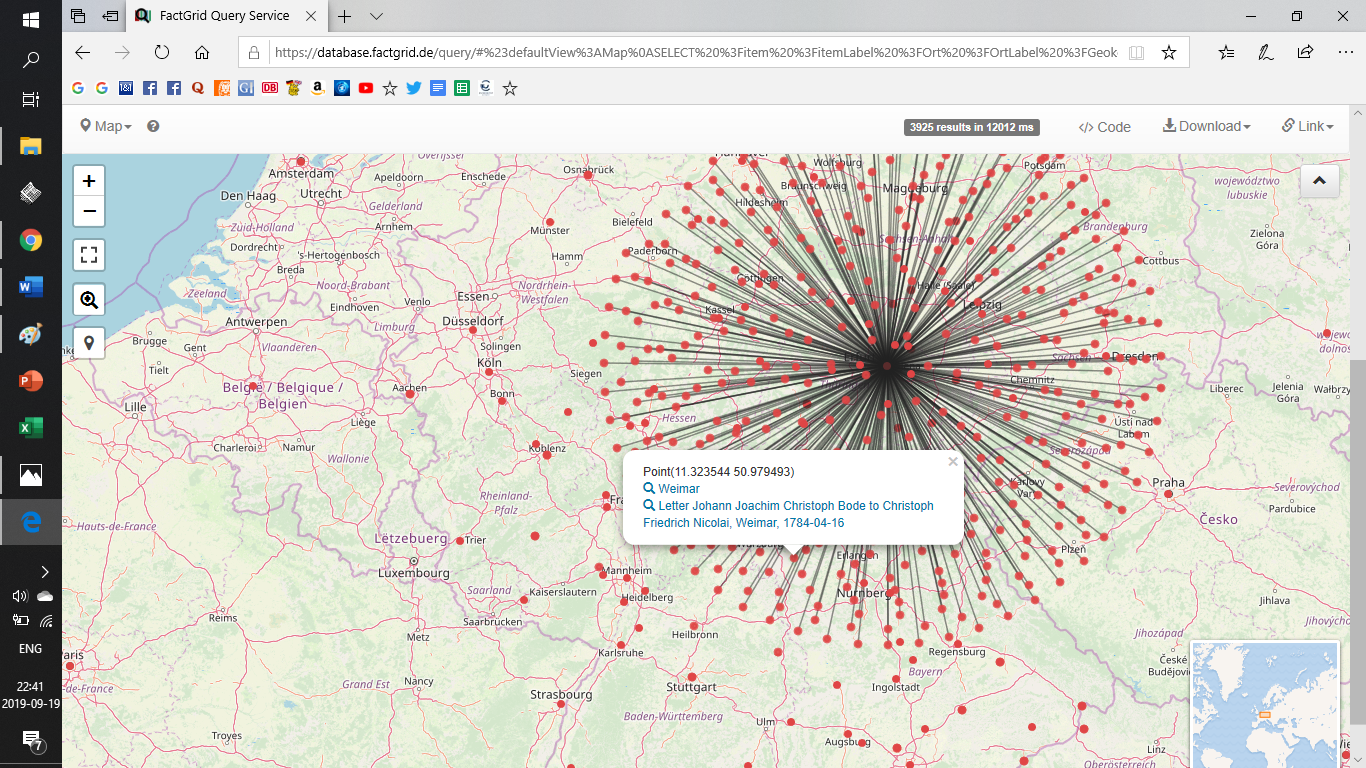
It showed the sender’s places of all known Illuminati letters and vaguely hinted at the Illuminati centres in Germany. But the picture remained static. It lacked the directions and the historical drama. You got more information if you clicked at an individual dot – usually this would open just a speech bubble with information about the particular letter that created this dot. But here and there one would see far more: a dot sparkling a fireworks of dots as in the case of Weimar (from where Christoph Bode organised the Order as the de facto leader after 1785/86). The beautiful bouquet is otherwise misleading – the dots do reach out to the various destinations; they stand for quantities which you only see if you hit the right dot (and which then obliterate much of the rest of the picture).

Bode’s Weimar correspondence – a nice representation of the number of documents but not much more.

Letters – that is the charm of the more refined temporospatial visualisation – tend to come in correspondences and these evolve, they stretch out, they blossom, and they die eventually.

The Illuminati are an almost ideal object for this particular visualisation as they present a full case to study. The “Republic of Letters” had remained out of reach for the Stanford project. The thing which we today prefer to call “academia” or “scientific community” was far bigger than the carefully selected and spectacular cases that created the first visualisations in 2009 — and only the whole picture would have revealed the evolution of our present academic debates between the 1480s and 1800. Regions and emerging nations brought forth increasingly scattered cultures of learning and they invented modern national topics such as our present debate of (usually national) literature. The spectacular exchanges could not possibly reveal these developments.

The Illuminati correspondence is, admittedly, no longer complete. We are looking here basically at the archives of Weishaupt and Bode and the Bavarian publications of 1787 – but it is even in this selection a clearly and well defined object. You know when you have an Illuminati letter in front of you: The author uses code names and the (messy) Illuminati-Persian calendar. The Organisation created complete genres of letters such as the monthly “Quibus Licet” which every member had to hand in and which would be answered with a “Reproche” signed by “Basilius” two months later. The genres are as remarkable as the internal affairs discussed in these letters.

The Order itself was at the same moment basically a complex correspondence: an organisational construct that generated a particular and unstable flow of information. Paul’s time lapse encapsulates the history and the drama of the Illuminati: For about two years – from 1776 to 1778 – we see very little: Ingolstadt is the place where Weishaupt’s “Perfectibilists” could organise most of their affairs in face to face meetings.

The situation changed dramatically in 1778: The Illuminati opened a lodge in Munich and started to infiltrate the masonic world.

Again two years later, in 1780, we see Adolph Freiherr von Knigge rising with exchanges he is now maintaining from Frankfurt and then from Heidelberg.

Knigge wins Bode for the Order in September 1782 and Bode in turn resolves the escalating conflict between Knigge and Weishaupt in 1784 and 1785: Knigge is forced to withdraw but Weishaupt does not regain his former position as the head of the organisation. Bavaria exposes the Order in 1786/87 with the first two editions of intercepted Illuminati documents. Weishaupt flees to Regensburg and then to Gotha where he ends in personal ignominy while it remains Bode’s part to come to the conclusion that he would not reform the secret organisation which could no longer claim to be a secret society.

You can pinpoint the individual letter to see who was writing here to whom with what letter exactly

Paul’s abstract movie wants to be explored. You can define the time frame and push it manually through the timeline, and you can click at each line to see whose letter is creating it. We can now see the overall quantities and the processes, the organisation’s actual growth and collapse on the map.

Far from perfect

The visualisation is state of the art and yet not much more than a show case at the moment. It is neither created in ever fresh queries nor can you use the html-page without some coding for your own questions.

The message, however is clear: The interface one would love to have with this visualisation could be far more simple than the present SPARQL query service. One would design it to always explore “correspondences” (P122Q11243) and one would ask the user for simple P—Q specifications of his or her desired visualistion. In the Illuminati case this would be:

  • Research Interest (P97) — Illuminati (Q10677)

One might just as well ask for “author” and name a couple of authors, or for recipients, but the Interface would do the rest and run the SPARQL query of correspondences to generate a list of the letters in question with senders’ and receivers’ places and dates.

Paul’s message is that this can be done: The centre of his html file is basically a SPARQL-search from our database. Maybe someone will script the interface during the Wikidata.con next month in Berlin.

And one would love to have more…

  • Think of a visualisation that tracked the movements of people on maps and that captured the moments when people (could have) met.
  • Think of a visualisation of the dissemination of objects – like copies of a specific edition.
  • Think of the spread of an organisation like Freemasonry with its mother lodges and filial branches.
  • Imagine a visualisation that traced your ancestors with a look at genealogical data.

Wikibase instances should invite the production of interfaces that can do certain jobs without bothering the user with SPARQL or Java proficiency. The cool thing about Wikidata or FactGrid is that these instances develop their (more or less) static ways to organise core data. We get more data but we continue to make the same useful statements especially if we have visualisations asking for these statements to be made with certain P- and Q-numbers.

Nodegoat would not lose any its charm if we began to offer similar visualisations; it will remain the software for the vast majority of projects that prefer the exclusive environment on which they can run exclusive and definitive presentations of their data. Wikibase instances are already very different beasts: They invite projects that want an open and growing landscape of data, and these projects will show the far bigger need of standard visualisations (i.e. of visualisations that use existing data and existing data structures). Projects on FactGrid or Wikdata need interfaces that already speak SPARQL. Time then to look at the more complex visualisations that are already running in environments such as the Stanford Republic of Letters Project or the Cultures of Knowledge Project in Oxford. We should act as the coolest competitors in this field, gather inspiration with the aim to inspire in turn.

Memorandum of Understanding between the University of Erfurt and the German National Library – to base the FactGrid on GND data in a joint project

German Version

We are proud to announce a new and massive Wikibase project that should keep a large community busy for far more than a year: Last month the president of the University of Erfurt, Prof. Dr. Walter Bauer-Wabnegg, and Dr. Elisabeth Niggemann, director-general of the German National Library in Frankfurt and Leipzig (DNB) signed a memorandum of understanding that aims to bring GND data into the FactGrid – on a grand scale.

The GND, the German Integrated Authority File, is an authority file of millions of persons plus corporate bodies, conferences and events, geographic information, topics and works – designed to shape the exchange between libraries, archives and academic projects in the DACH countries of Germany, Austria and Switzerland.

integrating the GND into the FactGrid had been our constant topic of discussion during the last year. A Wikibase instance becomes a cool thing to contribute to, as soon as it becomes the research tool that you would use yourself in your research. GND data links into the world of open data; they clarify who or what you are speaking of in your research in all German-language contexts – and they will reach out to the other global authority files and to the universe of library data.

In April 2018 it became clearer that the FactGrid would eventually be one of several Wikibase instances which could and should in this case aim for a larger federation. Early in June it transpired that the German National Library was on its way to test Wikibase in a software evaluation, with the aim to run possibly about ten Wikibase instances in a constant exchange with each other. That was when we contacted the DNB with our own agenda to import their data. We wanted to try, so that our proposal, could become a platform for “original research” – a platform without GND or Wikidata criteria of notability – in the evolving network of Wikibase platforms. Users will be allowed to create Q-Numbers for infants who died right after birth on FactGrid, and the GND and Wikidata will be free to decide under their criteria of notability and relevance, whether they would like to use our information – information they can now quote as original research from the FactGrid platform (with the detailed information of the projects behind this research).

Whilst the GND is CCO and free to be copied, the open joint venture with the German National Library aims to bring transparency into the data input. The more transparency we can bring into all the design decisions in this early stage, the better the wikibase platforms we are heading towards, will eventually be able to communicate with each other.

Now a team has to be formed. The German National Library and the Gotha research institutions of the University of Erfurt will send members into the team. The question is: Will we be able to broaden this team? We should have experts from the Wikimedia communities on board – people who know Wikibase and Wikidata, people who are used to community work on a regular wiki.

  • We would like to attract people who know how to formulate SPARQL searches and who will be able to test data models and make suggestions for the improved data models we should use, in order to handle the massive data sets we are expecting.
  • We’re looking for Wikibase experts who know how to bring in tens of millions of records into a Wikibase installation, and who know how to interconnect these records with genealogical and geographical links.
  • We do not yet know how we will keep the FactGrid manageable with respect to the wave of doublets and name parallels we are facing: The GND has these name parallels in unprecedented numbers. We will have to find ways to quickly inform researchers whether a person they have found in a document is already on the FactGrid or whether they will have to create the item. The hunt for items to be merged will become a permanent issue and we do not yet know how to technically support a community on this collective quest.
  • We will create new and complex fields of expertise: Millions of personal data sets will come with career statements. The FactGrid will turn all these statements into Q-Items, which we will have to organise in order to allow sociological searches for instance. The FactGrid project on historical jobs and their evolution will be only one of these projects.
  • We need players with Wikipedia experience: Though we will restrict ourselves to clear name accounts, we widely invite users with professional to private ambition to join the platform with their projects – whether they are focused on private genealogy or on publicly funded historical research.
  • We will have to provide a simplified FactGrid user interface that will bypass the SPARQL QueryService and the mushrooming Wikibase input pages. Magnus Manske’s Reasonator might become our standard interface for regular users, who will access the FactGrid as if they are accessing library catalogues – through organsied input forms.
  • We will eventually need help with database maintenance. It is particularly unfortunate that our project is primarily the work of historians, who do not always have a keen eye on how to optimally supply this technology.

The FactGrid will grow – and it will offer plenty of space for people to develop their own projects within this growth.


Scan of the Memorandum of Understanding (in German)


More

  • Barbara Fischer & Jens Ohlig, “Neues Testfeld für Wikibase: Eine Bundesbehörde geht auf Expedition im Wikiversum.” 2019-05-09 at https://blog.wikimedia.de

Memorandum of Understanding zwischen der Universität Erfurt und der Deutschen Nationalbibliothek – das FactGrid wird in einem Gemeinschaftsprojekt auf GND-Daten aufgesetzt

English Version

Das FactGrid-Projekt steht vor zwölf Monaten neuer Herausforderungen: Mit ihren Unterschriften vom 15. und 25. März 2019 unterzeichneten der Präsident der Universität Erfurt, Prof. Dr. Walter Bauer-Wabnegg, und Dr. Elisabeth Niggemann als Generaldirektorin der Deutschen Nationalbibliothek in Frankfurt und Leipzig ein Memorandum of Understanding, das in großem Umfang GND-Daten ins FactGrid bringen soll – Daten zu mehreren Millionen Personen und Körperschaften. Noch ist nicht klar, aus welcher Datenquelle wir die Ortsinformationen einspielen werden, die wir zudem benötigen werden.

Für die FactGrid-Projektbeteiligten lag hier noch nach der ersten Berührung mit der Software das sich abzeichnende große Desiderat: Eine Wikibase-Instanz wird zum interessanteren Werkzeug, wenn sie Benutzern Recherchen abnimmt und Wissen anbietet, auf das Forschung unmittelbar aufbauen kann. Die GND stand im selben Moment als die Datenquelle im Raum, aus der die Geisteswissenschaften im deutschsprachigen Raum sich in jedem Fall zu bedienen hätten. Von einem GND-Input aus könnte man beliebig weiterdenken, mit dem Blick auf die Verzeichnisse deutscher Drucke oder auf komplementäre internationale Normdaten.

Klar wurde im April 2018, der Europeana Workshop in Antwerpen war hier eine Wegscheide, dass soeben allerorten erste unabhängige Wikibase-Instanzen entstanden; sie würden im optimalen Fall eine „Föderation“ anstreben. Die Deutsche Nationalbibliothek würde, so der Informationsstand nur zwei Monate später, eigene Wikibase-Instanzen aufbauen — erst einmal in einer Software-Evaluation. Das FactGrid-Projekt stand damit vor Entscheidungen: Entweder setzten wir auf eine Plattform, die sich spezialisierte und noch im Frühstadium isolierte und nutzten GND-Daten nur für uns oder wir riskierten eine Ressource, die sich im Verlauf zwischen der GND und Wikidata als Plattform für „Original Research“ anbieten kann. Unser spezielles Angebot lässt sich benennen: Wir werden nicht die GND- oder Wikidata-Relevanzkriterien übernehmen. Bei uns wird man Datensätzen zu Säuglingen anlegen können, die nach der Geburt verstarben, um ein klareres Bild von Säuglingssterblichkeit im historischen Längsschnitt zu gewinnen. Wir werden der GND und Wikidata im selben Moment anbieten können, nach ihren eigenen Relevanzkriterien Informationen von uns zu beziehen — Informationen, die wir als Forschungsbeiträge zitierbar machen.

In welche technische Lösungen sich das übersetzen wird, sprich: wie Wikibase-Instanzen in Zukunft miteinander kommunizieren werden, ist noch offen. Jetzt jedoch schon können wir eine Instanz zur Verfügung stellen, auf der sich die GND in einer Wikibase-Version bearbeiten lassen wird.

Eine solche GND-Version gemeinsam mit der Deutschen Nationalbibliothek zur Verfügung zu stellen, hat vor allem den Zweck, Erfahrungen dabei unter allen Beteiligten verfügbar zu machen. Von der Transparenz der Design-Entscheidungen wird abhängen, wie gut die hier entstehenden Instanzen später miteinander kommunizieren werden.

Ein Team wird jetzt zu sammeln sein — aus den beteiligten Institutionen der Deutschen Nationalbibliothek und der Gothaer Forschungseinrichtungen der Universität Erfurt und, hier soll das unten publizierte Memorandum of Understanding Klarheiten schaffen, aus den Commmunities des Wikimedia-Umfelde, die mit Wikibase und mit Wikis im Moment entschieden vertrauter sind als wir.

  • Wir suchen SPARQL-Bewanderte, die Datenmodelle austesten und Vorschläge für geschicktere Datenkonfigurationen machen werden, mit denen man die auf uns zukommenden großen Informationsmengen intuitiv und fruchtbar handhaben wird.
  • Wir suchen Wikibase-Kenner, die wissen, wie man Mengen von mehreren Millionen Datensätzen in eine Wikibase-Instanz hineinbringt, und diese Datensätze dabei mit genealogischen und räumlichen Vernetzungen durchdringt.
  • Uns fehlt Expertise darin, wie wir das FactGrid in der Woge der Doubletten und Namensgleichheiten handhabbar halten, die nun auf uns zurollt: Die GND birgt Namensgleichheiten in bislang nicht dagewesenem Maße. Wir werden Wege finden müssen, wie man Forschenden in diesem Meer schnell Überblick gibt, ob die Person, die sie in einem Dokument genannt finden, schon über einen Datensatz verfügt oder neu angelegt werden muss. Die Doublettenfahndung wird zum Dauerthema werden, und wir wissen im Moment noch nicht, wie wir sie auf eine interessierte Community ausrichten und diese dabei technisch unterstützen.
  • Eigene diffizile Fachgebiete werden bei uns entstehen: In Millionen der GND-Personeneinträge finden sich Berufsangaben; bei uns wird aus jeder solchen Angabe ein Datenbankobjekt werden, zu dem nun eigene Aussagen zu machen sind. Wir werden hier Fachleute in verschiedensten Gebieten anziehen müssen, die derartige Felder zu durchdringen und zu erschließen wissen.
  • Wir brauchen Mitspieler, die schlicht Community-Erfahrung haben: Das FactGrid visiert die breite Nutzung an, auch wenn wir dabei auf die Verwendung von Klarnamen setzen. Im gelingenden Fall wird das FactGrid in den Wikipedia-Geschichtsprojekten beliebt werden und Accounts an Universitäten, in Bibliotheken und Archiven vergeben. Lokale Geschichtsvereine und Internet-Genealogie-Projekte sollten an der entstehenden Ressource mit ihren komplexen Vernetzungsangeboten Interesse gewinnen.
  • Wir werden das FactGrid mit einer Benutzeroberfläche ausstatten müssen, die technische Laien am SPARQL-QueryService und an den wuchernden Wikibase Eingabeseiten vorbeiführt. Suchmasken, die vermutlich direkt auf Seiten unseres (im Moment noch nicht sonderlich gut funktionierenden) Reasonator-Angebots führen, das Benutzer in beliebigen Sprachen mit strukturierten Datenblättern bedienen wird, könnten der Zielpunkt sein.
  • Wir werden schließlich Hilfe in der Datenbank-Betreuung benötigen. Hier ist ganz besonders misslich, dass unser Projekt im Moment vor allem die Arbeit von Geschichtsfachleuten ist, die nicht in jedem Moment bereits im Blick haben, wie sie die Technik optimal beliefern.

Das FactGrid wird wachsen und Mitspieler brauchen, die in diesem Wachstum vor allem Raum für ihre ganz eigene Projekte entdecken werden.

Mehr

  • Barbara Fischer & Jens Ohlig, “Neues Testfeld für Wikibase: Eine Bundesbehörde geht auf Expedition im Wikiversum.” 9. Mai 2019 at https://blog.wikimedia.de

Nachfolgend der Text der getroffenen Vereinbarung:


Memorandum of Understanding

zwischen

Deutsche Nationalbibliothek, vertreten durch die Generaldirektorin, Frau Dr. Elisabeth Niggemann
Adickesallee 1
60322 Frankfurt am Main

Universität Erfurt, vertreten durch den Präsidenten, Herrn Prof. Dr. Walter Bauer-Wabnegg
Nordhäuser Straße 63
99089 Erfurt

ausführende Einrichtungen:

Forschungszentrum Gotha der Universität Erfurt
Schlossberg 2
99867 Gotha
im Folgenden: FZG

Forschungsbibliothek Gotha der Universität Erfurt
Schloss Friedenstein
99867 Gotha
im Folgenden: FBG

Präambel

Die Deutsche Nationalbibliothek hat die Aufgabe, lückenlos alle deutschen und deutschsprachigen Publikationen, Tonträger und Musikalien (einschließlich Netzpublikationen und digitaler Objekte) ab 1913, im Ausland erscheinende Germanica und Übersetzungen deutschsprachiger Werke sowie die zwischen 1933 und 1945 erschienenen Werke deutschsprachiger Emigranten zu sammeln, dauerhaft zu archivieren, bibliografisch zu verzeichnen sowie der Öffentlichkeit zur Verfügung zu stellen.

Die FBG und das FZG sind zentrale wissenschaftliche Einrichtungen der Universität Erfurt. In ihrer Arbeit sind sie auf der einen Seite auf die Gothaer Bestände ausgerichtet; über ihre Stipendienprogramme und Forschungsprojekte, mit Schwerpunkten in der Erforschung der Frühen Neuzeit und der Globalisierung des 19. Jahrhunderts, andererseits international aktiv.

Die nachfolgenden Vereinbarungen betreffen die vom FZG initiierte und vom Universitätsrechen- und Medienzentrum der Universität Erfurt unter der URL https://database.factgrid.de gehostete Wikibase-Instanz, die seit dem August 2017 in einer Kooperation zwischen dem FZG und Wikimedia Deutschland aufgebaut wurde, um historischer Forschung insbesondere im Interesse an der internationalen Zusammenarbeit wissenschaftlicher Projekte zur Verfügung zu stehen.

Dies vorangestellt, treffen die DNB und die Universität Erfurt folgende Absichtserklärung:

§ 1 Gemeinsame Vorstellungen

Wikibase, die für Wikidata genutzte Software, soll sich in Zukunft zu einem funktionsfähigen Werkzeug für Wissenschaftler und wissenschaftliche Projekte entwickeln, mit dem in eigenen Installationen Daten offen und kollaborativ geteilt werden können.

Die gemeinfreien Daten der Gemeinsamen Normdatei (GND) – speziell die Daten für Personen und Körperschaften – sollen hierzu in der bestehenden Installation die Datengrundlage bieten, die es Wissenschaftlern erlaubt, Informationen in der Datenbank zu verknüpfen und anzureichern.

Für die GND liegt hierin ein erster Testfall einer größeren Datenintegration in eine Wikibase Instanz. Größere Aufgabenfelder werden im Rahmen dieser Vereinbarung im Blick zu halten sein: Wie lässt sich eine Wikibase Instanz in einen kontinuierlichen Datenabgleich mit Schwesterprojekten bzw. anderen Wikibase Instanzen bringen? Wie lassen sich etablierte Nutzungen der GND auf Seiten von Anwendern und Recherchierenden in neuer Systemumgebung realisieren?

§ 2 Gemeinsame Ziele

Die Partner wollen – im Rahmen ihrer Ressourcen und Möglichkeiten – im Erfahrungsaustausch miteinander die bestehende FactGrid Wikibase-Instanz mit Personen- und Körperschaftsdaten der GND befüllen.

Folgendes soll in diesem Projekt umgesetzt und evaluiert werden:

  1. Import von GND-Datensätzen in die (Factgrid-)Wikibase-Instanz
  2. Anforderungserhebung zur Synchronisation von Daten verschiedener Wikibase-Instanzen
  3. Anforderungserhebung für das Retrieval
  4. Evaluation bestehender Werkzeuge zur Qualitätssicherung und zur Präsentation der Daten
  5. Dokumentation der Projektarbeit und der Evaluationsergebnisse

§ 3 Aktivitäten

Zusammenarbeit

Die Partner stellen ein Team zusammen, das sich im ersten halben Jahr nach Vereinbarungsabschluss mindestens alle sechs Wochen in Treffen und Video-Konferenzen koordiniert und Aufgaben unter sich aufteilt.

Bis zum März 2019 streben sie die Erstellung eines Arbeitsplans mit Aufgabenverteilungen an.

Die DNB erhält Zugriff auf die Datenbank und administrative Benutzer-Accounts im FactGrid.

Die Partner dokumentieren im Blick auf spätere Datenbankverbindungen zu Wikidata und eventuellen DNB-Wikibase-Instanzen ihre Designentscheidungen und Arbeitserfahrungen.

Kommunikation

Die DNB und das FZG/FBG benennen einander je einen Ansprechpartner für alle im Rahmen der Zusammenarbeit abzustimmenden Angelegenheiten. Die Beteiligten sorgen dafür, dass sie sich regelmäßig gegenseitig über Vorhaben und Projekte in den gemeinsamen Arbeitsbereichen informieren.

Die Partner nutzen die ihnen zur Verfügung stehenden Kommunikationskanäle, um die Öffentlichkeit und ihre Communities über gemeinsame Aktivitäten zu informieren. Kommunikation nach außen, die das gemeinsame Vorhaben betrifft, wird vor Veröffentlichung immer zwischen den Partnern abgestimmt.

Für die Außenkommunikation räumen sich die Partner wechselseitig das nicht-ausschließliche, zeitlich auf die Laufzeit dieser Vereinbarung begrenzte und nur mit vorheriger Zustimmung übertragbare Recht ein, die von dem jeweils anderen Partner zur Verfügung gestellten Logos-, Namens-, Bild- oder Markenrechte zum Zwecke der Durchführung der vorliegenden gemeinsamen Ziele zu nutzen; dies gilt nur, soweit dies rechtlich zulässig ist und keine Rechte Dritter entgegenstehen. Die für die vereinbarten Zwecke benötigten Materialien, Abbildungen etc. werden kostenfrei vom jeweiligen Partner zur Verfügung gestellt. Die Partner verpflichten sich, die graphischen Gestaltungsvorgaben des jeweils anderen zu erfüllen.

§ 4 Dauer

Diese Vereinbarung tritt mit ihrer Unterzeichnung in Kraft. Sie gilt zunächst für 12 Monate und kann danach jederzeit unter Einhaltung einer Frist von 30 Tagen zum Ende eines Kalendervierteljahres einseitig gekündigt oder im beiderseitigen Einvernehmen vorzeitig beendet werden.

§ 5 Sonstiges

Durch diese Vereinbarung entstehen der DNB und der Universität Erfurt keine finanziellen Verpflichtungen. Die Partner stellen jeweils die auf ihrer Seite notwendigen Personal- und Sachleistungen zur Verfügung und tragen die ihnen dadurch entstehenden Kosten selbst. Wechselseitige Schadensersatzansprüche sind ausgeschlossen. Bei Ansprüchen Dritter haftet der Verursachende allein und ausschließlich.

Frankfurt am Main,
den 25.03.2019
Dr. Elisabeth Niggemann
Erfurt,
den 15. MRZ. 2019
Prof. Dr. Walter Bauer-Wabnegg


Scan der originalen Vereinbarung

„Archivführer zur deutschen Kolonialzeit“ online – ein Gespräch mit Uwe Jung, FH Potsdam, über den Einsatz von Wikidata als Forschungsplattform

Google translate English Version

Uwe Jung ist wissenschaftlicher Mitarbeiter beim Projekt “Quellen zur deutschen Kolonialzeit” an der Fachhochschule Potsdam. Die Beta-Version des Archivführers geht dieser Tage online. Im folgenden Interview geht es u.a. um die Frage, welche Rolle Wikidata im Projekt spielt.

Olaf Simons: Wir sprachen im vergangenen Sommer miteinander über die Möglichkeiten, Wikibase in Forschungsprojekten und bei der Präsentation von Forschungsarbeit einzusetzen, und tauschten uns dabei über verschiedene Optionen aus. Mit Ihrem Projekt gehen Sie soeben online. Worum geht es darin?

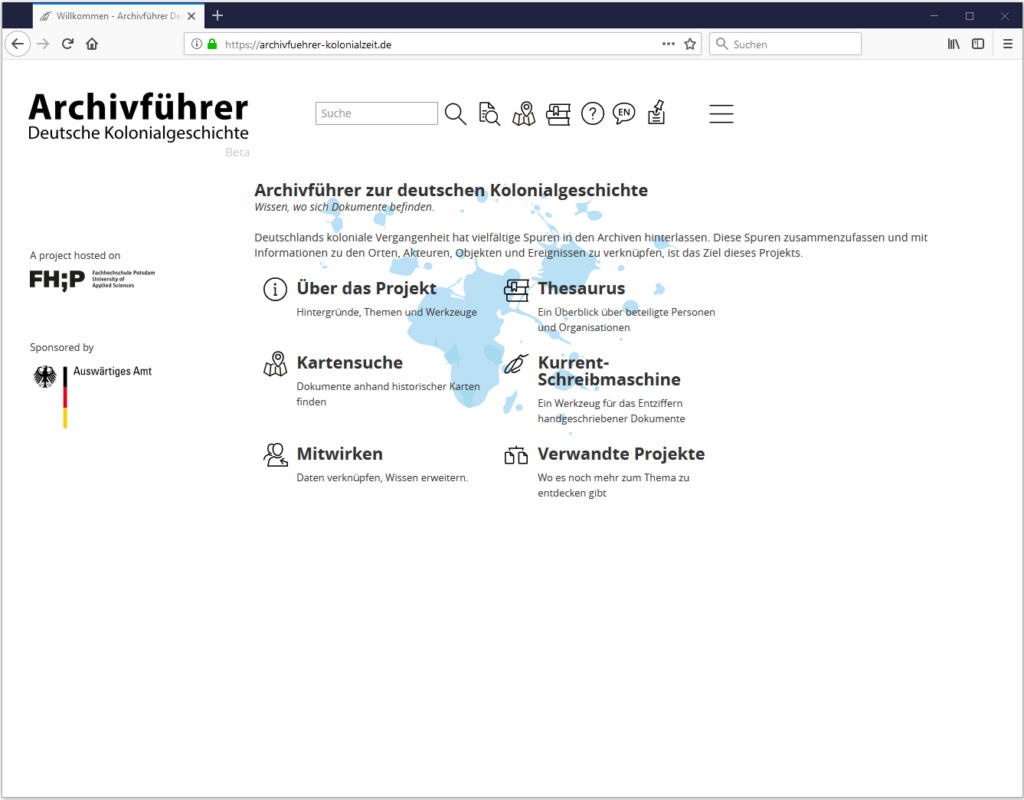
Uwe Jung: Deutschlands koloniale Vergangenheit hat vielfältige Spuren in den Archiven hinterlassen. Im Projekt “Archivführer zur Deutschen Kolonialgeschichte” https://archivfuehrer-kolonialzeit.de/ geht es darum, diese Spuren zusammenzufassen und mit Informationen zu den Orten, Akteuren und Ereignissen zu verknüpfen. Dabei kommt der freien Datenbank Wikidata eine zentrale Rolle zu.


Screenshot der Startseite https://archivfuehrer-kolonialzeit.de/

Olaf Simons: Das Projekt läuft an der Fachhochschule Potsdam?

Uwe Jung: Ja, das Projekt ist dort am Fachbereich Informationswissenschaften angesiedelt. Es wird zum größten Teil vom Auswärtigen Amt finanziert.

Olaf Simons: Sie entschlossen sich schon in der Antragsphase auf eine Realisierung mit Wikidata als Datenbank zu setzen – war das mutig? und was gab die Idee dazu?

Uwe Jung: Ich denke, mehrere Punkte haben dazu beigetragen. Zum einen war mir Wikidata bereits vorher bekannt. Persönlich unterstütze ich die freie Zugänglichmachung von Wissen. Die verschiedenen Wikimedia-Projekte sind hierfür sicher ein zentraler Ort. Zum anderen wurde mir aufgrund meiner beruflichen Erfahrung in Kamerun klar, dass es in den Nachfolgestaaten der deutschen Kolonien andere Prioritäten bei der Beschäftigung mit der gemeinsamen Geschichte gibt. Wir haben das Problem, dass Thesauri und Vokabulare in Europa häufig nur einen europäischen Blick auf diese Geschichte werfen. Das fängt bei der Schreibweise von Namen und Orten an. Viel wichtiger ist aber noch die Tatsache, dass z.B. in der Gemeinsamen Normdatei, an sich ein sehr gutes Werkzeug, in der Regel nur Entitäten auftauchen, die entweder selbst veröffentlicht haben oder über die zentral in einem Werk berichtet wird. Das Vokabular selbst wird in Europa verfasst, also weitgehend unter Ausschluss der “anderen” Seite.

Wikidata bietet nunmehr die Möglichkeit, gemeinsam an einem Vokabular zu arbeiten und ganz nebenbei auch noch das Thema “Kolonialgeschichte” in einen historischen Gesamtzusammenhang zu stellen.

Olaf Simons: Das ist, nebenbei, unser aktuelles Projekt: die gesamte GND – Personen und Körperschaften in unsere Instanz importieren und, soll ich sagen: sie öffnen? In jedem Fall sie benutzen und sie veränderbar machen – gemeinsam mit der GND, denn dort sieht man die Problemstellen nicht minder.

Wie sieht in Ihrem Projekt das Verhältnis von Projektarbeit und Mitarbeit der Öffentlichkeit aus? (Das ist in unseren Projekten ein zentraler Punkt: wir sind es die darin einen Großteil der Erschließungsarbeit in Teams oder in der Forschung Einzelner leisten).

Uwe Jung: Was die praktische Erfahrung betrifft, stehen wir noch am Anfang. Die Arbeit an der Seite selbst und das Zusammentragen von archivischen Beschreibungen hatten bisher Vorrang. Geplant ist, dass über eine thematische Wikimedia User Group zukünftig die Arbeit zum Thema Kolonialgeschichte koordiniert werden soll. Dabei lassen wir uns von folgenden Überlegungen leiten: Erstens basiert die Partizipation der Öffentlichkeit meistens auf freiwilliger Basis. Es kann also niemand gezwungen werden. Besser ist es, die Leute dort abzuholen, wo sie sich zu Hause fühlen. In ihrem jeweiligen Teilthema. Zweitens gibt es bereits viele Personen, welche in verschiedenen Wikimedia-Projekten sich mit Teilaspekten des Themas beschäftigt haben. Die Wikimedia User Group würde also lediglich auf Vorhandenem aufbauen. Das dann jedoch zum Vorteil aller. Wie gesagt, es geht hier nicht nur um Wikidata, sondern auch um Wikipedia, Wikisource und andere Projekte. Für Wikidata ist jetzt mit dem WikiProject “European Colonialism” ein Anfang gesetzt.

Olaf Simons: Bei der Arbeit über die Kontinente hinweg dürfte die Mehrsprachigkeit von Wikidata interessant werden. Wie wird die Software in Afrika angenommen?

Uwe Jung: Ich habe den Eindruck, dass es für die Leute einfacher ist, Fakten miteinander zu verknüpfen, als längere Texte in einem enzyklopädischen Stil zu verfassen. Vorausgesetzt, die Zuordnung der Properties ist klar. Wir sollten nicht vergessen, dass die Art und Weise, wie Lexika verfasst sind, keine universell gültige ist.

Olaf Simons: Keine universell gültige – und auch keine besonders neutrale, ist doch in unserem Kulturraum die Tatsache, dass man eines Lexikon-Eintrags “würdig” wird, so etwas wie der bildungsbürgerliche Ausweis von persönlicher sozialer Bedeutung geworden…

Unser eigenes Projekt ging aus eigenen Debatte mit Leuten des Wikidata-Projektes hervor; sie ermutigten uns, eine eigene Instanz aufzumachen. Ein wichtiges Argument war dabei, dass wir im externen Bereich sozusagen als “Incubator for Original Research” agieren können – als eine Seite, auf der es möglich wird, Dinge zu konstatieren, die noch nicht veröffentlicht sind, und die von hier aus erst zitierbar werden.

Gibt es in Eurem Projekt an dieser Stelle Grenzen, wo Ihr das Gefühl habt, das würden wir gerne mit der öffentlichen Ressource Wikidata tun, aber könnten wir so eigentlich nur auf einer eigenen Ressource riskieren?

Uwe Jung: Nein, die sehe ich nicht. Koloniale Geschichte wirkt bis heute täglich nach. Sie ist ein Politikum und sie wird von vielen Seiten aus betrachtet und interpretiert. Wir sind uns im Projekt darüber bewusst, dass eine Vollständigkeit und Unveränderbarkeit der Daten nicht erreicht werden kann. Das gilt sowohl für die archivischen Beschreibungen als auch für die “Norm”-Daten. Es soll keine “Bibel” werden, sondern vielmehr Hinweise auf derzeit noch verborgene Informationen und Zusammenhänge geben. Aufzeigen, was alles zum Thema gehört und wie weit es in die verschiedenen Sphären der damaligen und heutigen Gesellschaften hinein reicht.

Olaf Simons: Eine solche Problemstelle sind in unserem letzten Projekt die Dokumente, über die wir arbeiten – Akten, die wir zwar zitieren und transkribieren dürfen, die jedoch ansonsten nur eingeschränkt öffentlich zugänglich sind. Es wäre eigenartig, für diese Objekte so einfach Wikidata-Items zu eröffnen. Ein zweites Problem ist, dass wir die Datenbank als Arbeitswerkzeug benutzen, gerade auch um etwa Datierungen einfach einmal versuchsweise zu setzen und dann zu sehen, wie eine solche Entscheidung in der Arbeit aufgeht.

Woher kommen bei Euch die Dokumente? Ich sah beim Probeblick in den Internet-Auftritt, dass Dokumente eine wichtige Rolle spielen.

Uwe Jung: Das wäre in der Tat eigenartig. Zwar ließen sich in Wikidata auch archivierte Dokumente beschreiben, doch sind diese Beschreibungen selbst wohl besser bei den besitzenden Einrichtungen aufgehoben. Etwas anderes ist die Anreicherung von Daten zum besseren Verständnis der Dokumente. Diese neu hinzukommenden Daten stehen aber für sich selbst und brauchen nicht zwangsläufig mit einem bestimmten Dokument verknüpft zu werden. Vielmehr bieten das Datenmodell und die implementierten Tools von Wikidata die Möglichkeit, diese Daten mit vielen anderen Beschreibungen zu verknüpfen, z.B. Publikationen, Denkmäler, Museumsobjekte, Geschichten, Kochrezepte u.s.w.


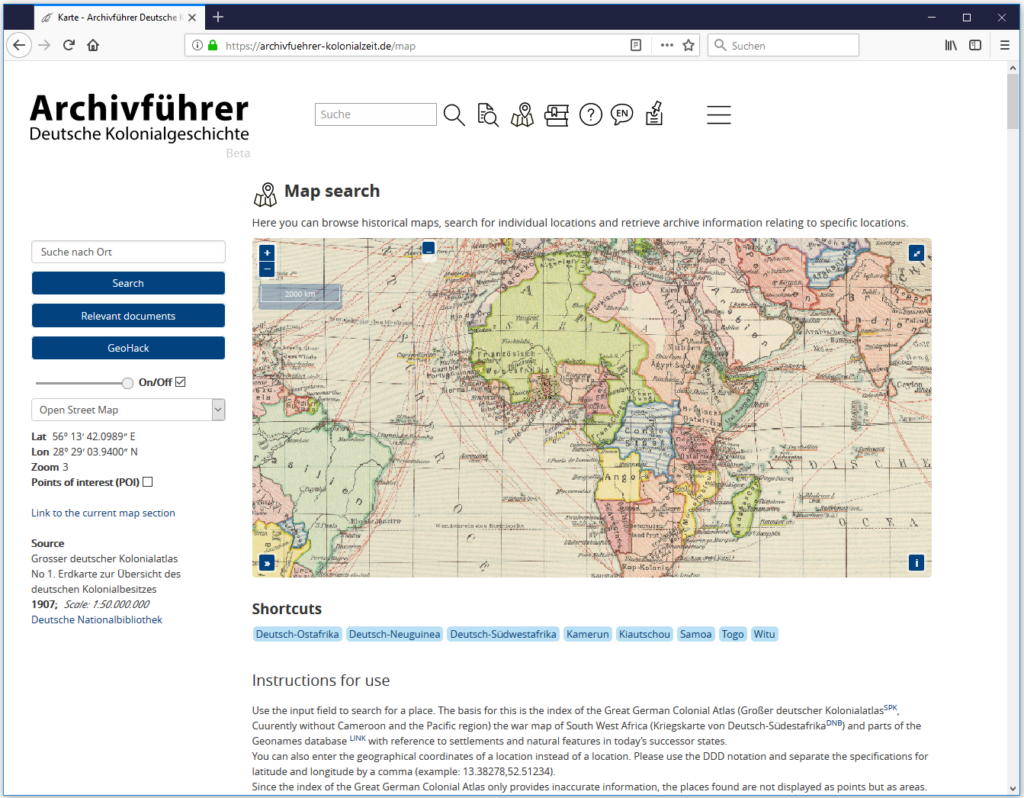
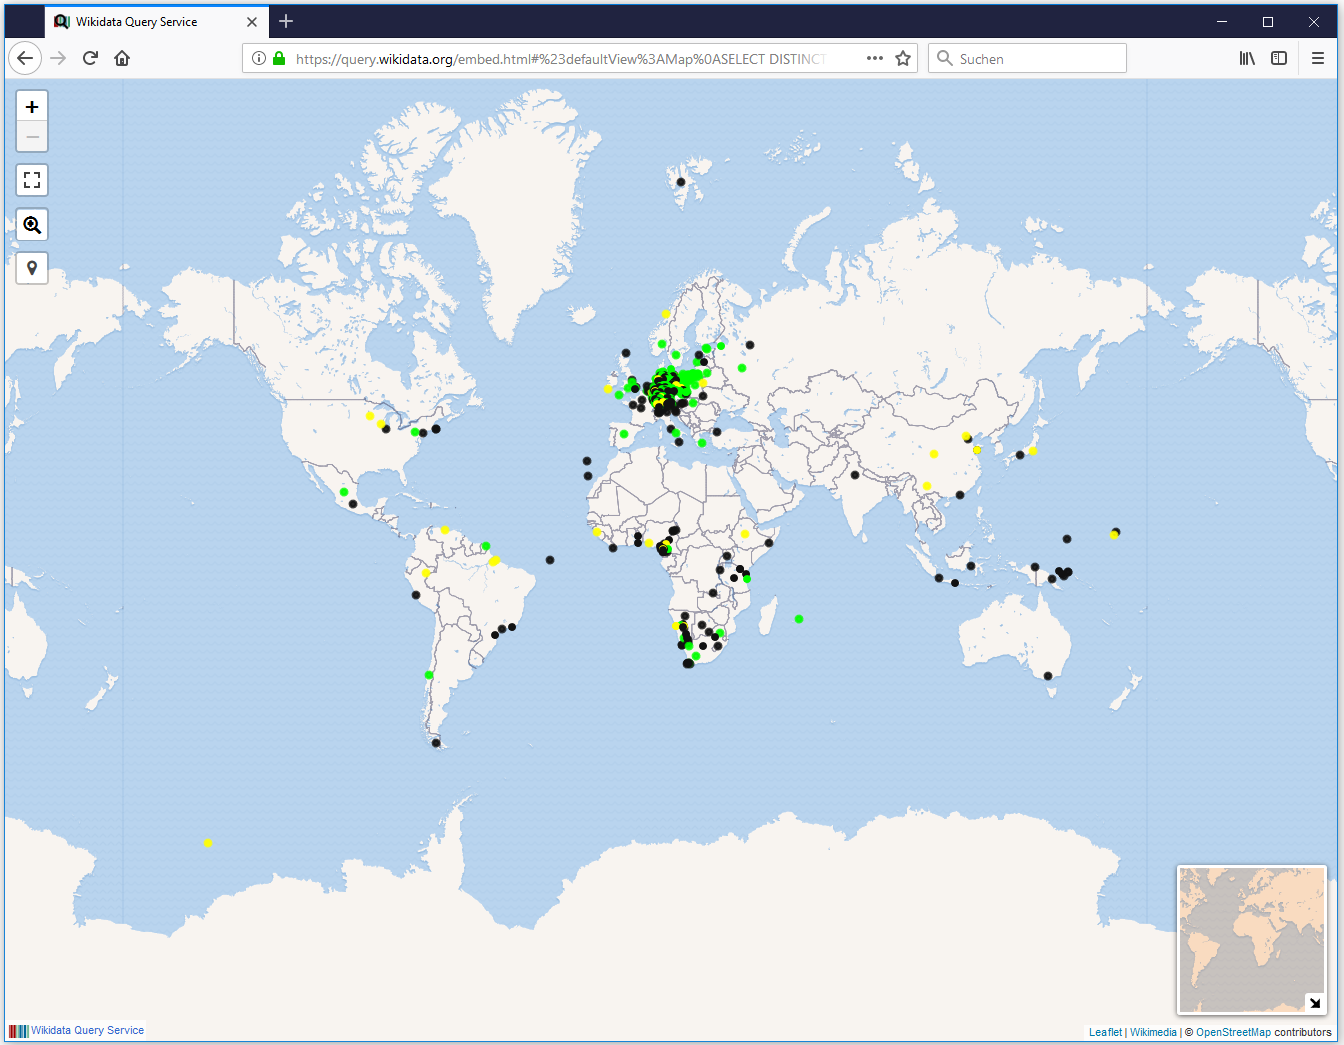
Der Kartenbrowser https://archivfuehrer-kolonialzeit.de/map

Olaf Simons: Euer Webauftritt hat sich seit dem Juni sehr verändert. Was bietet Ihr wem?

Uwe Jung: Es ist wichtig, die unterschiedliche Herangehensweise beim Publikum im Blick zu behalten. Deshalb gibt es zum Beispiel mehrere Sucheinstiege. Neben “Suchschlitz”, Facettensuche und erweiterter Suche kann auch ein Einstieg über die Normdaten erfolgen. Zusätzlich gibt es den Einstieg über den Thesaurus, welcher de facto ein Set von Wikidata-Abfragen darstellt. Und einen historischen Kartenbrowser, welcher wiederum mit einem historischem geografischen Index verknüpft ist. Eine weitere Besonderheit ist die “Kurrentschreibmaschine”, ein Werkzeug, das beim Lesen von alten Texten helfen soll.


Screenshot der Kurrentschreibmaschine

Olaf Simons: “Archivportal zur deutschen Kolonialgeschichte, Wissen, wo sich Dokumente befinden. Deutschlands koloniale Vergangenheit hat vielfältige Spuren in den Archiven hinterlassen. Diese Spuren zusammenzufassen und mit Informationen zu den Orten, Akteuren und Ereignissen zu verknüpfen, ist das Ziel dieses Projekts.” steht auf der Startseite. Ihr versucht, zu erfassen, wo es überhaupt Dokumente zur deutschen Kolonialgeschichte gibt. Wie geht Ihr dabei mit den Archivkatalogen und den größeren Verbundkatalogen (etwa dem Arcinsys) um, die ja ihre Archivalien gar nicht alle in Wikidata anmelden?

Uwe Jung: Auch wenn sich eventuell noch etwas am Einleitungstext ändern wird, die Intention bleibt gleich. Archivkataloge sind sicher ein Thema für sich. Auch hier basiert vieles auf der Freiwilligkeit. Eine große Hilfe sind die Deutsche Digitale Bibliothek bzw. das Archivportal-D. Viele Einrichtungen sind dort bereits vertreten und ermöglichen auch die Übernahmen von Metadaten. Ähnliches gilt für den Kalliope-Verbund. Einige Archive, wie z.B. das Bundesarchiv, stellen die Daten ihrer Bestände komplett als Open Data zum Download zur Verfügung. Von anderen haben wir die Daten in isolierter Form erhalten und konvertiert. Wiederum bei anderen Einrichtungen haben wir die Daten zunächst aus deren Online-Katalog gezogen und dann abgesprochen, was davon übernommen werden kann. Nicht zu vergessen ist, dass die Landschaft sehr heterogen ist und sich “Archivalien” letztendlich überall befinden können. Nicht nur in Archiven. Die Besucher/innen wiederum dürften wahrscheinlich eher daran interessiert sein, alles zusammen geliefert zu bekommen. Also Publikationen, Archivalien, Museumsobjekte, Debatten, usw.

Olaf Simons: Sicher auch zu recht. – Technisch gesehen habt Ihr eine Benutzeroberfläche aufgebaut, die Suchanfragen an Wikidata weitergibt – und an weitere Kataloge? (oder ist Wikidata hier das Nadelöhr, über das Ihr auf weitere Kataloge zugreift?

Uwe Jung: Hier muss unterschieden werden. Wikidata wird von uns in verschiedenen Zusammenhängen benutzt. Zum einen in Form des Thesaurus auf der Webseite. Diese Übersicht basiert direkt auf Wikidata-Abfragen und dient der allgemeinen Information sowie als ein Sucheinstieg in die Datenbank innerhalb des Portals.

Für die Auswahl, welche Daten aus den verschiedenen Online- und Offline-Katalogen übernommen werden, wird ebenfalls Wikidata benutzt. Hierzu gibt es eine zentrale Abfrage, die einen Korpus an Objekten zum Thema generiert. Die Labels und AlternateLabels aus diesem Ergebnis-Set dienen wiederum als Suchbegriffe für die Abfragen in den Katalogen. Ein Script sorgt dafür, dass allzu viel Noise (wie z.B. “Müller”) nicht übernommen wird. Dieses Script ist regelbasiert, da ein Rückgriff auf neuronale Netze keine befriedigenden Ergebnisse brachte.

Ein weiteres Mal wird Wikidata verwendet, um die zusammen mit den Beschreibungen importierten Normdaten der jeweiligen Einrichtungen zu vereinheitlichen. Die Normdaten werden über ihre Bezeichnungen mit existierenden Wikidata-Objekten verknüpft. Auch hier wird ein Großteil mit Skripten erledigt. Allerdings wird dann auch immer noch eine manuelle Kontrolle notwendig.

Olaf Simons: Visualisierungen sind mit einem eigenen Programmpunkt im Angebot…

Uwe Jung: Ja, eine der Stärken von Wikidata ist die Möglichkeit, Beziehungen zu visualisieren. Wir nutzen hier u.a. den SPARQL-Endpoint mit seiner Möglichkeit auch Ausgaben  in Karten- oder Diagrammform zu generieren.

Wikidata Screenshot
Screenshot Wikidata-Abfrage: Geburts, Wirkungs- und Sterbeorte von Personen mit Bezug zum Thema deutsche Kolonialgeschichte

Olaf Simons: Davon, worauf Eure Seite zugreift, merkt man als Besucher, wenn man dann bei Ausgaben auf die “Datenquelle” sieht?


Schritte bei der Durchsuchung des Thesaurus – sukzessive Screesnhots

Uwe Jung: Sofern ein Link zur Webseite der besitzenden Einrichtung mit übernommen werden konnte, wird dieser eingeblendet. Mit etwas Glück geht es dann von dort aus zum Volltext weiter. Leider gibt es aber auch noch Online-Kataloge ohne Persistent Identifier bzw. Permanentlinks zu einzelnen Beschreibungen.

Die Beschreibungen selbst werden einmalig übernommen, automatisch übersetzt und in einer lokalen Datenbank gespeichert. Die Daten des Thesaurus werden direkt aus Wikidata eingespielt, lassen sich also jederzeit von Dritten ändern und hoffentlich auch erweitern. Ein weiteres Script sorgt dafür, dass wir Änderungen am Korpus während der letzten 7, 30 bzw. 90 Tage zurückverfolgen, um eventuell auf Vandalismus reagieren zu können. Das alles spielt sich dann aber in Wikidata ab.

Olaf Simons: Und ist in Java-Script Interaktionen mit den Datenanbietern organisiert?

Uwe Jung: Nein, das wäre zu aufwändig. Wir verweisen darauf, dass Daten auf deren Webseiten aktueller und vollständiger sein können.

Olaf Simons: Ich meine Euer Angebot – wie ist das technisch gestrickt und woher hattet Ihr die Expertise, so etwas zu stemmen?

Uwe Jung: Die “Expertise” beantwortet gerade diese Frage 😉 Ich habe Afrikanistik mit der Spezialisierung Geschichte studiert. Hinzu kamen noch ein Studium in Bibliotheks- und Informationswissenschaften, Erfahrungen in der Auswärtigen Kultur- und Bildungspolitik und diverse IT-Kenntnisse. Vieles musste nebenbei noch gelernt werden, schließlich ändern sich Technologien ständig. Eine sehr große Hilfe sind dabei die diversen offenen Technologien. Für die gibt es im Netz viel Unterstützung und Anleitungen. Und man ist unabhängig von Service-Verträgen proprietärer Softwareanbieter.

Technisch basiert das Portal auf der freien Archivsoftware AtoM, die wiederum auf einem Ubuntu-Server agiert. Die Datenimporte und deren Weiterverarbeitung erfolgen hauptsächlich durch Python-Skripte. Für die Präsentation helfen Javascript zusammen mit den Frameworks jQuery und OpenLayer. Für die Georeferenzierung und Kachelung der Karten wurde QGIS mit den Plugins Georeferencer und QTiles benutzt.

Olaf Simons: Gut, Wir sollten Sie mal ausleihen ;).

Uwe Jung: Ab 2020 gerne 😉

Olaf Simons: An welcher Stelle des Webauftritts wird die Chance zum Zuge kommen, den Benutzer selbst die Datensätze verändern zu lassen, oder eigene Datensätze einzuspeisen? Wikidata ist ja gerade hier als interaktive Software interessant. Aus der Startseite geht das Interaktive nicht klar hervor…

Uwe Jung: An der Startseite wird sich bis zum Start noch einiges ändern. Im Portal selbst wird es keine gespeicherten benutzergenerierten Inhalte geben. Hierfür müssten zuvor diverse datenschutzrechtliche Dinge beachtet werden. Der Aufwand wäre zu hoch. Die eigentliche Interaktivität ist in der anzustrebenden Wikimedia User Group zu suchen. Vollständigere Daten im Wikidata-Korpus führen automatisch zu einem besseren Thesaurus im Portal. Außerdem ist es schwer, freiwillige Mitarbeit zu bekommen, wenn die Ergebnisse dieser Mitarbeit nicht unmittelbar und für alle zugänglich sind. Das Portal ist quasi nur ein Auszug aus (in der Mehrheit) bereits öffentlich einsehbaren Daten, welche rund um ein Thema gefiltert werden. Und selbst dieser Filter kann aufgrund der Vielschichtigkeit des Themas niemals fehlerfrei die Spreu vom Weizen trennen. Für die Zukunft wäre zu wünschen, dass sich ähnliche Portale zu anderen Themen mit weniger Aufwand herstellen lassen.

Nur um einen Einblick in die Vielfalt zu geben. Diverse Hauptverantwortliche der mörderischen Schlachten des ersten Weltkriegs waren zuvor einige Zeit in den Kolonien tätig. Zu nicht Wenigen davon gibt es verzeichnete Nachlässe. In den Kolonien waren Ingenieure tätig, zu deren Arbeiten es Pläne gibt. Das gleiche gilt für Naturwissenschaftler*innen und Mediziner. Diverse Künstler haben sich am Thema versucht oder waren gar vor Ort. Und über allen saßen Beamte mit ihren täglichen Problemen, die versucht haben, das Ganze zu verwalten. Unter anderem auch, damit einige Unternehmen und Missionen vor Ort tätig werden konnten. Schließlich spielte die Anti-Kolonialfrage spätestens ab 1919 eine wichtige Rolle in Systemauseinandersetzungen zwischen Ost und West. Sie finden also nüchterne amtliche Berichte neben wissenschaftlichen Abhandlungen, Gemälde neben Kartenwerken und Urlaubsfotos neben dem Ernst-Thälmann-Lied in Duala-Übersetzung.

Was jedoch klar wird, die deutsche Kolonialgeschichte lässt sich nicht auf einige herausragende historische Ereignisse bzw. auf einen reinen militärisch-politischen Aspekt reduzieren. Sie ist kein fest eingegrenztes Teilstück der deutschen Geschichte, welches sich bei Bedarf ausklammern lässt. Sie lässt sich eher mit einer Vielzahl von Flecken vergleichen, die zu einer nur scheinbar weißen Wand mit dazu gehören.

Olaf Simons: Vielen Dank für die Einblicke und das Interview.

Uwe Jung: Gern geschehen 😉


Bildquelle Featured Image: Uniformierung der Schutztruppe für Deutsch-Ostafrika (Brockhaus 1892), Dateiquelle Wikimedia Commons.