Nachklapp zur ersten GNDCon der Deutschen Nationalbibliothek, Frankfurt am Main, 3./4. Dezember 2018

Die Tickets für die erste große – vom 3. auf den 4. Dezember 2018 an der Frankfurter Nationalbibliothek veranstaltete – GNDCon waren Monate zuvor restlos vergeben. Um die 300 Interessenten füllten schließlich den großen Saal der Adickesallee 1 mit seiner Empore und am Rande aufgestellten Stehtischen: Bibliotheksrepräsentanten, Informatiker, die an Museen und in Archiven im deutschsprachigen Raum Datenbanken betreuen, Geisteswissenschaftler aus den Digital Humanities aller möglichen Projekte. Schließlich sollte es um nicht weniger als die „Öffnung der GND“, der Gemeinsamen Normdaten gehen, mit denen die Deutsche Nationalbibliothek Kultureinrichtungen im gesamten deutschsprachigen Raum und weltweit versorgt. CC0, frei lizenziert, sind sie schon seit längerem, doch das soll erst der Beginn der Öffnung sein.

Die anwesende Forschung war angereist zum guten Teil mit dem Willen aufzubegehren: Man sollte drauf dringen, in Zukunft höhere Rechte erhalten als das bescheidene, Vorschläge zu neuen Einträgen und zu dringenden Korrekturen machen zu dürfen. Bibliothekare äußerten sich unter der Spannung eines auf sie zurollenden Softwareumbruchs. Wer auch immer von der „Öffnung der GND“ redete, hatte womöglich noch kaum verstanden, wie die GND ihre Autorität bislang verteidigte. Für Wikidata sollte die Veranstaltung zu einer eigenartigen Geburtstagsfeier werden: Sechs Jahre waren vergangen und Wikidata war, anders als die Wikipedien zuvor, nach diesem sehr kurzen Spurt in der Lage, unter den globalen Normdatenanbietern mit Autorität zu punkten und mit der Software um die sich alles immer wieder drehte.

Durch das Programm führten Barbara Fischer und Jürgen Kett, erstere von Wikimedia an die DNB gewechselt. Internetkulturen mischten sich plötzlich mit ganz unerwartetem Charme.

Bildquelle: https://wiki.dnb.de/display/GNDCON2018/Bilder+%7C+GNDCon, Lizenz: Creative Commons unter Namensnennung, Weitergabe unter gleichen Bedingungen 2.5 Generic

Normdaten – Dreh- und Angelpunkte der Verständigung über die Dinge im Internet

Über die Normdaten organisieren sich mittlerweile die Katalogsysteme der Archive, Bibliotheken und Museen – und zunehmend auch Forschungsprojekte in den Digital Humanities.

Früher vermerkte jede Bibliothek, jedes Museum und jedes Forschungsprojekt für sich, von wem es soeben sprach; ob von „Thomas Mann“, dem Autor der Buddenbrooks, dem 1946 geborenen CDU-Politiker, dem zwanzig Jahre jüngeren Juristen oder von einem anderem der insgesamt 28 Träger dieses Namens, die die GND listet. Eindeutigkeit und Referenzdaten gewährleistet heute die GND-Nummer, an die sich alle Daten koppeln, über die die Trennungen verlaufen: biographische Eckdaten, geographische Informationen, Berufsbezeichnungen, zentrale Werkzuweisungen. Natürlich sollte Forschung der Digitalen Geisteswissenschaften sich der GND bei jedem Arbeitsschritt bedienen. Ein Projekt, das in Periodika der Weimarer Republik Autoren namentlich identifiziert, sollte diesen GND-Nummern zuweisen, wo immer solche bereits vorliegen, und so für spätere Auswertungen nachvollziehbar machen, wen genau man identifizierte. Es wäre im selben Moment praktisch, wenn das Projekt selbst GND-Nummern vergeben könnte. Am Ende erwartet man von der Deutschen Nationalbibliothek, dass sie die Forschung auswertet und neue Einträge generiert. Die Forschung weiß eigentlich am präzisesten, welche Datensätze sie soeben generieren möchte.

Im Rahmen des organisatorischen Verbunds, der die GND effektiv unter dem „DACH“ deutsch-österreichisch-schweizerischer Institutionen produziert, agieren in der GND eben darum längst schon Forscher mit eingeschränkten Editierrechten, mit Vorschlagsrechten – was indes eben immer noch weit entfernt bleibt von der Offenheit, mit der Wikidata jedem Nutzer erlaubt, Datensätze zu Personen und Werken anzulegen und Q-Nummern zu vergeben.

Die Eröffnungsvorträge der GNDCon folgten aufeinander wie zum Fanal abgestimmt. Harriet Aagaard, die Vertreterin der königlichen Bibliothek Schwedens, Vincent Boulet von der Bibliothéque Nationale de France und Jürgen Kett von der Deutschen Nationalbibliothek mit ihren Verschwisterungen nach Österreich und in die Schweiz verkündeten ihre Entscheidung, Wikidata in Zukunft als Brückenkopf im Informationsaustausch einzubeziehen. Darüber hinaus werde man prüfen, ob nicht Wikibase, die Software von Wikidata, die neue allgemeine Software im Bereich werden könne. Lydia Pintscher führte in Abrundung dieses Fanals in Wikidata ein. Spannung lag im Saal, da diese Weichenstellung verwirrende Unsicherheiten schafft: Wie vermittelt sich diese Entscheidungen der Bibliotheksleiter nach unten? Und: Was genau war hier den Forschern gesagt, die in der GND editieren wollen – dass sie besser gleich in Wikidata Datensätze erzeugten?

Wie Wikidata solches Gewicht gewann

Wikidata, der Startschuss zur Softwareentwicklung fiel erst 2012, begann mit dem Versuch, die Binnenverlinkung zwischen den gut 200 weltweit arbeitenden Wikipedien zu übernehmen – bis dahin hatten Wikipedianer sichergestellt, dass man über die „Interwiki-Links“ korrekt in Parallelartikel der anderen Sprachen gelenkt wurde. Wikidata weiß aus dieser Datenübernahme, in welchen Sprachen es einen „Thomas Mann“-Wikipedia-Artikel gibt und trennt die Artikel zum Lübecker Autor dabei mühelos von den Artikeln zu den anderen Namensträgern in allen Sprachen. Das allein wäre keine Revolution. Die kam mit der Entscheidung, die eigenen Identifikationen im nächsten Schritt mit allen wichtigeren Normdatensätzen weltweit zu verbinden. Wikidata wurde damit unvermerkt das Normdaten Repositorium, das den nationalen (und primär bibliothekarischen) Normdatenprojekten zueinander hilft: BNF-Mitarbeiter schlagen in Wikidata nach, welche GND-Datensätze den in der BNF identifizierten entsprechen. Doch wäre auch das vermutlich nur ein praktisches kleines Geschenk gewesen, wäre Wikidata nicht in jedem Moment dabei ganz anders aufgestellt gewesen: Wikidata kennt nicht nur alle Personen, die in irgendeiner Wikipedia einen Artikel haben, und kann dabei sagen, wo sich zwei Artikel auf dieselbe Person beziehen. Wikidata hat daneben auch Normdatensätze für Apfelsorten, Tische, Stühle und Bänke, ob namhafte Einzelstücke oder den Apfel, den Stuhl, den Tisch als solchem. Die Aussagen, die Wikidata in den Datensätzen macht, sind struktureller Natur: Wikidata erfasst (wie die DNB), dass Heinrich Mann Thomas Manns Bruder war. Anders als die GND-Datenbank weiß Wikidata jedoch zudem, sofern Wissen struktureller Natur ist, nicht nur nebenbei, was „Bruder“ auf Chinesisch oder Koreanisch heißt. „Bruder“, „Vater“, „Mutter“… sind in Wikidata selbst wieder Objekte mit Q-Nummern und mit Aussagen durch P-Nummern, die nun klären, was einen „Vater“ von einem „Bruder“ und einer „Mutter“ im Geflecht struktureller Aussagen zu nun Generation und Geschlecht unterscheidet – und hier wird im nächsten Zug wieder mit Q-Nummern und P-Aussagen definiert.

Die Normdatensätze der Bibliotheken sind, verglichen mit diesen Projekt, eng in ihrer vornehmlich nationalen Orientierung wie ihren Relevanzkriterien, die darauf abzielen, primär Autoren zu identifizieren und Schlagwortkataloge zu beliefern. Auf die Enzyklopädie aller Begriffe und Diskussionsgegenstände in allen Sprachen hatte es keine der Nationalbibliotheken abgesehen – Wikidata dagegen entspringt dieser globalen Enzyklopädie.

Wikibase: Eine Datenbank-Software für jedermann, die typische Bibliothekssoftware überraschend schlägt

Ich begriff am Vormittag des zweiten Tags klarer, warum man in der Deutschen Nationalbibliothek und eben nicht nur hier soeben über Wikibase nachdenkt. Interessierten war im Keller der Nationalbibliothek Zugriff auf eine Datenbankdoublette der GND eingeräumt.

Für den, der in Wikibase bereits Datensätze anlegte, ist die Software ein Schritt zurück in die 1990er Jahre: Die Benutzeroberfläche verlangt Einarbeitung. Jede Zeile eines Datensatzes eröffnet mit einer Nummer, der Ankündigung der nachfolgenden Aussage für den späteren Katalogeintrag. Hinter jeder Nummer muss Information in einer sehr speziellen Sprache abgelegt werden, um nachher korrekt ausgelesen zu werden. Man öffnet die begleitende Dokumentation im zweiten Browserfenster, sieht nach, welche Nummern etwa in einem Personendatensatz verwendet werden könnten und wie dabei die Eingabe zu geschehen hat – hier werden nicht Q-Nummern miteinander verbunden, hier wird vergleichsweise oft Text standardisiert eingegeben. Die Software arbeitet flach: Speichert man ab, wird der bisherige Datensatz überschrieben. Wikibase notiert dagegen, welche einzelne Aussage im Datensatz geändert oder hinzugefügt wurde und bietet Raum für Quellenangaben im Plural hinter jedem beliebigen Statement eines jeden Datensatzes. Die GND-Software ist zufrieden mit einer einzigen Quellenangabe für den ganzen Datensatz – und selbst die fehlt, wo immer man Daten aus vorhandenen Bibliotheksrepositorien übernahm.

Große Entscheidungen muss auch die DNB fällen und vorher diskutieren – die Diskussionen bleiben intern und außerhalb des Systems, wo in Wikidata ganz wie in den Wikipedien über alles öffentlich beraten, wenn nicht gestritten wird, was nachher Richtungsänderungen mit sich bringt.

Braucht man die Wikipedia-Öffentlichkeit in nationalen Bibliotheken? Und ist die Versionsverliebtheit der Wikibase-Software mit ihren Bearbeiterstempeln und Datierungen wie ihren „undo“-Aufforderungen mehr als eine nutzlose Anschwellung der Datenbank, die sich besser darauf konzentrierte, Fakten zu präsentieren?

Aus Sicht des Historikers ist die Antwort klar: Was heute erst einmal nach unnütz viel mehr Daten anmutet, wird in fünf Jahren von Laptops geleistet; und natürlich braucht man die Versionierung und die Quellen zu jedem einzelnen Statement. Es genügt nicht, irgendein Geburtsdatum zu kennen. Man sollte sagen können, woher dieses Datum bezogen ist. Und bei interessanten größeren Entscheidungen würde man gerne wissen, auf welcher Argumentation sie zustande kamen, um diese entweder übernehmen oder die Revision diskutieren zu können.

Die Autorität des Monopols

Die Autorität der nationalen Normdatenanbieter war bislang primär institutionell gewährleistet. Die deutsche Nationalbibliothek bietet das Geburtsdatum des Autors der Buddenbrooks, das jede Bibliothek übernehmen kann, weil eine Änderung (wenn sie denn unter einem neuen Befund nötig würde) eben der Nationalbibliothek gemeldet würde, um von hier aus in den vielen Katalogen zu erscheinen.

Den Scan der Geburtsurkunde benötigt die DNB dabei nicht. Wikidata würde ihn benötigen, die Datenbank, in der jeder Dahergelaufene Unsinn behaupten könnte, und die erst mit einem öffentlichen Quellenbeleg eine korrekte Information durchsetzen kann. Wikibase bietet die Nachweis-Aufforderung bis hin zur Option, einander widersprechende Daten mit den jeweiligen Quellen als genau solche divergierenden Daten verwalten zu können – eine extrem attraktive Option, da wir in der Datenüberlieferung oft nicht mehr haben, als einander widersprechende Quellen.

Eine neue GND-Software wird mindestens so leistungsfähig sein müssen wie Wikibase gegenwärtig ist. Sie wird in der Lage sein müssen, Nummern mehrsprachig zu belegen. Sie wird Edits einzeln versionieren können, um in Datensätzen jede einzelne Stellungnahme überprüfbar zu machen. Sie wird den Quellennachweis zu jeder Aussage einfordern und der Öffentlichkeit Einblick in Entscheidung gewähren, um mehr Sicherheit als Wikidata zu geben.

Wikibase ist frei lizenziert. Theoretisch könnte man die Software wohl so umprogrammieren, dass sie danach wesentliche Hierarchien in Bearbeitungsrechten aufweist, wie intransparente, „rein interne“ gegenüber öffentlich sichtbaren Bereichen. Praktisch wird der Schritt in Wikibase viel einfacher sein, wenn es gelingt, Instanzen in Kommunikation miteinander zu bringen. Man wird dann von der Nationalbibliothek aus mehrere Instanzen betreiben – öffentliche und weniger öffentliche und zwischen diesen die Richtungen im fortlaufenden Datenfluss autoritativ festlegen.

Dass Wikibase-Instanzen sich untereinander austauschen können, das Projekt von „Federated Wikibase Instances“, steht unabhängig davon in den Wikimedia Entwicklungsplänen.

Einigten die zentralen Normdatenanbieter sich global auf Softwarestandards, wäre man einen immensen Schritt weiter im Streben nach neuer Eindeutigkeit im weltweiten Datenaustausch. Gemeinsam mit Wikidata würden die alten Bibliotheken wieder Sicherheiten von Aussagen ins Netz bringen, härtere Aussagen als die der fuzzy Google searches, an die wir uns gewöhnten.

Und die Forschung?

In der GND zu editieren ist unter den gegenwärtigen Bedingungen für Forschungsprojekte nur bedingt attraktiv. Die Software ist unbefriedigend, doch natürlich wäre man gerne als Lieferant und Bezieher von GND-Nummern mit dabei, falls diese nicht soeben rapide an Wert verlieren. Im Moment sticht die GND – sobald man auf die nationale Ebene geht – Wikidata noch in der puren Quantität der Daten in den Kerngebieten aus; ein Rechenexempel aus Gothas Illuminaten-Projekt kann das verdeutlichen:

Zahl der nachgewiesenen Mitglieder im Illuminatenorden 1354 100%
Zahl der nachgewiesenen Illuminaten mit GND-Nummern 553 41%
Zahl der nachgewiesenen Illuminaten mit Wikidata-Nummern 191 14%

Die GND erfasst mehr historische Personen. Dass sie Studenten mit einer bibliotheksnotierten Dissertation beim Namen nennt, macht sie bei den Illuminaten überlegen; diese rekrutierten vornehmlich Studenten mit guten Karriereprognosen.

Im Zeitalter des freien Datenflusses hat ein solcher Vorsprung sein Verfallsdatum. Wikidata könnte die gesamte GND-Personenliste importieren (man mag ob der Doubletten, die man sich einhandeln würde, wie der fehlenden Vernetzung der Datensätze, vor einem solchen Import zurückschrecken). Die Masse Wikidata-nummerierter Personen bleibt im Gegenzug für die GND so uninteressant wie chinesische Lokalpolitiker, die Artikel in der Wikipedia ihrer Sprache haben. Die Überlegung lässt erahnen, von wo nach wo der Informationsfluss verlaufen wird: von den feinmaschigen vielen nationalen Datenbanken hin zu Wikidata.

Die Frage der „Relevanzkriterien“, die es bei der GND und weniger hart bei Wikidata gibt, ist am Ende die Frage, die für ganz eigene Forschungsplattformen spricht, denn die Forschung benötigt in letzter Konsequenz gänzlich offene Plattformen, auf denen man Datensätze bereits anlegen kann, wenn man erst noch sehen muss, ob sich mehr Dokumente zum Namen finden, über den man soeben stolperte. Ein Forschungsprojekt zum Bevölkerungsaufbau in frühneuzeitlichen Städten wird Datensätze für Säuglinge anlegen, die in den ersten zwei Lebensjahren verstarben – eine Erlaubnis, solche Personen einfügen zu dürfen, wird ein solches Forschungsprojekt von niemandem erbitten wollen. Was in der Forschung „relevant“ ist, darauf wetten Projekte kompetitiv in einer Zukunftsprognose: Was wichtige Forschung und damit relevante Information ist, das stellt sich dann heraus, wenn die Zitate der Arbeit beginnen und die Daten-Nutzung in Gang kommt, so die Spekulation jedes einzelnen Projekts.

Es ist dies der Grund, warum eine unabhängige Wikibase-Instanz mit den GND-Daten für die deutschsprachige Forschung so besonders spannend wäre – eine Plattform, die danach Schrittweise Datensätze anderer Nationen aufnähme.

Die große Kulturrevolution steht am Ende weniger für die GND oder Wikidata an, als für die Geisteswissenschaften, für deren bedeutendste Repräsentanten das Internet im Moment noch immer nicht viel mehr als ein grandioser Selbstbedienungsladen ist. Hier stellen, so die professorale Sicht, Großkonzerne wie Google gemeinsam mit Bibliotheken Hunderttausende von Büchern ins Netz, und hier schreiben fleißige namenlose Bienchen Wikipedia-Artikel, aus denen man mit copy & paste Informationen schnell mal eben beziehen kann, verblüffend verlässlich. Man selbst schreibt ein großes Buch und erwartet im Gegenzug mit dem Selbstverständnis des wissenschaftlich Publizierenden, dass die Leute aus dem Internet die eigene Arbeit geflissentlich beachten und noch aus den Fußnoten, die man setzte, die biographischen Richtigstellungen beziehen und korrekt in die Kataloge und Wikipedia-Artikel bringen. (Empört ist man, wenn die eigene Arbeit dabei nicht ordnungsgemäß zitiert wird; enttäuscht, wenn sie von denen im Internet unbeachtet bleibt.)

Die GND wird in der Transformation der Geisteswissenschaften, die hier noch immer ansteht, den interessantesten Impuls geben, wenn sie ihre Haltung zu den Wissenschaftlern wie zur eigenen Arbeit ändert. Es wird nötig werden, dass Wissenschaftler die Datenlage, die sie nutzen, unter der laufenden Arbeit in gesellschaftlicher Verantwortung in Stand halten – offen proklamiert. Sie benötigen dazu Plattformen, auf denen sie auch marginale Korrekturen von Daten noch als Forschungsbeiträge verbuchen können – sie ziehen es andernfalls vor, den persönlichen Wissensvorsprung auf dem privaten Rechner in Word-Dateien für sich und gegenüber den Kollegen zu behaupten, die ihre eigenen Word-Dateien mit bahnbrechenden Informationen für sich sorgsam hüten.

Die GND und Wikidata sind gegenwärtig in der einmaligen Lage, die Plattformen zur Verfügung stellen zu können, auf denen sich in Zukunft Wissen diskursiv – durch das Angebot des Belegs und der nachvollziehbaren Forschung – von der Flut der haltlosen bleibenden Behauptungen abgrenzt. Der Aufbau der neuen überlegenen, weil zitierbaren Ressourcen ist dabei derzeit noch gar nicht als Zentrum der Verantwortung der Geisteswissenschaften für das Wissen unserer Gesellschaften (wieder) in den Blick genommen.

Mehr Links

Der Gotha Zettelkasten – Wir vergeben Accounts

In den letzten Wochen gaben wir am Forschungszentrum Gotha mehrere – einander überlappende – Datensätze ins FactGrid ein. Unser Ziel ist es, die Grundlage für einen kollektiven großen Zettelkasten zu schaffen. Sein Gegenstand: das historische Gotha.

Gotha 1850, nach Abtragung der Stadtmauern

Der Gotha Zettelkasten soll

  • Informationen zu allen möglichen Objekten der Stadt erfassen: zu Häusern, Denkmälern, ja noch zu Bäumen
  • Informationen zu allen uns bekannt werdenden Personen bieten – ob berühmte Bürger oder Kinder, die noch kurz nach der Geburt unter der hohen Kindersterblichkeit der Frühen Neuzeit starben
  • Informationen zu Archivalien mit Datenbankobjekten verknüpfen – ob öffentlich verfügbaren Dokumenten oder privaten, die bei uns in Reproduktionen zugänglich gemacht werden können
  • Informationen zu Ereignissen anbieten, die hier als eigene Gegenstände des Interesses mit Wissen über die Orte, die beteiligten Personen und die vorliegenden Dokumente verknüpft werden

Was bieten wir im Moment?

Manches ist bereits ziemlich unüberschaubar. Das folgende Link bietet (blauen Knopf drücken) alle Personen, die in Gotha (zeitweilig) ortsansässig waren:

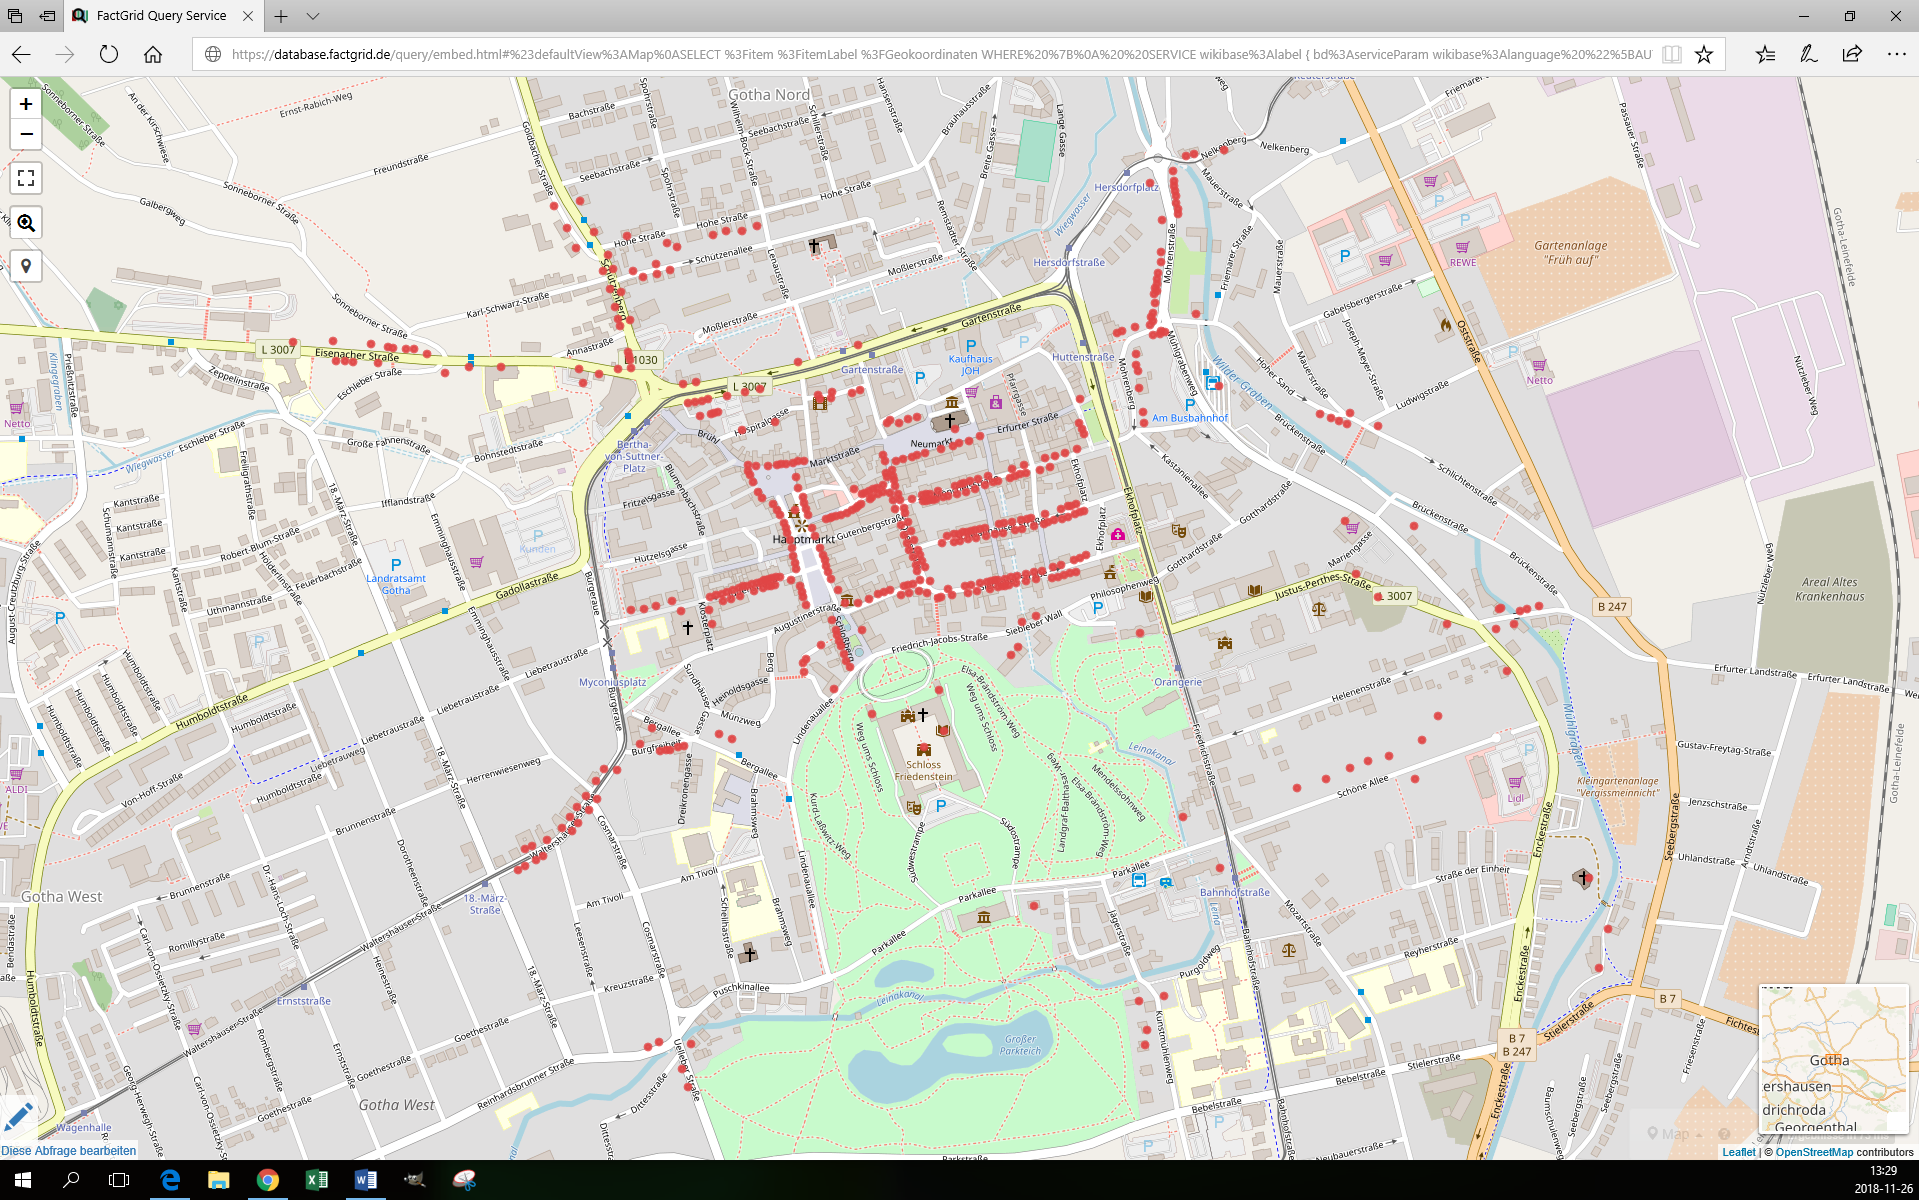
Vieles andere ist im Moment noch sehr gewöhnungsbedürftig: Die Datenbank kennt alle Adressen Gothas vor 1859. Viele von ihnen tauchen jetzt in der Suche auf der aktuellen Landkarte auf (wir wollen im Verlauf historische Landkarten verfügbar machen, auf denen man recherchieren kann). Mit dem folgenden Link kann man sich die gegenwärtig georeferenzierten Adressen auf der Landkarte anzeigen lassen:

 
…ist der Stadtplan auch noch unvollständig, weil die heutige Karte schlecht mit den alten Adressen zusammengeht, so bekommt man mit der tabellarischen Suche die gesamte Liste der Adressen vor 1859. Zu Beginn steht jeweils das Link in den Datensatz, unter dem man die früheren Namen der Adresse findet:

(um die Suchanfrage zu bearbeiten, Link links unten anklicken)

Für das Jahr 1848 können wir zudem alle männlichen, damals als Wahlmänner ausgeschriebenen, Erwachsenen nennen und den Häusern zuordnen. Wir wissen damit grob, welche Familien in welchen Häusern beieinander wohnten, wir kennen zudem die Berufe der Hausväter. Leider kennen wir damit noch lange nicht die Familien selbst: die Frauen und Kinder, die Eltern und Großeltern und mit diesen die Verwandtschaftsbeziehungen in der Stadt.

Hier vier Blicke in einzelne Häuser:

Dürftig ist zur Zeit unser Dokumentenvorrat – das Illuminatenprojekt (dessen Bestände in derselben Datenbank liegen) führt in die 1780er Jahre und berührt Gothas Stadtgeschichte und Bevölkerung nur hier und da.

Was wollen wir möglich machen?

Das FactGrid ist eine Wikibase-Datenbank. In gewisser Hinsicht kann sie alles, was Wikipedia kann: Man kann mit ihr beliebige Informationen auf Seiten zusammenstellen und die Informationen verlinken. Anders als in Wikipedia werden hier jedoch keine Artikel geschrieben, sondern Aussagen gesammelt: Wer war der Vater, wer die Mutter, wer die Ehefrau, wer die Kinder. Wann, wo geboren? Wann wo gestorben? Welchen Beruf? Welche Dokumente? Wann wo gewohnt? Wann wechselte dieses Haus den Besitzer? Wann wurde es abgerissen und neugebaut? Welche Namen trug es? Wo genau stand es auf der Landkarte?

Man kann ebenso gut Aussagen zu Dokumenten machen: In welcher Akte liegt das Dokument? Von wann ist es? Welche Personen sind genannt?

Anders als in Wikipedia wird es bei uns keine Debatte darüber geben, ob eine Person oder ein Dokument einen Wikipedia-Artikel „wert“ ist. Das Kind, das im Jahr 1784 zweijährig verstarb und von dem wir nur wissen, wer die Eltern waren, wie es hieß, wann es geboren wurde – ist mit all diesen Informationen einen Datenbankeintrag wert. Wir können im selben Moment sagen, wie viele Kinder Frauen im 18. Jahrhundert gebaren und wie viele davon nur überlebten. Uns interessieren Familienbilder, private Briefe, Tagebücher von Ur-Ur-Urgroßeltern, sollten sie noch irgendwo auf einem Dachboden liegen.

Wie kann man mitmachen?

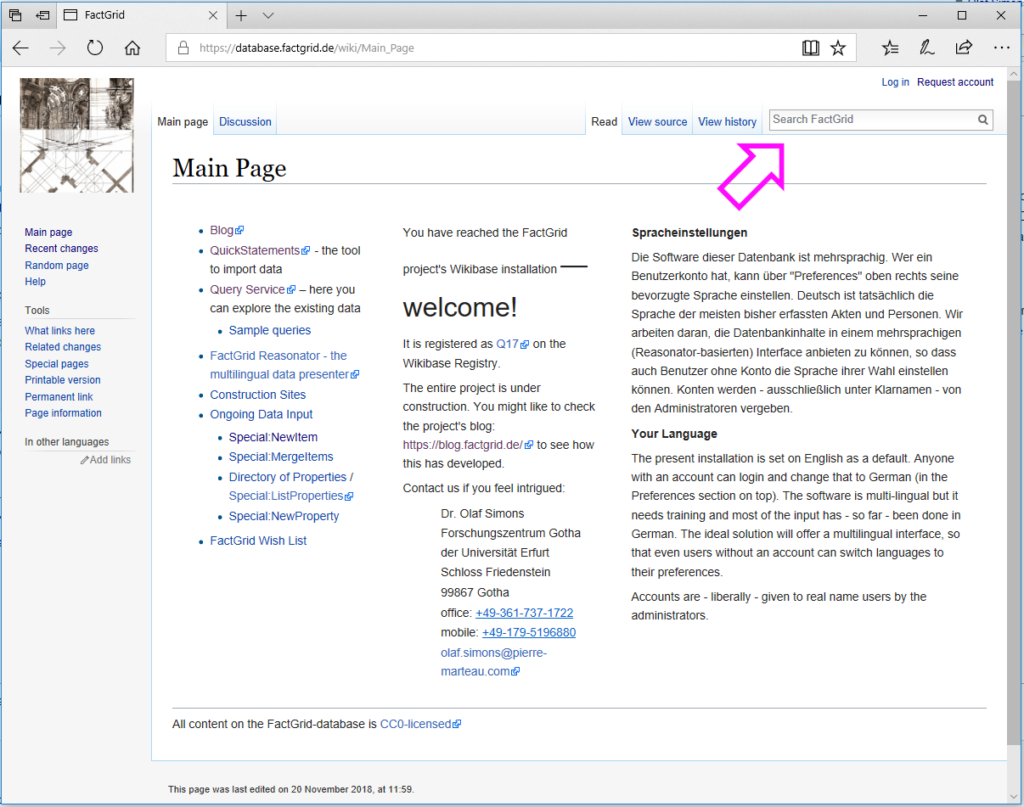
Die Datenbank ist offen sichtbar – was drin ist, kann sich jeder Besucher im Internet zeigen lassen. Im Moment ist das noch etwas holprig, da uns eine bessere Benutzeroberfläche fehlt. Man kann bereits jetzt wie in Wikipedia suchen (über das Suchfeld oben rechts).

Link in die FactGrid Datenbank

 
Daneben gibt es für Suchende mit besseren Computerkenntnissen die SPARQL Suche und eine Seite mit ersten Muster-Suchanfragen – eine reguläre Suchmaske ersetzt das nicht; sie muss kommen.

Wer sich von uns einen Account eröffnen lässt, kann sofort sehr viel mehr tun: Mit dem Account lässt sich die Benutzersprache auf Deutsch umstellen und, eingeloggt, kann man nun Änderungen an den Datensätzen vornehmen oder neue Datenblätter zu Personen der eigenen Familie anlegen wie zu Dokumenten aus dem eigenen Familienarchiv. Freuen würden wir uns, wenn sich hier eine Community bilden würde, die beim großen Puzzlespiel zusammenarbeitet und die sich mit unterschiedlichen Fähigkeiten ergänzt: Wer kann deutsche Handschrift lesen? Wer kann aus der Datenbank mit kleinen Programmierkenntnissen sehr viel mehr herausholen? – denn manches wird hier erst einmal ungewohnt sein: Man möchte bei einer Person einfach hinschreiben, wer der Vater war, doch will die Datenbank erst einmal, dass dieser Vater seine eigenen Q-Nummer hat, mit der sie dann gerne alle Verbindungen herstellen will. Wir helfen bei allen technischen Hürden online weiter.

Um den Start einfacher zu machen, gaben wir für die Mitte des 19. Jahrhunderts alle gut 1300 damals notierten Häuser ein und verteilten auf diese die gut 2400 bekannte Familienväter aus der Wahlliste des Jahres 1848. An diese ersten Datensätzen kann man nun leichter Steine anfügen im großen Puzzlespiel der historischen Stadt-Daten.

Für wen ist das spannend und warum soll man hier mitmachen?

Spannend ist die Datenbank für jeden, der zu Gotha privat oder beruflich forscht. Spannend ist sie aber auch für jeden, der seine Familiengeschichte oder die Geschichte seines Hauses hier zurückverfolgen will. Spannend sollte die Datenbank für Schulprojekte werden, die sich mit der Geschichte der Stadt oder des Territoriums auseinandersetzen – wir geben gerne ganze Recherchethemen, bei denen man in Projektarbeit über Akten und Geschichte und Informatik schlauer wird.

Der “Gotha Zettelkasten” sollte im Verlauf eine Ressource werden, um kollektiv Wissen sammeln und gemeinsam zu sortieren. Er sollte im selben Moment Menschen einander näherbringen, die hier ihr persönliches Wissen zu Gotha und seinen Bewohnern zusammenbringen.

Kontakt:

Via Facebook: Öffentliche Facebook Gruppe “Der Gotha Zettelkasten”

Am Ort und per E-mail:

Forschungszentrum Gotha der Universität Erfurt
— Dr. Olaf Simons
Schloss Friedenstein
99867 Gotha


Präsentation auf der Gothaer Stadtgeschichte Tagung 2022

2018-11-16/17: Wikibase/Illuminatenorden Data-Mining Workshop: 10 Reisestipendien nach Gotha zu vergeben

[Google translation of this page]

Das Forschungszentrum Gotha veranstaltet jährlich einen „Illuminatenworkshop“ mit dem Ziel, aktuelle Forschung zum Geheimorden der 1770er und 1780er Jahre zu bündeln.

Nachdem wir dieses Jahr in einer Kooperation mit Wikimedia Deutschland gut 5.000 komplexere Sätze von Metadaten zu den Akten des Illuminatenordens in einer Wikibase-Instanz verfügbar machten, möchten wir mit diesem Aufruf Wikidata-Enthusiasten einladen, gemeinsam mit Forschenden einen ersten Blick in diesen Datenschatz hinein zu wagen.

  1. Welche Visualisierungen (Netzwerke, Timelines, geographischen Erfassungen…) lassen sich aus dem Datenmaterial ziehen?
  2. Wie müsste man die Daten strukturieren, um noch ganz andere Forschungsfragen anzugehen?
  3. Wie lässt sich das dieses Datenmaterial am besten mit Volltext-Transkripten von Dokumenten verknüpfen?
  4. Wie kann unser bisheriges konventionelles Wiki – die Gotha Illuminati-Research Base – aus der Datenbank Information beziehen?
  5. Wie modellieren wir Datenobjekte auf einem Kurs, der Informations-Redundanzen vermeidet?
  6. Wie würde man Daten eingeben, um Zeitschnitte (und Repräsentationen auf alten Landkarten) zu bewerkstelligen?
  7. Wie gelingt es uns, unsere Reasonator-Integration klug in Richtung eines mehrsprachigen, Übersichtlichkeit generierenden Informationsangebots zu nutzen?
  8. Wie machen wir unsere Arbeit optimal im Wikidata-Universum nutzbar?

Unser diesjähriger Workshop soll Datenanalyse und Forschung zusammenbringen. Mitspieler, die sich mit SPARQL Datenbankabfragen und Visualisierungen auskennen, wollen wir einladen, mit der Forschung ins Gespräch zu kommen. Wir haben die Daten, die Datenbank und detailliertes Wissen über die die Aktenlage des Illuminatenordens mit seinen gut 1350 Mitgliedern und Tausenden von internen Dokumenten, um das Data-Mining spannend machen –, aber erfassen im Moment kaum, welche Aufschlüsse uns unser eigenes Material in der ganz neuen technischen Erschließung gibt. Wir verfügen über Erfahrung mit unserem bisherigen Arbeitsinstrument, einem konventionellen Wiki, aber erfassen im Moment gerade in Ansätzen, was uns das komplexere Medium der Wikidata-Technologie an hinzukommenden Optionen der praktischen Arbeit liefert.

Wer am wissenschaftlichen Programm im ganzen Umfang teilnehmen will, kann am Freitag den 16. November 2018 ab 9:00 am Forschungszentrum Gotha in unsere Forschungsdiskussionen Einblick nehmen.

Der Data-Mining-Workshop, dem die vorliegende Einladung speziell gilt, wird am Nachmittag Forschende und Wikidata-Kenner zusammenbringen. Die Veranstaltungen werden im Verlauf des Nachmittags getrennt in einen Wikibase Bastel-Workshop und in die Serie der spezifischeren Fachreferate.

Ein gemeinsames Abendessen ist für 19:00 angesetzt. Das Forschungszentrum steht Bastelwütigen indes danach noch die ganze Nacht offen.

Am zweiten Workshop-Tag wollen wir gegen 11:00 die Gruppen wieder zusammenführen, um voneinander zu lernen:

  • Was können Forschende aus der Datenbank gewinnen?
  • Was wünschten sich Datenbankenthusiasten an Forschungsarbeit, um im Data-Mining wesentlich tiefer einsteigen zu können?
  • Wie würde man ein größeres Aktenerschließungsprojekt mit dieser Datenbank am besten organisieren?

Wir können Reisekosten (unter der sich entwickelnden Etatlage sicher aus dem deutschsprachigen Raum), Unterbringung und Tagegelder übernehmen. Teilnahmewünsche sind mit eingehenderen Aussagen zu Arbeitsinteressen bis zum 5. November 2018 zu richten an olaf.simons@piere-marteau.com.


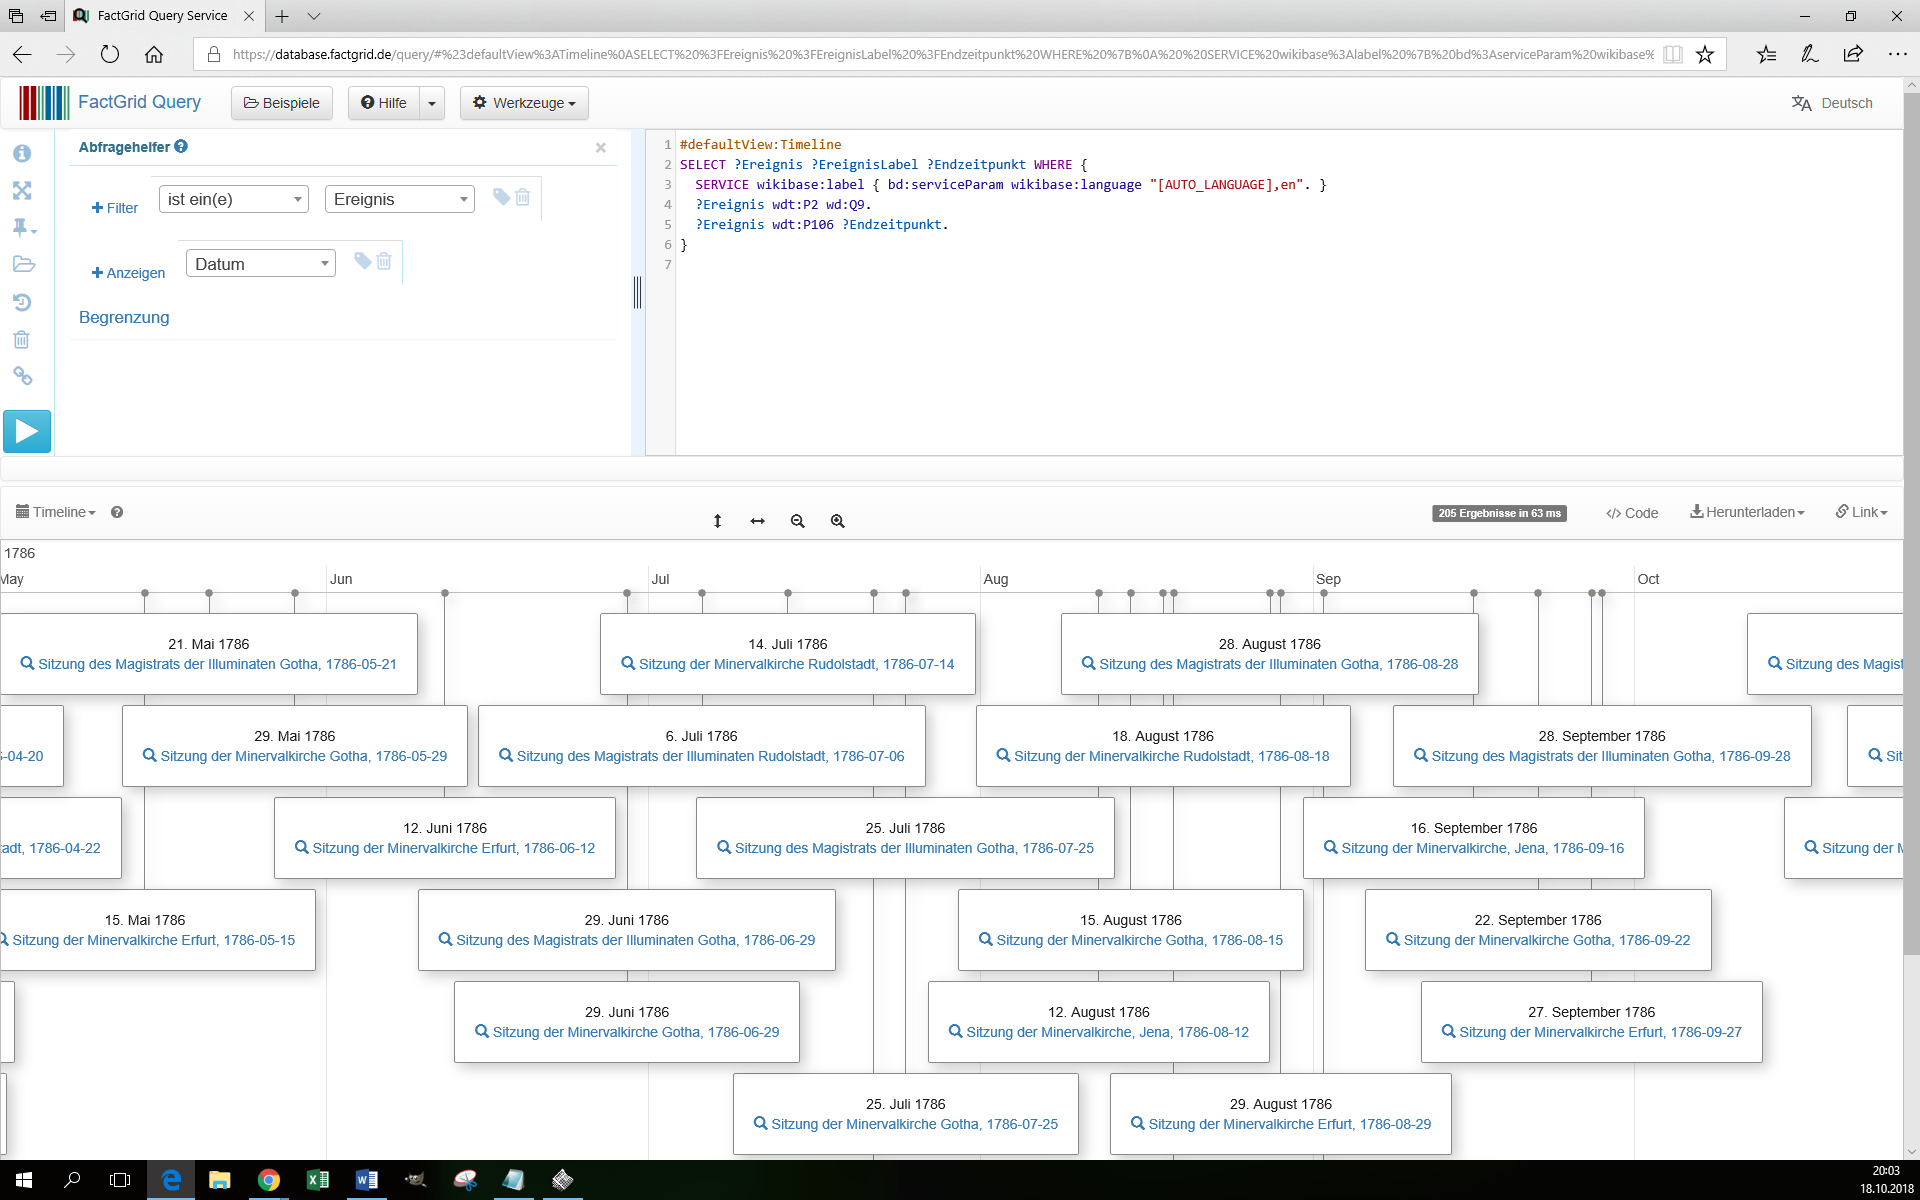
Erste Suchen und Visualisierungen zur Anregung

Sample queries: https://database.factgrid.de/wiki/Sample_queries

Further Reading

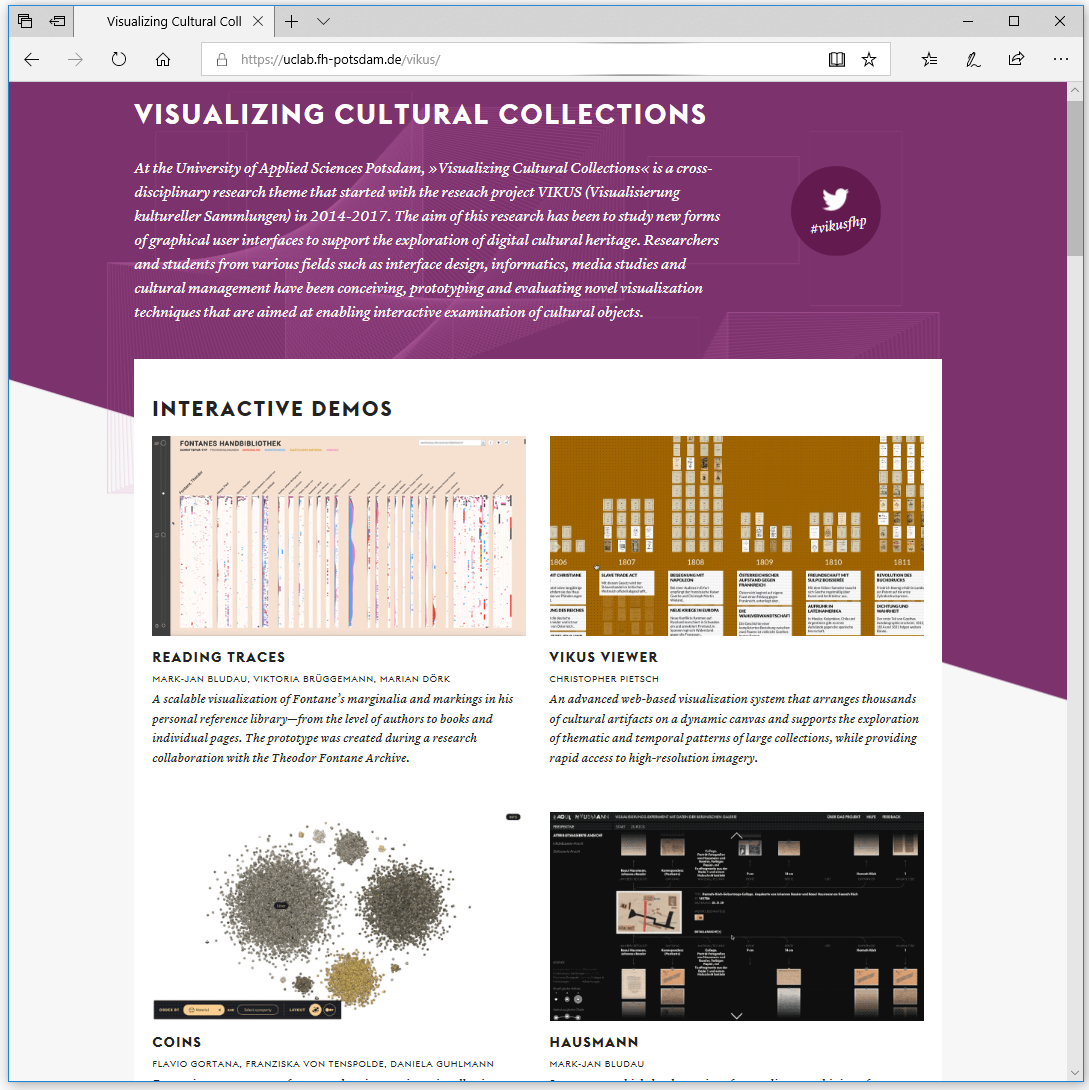
https://uclab.fh-potsdam.de/vikus/
VISUALIZING CULTURAL COLLECTIONS At the University of Applied Sciences Potsdam, »Visualizing Cultural Collections« is a cross-disciplinary research theme that started with the reseach project VIKUS (Visualisierung kultureller Sammlungen) in 2014-2017. The aim of this research has been to study new forms of graphical user interfaces to support the exploration of digital cultural heritage. Researchers and students from various fields such as interface design, informatics, media studies and cultural management have been conceiving, prototyping and evaluating novel visualization techniques that are aimed at enabling interactive examination of cultural objects.
more

As the last point makes it clear, the actual usefulness of the data comes with its use. Either in the form of services that are targeted at end users or by providing insights that are turned into stories that can be shared. To create a flourishing ecosystem of Wikidata-based applications running on high-quality data, a critical chicken-or-egg problem needs to be overcome: without complete and high-quality data, there are no cool apps. But without interesting apps, there are few incentives to provide data and to improve its quality. In other words: the main drivers of data quality and completeness are interesting and widely used applications, while the motivation to develop good apps is far greater if they can build upon a high-quality and complete data bases. In this article we will present a few of the things the Wikidata community is doing to address its chicken-or-egg problem.


  • Georgie, If you want to know more about how Academics are using Wikidata in Network Analysis research, here is our full Q+A with the University of Colorado. 2018-10-16 https://medium.com/

We started running SPARQL queries this summer. We are still experimenting with extracting data from the information we entered over the past year.

One example we tried was looking at House member ideology by occupation. Below shows the ideology of three occupations: athletes, farmers, and teachers (in all roughly 130 members).

The x-axis shows common ideology (liberal to conservative) and the y-axis shows member’s ideology on non-left/right issues such as civil rights and foreign policy. The graph shows that teachers split the ideological divide while farmers and athletes are more likely to be conservative.

House member ideology by occupation


Wikidata is the collaboratively curated knowledge graph of the Wikimedia Foundation (WMF), and the core project of Wikimedia’s data management strategy. A major challenge for bringing Wikidata to its full potential was to provide reliable and powerful services for data sharing and query, and the WMF has chosen to rely on semantic technologies for this purpose. A live SPARQL endpoint, regular RDF dumps, and linked data APIs are now forming the backbone of many uses of Wikidata. We describe this influential use case and its underlying infrastructure, analyse current usage, and share our lessons learned and future plans.

Image Source

Arthur Kampf (1864 Aachen – 1950 Castrop-Rauxel), Der Zeitungsleser, Oil on Canvas. 70,5 x 60,5 cm (1908), from: https://www.lempertz.com

The Illuminati Files Online: Some remarks on the FactGrid’s first – roughly 16,000 – datasets

German Version

The FactGrid (still lacking a unique design) has, over the last six weeks, just received its first project data – data from Halle’s and Gotha’s Illuminati research of the last 20 years, which I will briefly outline in the following. Some of the datasets are still lacking the complexity we are aiming at, others have gained quite some depth:

We are presently listing some 2,000 people, about 1,350 of whom have been Illuminati members in the 1780s; the rest are mostly people mentioned in the correspondences which we are trying to map. We are hesitating here with the far more complex biographical input which he have in store, since this would be better done in joint ventures with the GND and with Katrin Möller, university of Halle, who has become the leading expert on 18th-century careers and professions. We are negotiating in both directions. Our roughly 2,000 titles of research on the Illuminati come in equally rudimentary sets. Again, we have realized that it would be more interesting to base this work on library catalogue norms from the outset.

But we are quite detailed with the more than 9,000 documents currently associated with the original Illuminati: documents that survived with the publications of Illuminati documents by the Bavarian state of 1786 and 1787 and with the archives of Adam Weishaupt, Johann Joachim Christoph Bode, of Gotha’s first lodge “The Compass”, and of Ernest II of Saxony-Gotha-Altenburg.

Some 3,000 of these documents received detailed and complex metadata on our database; they will shed light on Gotha’s Illuminati research of the last five years. Led by Martin Mulsow, Markus Meumann and I have been mapping and analysing Illuminati Essays collected in the “Schwedenkiste”, the famous “Swedish Box”. Our work had started with volume 13 and had soon moved beyond. Junior scholars had joined us with their research. Christian Wirkner dealt excessively with the minutes of the meetings collected in volume 15 and with exemplary strands of “Quibus Licet”/“Reproch” communication which the Order had designed to guide its members. Gotha’s research comes therefore with an emphasis on volumes 11 to 16 of the “Swedish Box”

The Gotha Illuminati Research Base, a conventional MediaWiki which we had set up in order to organise the team’s research became within a year of its existence the pool of ongoing work for the entire (small) community of Illuminati researchers. It attracted the first massive external data inputs: Hermann Schüttler offered us a list of members which he eventually connected with biographies to all our documents. He moved on with a technological relic: an Access database of the research he and Reinhard Markner had conducted for the two volumes of The Illuminati Correspondence (published in 2005 and 2013 respectively). These data are now the deeper layer under the special qid Item: Q11305.

Schüttler provides the following overview of this special database:

1. What is in it? Letters collected by a) Adam Weishaupt now located Hamburg’s State Archive, as deposit of the “United Five” (lodges) Hamburg, and b) the of the “Schwedenkiste”, – collected here by Johann Joachim Christoph Bode and augmented by Ernst II. of Saxony-Gotha-Altenburg, now located in the Prussian Privy State Archives, Berlin (formerly located in State Archive of the GDR, Merseburg). We have added any materials of the Illuminati context from other sources, where we could spot them.
2. Who has been working on this from when to when? The data was collected during the years of the IZEA project between early 2000 and mid-2005 by Hermann Schüttler and have been partially supplemented by Reinhard Markner.
3. Which archives have been visited? Hamburg’s State Archive, the Prussian Privy State Archives, Berlin, the Bavarian Main State Archives, Munich (Weishaupt letters in the “Kasten Schwarz” collection), the Palatine State Library, Speyer (collection Schwanckhardt).
4. Which publications are linked to this? The titles, which are listed under the qid Item: Q11305.

For the first time, the FactGrid can therefore present the tip of the iceberg of the Illuminati files online. Future projects will be able to add to this now that the grid is laid out – but we could also enter a far more dynamic process offering the digitized documents together with the metadata we have here collected. This will only be conceivable in a project for which the Grand Lodges and the archives involved remain to be won.

The creative part of the work can now begin

Compared to the previous MediaWiki, the FactGrid is structurally in one aspect at a disadvantage: The wiki offers transcripts and summaries of hundreds of documents and sessions of the Order (see here what we did with Document 70, Schwedenkiste volume 13 in our conventional Wiki and see here the respective database record: Item:Q6641). It would be exciting to make the transcripts available in the database itself. We will write out two work contracts, on the one hand to bring database information into the conventional wiki – on the other hand to develop a concept of how we could use the FactGrid as our sole repository for data, extended digests, transcripts and media files.

The database is otherwise far superior to the previous MediaWiki: It creates the grid which future research can use while it is opening the door to the data mining that can now begin. One will now be able to map the entire work of the Order between the late 1770s and 1788 (as far as it is still documented). It will be possible to examine membership careers (as soon as we get on with the personal data in greater detail): Who got into the Order on whose proposal? What kind of networking did members unfold within the Order at what stage of its brief existence?

The project will now need groups to bring their own research into the database. It should at the same moment begin to attract “data scientists” and “data visualizers”. And, of course: We are immensely curious about what information others will make visible where we can only offer our gut feelings and sketchy ideas of personal networks that developed in this web. The FactGrid blog will be a good place to present data analytics, which SPARQL enthusiasts can now do far better than the researchers behind the data resource.

More

In alphabetical order: Lorenza Castella, Erik Liebscher, Reinhard Markner, Markus Meumann, Martin Mulsow, Hermann Schüttler, Olaf Simons and Christian Wirkner

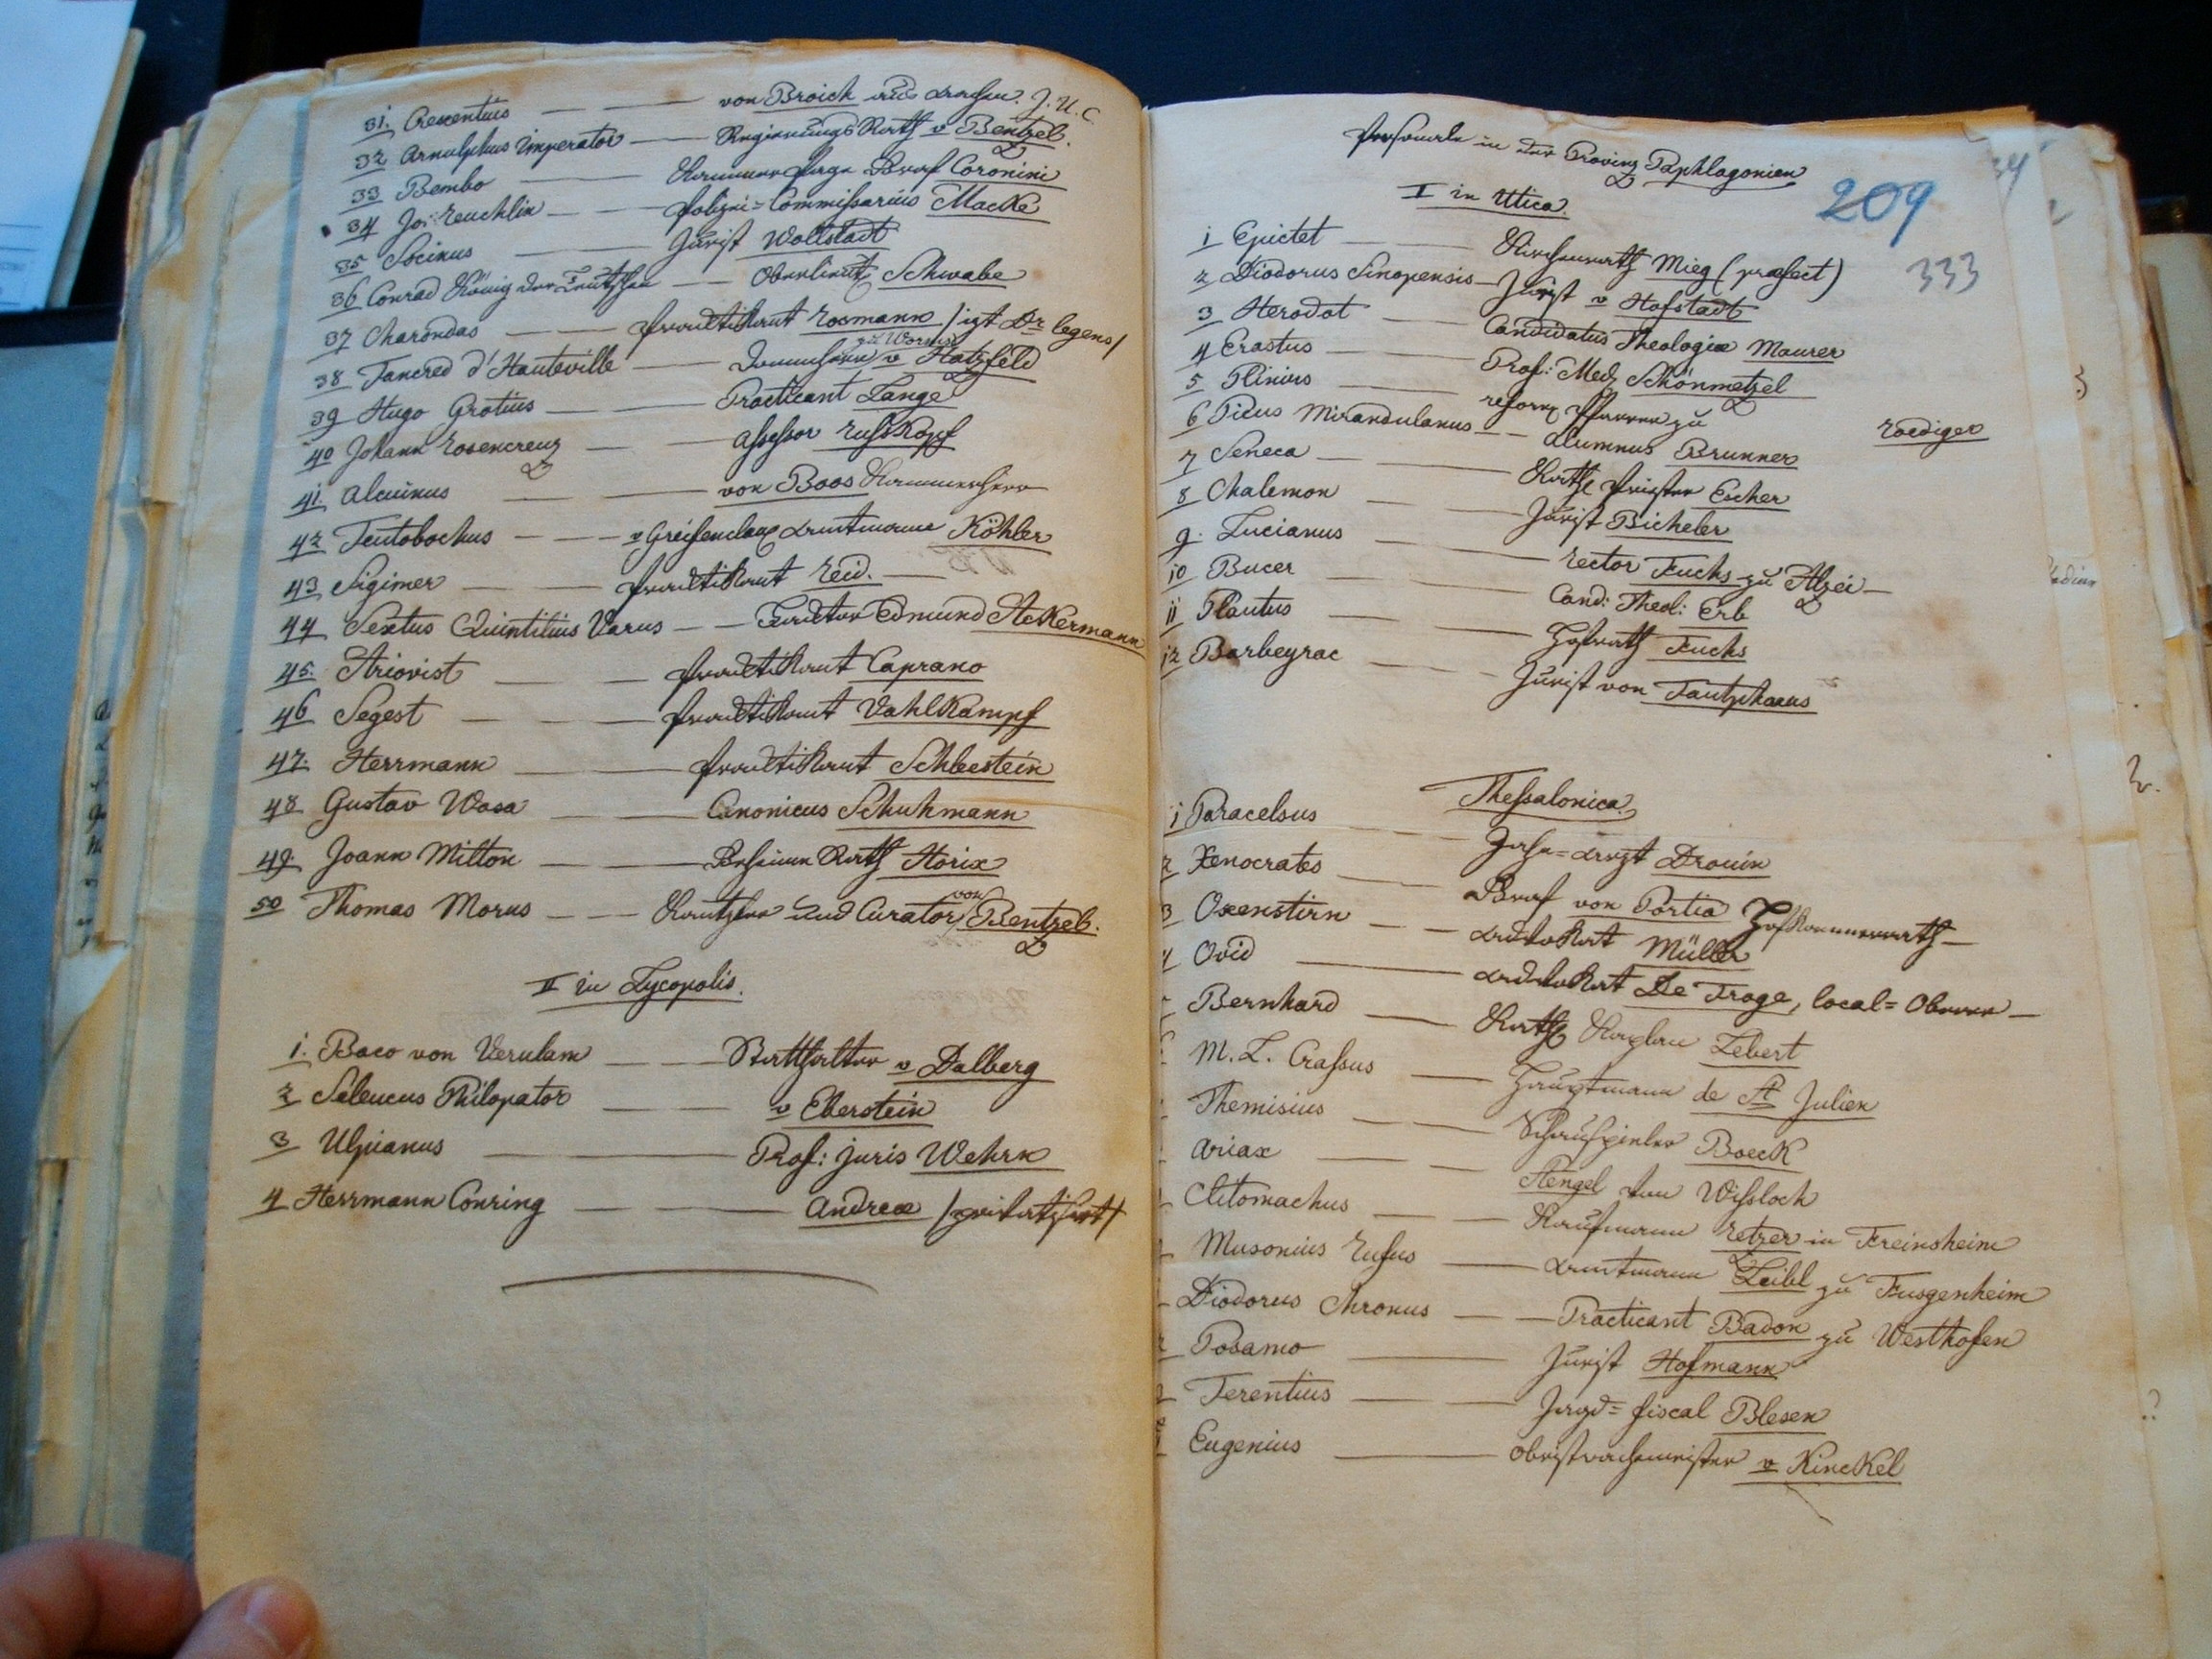
Featured image: Item: Q4545 last page and Item: Q4546 first page: The membership code names used by the Minerval churches of Frankfurt (Epidamnus, continuation from the previous page), Lycopolis (Erfurt), Heidelberg (Uttica) and Thesalonica (Mannheim).

Die Illuminatenakten Online: Einige Bemerkungen zu den ersten knapp 16.000 Datensätzen des FactGrid

in English

Das FactGrid (noch immer ohne ein eigenständiges Design) erhielt in den letzten Wochen seine ersten Projektdaten – Daten aus der Illuminatenforschung Halles und Gothas der letzten 20 Jahre, die hier kurz umrissen seien.

Rudimentär sind in diesem Stadium noch die Datensätze zu den gut 2.000 gelisteten Personen. Etwa 1.350 von ihnen waren Illuminaten, die übrigen zumeist Personen, die von ihnen in Briefen erwähnt wurden. Wir schrecken im Moment vor der Eingabe der uns vorliegenden runderen Datensätze zurück, da sie weit interessanter in einer Kooperation mit der GND und unterstützt durch Katrin Möllers Hallenser Projekt zu Erwerbsbiographien geschähe. Verhandlungen in beide Richtungen laufen. Rudimentär sind im selben Moment auch die gut 2,000 Titel Forschungsliteratur zum Illuminatenorden gelistet. Auch hier wurde uns klar, dass es interessant wäre, diese Arbeit von vornherein an bibliothekarische Katalogsysteme anzulehnen.

Im Zentrum bietet das FactGrid indes nun die gut 9.000 Dokumente, die aktuell in Forschungskreisen mit dem Illuminatenorden und ihren Aktenkonstellationen in Verbindung gebracht werden: Dokumente aus den Nachlässen Adam Weishaupts, Johann Joachim Christoph Bodes, der Gothaer Loge „Zum Compaß“, Ernsts II. von Sachsen-Gotha-Altenburg, sowie der 1786 und 1787 geschehenen Veröffentlichungen aus Bayern.

Etwa 3.000 dieser Dokumente sind sehr viel eingehender erfasst. Sie geben in ihrer obersten Schicht Einblick in Gothas Illuminatenforschung der letzten fünf Jahre: Unter der Projektleitung Martin Mulsows untersuchten Markus Meumann und ich von Nachwuchsforschern unterstützt „Illuminatenaufsätze“, mit ihrem Schwerpunkt im 13. Band der „Schwedenkiste“. Unsere Arbeit griff schnell in die benachbarten Bände aus. Christian Wirkner erschloss dabei in mehreren Schüben die Sitzungsprotokolle sowie einzelne Stränge der Betreuungskorrespondenz zwischen Mitgliedern und den „Unbekannten Oberen“ – den Austausch von „Quibus Licet“ und „Reprochen“. Der Gothaer Schwerpunkt liegt mithin in den Bänden 11 bis 16 der „Schwedenkiste“.

Das von uns aufgebaute „Illuminatenwiki“, die Gotha Illuminati Research Base, wirkte unerwartet in die Forschung hinein. Mit ihm kamen die Datensammlungen Hermann Schüttlers und Reinhard Markners ins Gehege, die bis in das Jahr 1998 zurückgehen. Hermann Schüttler publizierte 1991 das erste Kompendium zu den Mitgliedern des Ordens (und arbeitete diese bereits in die Gotha Illuminati Research Base ein: Die Mitglieder des Illuminatenordens). Gemeinsam mit Reinhard Markner erschloss er ab 2000 in großem Umfang die Ordenskorrespondenz. Eine Access Datenbank kam aus seiner Hand von hier aus in das Startangebot für das FactGrid – im FactGrid regulär mit der qid Item:Q11305 als Forschungsleistung ausgewiesen:

Hermann Schüttler zu diesem Datenbestand:

1. Was ist drin? Briefe vor allem aus a) dem Teilnachlaß von Adam Weishaupt im Staatsarchiv Hamburg, Depositum der „Vereinigten Fünf“ (Logen) Hamburg, sowie b) der „Schwedenkiste“, d.i. dem Nachlaß von Johann Joachim Christoph Bode, vermehrt um Papiere von Ernst II. von Sachsen-Gotha-Altenburg im Staatsarchiv Preußischer Kulturbesitz Berlin, zuvor Staatsarchiv der DDR, Merseburg. Dazu vereinzelt Material mit eindeutig illuminatischem Bezug verschiedenster Provenienz.
2. Wer hat wieviel von wann bis wann daran gearbeitet? Die Daten wurden während der Laufzeit des Projektes im IZEA zwischen Anfang 2000 und Mitte 2005 von Hermann Schüttler erfaßt und danach von Reinhard Markner teilweise ergänzt.
3. Welche Archive wurden besucht? Staatsarchiv der Freien und Hansestadt Hamburg, Geheimes Staatsarchiv Preußischer Kulturbesitz, Berlin, Bayerisches Hauptstaatsarchiv, München (Briefe Weishaupt im Bestand „Kasten Schwarz“), Pfälzische Landesbibliothek, Speyer (Nachlaß Schwanckhardt).
4. Welche Veröffentlichungen knüpfen sich daran? Die Titel, die sich jeweils unter der qid Item:Q11305 zur gesamten hier erbrachten Forschungsleistung gelistet finden.

Das FactGrid kann damit erstmals den Eisberg so halbwegs bemessen und im Projekt der Illuminatenakten Online in den Metadaten vorlegen. Zukünftige Projekte können von hier aus fortfahren. Mit ganz anderer Dynamik ließe sich das große hier angelegte Raster indes füllen, wenn wir mit der Datenbank die Digitalisate aller Dokumente zugänglich machen könnten. Das aber wird nur in einem Projekt denkbar werden, für das die Großlogen und Archive, in deren Eigentum respektive Besitz sich die meisten der Akten heute befinden, noch zu gewinnen bleiben.

Der kreative Part der Arbeit kann damit beginnen

Gegenüber dem bisherigen Wiki ist das FactGrid an einer Stelle strukturell im Nachteil: Das Wiki macht Transkripte und Zusammenfassungen von Hunderten Dokumenten sowie detaillierte Informationen zu Sitzungen des Ordens zugänglich (hier eine Musterseite zu einem Dokument – dem Dokument 70 im 13. Band der Schwedenkiste – im alten Wiki; hier die Datensammlung zum selben Dokument im FactGrid: Item:Q6641). Spannend wäre es, diese Texte und Informationen in der Datenbank selbst verfügbar zu machen. Wir werden zwei Werkverträge ausschreiben, einerseits um das alte Wiki zu entlasten, in dem wir Metadaten großflächig und laufend aktuell aus der Datenbank einspielen. Ein komplementärer Werkvertrag wird der Frage gelten, wie wir das konventionelle Wiki zur Vermeidung doppelter Arbeit im FactGrid (respektive in einer eigens zu gründenden FactGrid Ressource für Objektrepräsentationen) verlustfrei aufgehen lassen könnten (siehe hier die Vorformulierungen zu diesen beiden Werkverträgen).

An einer anderen Stelle ist die Datenbank dem bisherige MediaWiki bei weitem überlegen: Mit ihr ist die verfügbare Materiallage im großen Raster erfasst, in dem sich weiterforschen lässt – und die Tür geöffnet zum Data-Mining. Man wird nun daran gehen können, die gesamte Aktenproduktion kartographisch wie auf Zeitleisten zu erfassen. Man wird (insbesondere sobald die Personeninformationen zu den Berufen detaillierter eingegeben sind) durchleuchten können, wer mit wessen Fürsprachen welche Karrieren im Orden machte und dabei welche Netze des ordensinternen Austauschs generierte.

Gefragt sind damit zum einen Gruppen, die mit eigener Forschung im Feld weitermachen und zum anderen Data-Miner, Datenvisualisierer – und wir sind natürlich gespannt, welche Informationen sie dort sichtbar machen werden, wo wir bislang vor allem Detailinformationen mit dem gröberen Bauchgefühl der Beziehungen im Orden nachgehen. Der FactGrid Blog wird eine gute Adresse sein, um Daten-Analysen vorzulegen, die SPARQL-Begeisterte nun weit besser durchführen können als die Forscher hinter dieser Datenressource.

Mehr

In alphabetischer Reihenfolge: Lorenza Castella, Erik Liebscher, Reinhard Markner, Markus Meumann, Martin Mulsow, Hermann Schüttler, Olaf Simons und Christian Wirkner

Featured Image: Item:Q4545 letzte Seite und Item:Q4546 erste Seite: Die Mitgliederaufschlüsselungen der Minervalkirchen Frankfurt (Epidamnus, Fortsetzung von voriger Seite), Lycopolis (Erfurt), Heidelberg (Uttica) und Thesalonica (Mannheim).

Needed thing #4: A module to state original claims (and published research)

The Problem

Original research means that we will (also) have to deal with statements that have not been published before. So far this is a huge problem for any researcher. Should she make a claim that was never made before – minutes after she found the archival record to substantiate the spectacular claim? You better wait until your book is out – which can take a couple of years, and if you still need a database to do your research you better work on a platform where your work is invisible until then.

The platform with immediate visibility of your work is at the same moment a massive advantage: If you publish the observation minutes after you made it, you will have made your claim and you can from now onwards refer to it. That, however, means that FactGrid claim has to be made publicly, visibly connected to your research, your name, with a specific URL that comes with a publication date.

The FactGrid must be able to turn any statement which is made on the database into a micro publication. You make the claim and you give the source with all the information about you including your evaluation and the details which any future research should continue to offer. The Wikibase Interface of our dreams should offer footnotes on each claim, every note nicely wrapped up for anyone to grab and to repeat in his own texts.

The more complex source attribution will have more advantages: It will allow researchers to fill the database with hypothetical statements. These will be marked as such and enter the test run, for you will now be able to see whether a hypothetical date (for instance) of a letter fuses into the data environment you are creating. You can immediately work with colleagues on a premise where you feared them as rivals who could steal your information.

Model solution

The FactGrid source attribution will have four sections. Users should be guided with drop down menus where possible. We generate a new Q-item to quote in the end:

Section 1: Published elsewhere or original research? (pull down menu plus input fields)

  1. This statement is already publicly circulating. (Input fields:) Q-number of the publication (plus field for more specific reference like a specific page number).
  2. This is original research to be credited as such. (Input fields:) Q-numbers of the researchers or team to be credited (plus date stamp and url to quote the entire module).

Section 2: the evidence

  1. Q-number(s) of the piece(s) of evidence (plus field(s) for detailed reference like page number(s)).

Section 4: evaluation (qualifier to the previous via pull down menu)

  • The claim can be taken for granted with the evidence given.
  • The claim is based on additional conclusions (stated in section 4).
  • No evidence given, yet the claim is generally accepted as fact
  • The claim is obsolete (for reasons discussed in section 4).
  • The claim is/was hypothetical (the assumptions are stated in section 4).
  • The claim is valid within the fictional universe.
  • The claim has a propaganda value.
  • The claim is part of a religious creed (see the discussion of section 4).
  • The claim is personal/family knowledge.

Section 4: discussion (link to the statement’s discussion page)

Use

The source statement will ideally contain all the information needed to (automatically) generate a footnote which can then be used by the Reasonator the FactGrid’s equivalent (see our needed thing #3), in any Wikipedia article or in any other publication referring to the claim.


Published also here: https://www.wikidata.org/wiki/Wikidata:FactGrid/Needed_thing_No._4:_A_module_to_state_original_claims_(and_published_research)

Needed thing #3: An attractive Interface for browsing and reading Wikibase information

The Wikibase software has been designed to serve underneath the +200 Wikipedia installations, it is offering its services in SPARQL-queries but it does not aim at people interested in the facts collected on an item of knowledge.

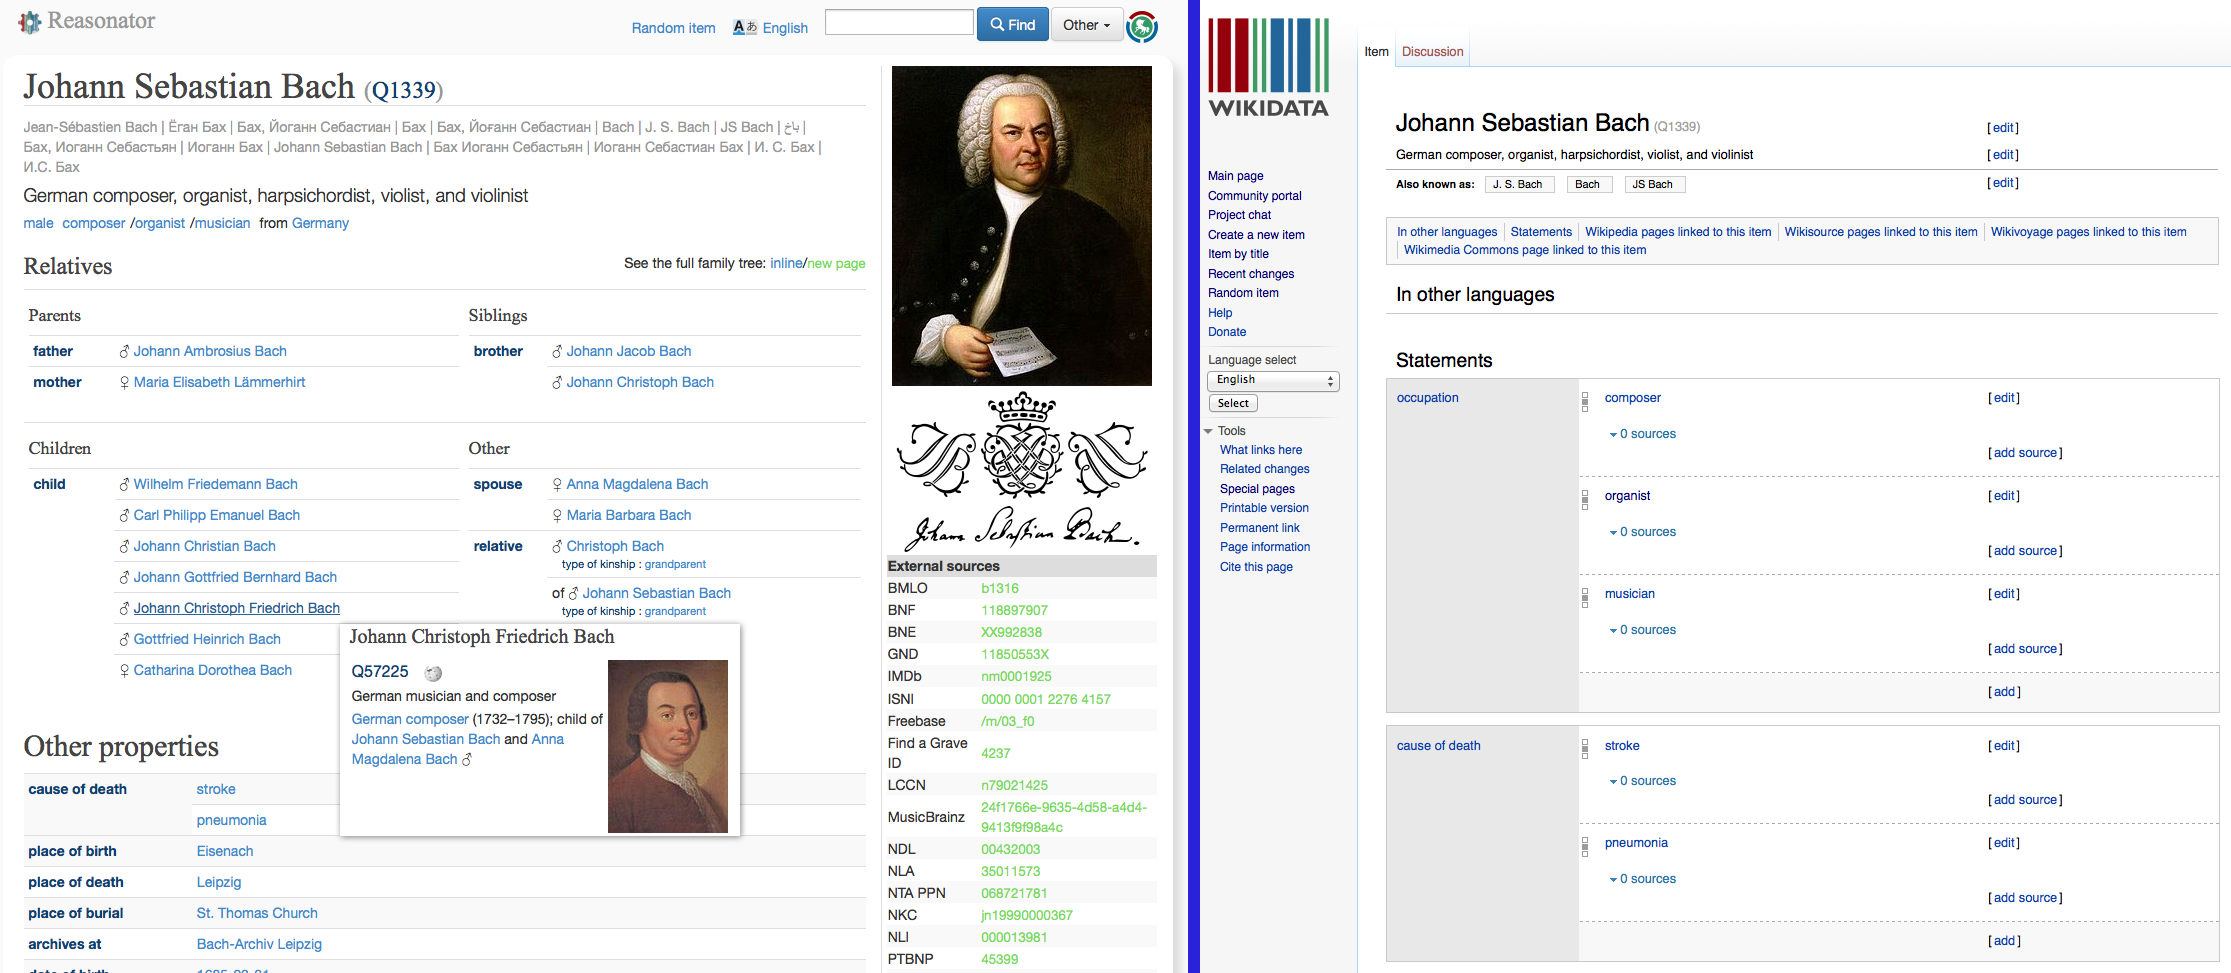
Magnus Manske’s Reasonator is the tool which turns Wikidata information almost into articles – in any language. The page on Q13339, Johann Sebastian Bach is, as it turns out, in many ways superior to the 200+ competing Wikipedia articles on Bach: It has one sinle source to be edited by users world wide. It shows at a single view what it has to offer – you do not crawl through well balanced sentences, which might not at all offer the information you are looking for.

But the Reasonator has its fundamental drawbacks: Technically you are on a platform that uses Wikidata information – not on the global Wikidata interface. Practically and organisation-wise you are on extraterritorial space when it comes to future developments. The Reasonator is Magnus Manske’s dream child. It is not part of the package Wikimedia will develop as the universal Wikidata front-end (because any such front-end would immediately rival the 200+ Wikipedias?)

The following thoughts aim at an “Interface” one would like to have with any Wikibase installation on whose and what technology whatsoever:

What the global “Wikibase Interface” should be able to do (and what it should avoid)

  1. Pages on items of knowledge (i.e. on Q-numbers of the installation) should not rival the written article (with automatically generated language statements).
  2. The interface should focus on the presentation of all the facts on a specific question. Get the first three entries of the list and get the complete list only if you click at more. Use the interface to get all the letters Leibniz has written, all the works composed by Bach, all the people Luther is known to have met plus dates and locations.
  3. An edit option leads from the specific statement on the Interface page to the specific Wikibase input section that is generating the statement.
  4. Users who are reading a biographical Interface page can press “edit via form” and they will be led to an input form for biographies with subsections to open. This is particularly useful on any page with fragmented and sparse information, since Interface readers will not necessarily have a clue what a Wikidata property is, and where to find it. They need inspiration of what questions they possibly could answer. See our Needed thing # 1: The technical solution that enables researchers to create input forms for the specific requirements.
  5. Any statement on the Interface page is referenced on page in a footnote (see Needed Thing #4: A module to state original claims (and published research)) so that users can grab the footnote and get it into the Wikipedia they are writing or into the research paper or book under their hands.
  6. The interface can present media and extended texts. A page on an archival document or 18th-century book must be able to offer the scans and a searchable text transcript (users who detect transcription mistakes must be able to correct the mistakes on the spot, through the interface). See one of our Illuminati-document pages for the requirement to be met.

Magnus Manske’s Reasonator is the Wikidata exploit that has taken the step into the data-driven alternative to Wikipedia articles. We should see the advantages: We leave the world of tediously constructed texts and all the confrontations these texts are bound to sparkle between want to be authors and offended readers. We get information that is actually generated in a global effort – where Wikipedia has been generating national communities so far with all their massive problems. We can aim at complete collections of facts. Do not press for “more” on a subject if you do not want to get the names of all the children Johann Sebastian Bach had – but use this source if that is what you want to know. We leave the debates of the various “notability” wars we are presently leading in or 200+ Wikipedias – the debates on what a respective “community” feels people should know, and what they feel one should not necessarily be bothered with.

We must reach the point where we see that Wikidata has actually merits of its own as a new additional source in the Wikimedia universe – and this is what Magnus Manske’s Reasonator has been doing almost in the shadow so far.

Links & More


Published also here: https://www.wikidata.org/wiki/Wikidata:FactGrid/Needed_thing_No._3:_An_attractive_Interface_for_browsing_and_reading_Wikibase_information

Needed thing #2: A logo and our own design

The facts all contribute only to setting the problem, not to its solution.
        Ludwig Wittgenstein, Tractatus Logico Philosophicus 6.4321

The FactGrid still needs its own cohesive design. The name is a modest allusion to Wittgenstein’s Tractatus and his idea that we see the world through a grid of factual statements. It was not that difficult to correlate this thought with images – looking backwards and a across cultural borders. The blog’s main page uses these changing images with humour and as inspiration.

That, however, is all we have at the moment – leaving a lot to be done. The different software platforms – our blog (WordPress), the Wikibase installation (Wikimedia design), and Magnus’ Manske’s Reasonator child do not really go together design-wise.

  • The project does not have a logo.
  • We are presently using Corbel on the FactGrid’s blog, a font with space to breathe, modern with its sans serif design and yet conservative with its medieval numerals and ligatures… is there an open source alternative? And: do we need to go open source with the font?
  • The database still has the Wikidata design (and basically the design of all the central Wikipedia projects). The blog is more in the direction to go. The database should, however, stay in close contact with its wikibase mother, so that anyone working primarily on the mother project can immediately feel right at home on our platform.
  • The FactGrid’s Reasonator interface should enjoy greater freedom to adopt a unified design since we are here mostly interested in an interface that represents information. We should here go for a design that is open to bigger representations of maps, images, models of objects, since our projects will be forced to produce show cases.

These remarks are will not yet serve as a specified task book, they should rather set a direction.


Published also here: https://www.wikidata.org/wiki/Wikidata:FactGrid/Needed_thing_No._2:_A_logo_and_our_own_design

Needed thing # 1: The technical solution that enables researchers to create input forms

Wikidata’s Wikibase installation has been filled almost entirely in massive automated data inputs. That is probably why input forms were not exactly the first priority.

Our database will focus on researchers and regular users whose tasks will call for modules which they can get used to. The historian might sit in an archive with the task to register some 200 documents of a law case. The documents have to be dated, information about authors, the institutions, and addressees has to given on each document. The private user might want to give biographical information about a distant family member with the aim to augment his family’s genealogy. Both are used to input forms. They will never have heard of “triples”, their ideas of “properties” will be inappropriate, they will not be able to use complex Excel-commands in order to prepare an input via QuickStatements.

Requirements

What we need is a technology which enables projects to create their own input forms:

  1. Research projects must be able to define and modify such input forms – using the properties they have created or found on the database.
  2. It should be possible to define and explain the particular input field – whether this field calls for an item (with a Q-number), a date or a numeric value etc. Predefined pull down menus will be particularly useful in a lot of cases.
  3. The ideal input form will give indications whether an item is already in the database by auto-completion and through suggestions.
  4. The tool should be able to create database items with new Q-numbers on a first input.
  5. It must be possible to return to a form and an item of interest once fresh information can be added so that bigger teams or a crowd can work in successive sessions on the same items. The Q-number could be the entry point.
  6. We should be able to nest forms, that is to include specific modularised forms in a bigger form: A biographical input will open with basic questions and it will then offer specific modules on the genealogy, places the person has lived and visited, education, degrees, memberships or works. A membership module for the Illuminati will differ from a membership module for the British House of Commons since being a member will raise altogether different questions in either case. The option of specific modules is necessary since we might get rare but complex options of interest to specialists only and since we should be able to duplicate entire modules: If a person is employed by different companies we get the same questions open again: From when to when? Which company? Where stationed? What position? What salary?

Use cases

Biographies will be the most interesting test field. Most users will have augmented their own CVs with biographical information more than once in their lives.

The document description will be the most interesting input form for historians to use – and a use case of its own practical value. We would test here the use of the database at the entry point where knowledge is produced with a tool that should be more handy than the usual individual word files which researchers are using for excerpts and random bits of information. The FactGrid document description could be used by archives in turn to gain the metadata users usually generate for their own purposes.

Status

Erfurt University funded a prototype development (see: https://database.factgrid.de/wiki/Web_Forms). We became able to generate input forms on the platform, smoothly using any properties a research team would gather on a specific module. It turned out to be more difficult to access such a form again at a later stage (as described in requirement 5 above).


Published also here: https://www.wikidata.org/wiki/Wikidata:FactGrid/Needed_thing_No._1:_The_technical_solution_that_enables_researchers_to_create_input_forms