2018-06-11/12: Daten in das FactGrid füllen — praktischer Workshop der Gothaer Forschungsstelle Illuminatenforschung

Liebe Erfurter und Gothaer FactGrid Interessierte,

in den letzten Wochen arbeiteten wir im engeren Kreis an der Einrichtung einer WikiBase-Instanz (der Software hinter dem Wikidata-Projekt) auf dem Server der Uni Erfurt: https://database.factgrid.de/

Es gab einige technische Schwierigkeiten bei der Anpassung der Tools an die neue Server-Umgebung zu bewältigen, doch sind wir seit einigen Tagen soweit, dass die Grundausstattung läuft: QuickStatements steht für den massenweisen Datenimport zur Verfügung. Der Query Service läuft, so dass wir SPARQL-Abfragen von Daten hinkriegen. Das Design (Logo etc.) ist noch offen – was im Moment den Vorteil hat, dass alles wie bei Wikidata aussieht. Matti Blume arbeitet daran, die Datensätze des Illuminatenprojektes für den Projektstart in die Datenbank zu füllen.

Vom Montag den 11. auf Dienstag den 12. Juni 2018 wollen wir gemeinsam mit Matti Blume und Sandra Müllrick am Forschungszentrum Gotha einen Workshop veranstalten, auf dem er praktischen Unterricht in der Befüllung der Datenbank erteilen wird:

  • Wie verändert man einzelne Daten?
  • Wie fügt man über QuickStatements Datenmassen in die Datenbank ein? (Auf dieser Seite ein paar Tutorials: https://factgrid-tools.geschichte.uni-halle.de/blog/archives/811)
  • Wie legt man dazu Properties (Eigenschaften) für Items an?
  • Wie organisieren wir unsere Properties am besten (von dem weit größeren Wikidata-Projekt lernend)?

Projekte, die am Forschungszentrum Gotha und an der Uni-Erfurt im Feld Geschichte und den benachbarten Kulturwissenschaften Datenbankleistung suchen, sind eingeladen, hier praktische Einblicke zu gewinnen. Hilfskräfte, die uns beim Betreuen der Ressource in Zukunft zur Verfügung stehen wollen (und Interesse an den Digital Humanities für die eigene spätere Arbeit haben) betrifft dieselbe Einladung.
Wir werden am Montag einleitend die Software vorstellen und im Austausch mit den Anwesenden ausloten, zu welchen Projekten sie sich eignet. In einem zweiten Arbeitsblock wird es darum gehen, vorbereitete Daten in die Datenbank zu füllen und die Arbeit zu überprüfen. Das wird im Wesentlichen auch das Programm für Dienstag sein, nun mit dem Ziel, Unabhängigkeit bei der Arbeit mit der Datenbank zu gewinnen. Die Uhrzeit für den Beginn der Veranstaltung Montag-Vormittag/Mittag wird im Vorfeld bekannt gegeben.

Die Weitergabe dieser Post an Datenbank-Interessierte ist ausdrücklich erwünscht. Für Voranmeldungen bis zum Mittwoch, den 6. Juni wären wir dankbar, auch für persönliche Notizen zur Hardware: Die Software lässt sich vom Laptop (über Eduroam) bedienen. Wir wollen zusehen, dass wir Computerarbeitsplätze im Forschungszentrum für die Teilnehmer frei halten.

Mit den besten Grüßen,
Olaf Simons

[per e-mail distribuiert]

Zeitplan

Montag, 11. Juni, Pagenhaus des FZG, Seminarraum

(13:15 – 13:40) Olaf Simons: Begrüßung. Kurze Projektgeschichte, eingehenderer Blick auf die Datenblättern aus dem Illuminatenprojekt, die das erste Unterrichtsmaterial geben werden.

(13:45 – 14:15) Sandra Müllrick: Eine kurze Vorstellung von Wikidata und der Wikibase Software. Die Datenbank, die Benutzer editieren können. Versionsgeschichte, Transparenz aller Editiervorgänge über Recent Changes. Triples als Statements. Abfragen über SPARQL, mehrsprachige Datenblätter im Reasonator. Was kann eine Datenbank, was ein reguläres Wiki (wie wir es im Illuminatenprojekt hatten) nicht kann?

(14:25 – 14:45) Praxisteil 1: Wie geht man strategisch vor, wenn man Tabellen aus einem Forschungsprojekt vor sich hat und diese in eine Wikibase Datenbank überführen will? Wie legt man Properties an? Wie behält man Überblick über schon existierende Properties? Wie geht man strategisch vor, wenn man einen solchen Datenberg einarbeiten will?

(15:00 bis zum Erschöpfungsbeginn) Praxisteil 2: Koordinierter Versuch, möglichst viel unserer Daten über QuickStatements in das System zu bringen. Wenn man Tabellenspalten in massenweise Triples überführt – wie legt man die Items an, wie die Properties? (Tutorials unter anderem hier: https://factgrid-tools.geschichte.uni-halle.de/blog/archives/811). Aufgaben für Einzelne oder Zweiergruppen.

Gemeinsames Abendessen

Dienstag, 12. Juni, Pagenhaus des FZG, Seminarraum, respektive Hauptgebäude, Besprechungsraum

(9:00 – 10:30, FZG Hauptgebäude, Besprechungsraum) Planungstreffen: Sandra Müllrick Mitglieder des Forschungszentrums und der Forschungsbibliothek. Projektpläne. Welche Entwicklungen können wir aus eigenen Mitteln finanzieren – wo brauchen wir (etwa bei der Suche von Werkvertragsnehmern) Hilfe von Wikimedia, respektive der Community? Welche Entwicklungen würde Wikimedia gerne anstoßen?

(Parallell 9:00 – 11:00) Praxisteil 3: Fortsetzung von angefangenen Eingaben und individuelle Beratung, insbesondere falls Mitspieler eigene Datensätze in die Datenbank bringen möchten.

(11:15 – 12:00) Praxisteil 4: Wo befinden sich die eingegebenen Daten nun? Was kann man mit ihnen bereits machen? Vielleicht finden wir einige interessante SPARQL-Abfragen.

(12:30 – 13:00) Resümee: Ideen, Desiderate, Pläne.


Google Spreadsheets and Illuminati Project Data

Dataset Google Spreadsheet Content What could be visualised? Web Form to build
Documents produced in the Illuminati Order Mostly Schwedenkiste, Illuminati materials from various archives and those documents that were already published in the late 1780s Network information. Caution: We are operating with fragmented and highly selective data. Describe an archival document
Illuminati members and others A list of the c. 1350 members of the order (including names belonging into the wider context), mostly research (stated in col. AJ) by Hermann Schüttler (2016). — The geographical spread of the Order on the central European map: col. AB to be matched with col. AG
— Already existing Wikidata and GND data sets linked in cols. M and N.
— Age structure of the members col. AC
— Percentage of aristocracy cols. J-L
Write a CV
The order had a complex grade system that created careers within the order, people could also get into different official positions Give information about an Illuminati career
Illuminati Events Mostly protocols of gatherings of “Minerval Churches” under Bode’s supervision. (Missing: Hermann Schüttler’s information about gatherings of the “Minerval Church” in Frankfurt/Main) Give information about a session (as type of an event)
Organisations
Publications  from: Forschungsliteratur

Bildnachweis

SPARQL — the Query Language

Wikibase installations are – at this moment – best explored with the SPARQL query language. Specialists are able to write queries in SPARQL but this is not what you would do as a beginner. Most people take a look at an example of a query and then modify the example to suit heir needs.

Here just briefly for the beginning a couple of useful links.


Above: SPARQL in 11 minutes. Note: this video is not specifically on using the Wikibase software.

Above: Navino Evans, co-founder of Histropedia (http://www.histropedia.com/), demonstrating how to construct Wikidata Sparql Queries.

Useful First Aid Links

2018-04-23/25, Antwerp — the first Federated-Wikibase-Workshop

Thanks to the initiative of Andra Waagmeester and Daniel Mietchen (who are part of the community that is behind Wikidata incorporating such staggering inputs as the complete human genome) we ventured a first workshop of projects that have begun to use the Wikibase software outside the original Wikimedia/Wikidata environment. The event at Antwerp’s fifteenth-century hospice, now the Elzenveld hotel and conference centre, was generously funded by the European Research Council. The participants came from fields which only this software would bring together: the natural sciences, the humanities, the social and political sphere and Wikimedia. Wikidata, the Wikimedia project in the centre, is about to become the broadest compound in the world of collaboratively produced knowledge. Starting with interconnecting the 290 Wikipedias all around the globe it became able to switch between all their respective languages. Knowing all the equivalents of articles as well as all the unique items which individual communities created on their Wikipedias Wikidata is closer than any comparable compound to theoretically knowing what a father, a cat, a religion or a novel structurally is. The multilingual competence is matched only by the database’s openness to all sorts of items: Wikidata is dealing with bacteria, the Mona Lisa, Chinese politicians, obscure philosophical concepts, mathematical equations, individual genes, geo-coordinates, and all sorts of properties and qualities these items can gain. The software is open to the flexible creation of ever new properties interconnecting the bricks. You can read Wikidata on the Reasonator and you can explore Wikidata with machines. It is open to logic, accessible in ever new SPARQL queries – the search language worth learning.

Why federating specialised Wikibase platforms will be a win/win situation for Wikidata and the emerging sister projects

Wikidata has overtaken the individual Wikipedias as a project attracting masses of specialised data. Anyone can contribute. The input can be done by machines – so why not the complete human genome? It is at the same moment no longer clear whether Wikidata is the ideal place to host such infusions. Should Wikidata risk the input of all the astronomical objects that have been referenced – of billions of stars creating usually little more than a number and the information of the original observation? This is not only a question of the software’s technical abilities; it is far more a question of the communities needed in order to keep the data easily accessible and up to date.

The alternative is the environment of interacting, more or less specialised platforms that use the same software and that exchange data wherever that is of interest. The win/win situation will have more than one dimension:

  • Wikidata is saved from a flood of information which no Wikidata community can offer to keep attractive.
  • The individual platforms can establish their own workflows and professionalised user rights managements.
  • Wikidata would function more as the bridge between various databases, referring to knowledge elsewhere – a uniquely attractive position.
  • The individual platforms would win visibility and sustainability in the compound – with Wikidata as the central supplier and distributor of information used all around the globe.

A wikibase compound to interconnect the emerging community

The workshop was immensely practical. The central product was not a mission statement of a future collaboration with tight pledges and attempts to institutionalise the emerging field. We were far more eager to discuss software problems, development plans, and to share practical experiences.

The two Wikimedia software developers, Adam Shorland and Raz Shuty, entered a sportive hunt for the stream of “tickets” that emerged in the various debates which Wikimedia’s Sandra Müllrick helped to organise in ever new groups.

Instead of the mission statement we created a further Wikibase instance with the primary aim to map all the projects that have begun to use the software. A retrospective timeline came gratis with the register:

Desirables

It was apparent that we had all been facing technical problems. Some of the projects found their own solutions, others tried to engage Wikimedia as the software’s mother. It was clear that we will all learn from each other and we should aim to make the practical know how we are individually gathering accessible to future projects.

Wikimedia’s Wikibase software is more versatile than any other comparable database software on the market: it is prepared to deal with a constant flux of concepts and specifically designed to adapt to open growth but it is not yet addressing “normal” users, users who are not primarily interested in the technical solutions they are getting here. The SPARQL query is a brilliant key to mine information, yet it is not a language a coincidental Google visitor or a professor of history organising his team will be immediately able and ready to use. Projects will face a need to develop conventional interfaces that will then secretly speak SPARQL in its further dealings with the database.

We will face similar needs to develop web forms which regular users can handle to contribute their knowledge.

Wikimedia – this was the encouraging signal Sandra Müllerick, Adam Shorland, and Raz Shuty were giving as a formidable team of problem solvers – is interested in the increased use of its new product. New projects are encouraged to test the software and if that is of use to them: to become platforms in a far wider compound of projects that can do what Wikidata should not aim to do.

Projects creating the new compound should at the same moment embrace the chance to meet, to learn from each other, and to exchange data. Any data exchange will create new perspectives on their respective fields, it will inspire new tools, it will promote their work in the growing environment of data driven research. The Wikibase software will become common over the next decade.

Our conference was a first meeting and an attempt to look across the borders of our respective fields. We decided to stabilise this exchange; a follow up meeting with probably more participants in New York is in the pipeline.

Details & Links

The Participants

  1. Susanna Ånäs (Finnish Name project; Open Knowledge Finland)
  2. Diego Chialva (Policy Analyst, European Research Council Executive Agency)
  3. Davy Cielen (Data Scientist, Contractor at the European Research Council Executive Agency)
  4. Rajaram Kaliyaperumal (LUMC, Leiden The netherlands)
  5. Lozana Mehandzhiyska London (South Bank University & Rhizome)
  6. Daniel Mietchen (Data Science Institute, University of Virginia)
  7. Lyndsey Moulds (Rhizome)
  8. Alexis-Michel Mugabushaka (Policy Analyst, European Research Council Executive Agency)
  9. Sandra Müllrick (Wikimedia Germany)
  10. Nuno Nunes (Maastricht University, Maastricht)
  11. Adam Shorland (Wikimedia Germany)
  12. Raz Shuty (Wikimedia Germany)
  13. Olaf Simons (Gotha Research Centre of the University of Erfurt)
  14. Greg Stupp (Scripps Research Institute)
  15. Elena Toma (Policy Analyst, European Research Council Executive Agency)
  16. Andra Waagmeester (micelio)

Presentations

Links

The (sobering) status report of Friday 13, April 2018

[A version of this was originally posted here]

[Postscript Friday 4, May 2018: SPARQL is on, we are in the middle of our first more massiv data input]

Four months have passed since the kick-off workshop shop, and the FactGrid project has run into its first unexpected problems. We are confident that we will solve the – primarily technical – issues, but one of the lessons we have learned so far is that we will need the support of a larger community in order to situate the FactGrid Project with more impact in the Wikidata-community.

What do we want to achieve? We are still trying to launch a Wikibase installation with the aim to offer a platform for original research. Data hosted on the FactGrid will be free to be used by Wikidata. Data will leave the FactGrid database, however, with the personal authorisations of research which Wikidata is not be able to generate.

Digital humanities projects interested to work on the collective FactGrid platform will sponsor software developments with their respective DH-funding. The cooperation with Wikimedia should make sure that tools sponsored by us will become part of the wider Wikibase software package. We want to prevent island solutions.

What kinds of problems have we been facing? And where do we need you?

Problem 1: The software is free but the vital tools do not work outside the Wikidata environment.

Wikibase is – relatively – easy to install, but the central tools you need in order to get data into and out of the database – QuickStatements and SPARQL – proved to be hard wired to the original Wikidata compound. Lucas Werkmeister has managed to free Quick-Statements from these ties. SPARQL remains on his agenda. We have no idea how tools that use SPARQL (in order to create visualisations for instance) will work once we have the independent SPARQL version. The software problems have blasted our entire schedule.

Problem 2: Getting the first sets of data into the FactGrid.

We have four larger spread sheets of data from the Gotha Illuminati project which we want to use in order to create an attractive show case.

  1. Google Spreadsheet: The Illuminati Files
  2. Google Spreadsheet: The Illuminati and others
  3. Google Spreadsheet: Some first Organisations
  4. Google Spreadsheet: Events referred to in the Illuminati Files

Our data sets are intriguing and able to attract a wider public interest without further advertisement. They should create steam for the engine if we manage to convinced all the parties involved (Freemason, Berlin State Archive, Gotha Reasearch Centre and the Wikimedia Community) to risk a crowd sourced identification of the roughly 6,000 digitised documents which we have been gathering over the last four years. We have underestimated, however, the problems an empty database (a database without any properties and any primary items) is causing.

If you feel cool with QuickStatements and if you think an empty wikibase installation is just the free space you have been dreaming of, join the team and help us to learn how we can use our data with the brilliant software.

Problem 3: We will need a more massive Wikidata and/or GND input.

We will need our own landscape of information ready to be improved if we want to attract other projects of historical research and regular internet users (with wider a genealogical project for instance). A strategist is here needed, someone with ideas how we could (for instance) acquire all the names of people with birth dates between 1400 and 1800 from Wkidata and/or the GND for our database. (To keep the database clean we might focus on basic data like names, birth dates, places of birth and death, and family connections). Wikibase fans who feel you could organise such an import, feel inspired! We would offer you all the freedom of the experiment you would ask for.

Problem 4: We will need something like forms which users can fill in in order to create standardised CVs with the Wikibase software.

Adrian Heine has taken the first steps into this project. Our aim is a Wikibase environment which normal people can correspond with like they have been corresponding with the Wikipedia software so far. You pick a person of your interest and you get a questionnaire with modules (on places and addresses that the respective person has lived, on employments he or she has been in, on the person’s genealogy, on personal contacts we can prove). Wikibase is presently not exactly ready to be edited by normal people.

Problem 5 (a project for the future): Wikibase needs something like a standard Wikibase-Interpreter

Magnus Manske’s Reasonator has been the cool thing on all my presentations of the Wikibase software in DH-circles. You can pick your language and you get an organised data sheet.

Things get difficult if you want to correct or augment the Reasonator’s information sheet; and things get even more difficult if you want to run the Reasonator on your own platform. The development of an immediate interface that produces smooth pages of structured information will be necessary in order to motivate people to gather information for Wikidata (or any affiliate). The Wikibase-Interpreter would be ready to offer the complete knowledge on any field of interest. It would be ready to list all the places a person is known to have visited, all the contacts he or she is known to have had – whether face to face or through letters. Think of the thousands of contacts of the Leibniz’ correspondence – a problem to be solved with pages that give an overview and “more” on the user’s particular request. The Reasonator is, so far not reading Wikidata directly, nor is it part of the Wikimedia software development. Wikidata will need its own Interpreter in order to become an independent source of information – an independent source that also serves all the Wikipedias around the Globe.

We need to change the way we are organising all this

We have been able to offer a couple of grants in 2017 in order to get the project going. We should be able to use the further funding of DH-projects interested in the software and the collaborative platform to inspire if not to fully finance future tools. DH-projects will, however, only risk a cooperation with the FactGrid project and with Wikimedia as the software and data-partner if we manage to offer an attractive show case of what can be done. The Illuminati files are an immensely cool project to begin with. The global interest in these files is huge, everyone has heard of the Illuminati and here you get their most secret files. Visualisations of networks and of the geographical spread of the secret order will find a good test case here. If we should be able to inspire a crowd sourced annotation of all the known documents – that would stir up a global press attention.

We are, however, far from the show case which we could present anywhere at this moment.

2017-12-1/2: Erster FactGrid Workshop in Berlin: Ergebnisse

Das Treffen begann mit wechselseitigen Vorstellungen von Wikidata und dem Illuminatenprojekt (mehr zu Wikidata hier, mehr zum Projekt die Illuminatenakten online zu bringen: hier), eine Etherpad Seite dokumentiert, was an Links in der Runde durchgegangen wurde.

Hier die wichtigsten Überlegungen und Ergebnisse:

1| Das FactGrid muss vorbefüllt werden, insbesondere mit bibliographischer Information

In einer Demonstration korrigierten wir das Todesdatum zu August Bohse (Q760965). Die Korrektur selbst war einfach, die Quellenangabe jedoch umständlich und unbefriedigend: Das Bearbeitungsfeld akzeptiert entweder eine URL (hier hätte man das Google Books-Link angeben können) oder ein bereits bestehendes Wikidata Objekt mit seiner Q-Nummer. Das Datenbank-Objekt zu generieren, war mühselig. Das Ergebnis war zudem ohne viel weiteren Nutzen: Man wird das zitierte Buch so nicht in zukünftigen Buchrecherchen wiederfinden. Bibliothekskataloge nehmen Titel weit komplexer auf, ohne dass man Benutzern diese komplexen Eingaben indes zumuten will.

Das Fazit aus dieser Demonstration war: Wir benötigen im FactGrid eine Vorabfüllung, so dass Forschende hier bereits bestehende Objekte in Beziehung miteinander setzen. Das FactGrid sollte bereits eine breite Basis an

  1. Wikidata-Objekten
  2. GND-Objekten
  3. Bibliographischer Information (namentlich der Nationalkatalogen für die frühe Neuzeit: VD16-VD18, ESTC, STCN aufweisen

Man wird erstens nachdenken müssen, wie man für die historische Datenbank auswählt (das menschliche Genom, das in Wikidata vollständig sequenziert erfasst ist, ist uninteressant, auch will man eher unglückliche Informationsangebote aus der neuen Datenbank heraushalten – man benötigt jedoch etwa zu Personen Grunddaten, um sie eindeutig identifizieren zu können). Man wird zweitens nachdenken müssen, wie man bei der Zusammenführung von Wikidata und GND-Informationen mit Doubletten umgeht.

2| Benötigt: Schicke (spielerische) Werkzeuge zur Ausmerzung von Doubletten

Das Problem taucht beim Anlegen bruchstückhafter Datensätze wieder auf – etwa wenn man aus einem Besucherbuch Namen abschreibt, von denen man nur weiß, dass sie zu einem genannten Zeitpunkt am genannten Ort sich so auswiesen.

Die Lösung wird ein Tool sein, dass Wahrscheinlichkeiten misst. Wie wahrscheinlich ist es, dass zwei Personen selben Namens am selben Tag und in der selben Stadt geboren wurden – und dann etwa auch noch das Sterbedatum und den Sterbeort teilen. Vermutlich kann man bei einer Zusammenführung von Daten automatische von Doubletten riskieren, wenn man dabei die statistische Wahrscheinlichkeit der Identität greifbar macht.

Attraktiv wäre ein Tool, das erwägt, wer wer sein könnte: Bei wem liegt die tentative Information im Bereich der Lebensspanne? Wer ist dagegen auszuschließen, da er an diesem Tag ein Alibi hat? Man kann dann massenweise aus Kirchenbüchern Namen und Daten notieren, Objekte anlegen und später das System nach Vorschlägen der Identifikation befragen.

3| Forschungsprojekten in der Ressource Raum bieten, die eigene Arbeit zu präsentieren

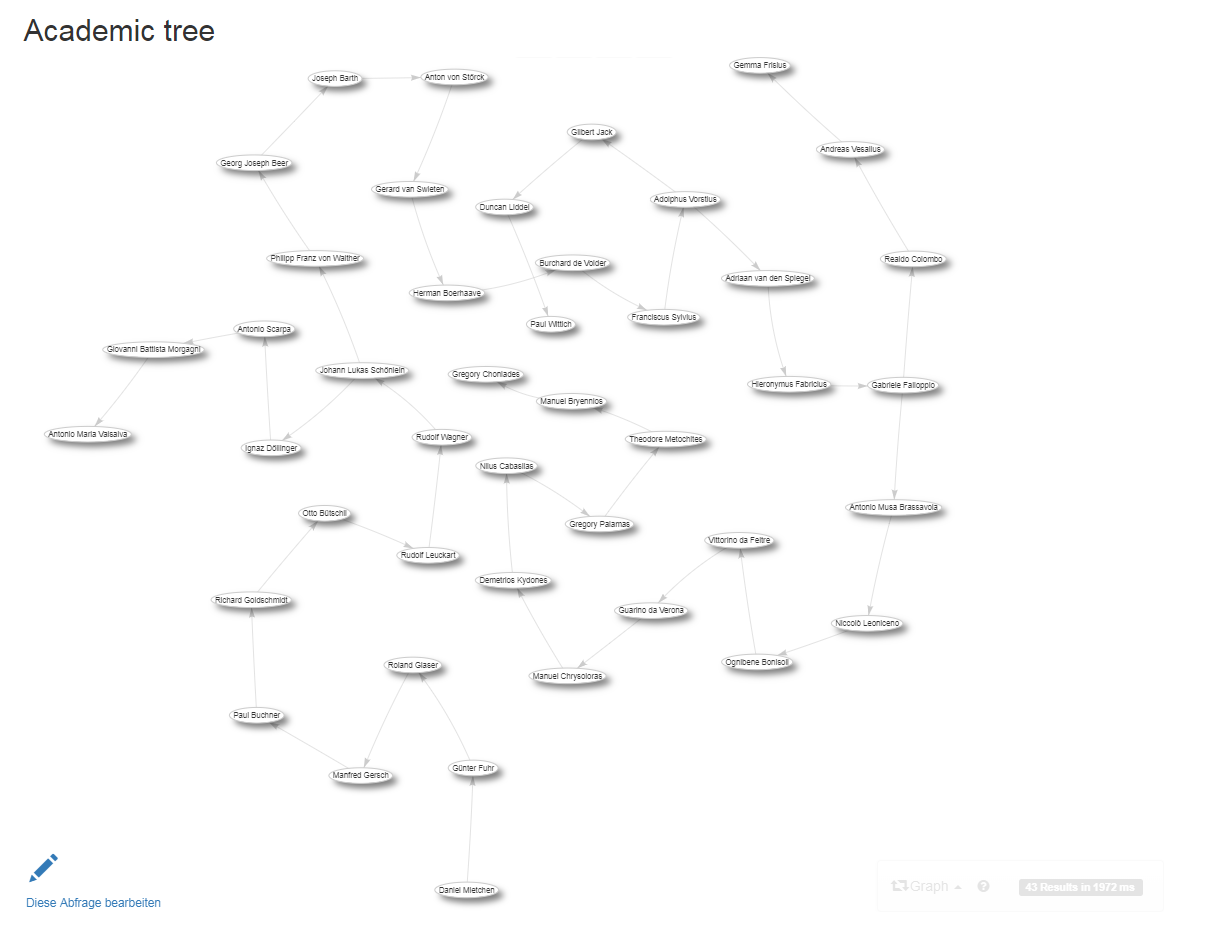
Demonstrationen verschiedener Tools machten klar, dass es bereits wunderbare Anwendungen gibt, die den Rang ganzer wissenschaftlicher Projekte haben könnten. Daniel Mietchen zeigte die Genealogie seiner Doktorväter bis um 1500 zurück:

Screenshot from https://tools.wmflabs.org/scholia/author/Q20895785 / enlarge

Die Entwicklungsrichtung, für die wir uns nach den Demonstrationen entschieden, ist es, vorwiegend mit der Datenbank zu arbeiten und Projekten dabei die Chance selektiver Präsentationen zu geben. Wir werden dafür eine Art Tagging einführen, mit dem Projekte Dokumente und Personen oder (Zeit–)räume ihres Interesses ausmachen können, um dann spezifische Suchangebote innerhalb eines abgesteckten Geländes machen zu können.

4| SQID und Reasonator

Die Entscheidung das „Illuminatenwiki“ langfristig aufzulösen, fiel insbesondere im Blick auf den Reasonator und SQID: Hier die Vergleichsseiten zu Johann Sebastian Bach in den Wikidata-Präsentationen durch beide beide Tools.

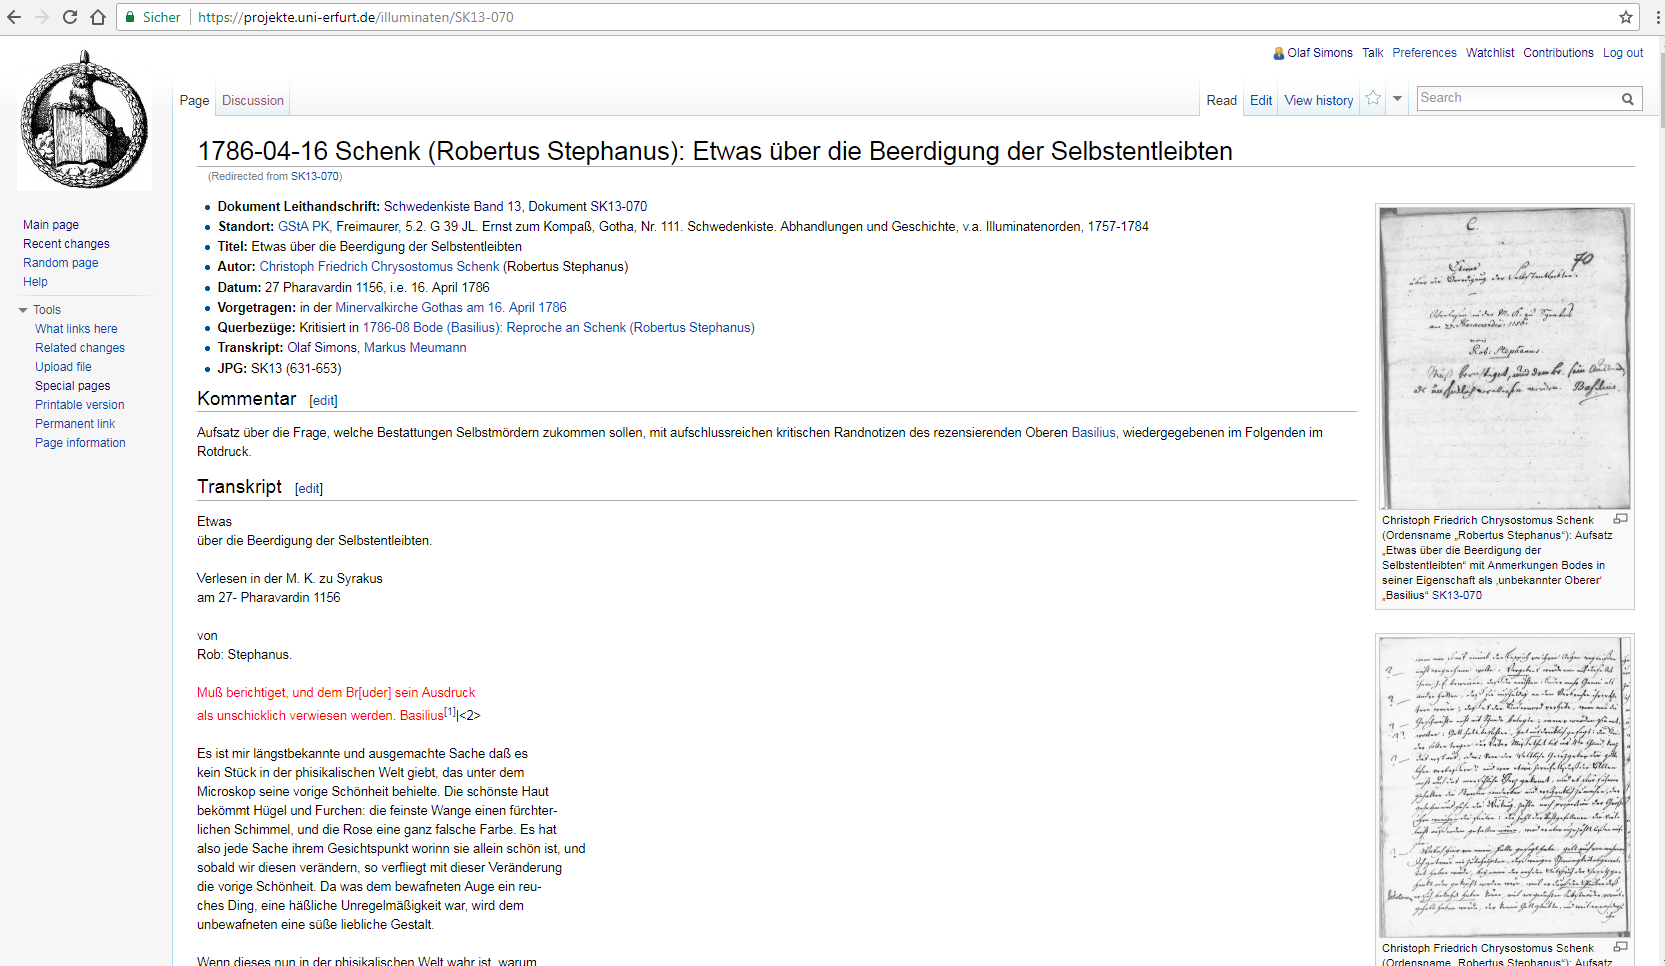
Beide Tools lassen sich parallel anbieten und werden einen ähnlichen Entwicklungsbedarf aufwerfen. Beim Umgang mit Dokumenten hätten wir gerne die Scans, Transkripte und Übersetzungen auf denselben Seiten. Eine typische Seite zu einer Quelle ist aus der Gotha Illuminati Research Base diese zu Schwedenkiste Band 13, Dokument SK13-070.

Elegant wäre, es zweispaltig Digitalisate neben Transkriptionen setzen zu können (und die Software für das Editieren zu öffnen). Elegant wäre es, wenn Benutzer zudem hier Übersetzungen anfertigen könnten.

5| Der FactGrid Quellen-Nachweis

Ausgiebig diskutierten wir das Schema des FactGrid Quellennachweises, wie es sich hier als Diskussionsvorschlag findet: Faktenbelege, die “Original Research” zulassen.

Prinzipiell sollte dieses Schema es Forschern erlauben, Befunde erstmals im FactGrid zu präsentieren und dabei selbst Arbeitshypothesen als solche handhaben zu können. Das Ziel ist nicht die Ressource, die ausschließlich mit solider Information bestückt wird, sondern ein Forschungshilfsmittel, das man etwa mit Personenlisten aus Dokumenten befüllen kann, um später zu sehen, welche Aussagen sich dazu machen lassen.

5| CC0 oder CC BY 4.0

Die Lizenz für das Factgrid sollte bislang CC BY 4.0 sein – jeder darf Informationen beliebig verwenden, muss sie aber wie verlangt zitieren. Das ist die wissenschaftliche Praxis, und das Zitat kann in diesem Fall nicht einfach „FactGrid“ lauten, es muss die Forscher nennen, die im FactGrid auf den Befund verwiesen.

Gegen die CC BY 4.0 spricht, dass sie bei einer Föderation mit Wikidata und dortiger CCo Lizenz ein Lizenzgefälle erzeugt, auch dass sich bei vielen Tools am Ende nicht das erwünschte Zitat mitliefern lassen wird: Wo sollen bei einer Visualisierung die Angaben zu den Forschern erscheinen? Fordert man sie ein, verhindert man die Visualisierungen.

Die pragmatische Alternative könnte lauten, dass wir uns auf CC0 einlassen, aber

  • eine best practice Information geben: Dort, wo einzelne Informationen etwa zu einem Todesdatum von uns zitiert werden, stellt ein eigenes Zitierlink zusammen, wie wir das Datum wissenschaftlich zitieren würden. Das ist gerade für uns selbst attraktiv: Wir können dann von hier aus in eigenen Artikeln Fußnoten beziehen.
  • mit Wikidata eine Vereinbarung treffen, wie wir dort Informationen unserer Arbeit zitiert sehen wollen
  • auf eine technische Lösung hinarbeiten, die es Benutzern in Wikipedia leicht macht, ganze Fußnoten zu Informationen von uns zu beziehen – bislang werden Todesdaten etwa regulär ohne Quellenangaben gehandhabt.

6| Die Daten der Schwedenkiste-Excel-Liste in Triple verwandeln

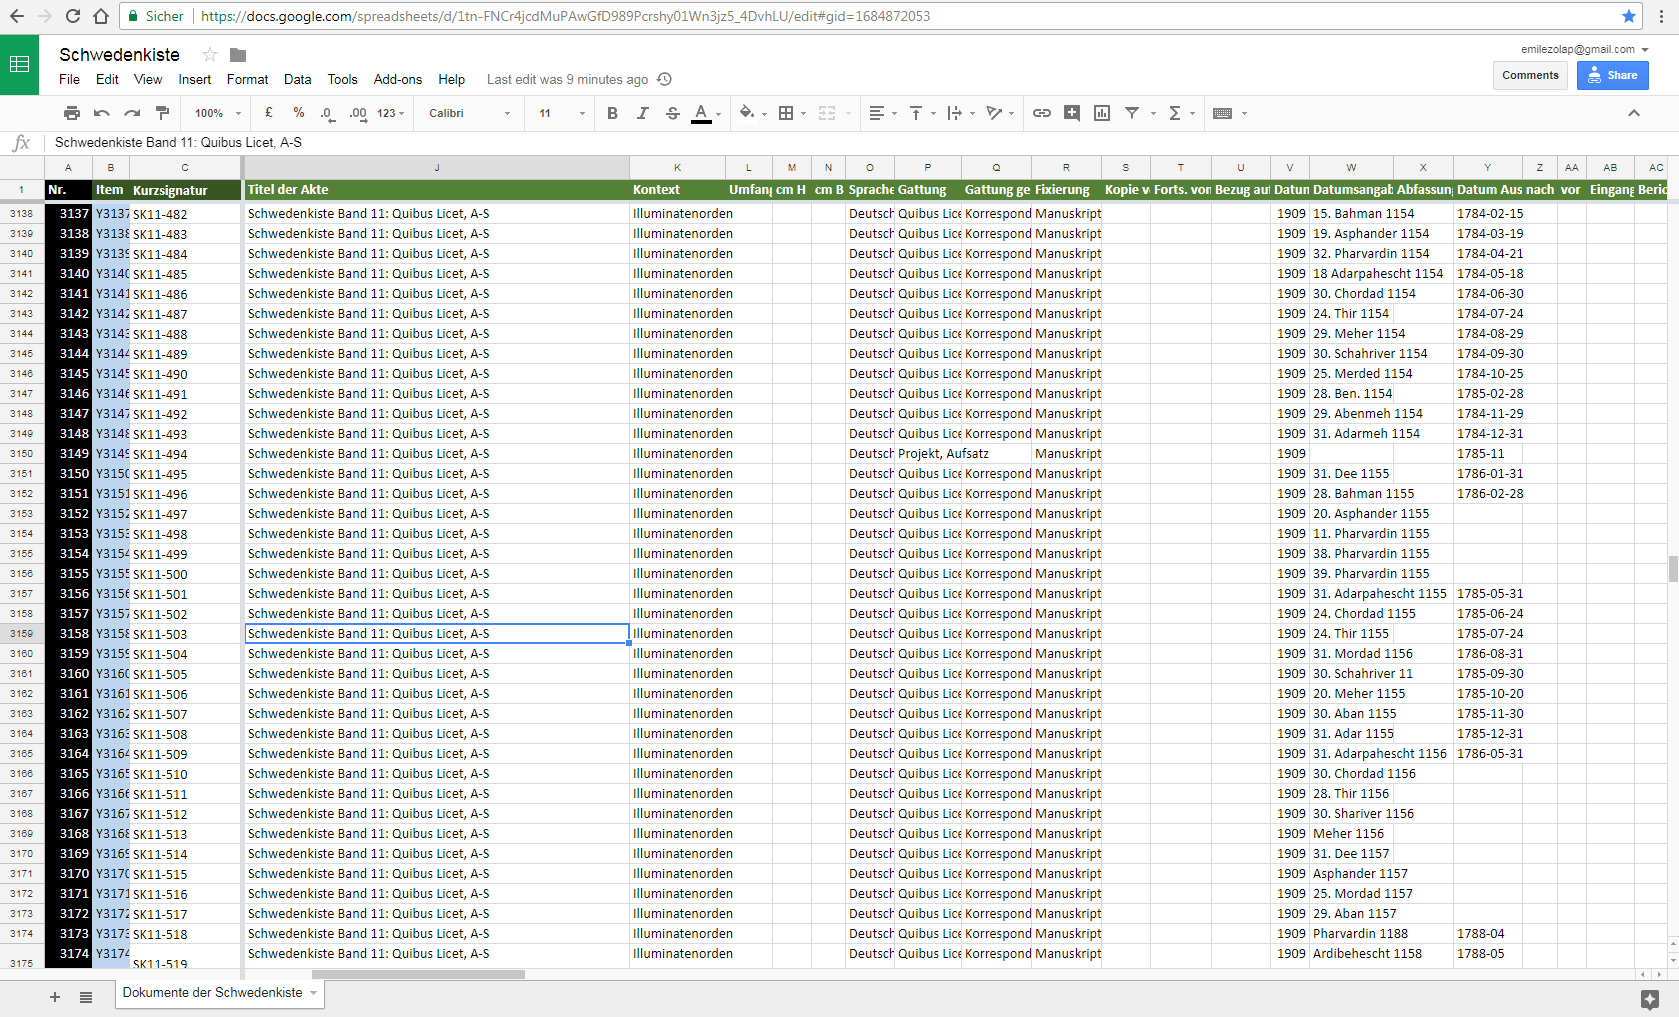
Wir gingen diese Liste spaltenweise durch. Es sollte kein Problem sein, die Tripel zu den gelisteten Dokumenten zu formulieren. Etwas Anpassungsarbeit wird nötig, um etwa nicht mehr vorhandene Dokumente zudem einzeln führen zu können. Die Schwedenkiste enthält Seiten jeweils mehreren Entwürfen von Briefen, die selbst nicht mehr überliefert, aber von hier aus einzeln rekonstruierbar sind.

Matti Blume und Olaf Simons wollen sich am 11.12. in Berlin für das Datenmodell und die Anpassung der Excel-Liste treffen.

7| Zeitschnitte

Spannend wäre es, wenn man im FactGrid historische Situationen darstellbar machen könnte. Der Artikel zu Gotha wird in diesem Fall nach gewünschtem Zeitraum zusammengestellt mit Informationen, die Zeitraum-gerecht arrangiert werden. Gotha hat um 1800 etwa 12.000 Einwohner, es gehört nicht zur BRD sondern ist Residenzstadt im Herzogtum Sachsen-Gotha-Altenburg und so fort.

Eine Website, die Zeitschnitte recherchierbar macht, wäre ein denkbares Objekt für einen coding Wettbewerb.

8| Barcamp Open Science, Coding Da Vinci, Hackathon

Vom Berliner Workshop ging die Anregung aus, einen nächsten Workshop im Frühjahr – vielleicht Anfang März zu veranstalten und dabei absolvierte Arbeitsschritte zu besprechen. Unser Ziel sollte es im selben Moment sein, von hier aus Projekte für coding-events zu formulieren:

9| Koordination

Kopfzerbrechen Nr. 6: Dokumente des Illuminatenordens erfassen

Im Verlauf unserer Arbeit legten wir zur Orientierung innerhalb der Schwedenkiste dieses Spreadsheet an. Jede Zeile (ab 24) ist ein Dokument innerhalb eines der 20 Bände der Schwedenkiste; dem folgen noch einige weitere Dokumente unserer Recherchen.

In der Visualsisierung der Datenbankinformation wird man später zu jedem Dokument eine Seite haben wollen mit Metadaten, Digitalisaten, Transkript, Übersetzung ins Englische.

Die Datenstruktur würde, von unserer Excelliste kommend, übersichtlich diese Felder haben, von denen einige unorthodox sind – der Orden verschlüssele Datums- und Ortsangaben, die Namen von Sendern und Empfängern wurden verschlüsselt, wichtiger noch: Sender schrieben regelmäßig an den Orden, ohne zu erfahren, wer dort ihre Briefe öffnete (das indes wissen wir, nachdem wir die Innenorganisation kennen).

Groberfassung

1. Kurztitel
2. Level: Archivbestand/ Akte/ Dokument/ Abschnitt in einem Dokument [ideal: Pulldownmenü zur Bestimmung der Erfassungsebene]
3. included in (in welchem Archivbestand findet sich die Akte, in welcher Akte das Dokument, in welchem Dokument der Abschnitt der hier erfasst wird?)

3a. dortige Position
3b. Seiten oder Blattangabe
4. Digitalisat online
5. Transkript online
6. Veröffentlichung

6a. Stellenangabe (Seiten von bis)
7. Übersetzung

7a. Stellenangabe (Seiten von bis)
7b. Sprache der notierten Übersetzung
8. Forschung

8a. Stellenangabe (Seiten von bis)

Objektbeschreibung

9. Umfang der Akte, des Dokuments, des Abschnitts (in der Regel eine Seiten- oder Blattzahl)
10. Format [unterschiedliche Angaben denkbar: 2°, 4°, 8°, DIN A…, cm x cm]
11. Manuskript/ Manuskript mit Noten/ Typoskript/ Druck/ Formular (mit Eintragungen)/ Schattenriss/ Zeichnung (mit Text)/ Konvolut
12. Handschrift
13. Sprache

Autor

14. Autor

14a Autor Selbstaussage (“Name vorenthalten, sprich anonym”, Initialen, Pseudonym…)
14b. Verantwortende Insitution
15. Absendeort

15a. Geo Kordinate
15b. Absendeort in seiner unklaren Nennung
16. Absendedatum / Enddatum der Komposition

16a Genauigkeit (ca./ recte/ fraglich)
16b Datierungsangabe laut Dokument
16c Abfassungsbeginn (z.B. bei Tagebüchern oder Briefen, die über Tage hinweg verfasst werden)
16d. terminus post quem (was ist das Datum, nach dem dieses Dokument verfasst sein muss)
16e. terminus ante quem (was ist das Datum vor dem dieses Dokument verfasst sein muss)

Empfänger

17. Empfänger

17a. abweichende Adressierung
17b. adressierte Institution
18. Ort Empfänger

18a. Geokoordinate
19. Eingangsdatum
20. Weitere Rezipienten (besonders wichtig bei den Illuminatenakten, wo man Briefe an den Orden adressiert, auf dass “Unbekannte Obere” sie lesen – die wir wiederum identifizieren können)

Inhalt

21. Textsorte standardisiert [hier muss Auswahl erstellt werden]
21. Textsorte Selbstaussage
22. Titel
23. Inhalt
24. Berichtsgegenstand [FactGrid-Id von Ereignis etwa bei Treffen, Konferenz etc.]

24a. Berichtszeitraum von
24b. Berichtszeitraum bis

Kontext

25. Antwort auf
26. Rezension von/ Gutachten zu
27. Fortsetzung von
28. Dokument ist [Auswahl:] Konzeptschrift zu/ Kopie von/ Reinschrift von/ Zusammenfassung von/ Übersetzung von/ Katalogeintrag zu

28a. Dokument zur vorigen Spalte
29. Bearbeiter/ Übersetzer (Information zur vorvorigen Spalte)
30. Querbezüge
31. Genannte Personen

Provenienzinformation nach Verlust des Objektes oder des Quellennachweises

32: Verlust/ zu recherchieren/ privat
33: Status seit wann
34: Grund (etwa Bombardierung des Archivs – Möglichkeit eines Ereignislinks)
35: Paralellüberlieferung (woher kommen die Informationen, die wir heute über das Dokument haben)

35a: Stellenangabe zu vorigem (Seite Default)

Provenienz bei vorliegendem Dokument

36. Besitzer / Archiv

36a. Geo-Koordinate
37. Besitz von/seit

37a. Besitz bis
38. Bestand
39. Signatur
40. Verzeichnis
41. Zugänglichkeit (öffentlich zugänglich/ eingeschränkt öffentlich zugänglich/ privat/ geheim)
42. Eigentümer
43. Wechsel gegenüber voriger Provenienz [Kauf/ Schenkung/ Leihgabe/ Enteignung/ Aneignung/ Raub]

FactGrid-interne Information

44. Erschließung (Namen derer, die die Erschließungsinformationen lieferten, mit Jahresangaben)
45. Forschungskontexte (hier können Forschungsprojekte Materialcorpora für ihre Recherchen generieren)
46. Template (für eine Darstellung etwa im Article Placeholder)
47. Digitalisat (wichtig, wo wir nicht-öffentliche Bilddateien von unseren Servern benennen)
48. Achtung! (Raum für Bearbeitungsnotizen)

Die zentrale Frage dieses Kopfzerbrechens ist: Wie stimmen wir diese Liste mit bereits bestehenden Wikidata-Feldern ab? Wie erstellen wir hierfür eine Eingabeschablone, die – etwa bei einer Crowd-Erschließung – die richtigen Fragen übersichtlich stellt?

Wie generieren wir aus den Daten im Verlauf ansprechende Seiten zu den Dokumenten, die deren Lektüre zu einer angenehmen Erfahrung macht? Mit welcher Gestaltung würde man Übersetzungen einspielen (die Übersetzung ins Englische ist das größte Desiderat des öffentlichen Austauschs über die Illuminaten). Magnus Manskes Reasonator machte gute Vorschläge was die Gestaltung von Seiten aus Wikidata anbetrifft.

Bisher sehen unsere Seiten zu Dokumenten – unbefriedigend – so aus:

Screenshot SK13-070 https://projekte.uni-erfurt.de/illuminaten/SK13-070

2017-12-1/2: Einige konkrete Fragen für den ersten FactGrid Workshop

siehe https://factgrid-tools.geschichte.uni-halle.de/blog/archives/159

  1. Wäre es sinnvoll, das FactGrid vorab mit ausgewählten (auf Kerndaten reduzierten) Datensätzen aus Wikdata und der GND zu befüllen, um nicht im leeren Raum zu beginnen?
  2. Gäbe es alternativ eine einfache Option, Daten mit den bestehenden Datenbanken abzugleichen und Datensätze ohne Umstände zu übernehmen?
  3. Könnte man den Umgang mit Doubletten – verschiedenen Datensätzen zur selben Person etwa (resultierend aus der Zusammenfügung von Tatenmengen) – nicht zu einem fruchtbaren Problem machen, sprich: die Datenbank einsetzen, um gezielt nach möglichen Übereinstimmungen zu fahnden?
  4. Wie würde man am besten mit ‘tentativen Informationen’ umgehen – mit Personen etwa, von denen man erstmal nur einen Nachnamen, einen Zeitpunkt und Ort in einem ersten Aktenbefund hat? (Siehe das erste und das zweite Kopfzerbrechen hierzu.)
  5. Wäre es nicht klug, Bilddateien und Transkripte in derselben Datenbank zu verwalten? (Siehe das fünfte Kopfzerbrechen.)
  6. Wie gehen wir mit wechselseitigen Beziehungen um? Wenn eine Schablone es erlaubt, zu einer Person Eltern und Kinder zu nennen, wie stellen wir sicher, dass Schablonen zu Kindern wiederum die bereits eröffneten Beziehungen zu den Eltern in den Eingabefeldern haben?
  7. Wenn wir Gegenstände und Eigenschaften definieren, werden wir dafür eigene (sagen wir) X- und Y-Nummern vergeben, um Freiheit bei der Erweiterung und Ausbeutung der Datenlage zu haben? Wenn ja: Wie sichern wir die weitestmögliche Vereinbarkeit mit Wikidata-Einträgen ab?
  8. Magnus Manskes Reasonator erweist sich als ungemein elegantes Werkzeug, um Wikidata-Information enzyklopädisch verfügbar zu machen. Taugt der “article placeholder” als Alternative, wenn wir eine Vermehrung von Plattformen verhindern wollen und wenn wir eine automatische und übersichtliche Datenpräsentation suchen. Braucht Wikidata nicht langfristig einen eigenen “Visualizer”, der die Informationen zu jedem Gegenstand zweckmäßig anordnet und erst beim Editierwunsch in den Bearbeitungsmodus schaltet?
  9. Das FactGrid soll verschiedenen Projekten als gemeinsam betriebene und angereicherte Plattform dienen. Wie machen wir es möglich, dass das jedes einzelne Projekt die Ressource unter seinem eigenen Focus ausbeuten kann? Wie ermöglichen wir Suchen, die etwa speziell im Aktenbestand bleiben, der vorher als die thematisch relevante Datenlage eines Projekts definiert wurde?

Kopfzerbrechen Nr. 5: Dokumente, Transkripte und aus ihnen bezogenen Informationen zusammenhalten

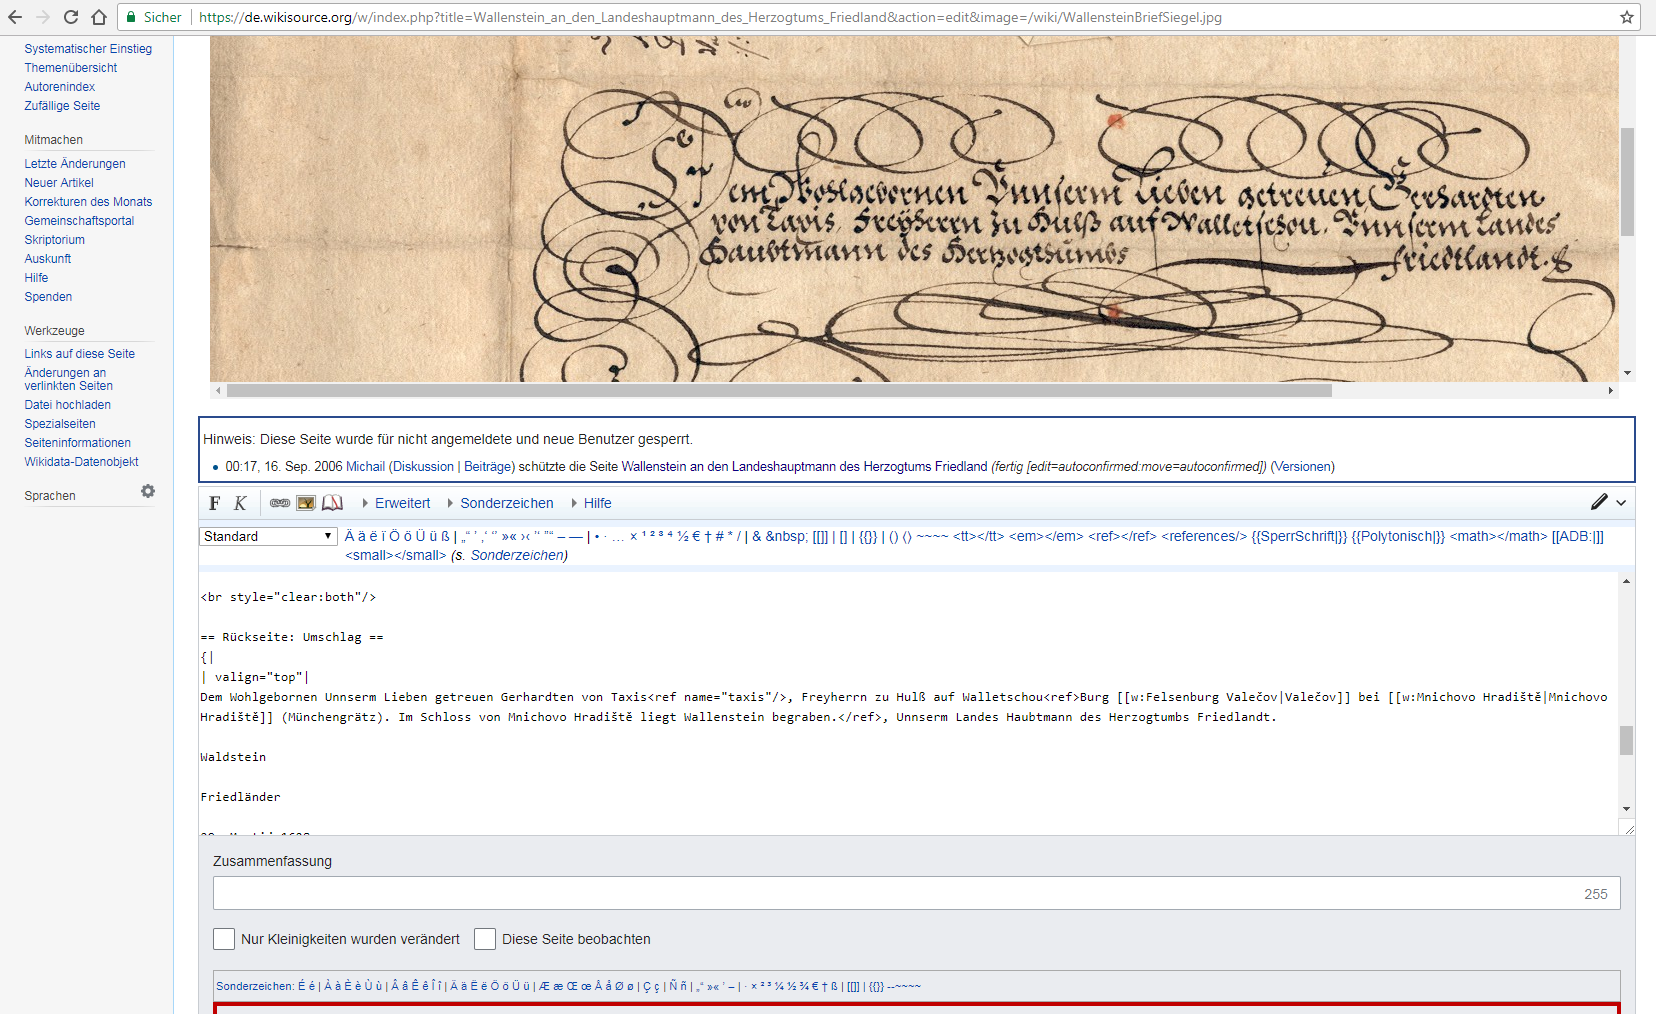
Wikisource Screenshot mit Bilddatei und Bearbeitungsfenster für das Transkript im Original
Das ist die mühsame Arbeit des Historikers wie des Hobby-Forschers, der etwa Kirchenbücher auf den Spuren seiner Familie auswertet: Man hat ein Dokument. Wenn es älter ist, entziffert man es, indem man es nebenbei notdürftig transkribiert. Mitunter muss man es nebenbei in eine lebende Sprache übersetzen, bevor man im letzten Schritt Informationen aus dem Dokument zieht (und sich notiert, wie man die Information nachher zitiert).

Sollten wir das Projekt der Illuminatenakten Online in einer größeren Kooperation mit den zu beteiligenden Partnern zuwege bringen, werden wir zu alledem noch die Scans der einzelnen Dokumentenseiten zu verwalten haben. Was wäre praktischer für deren Verwaltung als die bereits benutzte Datenbank? Eigene Wikis aufsetzen mit der Wikisource-extension, die es erlaubt, einen Scan neben einem Transkriptionsfenster zu sehen, hieße die Plattformen planlos zu vermehren.

Interessant ist die all-in-one-solution. Sie öffnet den Weg in die Volltextsuche; vor allem aber behält man mit ihr stets die Arbeitsschritte beieinander. Im raschen Zugriff lässt sich erfassen, welche Informationen aus welcher Datenlage gezogen wurden. Beim seltsamen Befund ist man schnell an der Quelle, die falsch gelesen oder fehlinterpretiert worden sein muss. Die Metadaten zum Objekt, die man vor allem mit der Datenbank verwalten möchte, bleiben dicht bei der Objektbearbeitung.

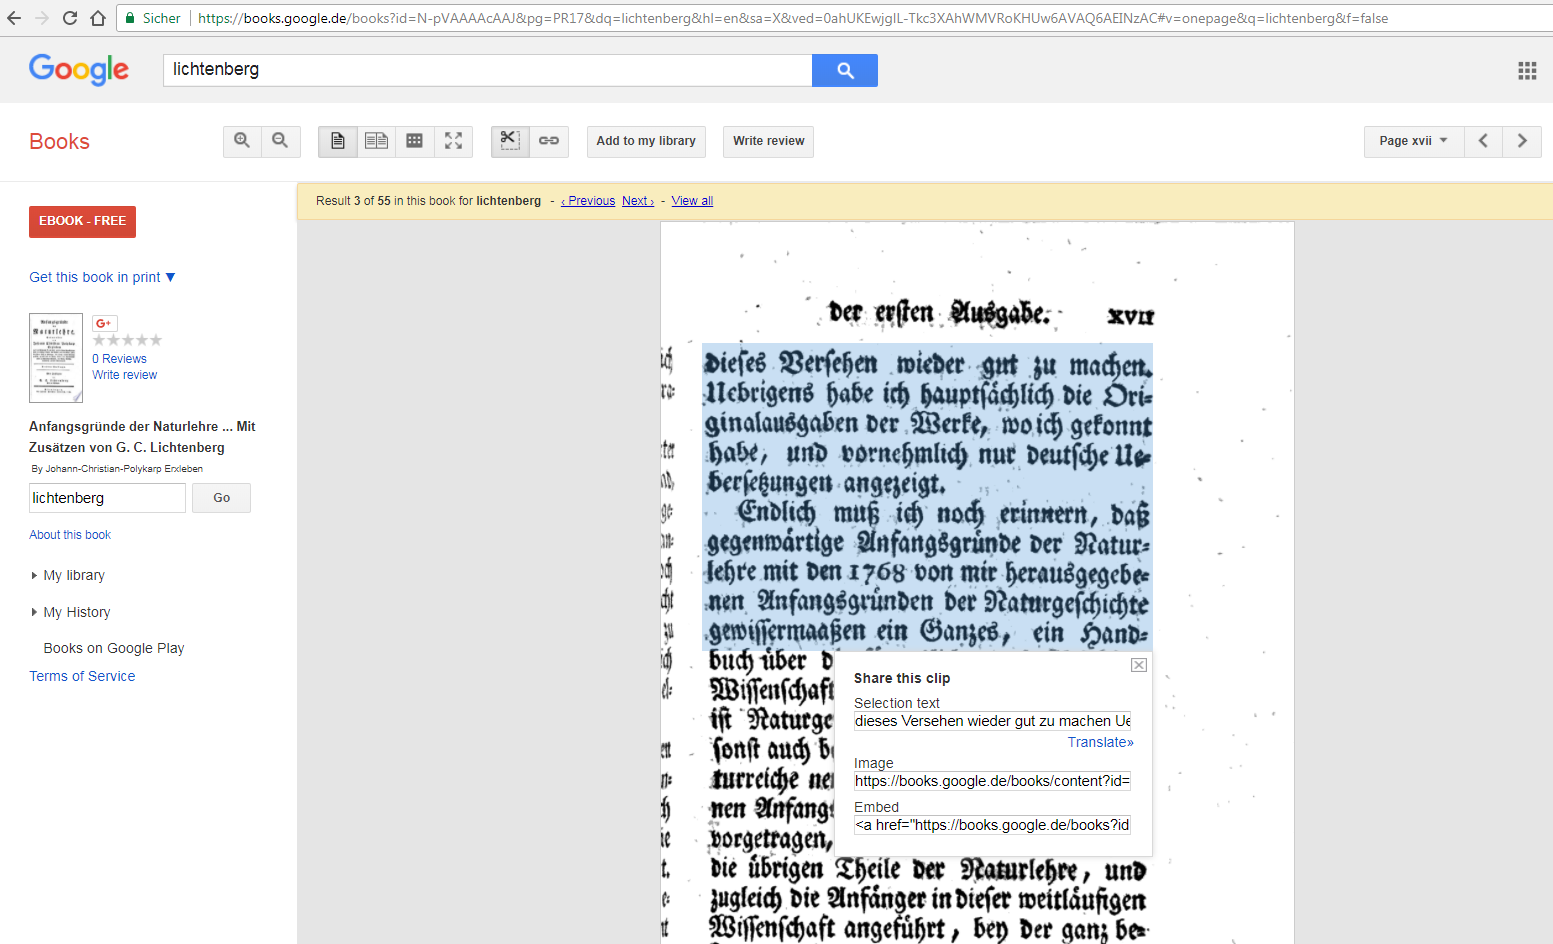
Vielleicht würde man mit Sichtfenstern arbeiten wollen, die man in verschiedenen Tabs, mitunter auch auf zwei Bildschirmen, nebeneinander nach eigenen Wünschen anordnen könnte. Angenehm wäre es, wenn man die Information von anderen Datenbanken einbinden könnte: Oft wünscht man sich eine Funktion, um eine bereits vorhandene Texterkennung – sie läuft bei Google Books und Archive.org im Hintergrund der Scans mit – einfacher bei der eigenen Arbeit benutzen zu können. Man korrigiert schneller als man selbst schreibt.

Screenshot aus Google Books: Man kommt an die OCR zu einzelnen Textpassagen, kann sie aber nicht bearbeiten. Vergrößern / Google Books

Das sind gleich mehrere Baustellen für ein längeres Kopfzerbrechen.

Kopfzerbrechen Nr. 4: Organigramme

In Google Books findet sich eine kleine Serie der Herzoglich-Sachsen-Gotha- und Altenburgischer Hof- und Adreß-Kalender:

Die Serie von 1768 bis 1825: https://digital.slub-dresden.de/werkansicht/dlf/54350/1/ /
https://zs.thulb.uni-jena.de/receive/jportal_jpvolume_00240779

Die Publikationen waren nicht ungewöhnlich. Man entnahm ihnen nach dem kalendarischen Vorspann und den Informationen über die Post-
und Botenverbindungen Überblick über den Aufbau des gesamten Staats und seiner Landeskirche samt den Namen und Posten aller Amts- und Würdenträger bis hinab zu den Angestellten, die der Herrschaft auf dem Schloss aufwarteten.

Netzwerkdarstellungen wurden in den letzten Jahren populär. Sie erlauben es, Knoten in größeren Kommunikationsgefügen auszumachen. Insbesondere informelle offene Korrespondenzgefüge gewinnen hier Transparenz.

Tatsächlich wissen wir aber dank solcher Kalender und vergleichbarerer Publikationen über die Interaktionsgefüge weit mehr. Wir verfügen über Organisationspläne aus staatlichen und kirchlichen Behörden, wir kennen die Gefüge der Armee, größerer Anstalten wie kleinerer Firmen, kennen die Positionen in geheimen und nicht geheimen Gesellschaften, die Gremien und Ausschüsse von Parlamenten und Parteien und so fort.

Eine der interessantesten Leistungen des FactGrids könnte darin liegen, diese Gefüge mit den Personendaten und Archivalien zu erfassen. Hier sind Organisationsstrukturen ausgewiesen samt Titeln, Positionen und den Namen der Amtsinhaber. Wie müsste die Dateneingabe aussehen, um aus ihr Organigramme für jeweils gewünschte Zeitschnitte zu generieren – mit Links zu den Personen und zu Schriftstücken ihrer Hand?

Die Adress-Kalender erfassen, wie der größte Arbeitgeber im frühneuzeitlichen Staat mit der Bevölkerung seines Territoriums verwoben war: Welcher Prozentsatz der Stadt- und der Landbevölkerung stand in Dienstverhältnissen zum Hof? Wie verliefen – hier wird die Serie der Kalender aufschlussreich – Karrieren bei Hof? Welche Positionen erweisen sich als sozial durchlässiger als andere?

Wie sind – wenn wir Organisationsgefüge miteinander korrelieren – Gothas Freimaurer mit Staat und Kirche des Herzogtums verwoben? In wieweit überlappen sich Kreise des Klubbs, der Thee-Gesellschaft, der Besucher der wissenschaftlichen Vorlesungen des Hofarchivars Ludwig Christian Lichtenbergs in der Stadt, der Illuminaten im Haus des Schlosshauptmanns Christian Georg von Helmolt mit staatlichen Strukturen? Welche Mitgliedschaften waren Eintrittskarten in Karrieren, welche persönlichen Kontakte öffneten Türen?

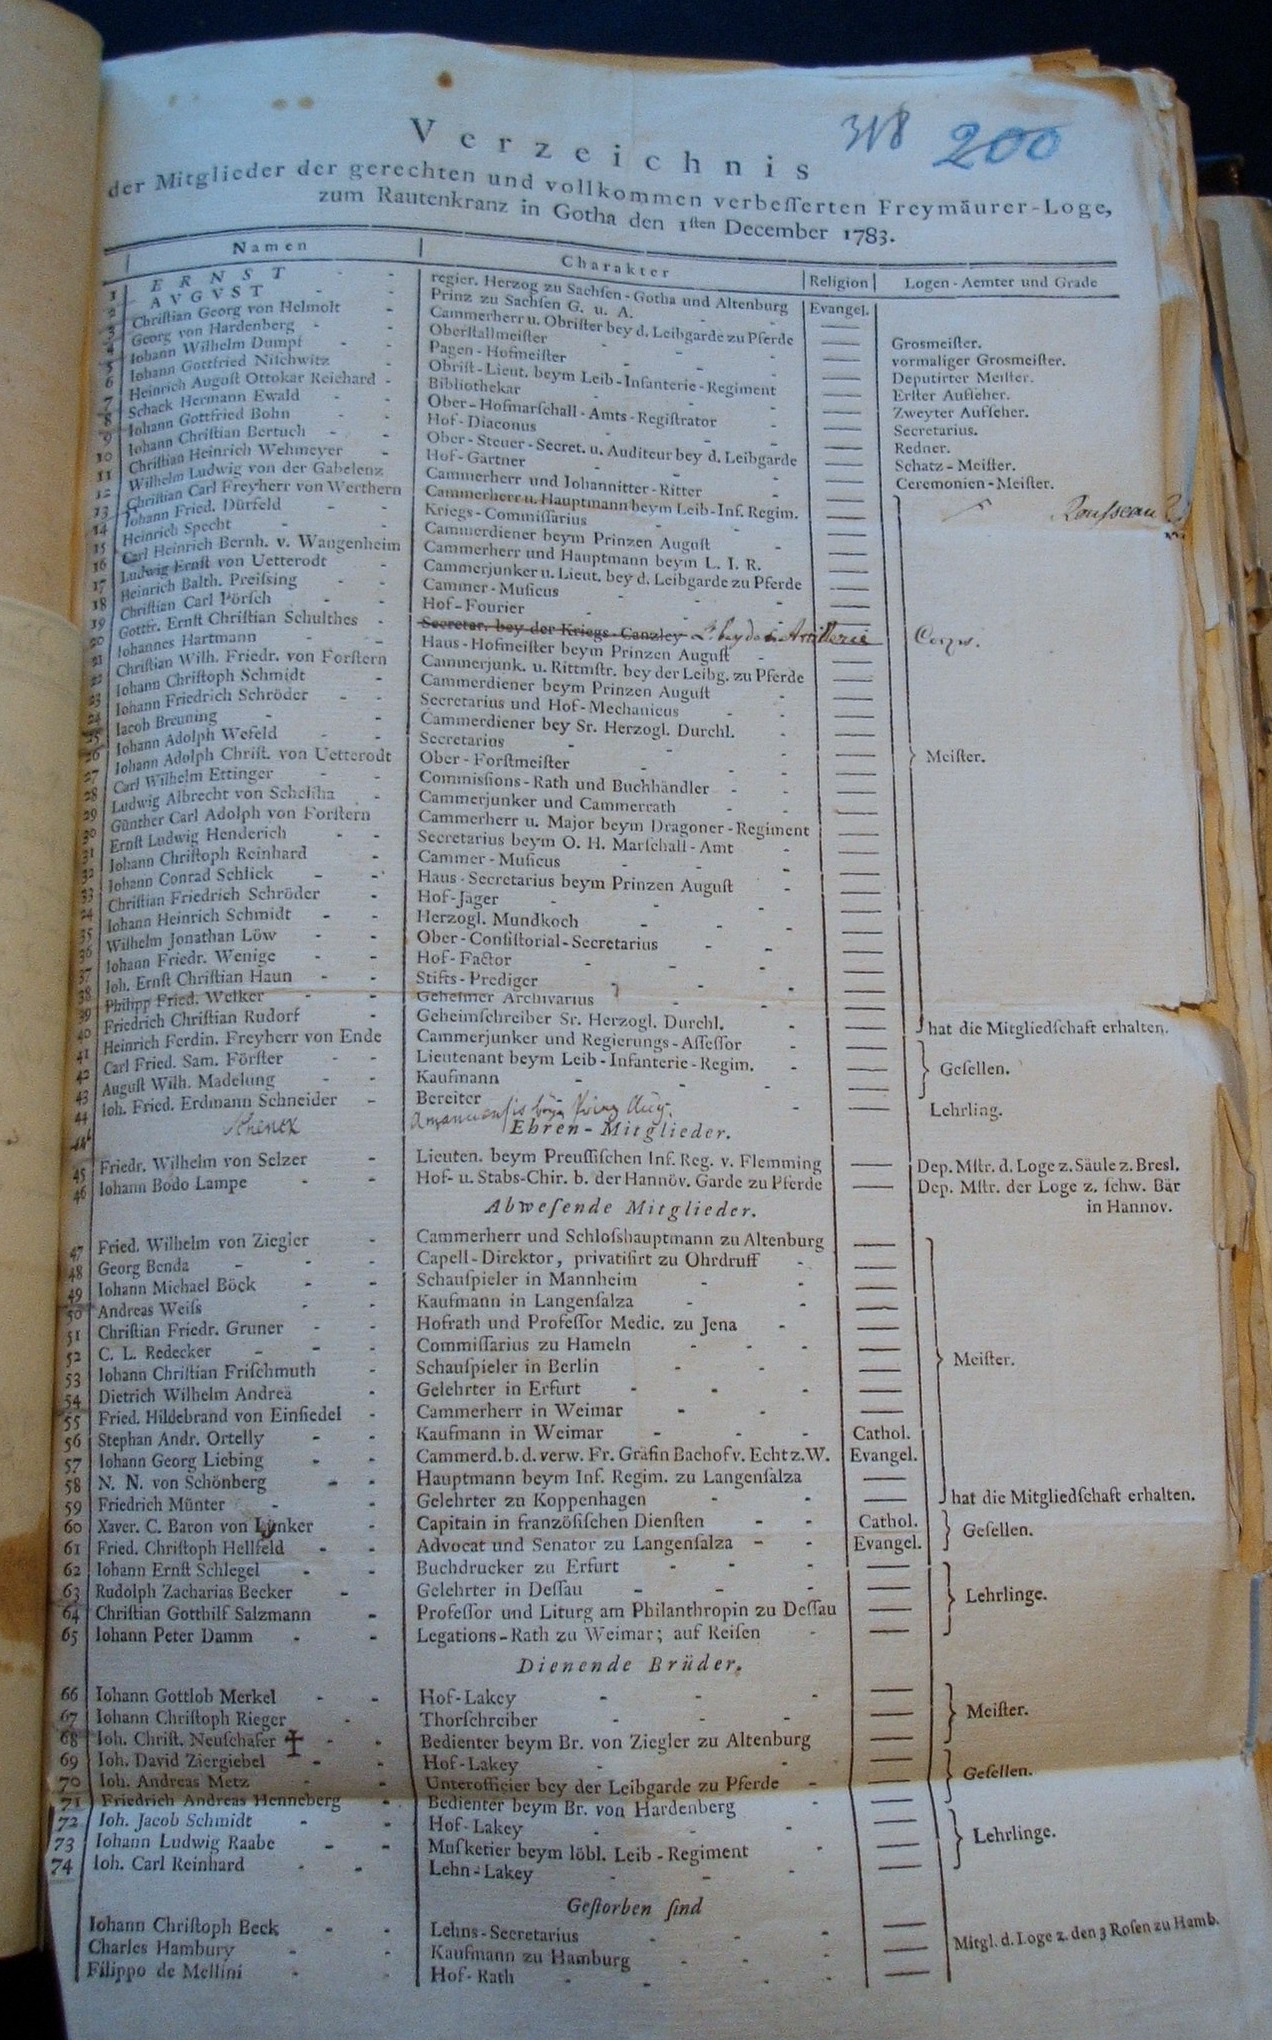
Aus den Akten des Illuminatenordens Schwedenkiste Band 10, 200: Die Mitgliederliste der Gothaer Freimaurer-Loge von 1783. Deutlich sichtbar: Führende Hofbeamten treffen sich in der Loge wieder – aber nicht alle… Vergrößern

Übersichtlichkeit werden Organigramme generieren, sobald sie mit der Aktenüberlieferung korreliert werden, und man auf die Schnelle in die Arbeit von Behörden Einblick nehmen kann.

Bleibt die zentrale Frage: Was muss wie eingegeben werden, um welche Darstellungen zu erlauben und welche Fragen stellen zu können?

Struktur Stadtverwaltung Gotha, Organigramm 2017 http://www.gotha.de/rathaus-politik/stadtverwaltung/organigrammaktenplan.html

Kopfzerbrechen Nr. 3: Genealogien

Genealogien durchdringen alle Arbeitsgebiete. Wer Bibliothekskataloge durchsucht, erhält Verlagsangaben und bleibt im Dunkeln darüber, wie diese Angaben zusammenhängen.

Genealogien der Geschäftsführung

Dem Buchhandelshistoriker ist klar, dass er hier genealogisch denken muss: Die städtischen Behörden vergaben Lizenzen für den Druck, Verlag und/oder Verkauf von Büchern. Die Lizenzen wurden innerfamiliär weitergegeben vom Vater auf den Sohn oder, bei ausbleibenden Erben, auf die Witwe und die Kinder, bis jemand in das Geschäft einheiratete oder es von auswärts kommend erwarb.

Neue Lizenzen wurden selten eröffnet. Das Interesse des Hofes konnte hier innserstädtische Interessen an der Vermeidung von Konkurrenz außer Kraft setzen. Eine Geschäftsteilung konnte eine Differenzierung in verschiedene Lizenzen mit sich bringen – fortan bestand ein Unternehmen als reine Druckerei, und eines als reines Verlagsgeschäft mit Buchhandlung.

Dutzende von Namen über drei Jahrhunderte ordnen sich, sobald man die Genealogie der weitergegebenen Rechte erfasst, zu wenigen Strängen pro Stadt – das kann wie folgt für München oder Gotha aussehen:

Vergleichbare Darstellungen der Geschäftsbeziehungen sind bereits Teil des ungeborgenen Katalogwissens. Die Kataloge könnten theoretisch auf die Nahtstellen hinweisen, an denen vermutlich ein Wechsel stattfand, ein Name ausläuft, ein anderer anhebt. Letztlich erfordert die Rekonstruktion der Zusammenhänge jedoch eigenes Wissen über Familienbeziehungen und die Zusammenhänge der städtischen Gewerbeakten.

Auf der Ebene der Software benötigte man die passenden Darstellungsoptionen. Vor allem aber braucht man Schnittstellen, an denen Benutzer die Verbindungen herstellen und die Genealogie ordnen können.

Genetische Verhältnisse: Stemmata

Viel komplizierter liegen die Verhältnisse bei den genetischen Zusammenhängen zwischen Buchausgaben. Manche Kataloge scheitern hier schon im Ansatz wie der hinter Google Books. Man versuche etwa, die Nummern eines Journals aus dem 18. Jahrhundert, dessen Digitalisate irgendwie im System stecken, sich der Reihenfolge nach anzeigen zu lassen. Google hilft einem hier mit einem vagen Angebot weiter nach dem Motto „Leser, die dies lasen, könnten auch diese Links interessant finden“.

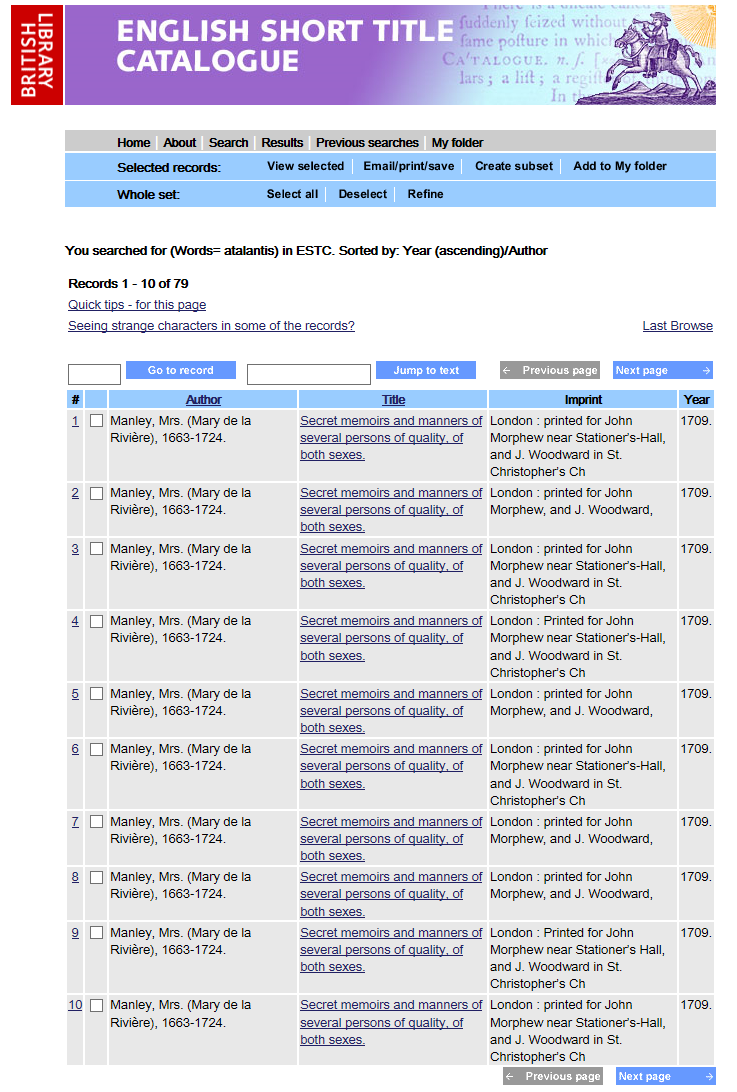
Doch auch ausgefeilte Kataloge wie der ESTC, das Verzeichnis aller englischen Titel der Jahre 1473 bis 1800, weisen hier rasch unüberschaubar werdende Gebiete auf – dann etwa, wenn minimale Varianten von einer Ausgabe, verschiedene Auflagen und zudem einzelne Teilbände auf ein Jahr fallen wie im Fall der Katalogangabe für Delarivier Manleys Atalantis:

ESTC Suche: “Atalantis”. Auch nach der chronologischen Sortierung bleibt unklar, hinter welchem Link der erste Text liegt.

Man wünschte sich hier nicht minder eine Option der genealogischen Strukturierung: Der erste Band erschien im Mai 1709; im Juli musste er nachgedruckt werden. Band zwei folgte im Oktober. 1710 brachte die Autorin ein Werk heraus, das erst einmal einen eigenen Titel trug: die Memoirs of Europe. Ein halbes Jahr später folgte davon Band zwei. Ab 1715/16 wurden diese Bände in Neuausgaben der Atalantis als deren Folgen III und IV notiert.

Dem Markterfolg wurden ab 1711 auch noch ganz andere Bücher untergeschoben: 1705 war erstmals eine Queen Zarah mit ähnlicher Skandalgeschichte erschienen. Deren zweite Ausgabe kommt 1711 „by way of appendix to the New Atalantis“ heraus. Ein weiterer älterer Titel macht denselben Sprung in den Komplex und vier neue wollen unverzüglich in ihn hinein. Siehe hier die geschlossenere genetische Darstellung: http://pierre-marteau.com/library/e-1709-0004.html.

Der ESTC ist im Kern ein Nationalkatalog. Das wird deutlicher, sobald man die weiteren Titel auf dem europäischen Markt nachweisen will – dem versagt sich der ESTC. In den Niederlanden erfolgte 1713 die Übersetzung der ersten zwei Bände ins Französische. Eine nachweisbare, kondensierte deutsche Fassung datiert vermutlich von 1714 und übersetzt nach der französischen Ausgabe.

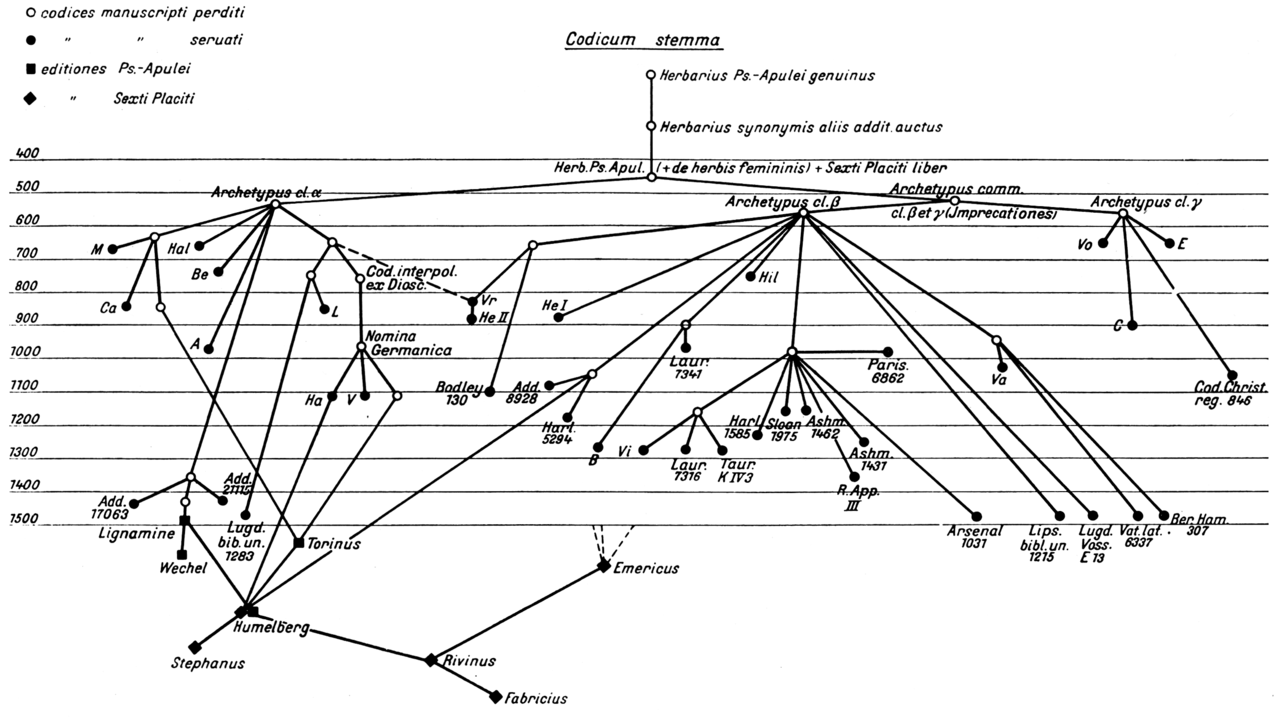
Für die beschriebenen genetischen Beziehungen bräuchte man Stemmata, wie sie in der Handschriftenkunde verbreitet sind. Das Komplizierte ist hier, dass die Beziehungen zwischen Titeln immer über das ganze Schema hinweg verlaufen können. Ein Verlag mag bei einer Neuausgabe nach der letzten ihm greifbare Ausgabe setzen. Er könnte jedoch auch auf die Erstausgabe zurückgreifen, oder eine von der Autorin korrigierte spätere. Die moderne „kritische“ Ausgabe wird sich für eine Leitausgabe entscheiden, und Varianten (wenn vorhanden) mit dem Manuskript der Autorin und den ersten und letzten Ausgaben, die sie selbst beeinflusste, erfassen.

Stemma für die Manuskripte des ‘Pseudo-Apuleius Herbarius’ aus Ernst Howald and Henry E. Sigerist. Antonii Musa De herba vettonica (Leipzig 1927). https://commons.wikimedia.org/wiki/File:Howald-sigerist.png

Wieder wäre einem mit einer Schnittstelle geholfen, die es erlaubte, verschiedene genetische Beziehungen zwischen Ausgaben herzustellen, die dann in einer Visualisierung zum Zuge kämen.

Entwicklungen

Natürlich hofft man auf die Software, die selbst rekonstruiert, wie sich die Dinge ordnen – darum geht es im Umgang mit „Big Data“. Das Spannende an der Wikidata-Software ist jedoch im selben Moment, dass der Benutzer mit ihr sein Wissen viel schneller und härter einbringen und damit die großen Schneisen der Diskussion gezielt und diskutierbar schlagen könnte.


oder:

..von hier: https://www.edwardtufte.com/bboard/q-and-a-fetch-msg?msg_id=0000yO

Siehe auch