Memorandum of Understanding zwischen der Universität Erfurt und der Deutschen Nationalbibliothek – das FactGrid wird in einem Gemeinschaftsprojekt auf GND-Daten aufgesetzt

English Version

Das FactGrid-Projekt steht vor zwölf Monaten neuer Herausforderungen: Mit ihren Unterschriften vom 15. und 25. März 2019 unterzeichneten der Präsident der Universität Erfurt, Prof. Dr. Walter Bauer-Wabnegg, und Dr. Elisabeth Niggemann als Generaldirektorin der Deutschen Nationalbibliothek in Frankfurt und Leipzig ein Memorandum of Understanding, das in großem Umfang GND-Daten ins FactGrid bringen soll – Daten zu mehreren Millionen Personen und Körperschaften. Noch ist nicht klar, aus welcher Datenquelle wir die Ortsinformationen einspielen werden, die wir zudem benötigen werden.

Für die FactGrid-Projektbeteiligten lag hier noch nach der ersten Berührung mit der Software das sich abzeichnende große Desiderat: Eine Wikibase-Instanz wird zum interessanteren Werkzeug, wenn sie Benutzern Recherchen abnimmt und Wissen anbietet, auf das Forschung unmittelbar aufbauen kann. Die GND stand im selben Moment als die Datenquelle im Raum, aus der die Geisteswissenschaften im deutschsprachigen Raum sich in jedem Fall zu bedienen hätten. Von einem GND-Input aus könnte man beliebig weiterdenken, mit dem Blick auf die Verzeichnisse deutscher Drucke oder auf komplementäre internationale Normdaten.

Klar wurde im April 2018, der Europeana Workshop in Antwerpen war hier eine Wegscheide, dass soeben allerorten erste unabhängige Wikibase-Instanzen entstanden; sie würden im optimalen Fall eine „Föderation“ anstreben. Die Deutsche Nationalbibliothek würde, so der Informationsstand nur zwei Monate später, eigene Wikibase-Instanzen aufbauen — erst einmal in einer Software-Evaluation. Das FactGrid-Projekt stand damit vor Entscheidungen: Entweder setzten wir auf eine Plattform, die sich spezialisierte und noch im Frühstadium isolierte und nutzten GND-Daten nur für uns oder wir riskierten eine Ressource, die sich im Verlauf zwischen der GND und Wikidata als Plattform für „Original Research“ anbieten kann. Unser spezielles Angebot lässt sich benennen: Wir werden nicht die GND- oder Wikidata-Relevanzkriterien übernehmen. Bei uns wird man Datensätzen zu Säuglingen anlegen können, die nach der Geburt verstarben, um ein klareres Bild von Säuglingssterblichkeit im historischen Längsschnitt zu gewinnen. Wir werden der GND und Wikidata im selben Moment anbieten können, nach ihren eigenen Relevanzkriterien Informationen von uns zu beziehen — Informationen, die wir als Forschungsbeiträge zitierbar machen.

In welche technische Lösungen sich das übersetzen wird, sprich: wie Wikibase-Instanzen in Zukunft miteinander kommunizieren werden, ist noch offen. Jetzt jedoch schon können wir eine Instanz zur Verfügung stellen, auf der sich die GND in einer Wikibase-Version bearbeiten lassen wird.

Eine solche GND-Version gemeinsam mit der Deutschen Nationalbibliothek zur Verfügung zu stellen, hat vor allem den Zweck, Erfahrungen dabei unter allen Beteiligten verfügbar zu machen. Von der Transparenz der Design-Entscheidungen wird abhängen, wie gut die hier entstehenden Instanzen später miteinander kommunizieren werden.

Ein Team wird jetzt zu sammeln sein — aus den beteiligten Institutionen der Deutschen Nationalbibliothek und der Gothaer Forschungseinrichtungen der Universität Erfurt und, hier soll das unten publizierte Memorandum of Understanding Klarheiten schaffen, aus den Commmunities des Wikimedia-Umfelde, die mit Wikibase und mit Wikis im Moment entschieden vertrauter sind als wir.

  • Wir suchen SPARQL-Bewanderte, die Datenmodelle austesten und Vorschläge für geschicktere Datenkonfigurationen machen werden, mit denen man die auf uns zukommenden großen Informationsmengen intuitiv und fruchtbar handhaben wird.
  • Wir suchen Wikibase-Kenner, die wissen, wie man Mengen von mehreren Millionen Datensätzen in eine Wikibase-Instanz hineinbringt, und diese Datensätze dabei mit genealogischen und räumlichen Vernetzungen durchdringt.
  • Uns fehlt Expertise darin, wie wir das FactGrid in der Woge der Doubletten und Namensgleichheiten handhabbar halten, die nun auf uns zurollt: Die GND birgt Namensgleichheiten in bislang nicht dagewesenem Maße. Wir werden Wege finden müssen, wie man Forschenden in diesem Meer schnell Überblick gibt, ob die Person, die sie in einem Dokument genannt finden, schon über einen Datensatz verfügt oder neu angelegt werden muss. Die Doublettenfahndung wird zum Dauerthema werden, und wir wissen im Moment noch nicht, wie wir sie auf eine interessierte Community ausrichten und diese dabei technisch unterstützen.
  • Eigene diffizile Fachgebiete werden bei uns entstehen: In Millionen der GND-Personeneinträge finden sich Berufsangaben; bei uns wird aus jeder solchen Angabe ein Datenbankobjekt werden, zu dem nun eigene Aussagen zu machen sind. Wir werden hier Fachleute in verschiedensten Gebieten anziehen müssen, die derartige Felder zu durchdringen und zu erschließen wissen.
  • Wir brauchen Mitspieler, die schlicht Community-Erfahrung haben: Das FactGrid visiert die breite Nutzung an, auch wenn wir dabei auf die Verwendung von Klarnamen setzen. Im gelingenden Fall wird das FactGrid in den Wikipedia-Geschichtsprojekten beliebt werden und Accounts an Universitäten, in Bibliotheken und Archiven vergeben. Lokale Geschichtsvereine und Internet-Genealogie-Projekte sollten an der entstehenden Ressource mit ihren komplexen Vernetzungsangeboten Interesse gewinnen.
  • Wir werden das FactGrid mit einer Benutzeroberfläche ausstatten müssen, die technische Laien am SPARQL-QueryService und an den wuchernden Wikibase Eingabeseiten vorbeiführt. Suchmasken, die vermutlich direkt auf Seiten unseres (im Moment noch nicht sonderlich gut funktionierenden) Reasonator-Angebots führen, das Benutzer in beliebigen Sprachen mit strukturierten Datenblättern bedienen wird, könnten der Zielpunkt sein.
  • Wir werden schließlich Hilfe in der Datenbank-Betreuung benötigen. Hier ist ganz besonders misslich, dass unser Projekt im Moment vor allem die Arbeit von Geschichtsfachleuten ist, die nicht in jedem Moment bereits im Blick haben, wie sie die Technik optimal beliefern.

Das FactGrid wird wachsen und Mitspieler brauchen, die in diesem Wachstum vor allem Raum für ihre ganz eigene Projekte entdecken werden.

Mehr

  • Barbara Fischer & Jens Ohlig, “Neues Testfeld für Wikibase: Eine Bundesbehörde geht auf Expedition im Wikiversum.” 9. Mai 2019 at https://blog.wikimedia.de

Nachfolgend der Text der getroffenen Vereinbarung:


Memorandum of Understanding

zwischen

Deutsche Nationalbibliothek, vertreten durch die Generaldirektorin, Frau Dr. Elisabeth Niggemann
Adickesallee 1
60322 Frankfurt am Main

Universität Erfurt, vertreten durch den Präsidenten, Herrn Prof. Dr. Walter Bauer-Wabnegg
Nordhäuser Straße 63
99089 Erfurt

ausführende Einrichtungen:

Forschungszentrum Gotha der Universität Erfurt
Schlossberg 2
99867 Gotha
im Folgenden: FZG

Forschungsbibliothek Gotha der Universität Erfurt
Schloss Friedenstein
99867 Gotha
im Folgenden: FBG

Präambel

Die Deutsche Nationalbibliothek hat die Aufgabe, lückenlos alle deutschen und deutschsprachigen Publikationen, Tonträger und Musikalien (einschließlich Netzpublikationen und digitaler Objekte) ab 1913, im Ausland erscheinende Germanica und Übersetzungen deutschsprachiger Werke sowie die zwischen 1933 und 1945 erschienenen Werke deutschsprachiger Emigranten zu sammeln, dauerhaft zu archivieren, bibliografisch zu verzeichnen sowie der Öffentlichkeit zur Verfügung zu stellen.

Die FBG und das FZG sind zentrale wissenschaftliche Einrichtungen der Universität Erfurt. In ihrer Arbeit sind sie auf der einen Seite auf die Gothaer Bestände ausgerichtet; über ihre Stipendienprogramme und Forschungsprojekte, mit Schwerpunkten in der Erforschung der Frühen Neuzeit und der Globalisierung des 19. Jahrhunderts, andererseits international aktiv.

Die nachfolgenden Vereinbarungen betreffen die vom FZG initiierte und vom Universitätsrechen- und Medienzentrum der Universität Erfurt unter der URL https://database.factgrid.de gehostete Wikibase-Instanz, die seit dem August 2017 in einer Kooperation zwischen dem FZG und Wikimedia Deutschland aufgebaut wurde, um historischer Forschung insbesondere im Interesse an der internationalen Zusammenarbeit wissenschaftlicher Projekte zur Verfügung zu stehen.

Dies vorangestellt, treffen die DNB und die Universität Erfurt folgende Absichtserklärung:

§ 1 Gemeinsame Vorstellungen

Wikibase, die für Wikidata genutzte Software, soll sich in Zukunft zu einem funktionsfähigen Werkzeug für Wissenschaftler und wissenschaftliche Projekte entwickeln, mit dem in eigenen Installationen Daten offen und kollaborativ geteilt werden können.

Die gemeinfreien Daten der Gemeinsamen Normdatei (GND) – speziell die Daten für Personen und Körperschaften – sollen hierzu in der bestehenden Installation die Datengrundlage bieten, die es Wissenschaftlern erlaubt, Informationen in der Datenbank zu verknüpfen und anzureichern.

Für die GND liegt hierin ein erster Testfall einer größeren Datenintegration in eine Wikibase Instanz. Größere Aufgabenfelder werden im Rahmen dieser Vereinbarung im Blick zu halten sein: Wie lässt sich eine Wikibase Instanz in einen kontinuierlichen Datenabgleich mit Schwesterprojekten bzw. anderen Wikibase Instanzen bringen? Wie lassen sich etablierte Nutzungen der GND auf Seiten von Anwendern und Recherchierenden in neuer Systemumgebung realisieren?

§ 2 Gemeinsame Ziele

Die Partner wollen – im Rahmen ihrer Ressourcen und Möglichkeiten – im Erfahrungsaustausch miteinander die bestehende FactGrid Wikibase-Instanz mit Personen- und Körperschaftsdaten der GND befüllen.

Folgendes soll in diesem Projekt umgesetzt und evaluiert werden:

  1. Import von GND-Datensätzen in die (Factgrid-)Wikibase-Instanz
  2. Anforderungserhebung zur Synchronisation von Daten verschiedener Wikibase-Instanzen
  3. Anforderungserhebung für das Retrieval
  4. Evaluation bestehender Werkzeuge zur Qualitätssicherung und zur Präsentation der Daten
  5. Dokumentation der Projektarbeit und der Evaluationsergebnisse

§ 3 Aktivitäten

Zusammenarbeit

Die Partner stellen ein Team zusammen, das sich im ersten halben Jahr nach Vereinbarungsabschluss mindestens alle sechs Wochen in Treffen und Video-Konferenzen koordiniert und Aufgaben unter sich aufteilt.

Bis zum März 2019 streben sie die Erstellung eines Arbeitsplans mit Aufgabenverteilungen an.

Die DNB erhält Zugriff auf die Datenbank und administrative Benutzer-Accounts im FactGrid.

Die Partner dokumentieren im Blick auf spätere Datenbankverbindungen zu Wikidata und eventuellen DNB-Wikibase-Instanzen ihre Designentscheidungen und Arbeitserfahrungen.

Kommunikation

Die DNB und das FZG/FBG benennen einander je einen Ansprechpartner für alle im Rahmen der Zusammenarbeit abzustimmenden Angelegenheiten. Die Beteiligten sorgen dafür, dass sie sich regelmäßig gegenseitig über Vorhaben und Projekte in den gemeinsamen Arbeitsbereichen informieren.

Die Partner nutzen die ihnen zur Verfügung stehenden Kommunikationskanäle, um die Öffentlichkeit und ihre Communities über gemeinsame Aktivitäten zu informieren. Kommunikation nach außen, die das gemeinsame Vorhaben betrifft, wird vor Veröffentlichung immer zwischen den Partnern abgestimmt.

Für die Außenkommunikation räumen sich die Partner wechselseitig das nicht-ausschließliche, zeitlich auf die Laufzeit dieser Vereinbarung begrenzte und nur mit vorheriger Zustimmung übertragbare Recht ein, die von dem jeweils anderen Partner zur Verfügung gestellten Logos-, Namens-, Bild- oder Markenrechte zum Zwecke der Durchführung der vorliegenden gemeinsamen Ziele zu nutzen; dies gilt nur, soweit dies rechtlich zulässig ist und keine Rechte Dritter entgegenstehen. Die für die vereinbarten Zwecke benötigten Materialien, Abbildungen etc. werden kostenfrei vom jeweiligen Partner zur Verfügung gestellt. Die Partner verpflichten sich, die graphischen Gestaltungsvorgaben des jeweils anderen zu erfüllen.

§ 4 Dauer

Diese Vereinbarung tritt mit ihrer Unterzeichnung in Kraft. Sie gilt zunächst für 12 Monate und kann danach jederzeit unter Einhaltung einer Frist von 30 Tagen zum Ende eines Kalendervierteljahres einseitig gekündigt oder im beiderseitigen Einvernehmen vorzeitig beendet werden.

§ 5 Sonstiges

Durch diese Vereinbarung entstehen der DNB und der Universität Erfurt keine finanziellen Verpflichtungen. Die Partner stellen jeweils die auf ihrer Seite notwendigen Personal- und Sachleistungen zur Verfügung und tragen die ihnen dadurch entstehenden Kosten selbst. Wechselseitige Schadensersatzansprüche sind ausgeschlossen. Bei Ansprüchen Dritter haftet der Verursachende allein und ausschließlich.

Frankfurt am Main,
den 25.03.2019
Dr. Elisabeth Niggemann
Erfurt,
den 15. MRZ. 2019
Prof. Dr. Walter Bauer-Wabnegg


Scan der originalen Vereinbarung

„Archivführer zur deutschen Kolonialzeit“ online – ein Gespräch mit Uwe Jung, FH Potsdam, über den Einsatz von Wikidata als Forschungsplattform

Google translate English Version

Uwe Jung ist wissenschaftlicher Mitarbeiter beim Projekt “Quellen zur deutschen Kolonialzeit” an der Fachhochschule Potsdam. Die Beta-Version des Archivführers geht dieser Tage online. Im folgenden Interview geht es u.a. um die Frage, welche Rolle Wikidata im Projekt spielt.

Olaf Simons: Wir sprachen im vergangenen Sommer miteinander über die Möglichkeiten, Wikibase in Forschungsprojekten und bei der Präsentation von Forschungsarbeit einzusetzen, und tauschten uns dabei über verschiedene Optionen aus. Mit Ihrem Projekt gehen Sie soeben online. Worum geht es darin?

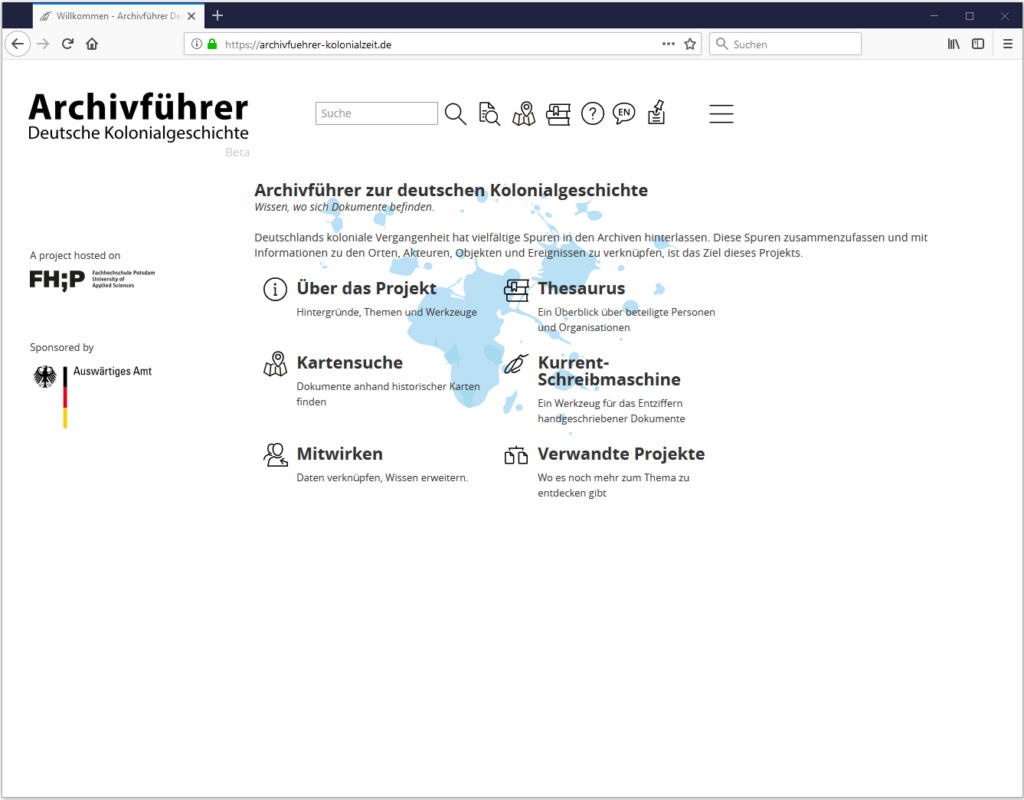
Uwe Jung: Deutschlands koloniale Vergangenheit hat vielfältige Spuren in den Archiven hinterlassen. Im Projekt “Archivführer zur Deutschen Kolonialgeschichte” https://archivfuehrer-kolonialzeit.de/ geht es darum, diese Spuren zusammenzufassen und mit Informationen zu den Orten, Akteuren und Ereignissen zu verknüpfen. Dabei kommt der freien Datenbank Wikidata eine zentrale Rolle zu.


Screenshot der Startseite https://archivfuehrer-kolonialzeit.de/

Olaf Simons: Das Projekt läuft an der Fachhochschule Potsdam?

Uwe Jung: Ja, das Projekt ist dort am Fachbereich Informationswissenschaften angesiedelt. Es wird zum größten Teil vom Auswärtigen Amt finanziert.

Olaf Simons: Sie entschlossen sich schon in der Antragsphase auf eine Realisierung mit Wikidata als Datenbank zu setzen – war das mutig? und was gab die Idee dazu?

Uwe Jung: Ich denke, mehrere Punkte haben dazu beigetragen. Zum einen war mir Wikidata bereits vorher bekannt. Persönlich unterstütze ich die freie Zugänglichmachung von Wissen. Die verschiedenen Wikimedia-Projekte sind hierfür sicher ein zentraler Ort. Zum anderen wurde mir aufgrund meiner beruflichen Erfahrung in Kamerun klar, dass es in den Nachfolgestaaten der deutschen Kolonien andere Prioritäten bei der Beschäftigung mit der gemeinsamen Geschichte gibt. Wir haben das Problem, dass Thesauri und Vokabulare in Europa häufig nur einen europäischen Blick auf diese Geschichte werfen. Das fängt bei der Schreibweise von Namen und Orten an. Viel wichtiger ist aber noch die Tatsache, dass z.B. in der Gemeinsamen Normdatei, an sich ein sehr gutes Werkzeug, in der Regel nur Entitäten auftauchen, die entweder selbst veröffentlicht haben oder über die zentral in einem Werk berichtet wird. Das Vokabular selbst wird in Europa verfasst, also weitgehend unter Ausschluss der “anderen” Seite.

Wikidata bietet nunmehr die Möglichkeit, gemeinsam an einem Vokabular zu arbeiten und ganz nebenbei auch noch das Thema “Kolonialgeschichte” in einen historischen Gesamtzusammenhang zu stellen.

Olaf Simons: Das ist, nebenbei, unser aktuelles Projekt: die gesamte GND – Personen und Körperschaften in unsere Instanz importieren und, soll ich sagen: sie öffnen? In jedem Fall sie benutzen und sie veränderbar machen – gemeinsam mit der GND, denn dort sieht man die Problemstellen nicht minder.

Wie sieht in Ihrem Projekt das Verhältnis von Projektarbeit und Mitarbeit der Öffentlichkeit aus? (Das ist in unseren Projekten ein zentraler Punkt: wir sind es die darin einen Großteil der Erschließungsarbeit in Teams oder in der Forschung Einzelner leisten).

Uwe Jung: Was die praktische Erfahrung betrifft, stehen wir noch am Anfang. Die Arbeit an der Seite selbst und das Zusammentragen von archivischen Beschreibungen hatten bisher Vorrang. Geplant ist, dass über eine thematische Wikimedia User Group zukünftig die Arbeit zum Thema Kolonialgeschichte koordiniert werden soll. Dabei lassen wir uns von folgenden Überlegungen leiten: Erstens basiert die Partizipation der Öffentlichkeit meistens auf freiwilliger Basis. Es kann also niemand gezwungen werden. Besser ist es, die Leute dort abzuholen, wo sie sich zu Hause fühlen. In ihrem jeweiligen Teilthema. Zweitens gibt es bereits viele Personen, welche in verschiedenen Wikimedia-Projekten sich mit Teilaspekten des Themas beschäftigt haben. Die Wikimedia User Group würde also lediglich auf Vorhandenem aufbauen. Das dann jedoch zum Vorteil aller. Wie gesagt, es geht hier nicht nur um Wikidata, sondern auch um Wikipedia, Wikisource und andere Projekte. Für Wikidata ist jetzt mit dem WikiProject “European Colonialism” ein Anfang gesetzt.

Olaf Simons: Bei der Arbeit über die Kontinente hinweg dürfte die Mehrsprachigkeit von Wikidata interessant werden. Wie wird die Software in Afrika angenommen?

Uwe Jung: Ich habe den Eindruck, dass es für die Leute einfacher ist, Fakten miteinander zu verknüpfen, als längere Texte in einem enzyklopädischen Stil zu verfassen. Vorausgesetzt, die Zuordnung der Properties ist klar. Wir sollten nicht vergessen, dass die Art und Weise, wie Lexika verfasst sind, keine universell gültige ist.

Olaf Simons: Keine universell gültige – und auch keine besonders neutrale, ist doch in unserem Kulturraum die Tatsache, dass man eines Lexikon-Eintrags “würdig” wird, so etwas wie der bildungsbürgerliche Ausweis von persönlicher sozialer Bedeutung geworden…

Unser eigenes Projekt ging aus eigenen Debatte mit Leuten des Wikidata-Projektes hervor; sie ermutigten uns, eine eigene Instanz aufzumachen. Ein wichtiges Argument war dabei, dass wir im externen Bereich sozusagen als “Incubator for Original Research” agieren können – als eine Seite, auf der es möglich wird, Dinge zu konstatieren, die noch nicht veröffentlicht sind, und die von hier aus erst zitierbar werden.

Gibt es in Eurem Projekt an dieser Stelle Grenzen, wo Ihr das Gefühl habt, das würden wir gerne mit der öffentlichen Ressource Wikidata tun, aber könnten wir so eigentlich nur auf einer eigenen Ressource riskieren?

Uwe Jung: Nein, die sehe ich nicht. Koloniale Geschichte wirkt bis heute täglich nach. Sie ist ein Politikum und sie wird von vielen Seiten aus betrachtet und interpretiert. Wir sind uns im Projekt darüber bewusst, dass eine Vollständigkeit und Unveränderbarkeit der Daten nicht erreicht werden kann. Das gilt sowohl für die archivischen Beschreibungen als auch für die “Norm”-Daten. Es soll keine “Bibel” werden, sondern vielmehr Hinweise auf derzeit noch verborgene Informationen und Zusammenhänge geben. Aufzeigen, was alles zum Thema gehört und wie weit es in die verschiedenen Sphären der damaligen und heutigen Gesellschaften hinein reicht.

Olaf Simons: Eine solche Problemstelle sind in unserem letzten Projekt die Dokumente, über die wir arbeiten – Akten, die wir zwar zitieren und transkribieren dürfen, die jedoch ansonsten nur eingeschränkt öffentlich zugänglich sind. Es wäre eigenartig, für diese Objekte so einfach Wikidata-Items zu eröffnen. Ein zweites Problem ist, dass wir die Datenbank als Arbeitswerkzeug benutzen, gerade auch um etwa Datierungen einfach einmal versuchsweise zu setzen und dann zu sehen, wie eine solche Entscheidung in der Arbeit aufgeht.

Woher kommen bei Euch die Dokumente? Ich sah beim Probeblick in den Internet-Auftritt, dass Dokumente eine wichtige Rolle spielen.

Uwe Jung: Das wäre in der Tat eigenartig. Zwar ließen sich in Wikidata auch archivierte Dokumente beschreiben, doch sind diese Beschreibungen selbst wohl besser bei den besitzenden Einrichtungen aufgehoben. Etwas anderes ist die Anreicherung von Daten zum besseren Verständnis der Dokumente. Diese neu hinzukommenden Daten stehen aber für sich selbst und brauchen nicht zwangsläufig mit einem bestimmten Dokument verknüpft zu werden. Vielmehr bieten das Datenmodell und die implementierten Tools von Wikidata die Möglichkeit, diese Daten mit vielen anderen Beschreibungen zu verknüpfen, z.B. Publikationen, Denkmäler, Museumsobjekte, Geschichten, Kochrezepte u.s.w.


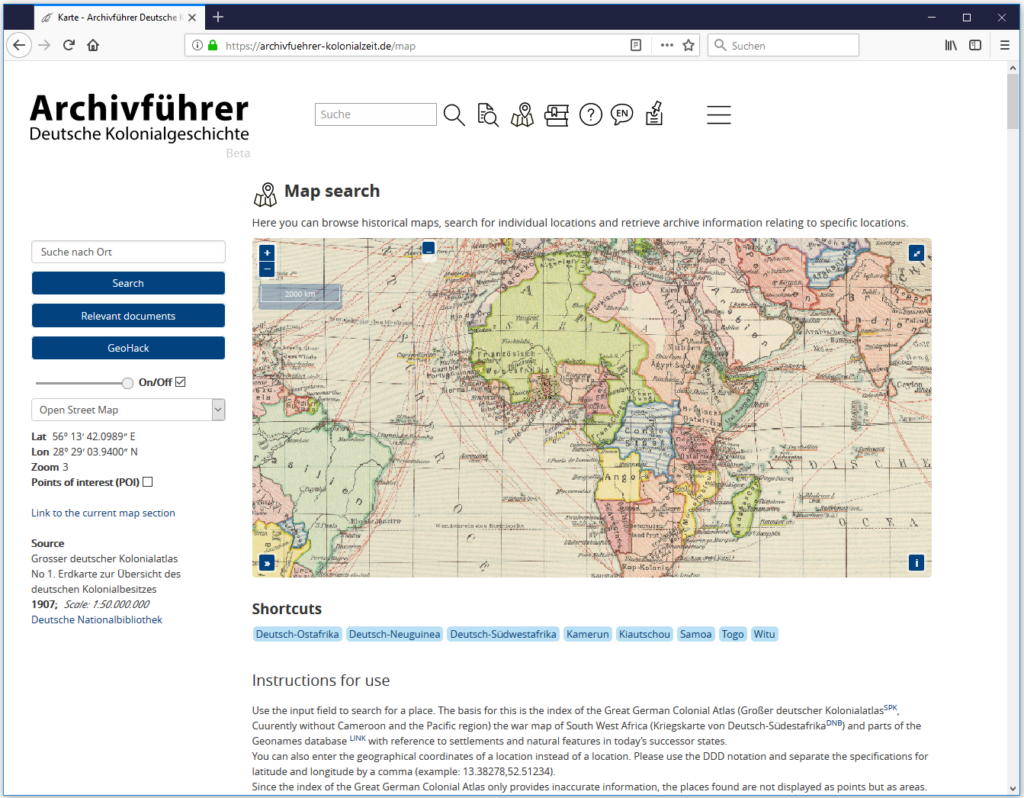
Der Kartenbrowser https://archivfuehrer-kolonialzeit.de/map

Olaf Simons: Euer Webauftritt hat sich seit dem Juni sehr verändert. Was bietet Ihr wem?

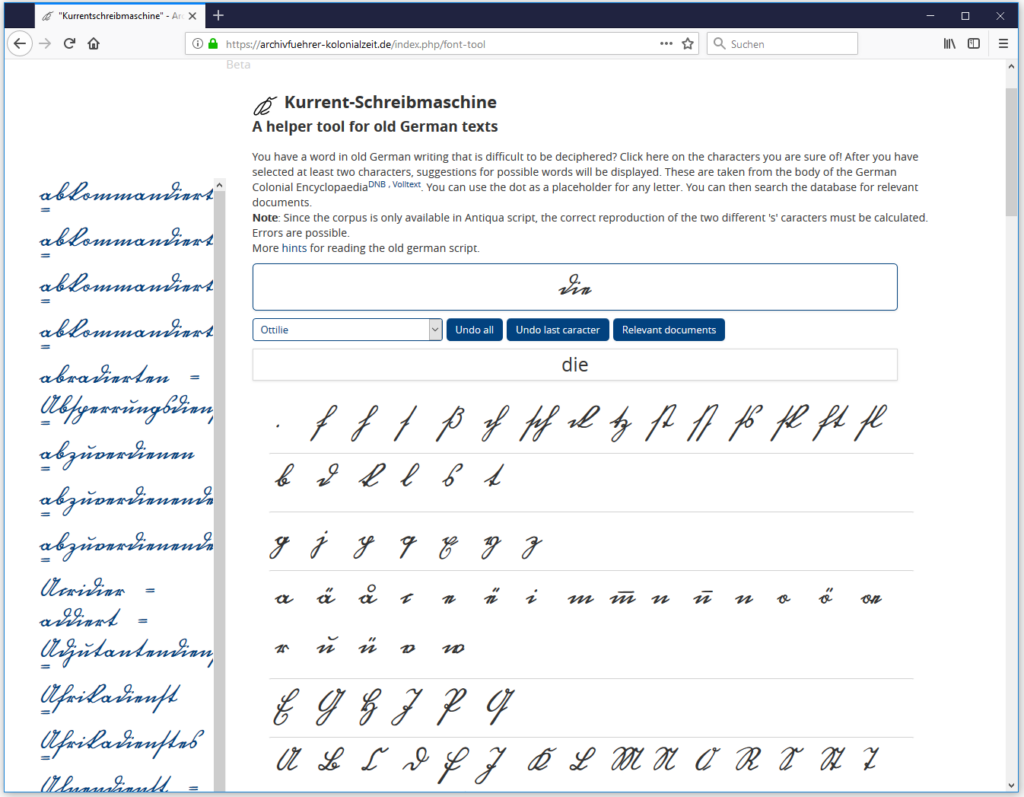
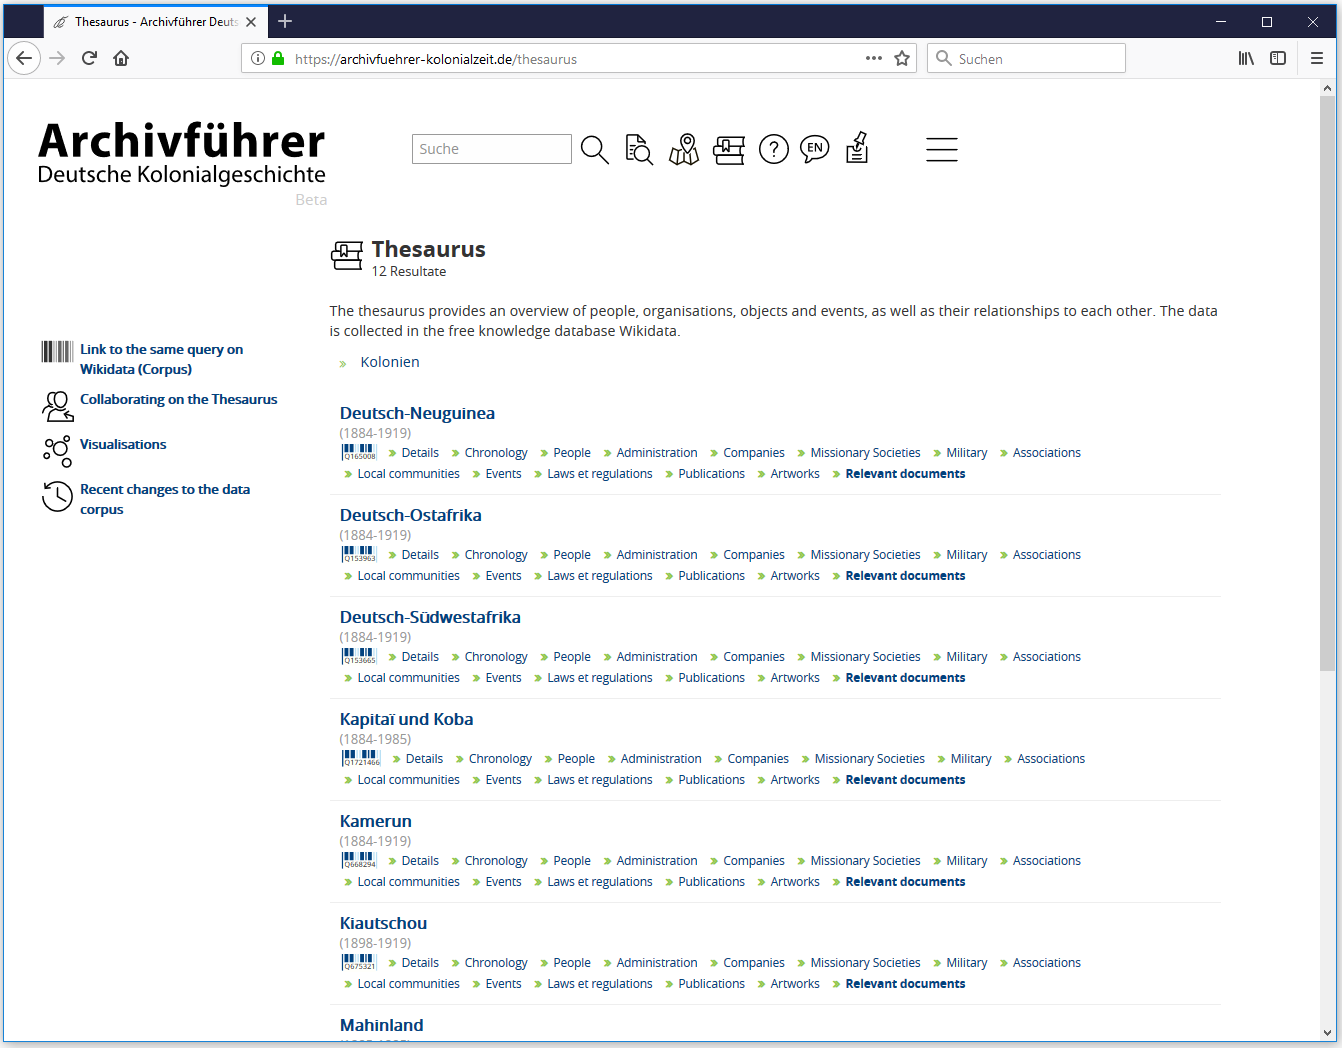
Uwe Jung: Es ist wichtig, die unterschiedliche Herangehensweise beim Publikum im Blick zu behalten. Deshalb gibt es zum Beispiel mehrere Sucheinstiege. Neben “Suchschlitz”, Facettensuche und erweiterter Suche kann auch ein Einstieg über die Normdaten erfolgen. Zusätzlich gibt es den Einstieg über den Thesaurus, welcher de facto ein Set von Wikidata-Abfragen darstellt. Und einen historischen Kartenbrowser, welcher wiederum mit einem historischem geografischen Index verknüpft ist. Eine weitere Besonderheit ist die “Kurrentschreibmaschine”, ein Werkzeug, das beim Lesen von alten Texten helfen soll.


Screenshot der Kurrentschreibmaschine

Olaf Simons: “Archivportal zur deutschen Kolonialgeschichte, Wissen, wo sich Dokumente befinden. Deutschlands koloniale Vergangenheit hat vielfältige Spuren in den Archiven hinterlassen. Diese Spuren zusammenzufassen und mit Informationen zu den Orten, Akteuren und Ereignissen zu verknüpfen, ist das Ziel dieses Projekts.” steht auf der Startseite. Ihr versucht, zu erfassen, wo es überhaupt Dokumente zur deutschen Kolonialgeschichte gibt. Wie geht Ihr dabei mit den Archivkatalogen und den größeren Verbundkatalogen (etwa dem Arcinsys) um, die ja ihre Archivalien gar nicht alle in Wikidata anmelden?

Uwe Jung: Auch wenn sich eventuell noch etwas am Einleitungstext ändern wird, die Intention bleibt gleich. Archivkataloge sind sicher ein Thema für sich. Auch hier basiert vieles auf der Freiwilligkeit. Eine große Hilfe sind die Deutsche Digitale Bibliothek bzw. das Archivportal-D. Viele Einrichtungen sind dort bereits vertreten und ermöglichen auch die Übernahmen von Metadaten. Ähnliches gilt für den Kalliope-Verbund. Einige Archive, wie z.B. das Bundesarchiv, stellen die Daten ihrer Bestände komplett als Open Data zum Download zur Verfügung. Von anderen haben wir die Daten in isolierter Form erhalten und konvertiert. Wiederum bei anderen Einrichtungen haben wir die Daten zunächst aus deren Online-Katalog gezogen und dann abgesprochen, was davon übernommen werden kann. Nicht zu vergessen ist, dass die Landschaft sehr heterogen ist und sich “Archivalien” letztendlich überall befinden können. Nicht nur in Archiven. Die Besucher/innen wiederum dürften wahrscheinlich eher daran interessiert sein, alles zusammen geliefert zu bekommen. Also Publikationen, Archivalien, Museumsobjekte, Debatten, usw.

Olaf Simons: Sicher auch zu recht. – Technisch gesehen habt Ihr eine Benutzeroberfläche aufgebaut, die Suchanfragen an Wikidata weitergibt – und an weitere Kataloge? (oder ist Wikidata hier das Nadelöhr, über das Ihr auf weitere Kataloge zugreift?

Uwe Jung: Hier muss unterschieden werden. Wikidata wird von uns in verschiedenen Zusammenhängen benutzt. Zum einen in Form des Thesaurus auf der Webseite. Diese Übersicht basiert direkt auf Wikidata-Abfragen und dient der allgemeinen Information sowie als ein Sucheinstieg in die Datenbank innerhalb des Portals.

Für die Auswahl, welche Daten aus den verschiedenen Online- und Offline-Katalogen übernommen werden, wird ebenfalls Wikidata benutzt. Hierzu gibt es eine zentrale Abfrage, die einen Korpus an Objekten zum Thema generiert. Die Labels und AlternateLabels aus diesem Ergebnis-Set dienen wiederum als Suchbegriffe für die Abfragen in den Katalogen. Ein Script sorgt dafür, dass allzu viel Noise (wie z.B. “Müller”) nicht übernommen wird. Dieses Script ist regelbasiert, da ein Rückgriff auf neuronale Netze keine befriedigenden Ergebnisse brachte.

Ein weiteres Mal wird Wikidata verwendet, um die zusammen mit den Beschreibungen importierten Normdaten der jeweiligen Einrichtungen zu vereinheitlichen. Die Normdaten werden über ihre Bezeichnungen mit existierenden Wikidata-Objekten verknüpft. Auch hier wird ein Großteil mit Skripten erledigt. Allerdings wird dann auch immer noch eine manuelle Kontrolle notwendig.

Olaf Simons: Visualisierungen sind mit einem eigenen Programmpunkt im Angebot…

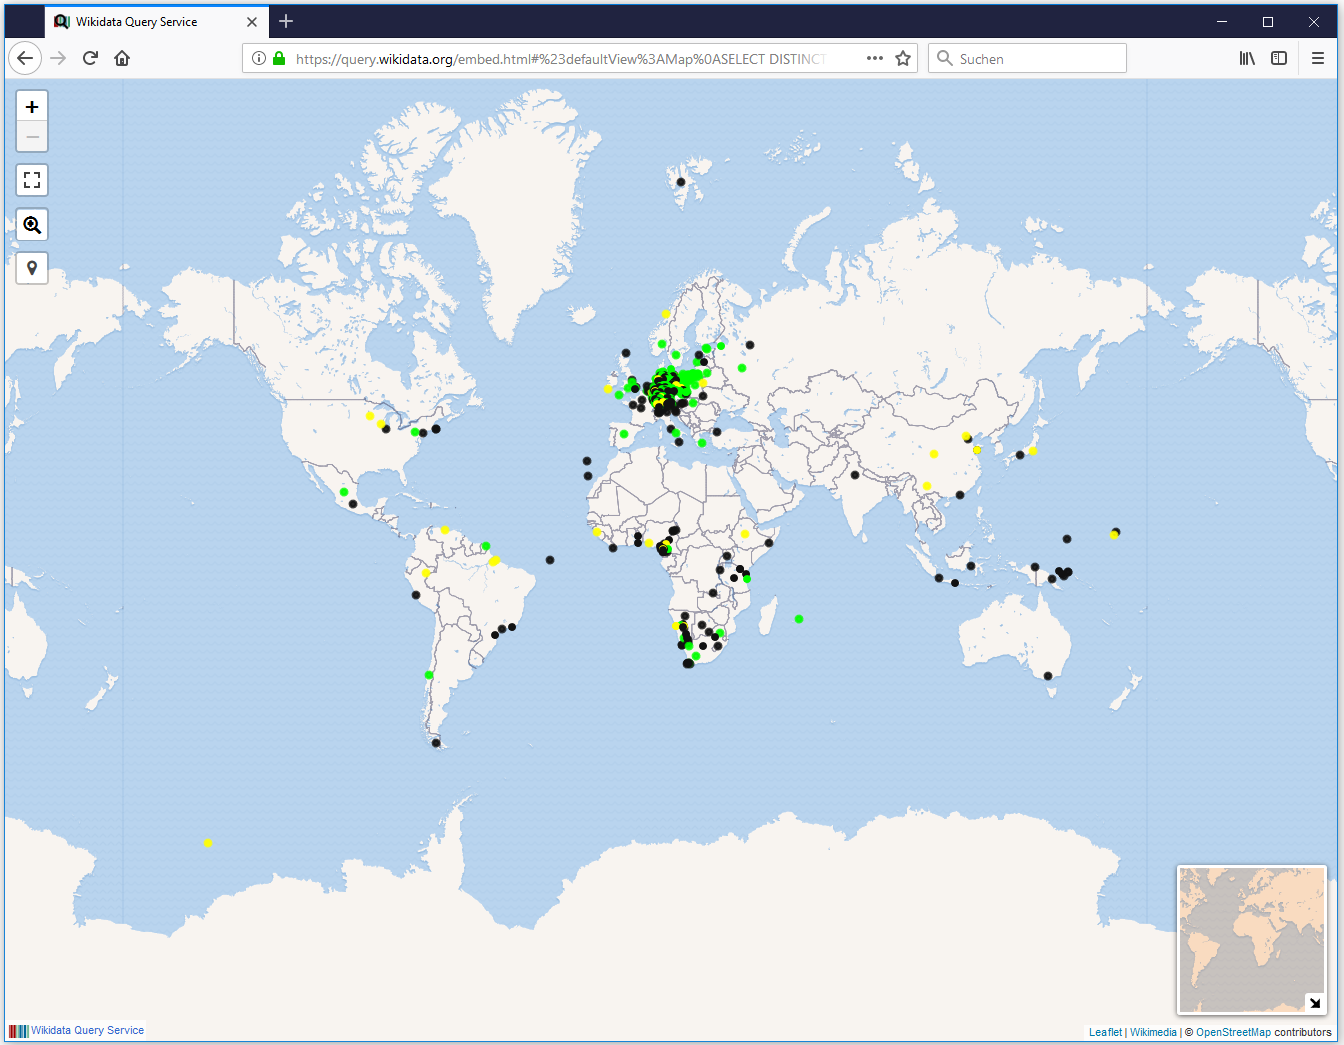
Uwe Jung: Ja, eine der Stärken von Wikidata ist die Möglichkeit, Beziehungen zu visualisieren. Wir nutzen hier u.a. den SPARQL-Endpoint mit seiner Möglichkeit auch Ausgaben  in Karten- oder Diagrammform zu generieren.

Wikidata Screenshot
Screenshot Wikidata-Abfrage: Geburts, Wirkungs- und Sterbeorte von Personen mit Bezug zum Thema deutsche Kolonialgeschichte

Olaf Simons: Davon, worauf Eure Seite zugreift, merkt man als Besucher, wenn man dann bei Ausgaben auf die “Datenquelle” sieht?


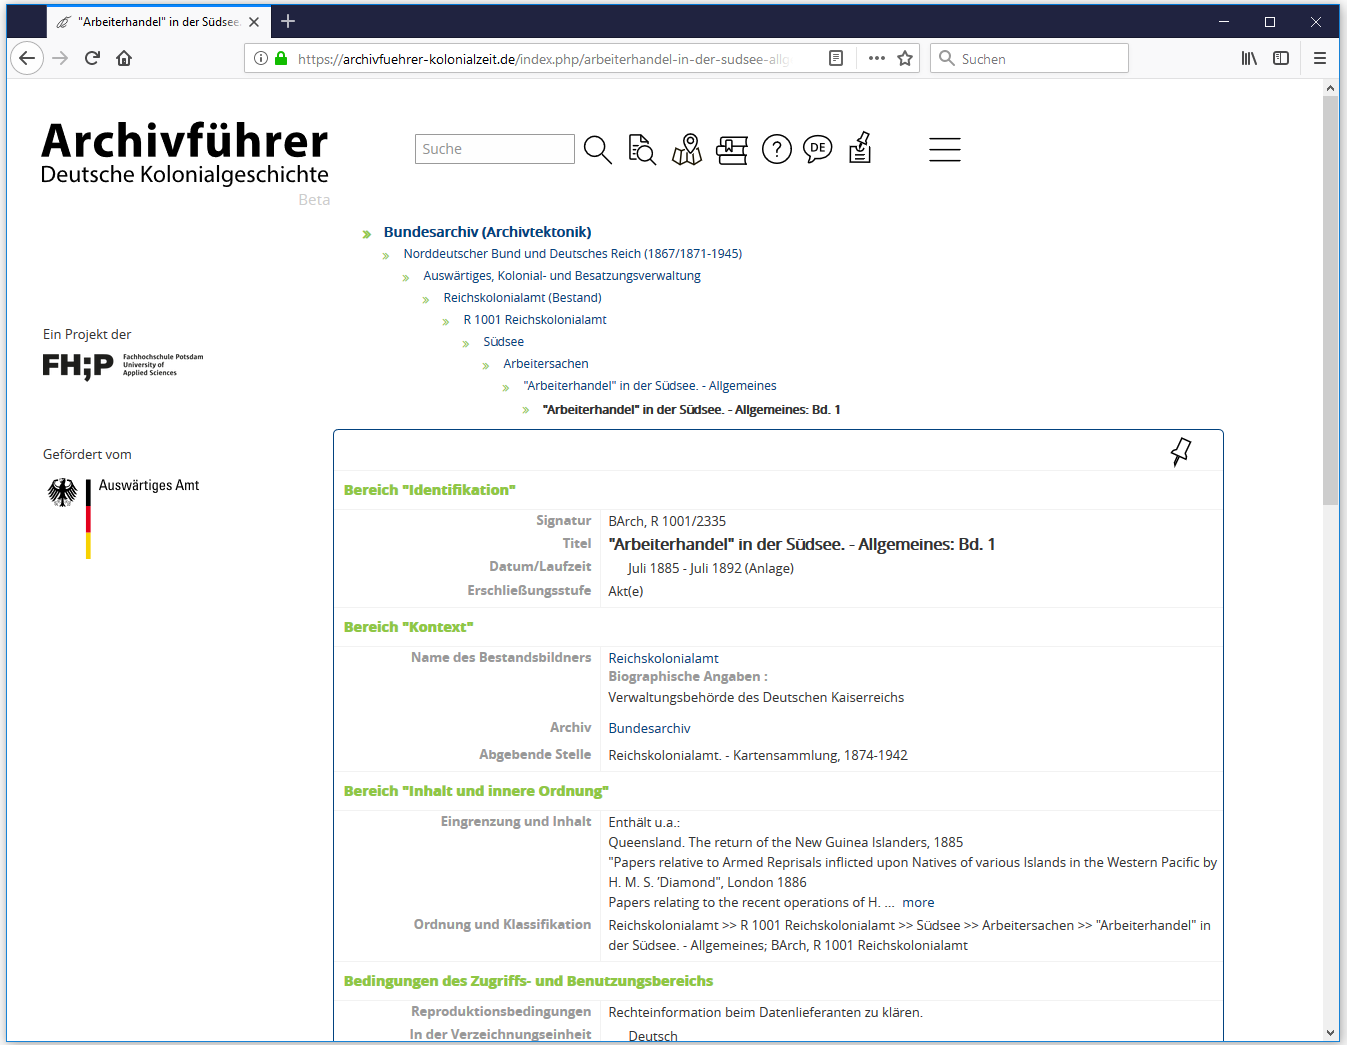
Schritte bei der Durchsuchung des Thesaurus – sukzessive Screesnhots

Uwe Jung: Sofern ein Link zur Webseite der besitzenden Einrichtung mit übernommen werden konnte, wird dieser eingeblendet. Mit etwas Glück geht es dann von dort aus zum Volltext weiter. Leider gibt es aber auch noch Online-Kataloge ohne Persistent Identifier bzw. Permanentlinks zu einzelnen Beschreibungen.

Die Beschreibungen selbst werden einmalig übernommen, automatisch übersetzt und in einer lokalen Datenbank gespeichert. Die Daten des Thesaurus werden direkt aus Wikidata eingespielt, lassen sich also jederzeit von Dritten ändern und hoffentlich auch erweitern. Ein weiteres Script sorgt dafür, dass wir Änderungen am Korpus während der letzten 7, 30 bzw. 90 Tage zurückverfolgen, um eventuell auf Vandalismus reagieren zu können. Das alles spielt sich dann aber in Wikidata ab.

Olaf Simons: Und ist in Java-Script Interaktionen mit den Datenanbietern organisiert?

Uwe Jung: Nein, das wäre zu aufwändig. Wir verweisen darauf, dass Daten auf deren Webseiten aktueller und vollständiger sein können.

Olaf Simons: Ich meine Euer Angebot – wie ist das technisch gestrickt und woher hattet Ihr die Expertise, so etwas zu stemmen?

Uwe Jung: Die “Expertise” beantwortet gerade diese Frage 😉 Ich habe Afrikanistik mit der Spezialisierung Geschichte studiert. Hinzu kamen noch ein Studium in Bibliotheks- und Informationswissenschaften, Erfahrungen in der Auswärtigen Kultur- und Bildungspolitik und diverse IT-Kenntnisse. Vieles musste nebenbei noch gelernt werden, schließlich ändern sich Technologien ständig. Eine sehr große Hilfe sind dabei die diversen offenen Technologien. Für die gibt es im Netz viel Unterstützung und Anleitungen. Und man ist unabhängig von Service-Verträgen proprietärer Softwareanbieter.

Technisch basiert das Portal auf der freien Archivsoftware AtoM, die wiederum auf einem Ubuntu-Server agiert. Die Datenimporte und deren Weiterverarbeitung erfolgen hauptsächlich durch Python-Skripte. Für die Präsentation helfen Javascript zusammen mit den Frameworks jQuery und OpenLayer. Für die Georeferenzierung und Kachelung der Karten wurde QGIS mit den Plugins Georeferencer und QTiles benutzt.

Olaf Simons: Gut, Wir sollten Sie mal ausleihen ;).

Uwe Jung: Ab 2020 gerne 😉

Olaf Simons: An welcher Stelle des Webauftritts wird die Chance zum Zuge kommen, den Benutzer selbst die Datensätze verändern zu lassen, oder eigene Datensätze einzuspeisen? Wikidata ist ja gerade hier als interaktive Software interessant. Aus der Startseite geht das Interaktive nicht klar hervor…

Uwe Jung: An der Startseite wird sich bis zum Start noch einiges ändern. Im Portal selbst wird es keine gespeicherten benutzergenerierten Inhalte geben. Hierfür müssten zuvor diverse datenschutzrechtliche Dinge beachtet werden. Der Aufwand wäre zu hoch. Die eigentliche Interaktivität ist in der anzustrebenden Wikimedia User Group zu suchen. Vollständigere Daten im Wikidata-Korpus führen automatisch zu einem besseren Thesaurus im Portal. Außerdem ist es schwer, freiwillige Mitarbeit zu bekommen, wenn die Ergebnisse dieser Mitarbeit nicht unmittelbar und für alle zugänglich sind. Das Portal ist quasi nur ein Auszug aus (in der Mehrheit) bereits öffentlich einsehbaren Daten, welche rund um ein Thema gefiltert werden. Und selbst dieser Filter kann aufgrund der Vielschichtigkeit des Themas niemals fehlerfrei die Spreu vom Weizen trennen. Für die Zukunft wäre zu wünschen, dass sich ähnliche Portale zu anderen Themen mit weniger Aufwand herstellen lassen.

Nur um einen Einblick in die Vielfalt zu geben. Diverse Hauptverantwortliche der mörderischen Schlachten des ersten Weltkriegs waren zuvor einige Zeit in den Kolonien tätig. Zu nicht Wenigen davon gibt es verzeichnete Nachlässe. In den Kolonien waren Ingenieure tätig, zu deren Arbeiten es Pläne gibt. Das gleiche gilt für Naturwissenschaftler*innen und Mediziner. Diverse Künstler haben sich am Thema versucht oder waren gar vor Ort. Und über allen saßen Beamte mit ihren täglichen Problemen, die versucht haben, das Ganze zu verwalten. Unter anderem auch, damit einige Unternehmen und Missionen vor Ort tätig werden konnten. Schließlich spielte die Anti-Kolonialfrage spätestens ab 1919 eine wichtige Rolle in Systemauseinandersetzungen zwischen Ost und West. Sie finden also nüchterne amtliche Berichte neben wissenschaftlichen Abhandlungen, Gemälde neben Kartenwerken und Urlaubsfotos neben dem Ernst-Thälmann-Lied in Duala-Übersetzung.

Was jedoch klar wird, die deutsche Kolonialgeschichte lässt sich nicht auf einige herausragende historische Ereignisse bzw. auf einen reinen militärisch-politischen Aspekt reduzieren. Sie ist kein fest eingegrenztes Teilstück der deutschen Geschichte, welches sich bei Bedarf ausklammern lässt. Sie lässt sich eher mit einer Vielzahl von Flecken vergleichen, die zu einer nur scheinbar weißen Wand mit dazu gehören.

Olaf Simons: Vielen Dank für die Einblicke und das Interview.

Uwe Jung: Gern geschehen 😉


Bildquelle Featured Image: Uniformierung der Schutztruppe für Deutsch-Ostafrika (Brockhaus 1892), Dateiquelle Wikimedia Commons.

Die Illuminatenakten Online: Einige Bemerkungen zu den ersten knapp 16.000 Datensätzen des FactGrid

in English

Das FactGrid (noch immer ohne ein eigenständiges Design) erhielt in den letzten Wochen seine ersten Projektdaten – Daten aus der Illuminatenforschung Halles und Gothas der letzten 20 Jahre, die hier kurz umrissen seien.

Rudimentär sind in diesem Stadium noch die Datensätze zu den gut 2.000 gelisteten Personen. Etwa 1.350 von ihnen waren Illuminaten, die übrigen zumeist Personen, die von ihnen in Briefen erwähnt wurden. Wir schrecken im Moment vor der Eingabe der uns vorliegenden runderen Datensätze zurück, da sie weit interessanter in einer Kooperation mit der GND und unterstützt durch Katrin Möllers Hallenser Projekt zu Erwerbsbiographien geschähe. Verhandlungen in beide Richtungen laufen. Rudimentär sind im selben Moment auch die gut 2,000 Titel Forschungsliteratur zum Illuminatenorden gelistet. Auch hier wurde uns klar, dass es interessant wäre, diese Arbeit von vornherein an bibliothekarische Katalogsysteme anzulehnen.

Im Zentrum bietet das FactGrid indes nun die gut 9.000 Dokumente, die aktuell in Forschungskreisen mit dem Illuminatenorden und ihren Aktenkonstellationen in Verbindung gebracht werden: Dokumente aus den Nachlässen Adam Weishaupts, Johann Joachim Christoph Bodes, der Gothaer Loge „Zum Compaß“, Ernsts II. von Sachsen-Gotha-Altenburg, sowie der 1786 und 1787 geschehenen Veröffentlichungen aus Bayern.

Etwa 3.000 dieser Dokumente sind sehr viel eingehender erfasst. Sie geben in ihrer obersten Schicht Einblick in Gothas Illuminatenforschung der letzten fünf Jahre: Unter der Projektleitung Martin Mulsows untersuchten Markus Meumann und ich von Nachwuchsforschern unterstützt „Illuminatenaufsätze“, mit ihrem Schwerpunkt im 13. Band der „Schwedenkiste“. Unsere Arbeit griff schnell in die benachbarten Bände aus. Christian Wirkner erschloss dabei in mehreren Schüben die Sitzungsprotokolle sowie einzelne Stränge der Betreuungskorrespondenz zwischen Mitgliedern und den „Unbekannten Oberen“ – den Austausch von „Quibus Licet“ und „Reprochen“. Der Gothaer Schwerpunkt liegt mithin in den Bänden 11 bis 16 der „Schwedenkiste“.

Das von uns aufgebaute „Illuminatenwiki“, die Gotha Illuminati Research Base, wirkte unerwartet in die Forschung hinein. Mit ihm kamen die Datensammlungen Hermann Schüttlers und Reinhard Markners ins Gehege, die bis in das Jahr 1998 zurückgehen. Hermann Schüttler publizierte 1991 das erste Kompendium zu den Mitgliedern des Ordens (und arbeitete diese bereits in die Gotha Illuminati Research Base ein: Die Mitglieder des Illuminatenordens). Gemeinsam mit Reinhard Markner erschloss er ab 2000 in großem Umfang die Ordenskorrespondenz. Eine Access Datenbank kam aus seiner Hand von hier aus in das Startangebot für das FactGrid – im FactGrid regulär mit der qid Item:Q11305 als Forschungsleistung ausgewiesen:

Hermann Schüttler zu diesem Datenbestand:

1. Was ist drin? Briefe vor allem aus a) dem Teilnachlaß von Adam Weishaupt im Staatsarchiv Hamburg, Depositum der „Vereinigten Fünf“ (Logen) Hamburg, sowie b) der „Schwedenkiste“, d.i. dem Nachlaß von Johann Joachim Christoph Bode, vermehrt um Papiere von Ernst II. von Sachsen-Gotha-Altenburg im Staatsarchiv Preußischer Kulturbesitz Berlin, zuvor Staatsarchiv der DDR, Merseburg. Dazu vereinzelt Material mit eindeutig illuminatischem Bezug verschiedenster Provenienz.
2. Wer hat wieviel von wann bis wann daran gearbeitet? Die Daten wurden während der Laufzeit des Projektes im IZEA zwischen Anfang 2000 und Mitte 2005 von Hermann Schüttler erfaßt und danach von Reinhard Markner teilweise ergänzt.
3. Welche Archive wurden besucht? Staatsarchiv der Freien und Hansestadt Hamburg, Geheimes Staatsarchiv Preußischer Kulturbesitz, Berlin, Bayerisches Hauptstaatsarchiv, München (Briefe Weishaupt im Bestand „Kasten Schwarz“), Pfälzische Landesbibliothek, Speyer (Nachlaß Schwanckhardt).
4. Welche Veröffentlichungen knüpfen sich daran? Die Titel, die sich jeweils unter der qid Item:Q11305 zur gesamten hier erbrachten Forschungsleistung gelistet finden.

Das FactGrid kann damit erstmals den Eisberg so halbwegs bemessen und im Projekt der Illuminatenakten Online in den Metadaten vorlegen. Zukünftige Projekte können von hier aus fortfahren. Mit ganz anderer Dynamik ließe sich das große hier angelegte Raster indes füllen, wenn wir mit der Datenbank die Digitalisate aller Dokumente zugänglich machen könnten. Das aber wird nur in einem Projekt denkbar werden, für das die Großlogen und Archive, in deren Eigentum respektive Besitz sich die meisten der Akten heute befinden, noch zu gewinnen bleiben.

Der kreative Part der Arbeit kann damit beginnen

Gegenüber dem bisherigen Wiki ist das FactGrid an einer Stelle strukturell im Nachteil: Das Wiki macht Transkripte und Zusammenfassungen von Hunderten Dokumenten sowie detaillierte Informationen zu Sitzungen des Ordens zugänglich (hier eine Musterseite zu einem Dokument – dem Dokument 70 im 13. Band der Schwedenkiste – im alten Wiki; hier die Datensammlung zum selben Dokument im FactGrid: Item:Q6641). Spannend wäre es, diese Texte und Informationen in der Datenbank selbst verfügbar zu machen. Wir werden zwei Werkverträge ausschreiben, einerseits um das alte Wiki zu entlasten, in dem wir Metadaten großflächig und laufend aktuell aus der Datenbank einspielen. Ein komplementärer Werkvertrag wird der Frage gelten, wie wir das konventionelle Wiki zur Vermeidung doppelter Arbeit im FactGrid (respektive in einer eigens zu gründenden FactGrid Ressource für Objektrepräsentationen) verlustfrei aufgehen lassen könnten (siehe hier die Vorformulierungen zu diesen beiden Werkverträgen).

An einer anderen Stelle ist die Datenbank dem bisherige MediaWiki bei weitem überlegen: Mit ihr ist die verfügbare Materiallage im großen Raster erfasst, in dem sich weiterforschen lässt – und die Tür geöffnet zum Data-Mining. Man wird nun daran gehen können, die gesamte Aktenproduktion kartographisch wie auf Zeitleisten zu erfassen. Man wird (insbesondere sobald die Personeninformationen zu den Berufen detaillierter eingegeben sind) durchleuchten können, wer mit wessen Fürsprachen welche Karrieren im Orden machte und dabei welche Netze des ordensinternen Austauschs generierte.

Gefragt sind damit zum einen Gruppen, die mit eigener Forschung im Feld weitermachen und zum anderen Data-Miner, Datenvisualisierer – und wir sind natürlich gespannt, welche Informationen sie dort sichtbar machen werden, wo wir bislang vor allem Detailinformationen mit dem gröberen Bauchgefühl der Beziehungen im Orden nachgehen. Der FactGrid Blog wird eine gute Adresse sein, um Daten-Analysen vorzulegen, die SPARQL-Begeisterte nun weit besser durchführen können als die Forscher hinter dieser Datenressource.

Mehr

In alphabetischer Reihenfolge: Lorenza Castella, Erik Liebscher, Reinhard Markner, Markus Meumann, Martin Mulsow, Hermann Schüttler, Olaf Simons und Christian Wirkner

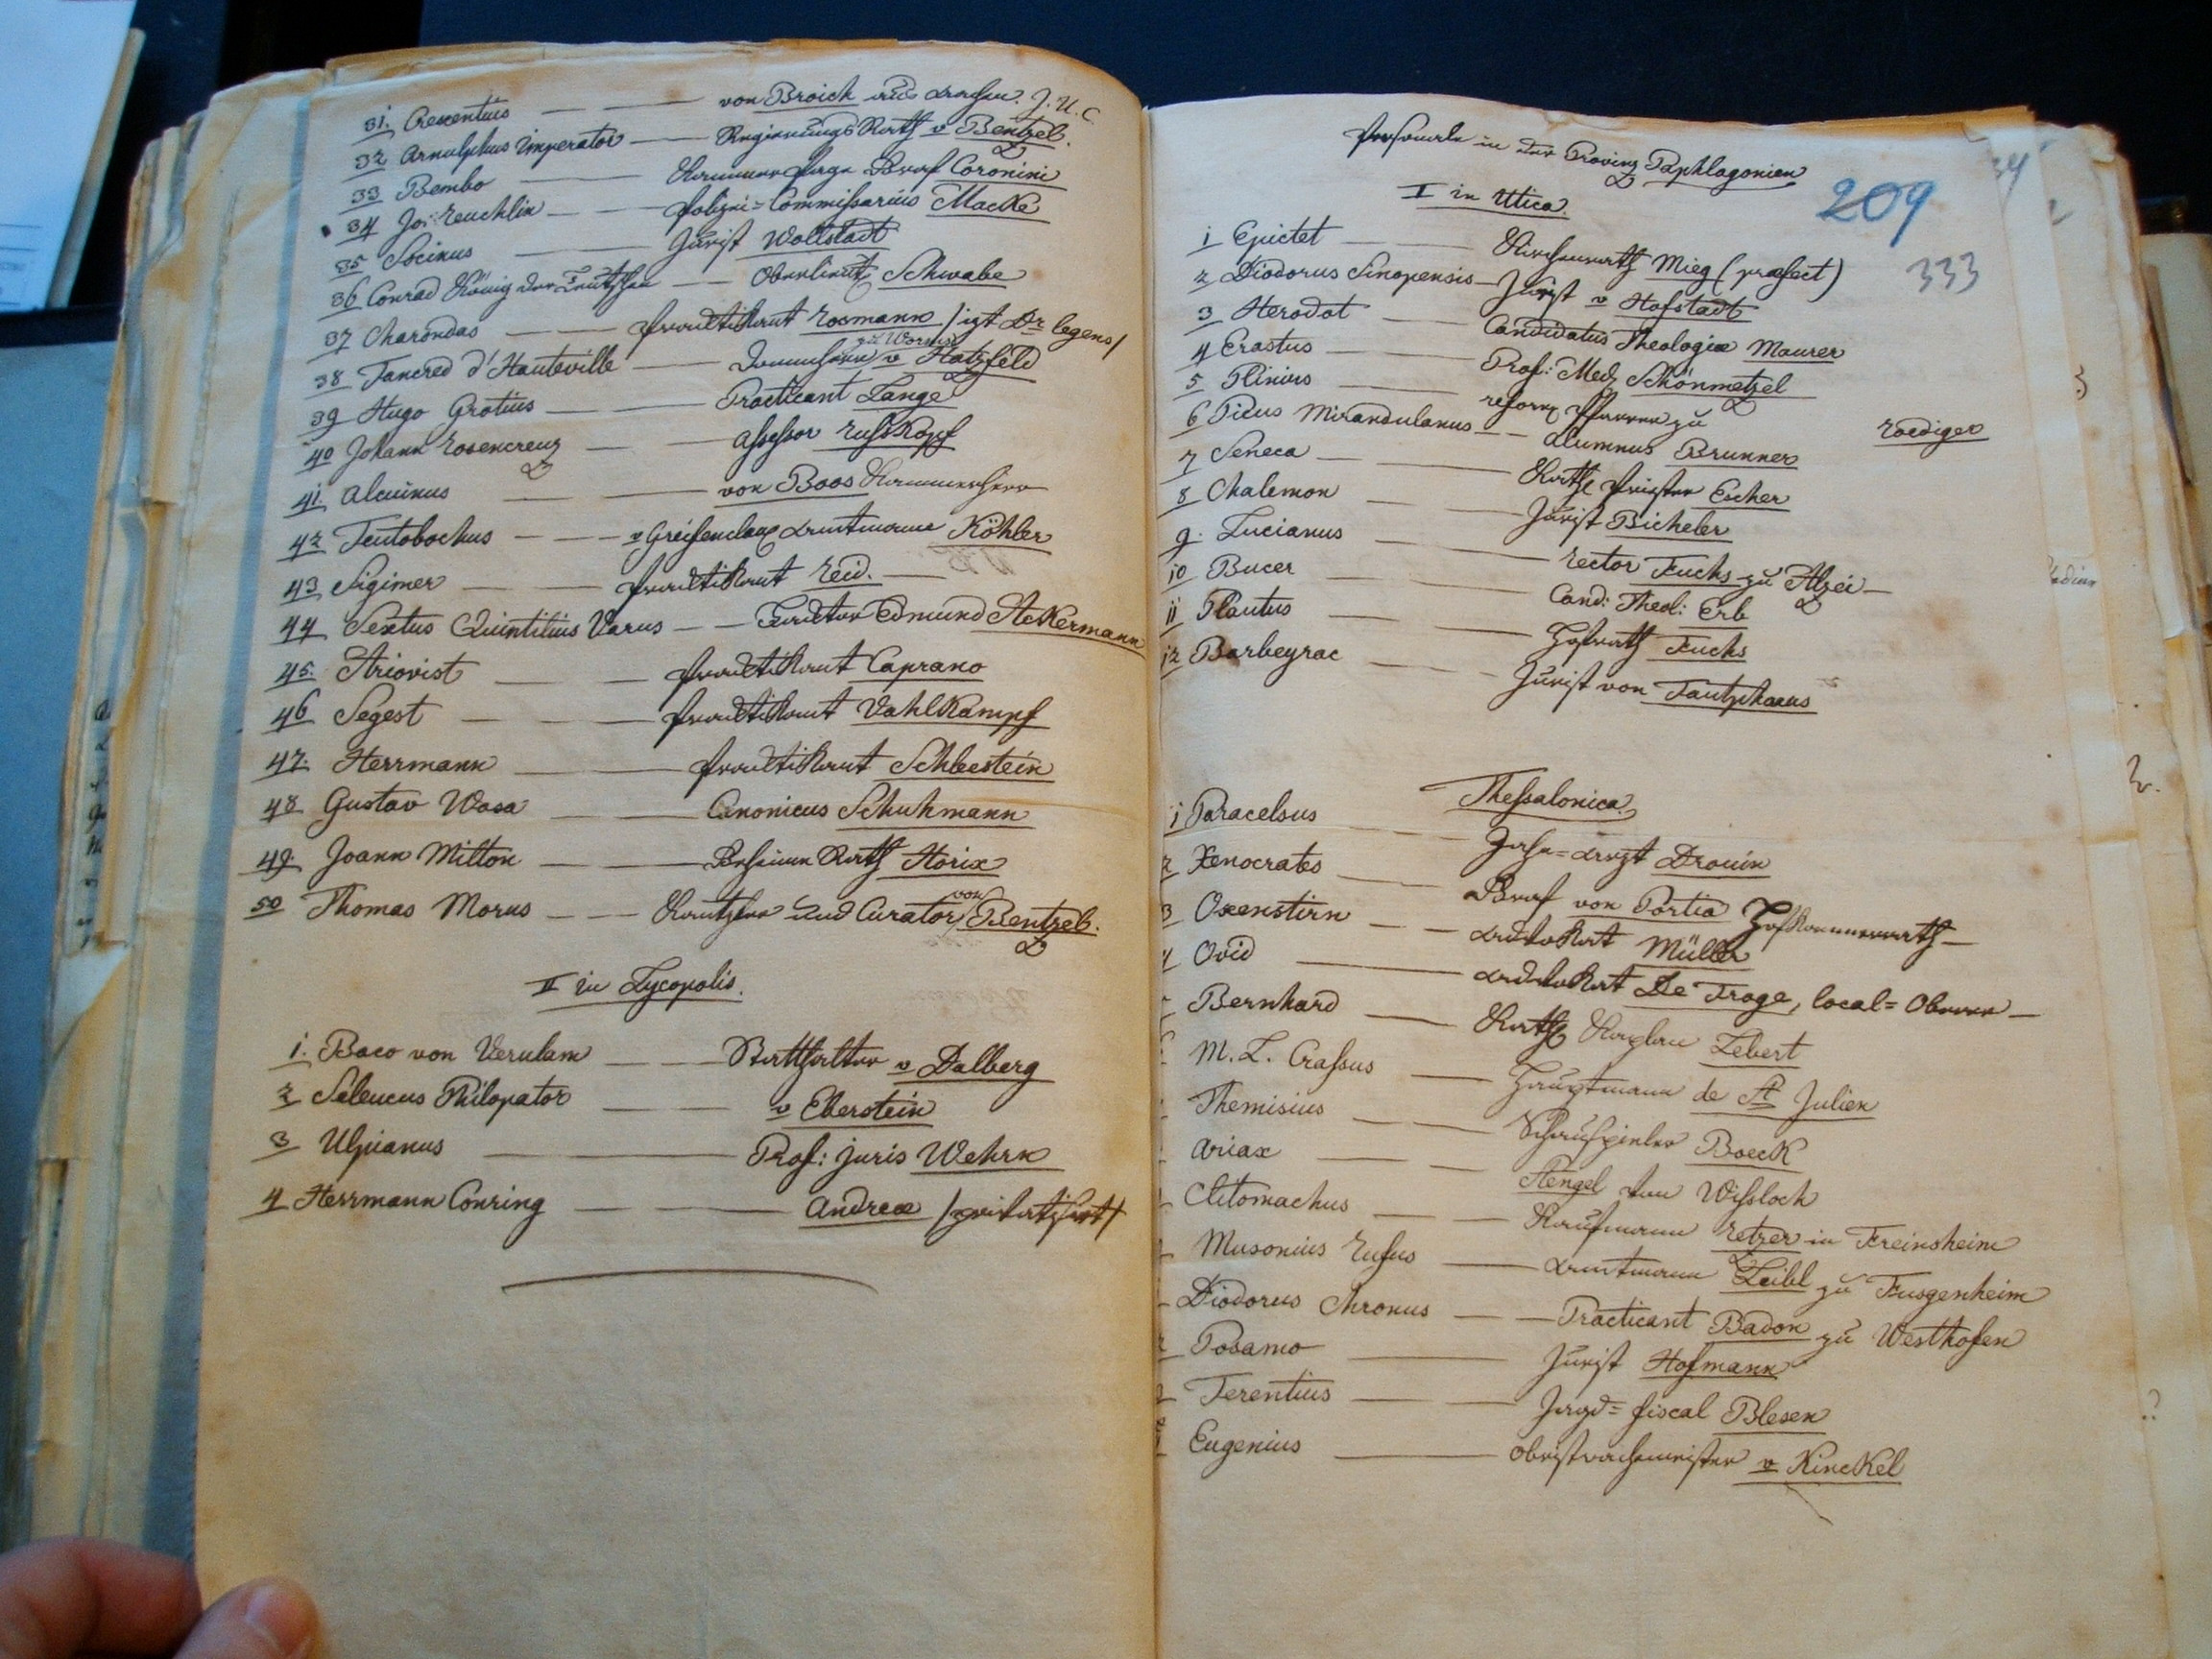
Featured Image: Item:Q4545 letzte Seite und Item:Q4546 erste Seite: Die Mitgliederaufschlüsselungen der Minervalkirchen Frankfurt (Epidamnus, Fortsetzung von voriger Seite), Lycopolis (Erfurt), Heidelberg (Uttica) und Thesalonica (Mannheim).

The (sobering) status report of Friday 13, April 2018

[A version of this was originally posted here]

[Postscript Friday 4, May 2018: SPARQL is on, we are in the middle of our first more massiv data input]

Four months have passed since the kick-off workshop shop, and the FactGrid project has run into its first unexpected problems. We are confident that we will solve the – primarily technical – issues, but one of the lessons we have learned so far is that we will need the support of a larger community in order to situate the FactGrid Project with more impact in the Wikidata-community.

What do we want to achieve? We are still trying to launch a Wikibase installation with the aim to offer a platform for original research. Data hosted on the FactGrid will be free to be used by Wikidata. Data will leave the FactGrid database, however, with the personal authorisations of research which Wikidata is not be able to generate.

Digital humanities projects interested to work on the collective FactGrid platform will sponsor software developments with their respective DH-funding. The cooperation with Wikimedia should make sure that tools sponsored by us will become part of the wider Wikibase software package. We want to prevent island solutions.

What kinds of problems have we been facing? And where do we need you?

Problem 1: The software is free but the vital tools do not work outside the Wikidata environment.

Wikibase is – relatively – easy to install, but the central tools you need in order to get data into and out of the database – QuickStatements and SPARQL – proved to be hard wired to the original Wikidata compound. Lucas Werkmeister has managed to free Quick-Statements from these ties. SPARQL remains on his agenda. We have no idea how tools that use SPARQL (in order to create visualisations for instance) will work once we have the independent SPARQL version. The software problems have blasted our entire schedule.

Problem 2: Getting the first sets of data into the FactGrid.

We have four larger spread sheets of data from the Gotha Illuminati project which we want to use in order to create an attractive show case.

  1. Google Spreadsheet: The Illuminati Files
  2. Google Spreadsheet: The Illuminati and others
  3. Google Spreadsheet: Some first Organisations
  4. Google Spreadsheet: Events referred to in the Illuminati Files

Our data sets are intriguing and able to attract a wider public interest without further advertisement. They should create steam for the engine if we manage to convinced all the parties involved (Freemason, Berlin State Archive, Gotha Reasearch Centre and the Wikimedia Community) to risk a crowd sourced identification of the roughly 6,000 digitised documents which we have been gathering over the last four years. We have underestimated, however, the problems an empty database (a database without any properties and any primary items) is causing.

If you feel cool with QuickStatements and if you think an empty wikibase installation is just the free space you have been dreaming of, join the team and help us to learn how we can use our data with the brilliant software.

Problem 3: We will need a more massive Wikidata and/or GND input.

We will need our own landscape of information ready to be improved if we want to attract other projects of historical research and regular internet users (with wider a genealogical project for instance). A strategist is here needed, someone with ideas how we could (for instance) acquire all the names of people with birth dates between 1400 and 1800 from Wkidata and/or the GND for our database. (To keep the database clean we might focus on basic data like names, birth dates, places of birth and death, and family connections). Wikibase fans who feel you could organise such an import, feel inspired! We would offer you all the freedom of the experiment you would ask for.

Problem 4: We will need something like forms which users can fill in in order to create standardised CVs with the Wikibase software.

Adrian Heine has taken the first steps into this project. Our aim is a Wikibase environment which normal people can correspond with like they have been corresponding with the Wikipedia software so far. You pick a person of your interest and you get a questionnaire with modules (on places and addresses that the respective person has lived, on employments he or she has been in, on the person’s genealogy, on personal contacts we can prove). Wikibase is presently not exactly ready to be edited by normal people.

Problem 5 (a project for the future): Wikibase needs something like a standard Wikibase-Interpreter

Magnus Manske’s Reasonator has been the cool thing on all my presentations of the Wikibase software in DH-circles. You can pick your language and you get an organised data sheet.

Things get difficult if you want to correct or augment the Reasonator’s information sheet; and things get even more difficult if you want to run the Reasonator on your own platform. The development of an immediate interface that produces smooth pages of structured information will be necessary in order to motivate people to gather information for Wikidata (or any affiliate). The Wikibase-Interpreter would be ready to offer the complete knowledge on any field of interest. It would be ready to list all the places a person is known to have visited, all the contacts he or she is known to have had – whether face to face or through letters. Think of the thousands of contacts of the Leibniz’ correspondence – a problem to be solved with pages that give an overview and “more” on the user’s particular request. The Reasonator is, so far not reading Wikidata directly, nor is it part of the Wikimedia software development. Wikidata will need its own Interpreter in order to become an independent source of information – an independent source that also serves all the Wikipedias around the Globe.

We need to change the way we are organising all this

We have been able to offer a couple of grants in 2017 in order to get the project going. We should be able to use the further funding of DH-projects interested in the software and the collaborative platform to inspire if not to fully finance future tools. DH-projects will, however, only risk a cooperation with the FactGrid project and with Wikimedia as the software and data-partner if we manage to offer an attractive show case of what can be done. The Illuminati files are an immensely cool project to begin with. The global interest in these files is huge, everyone has heard of the Illuminati and here you get their most secret files. Visualisations of networks and of the geographical spread of the secret order will find a good test case here. If we should be able to inspire a crowd sourced annotation of all the known documents – that would stir up a global press attention.

We are, however, far from the show case which we could present anywhere at this moment.