Wäre es sinnvoll, das FactGrid vorab mit ausgewählten (auf Kerndaten reduzierten) Datensätzen aus Wikdata und der GND zu befüllen, um nicht im leeren Raum zu beginnen?
Gäbe es alternativ eine einfache Option, Daten mit den bestehenden Datenbanken abzugleichen und Datensätze ohne Umstände zu übernehmen?
Könnte man den Umgang mit Doubletten – verschiedenen Datensätzen zur selben Person etwa (resultierend aus der Zusammenfügung von Tatenmengen) – nicht zu einem fruchtbaren Problem machen, sprich: die Datenbank einsetzen, um gezielt nach möglichen Übereinstimmungen zu fahnden?
Wie würde man am besten mit ‘tentativen Informationen’ umgehen – mit Personen etwa, von denen man erstmal nur einen Nachnamen, einen Zeitpunkt und Ort in einem ersten Aktenbefund hat? (Siehe das erste und das zweite Kopfzerbrechen hierzu.)
Wäre es nicht klug, Bilddateien und Transkripte in derselben Datenbank zu verwalten? (Siehe das fünfte Kopfzerbrechen.)
Wie gehen wir mit wechselseitigen Beziehungen um? Wenn eine Schablone es erlaubt, zu einer Person Eltern und Kinder zu nennen, wie stellen wir sicher, dass Schablonen zu Kindern wiederum die bereits eröffneten Beziehungen zu den Eltern in den Eingabefeldern haben?
Wenn wir Gegenstände und Eigenschaften definieren, werden wir dafür eigene (sagen wir) X- und Y-Nummern vergeben, um Freiheit bei der Erweiterung und Ausbeutung der Datenlage zu haben? Wenn ja: Wie sichern wir die weitestmögliche Vereinbarkeit mit Wikidata-Einträgen ab?
Magnus Manskes Reasonator erweist sich als ungemein elegantes Werkzeug, um Wikidata-Information enzyklopädisch verfügbar zu machen. Taugt der “article placeholder” als Alternative, wenn wir eine Vermehrung von Plattformen verhindern wollen und wenn wir eine automatische und übersichtliche Datenpräsentation suchen. Braucht Wikidata nicht langfristig einen eigenen “Visualizer”, der die Informationen zu jedem Gegenstand zweckmäßig anordnet und erst beim Editierwunsch in den Bearbeitungsmodus schaltet?
Das FactGrid soll verschiedenen Projekten als gemeinsam betriebene und angereicherte Plattform dienen. Wie machen wir es möglich, dass das jedes einzelne Projekt die Ressource unter seinem eigenen Focus ausbeuten kann? Wie ermöglichen wir Suchen, die etwa speziell im Aktenbestand bleiben, der vorher als die thematisch relevante Datenlage eines Projekts definiert wurde?
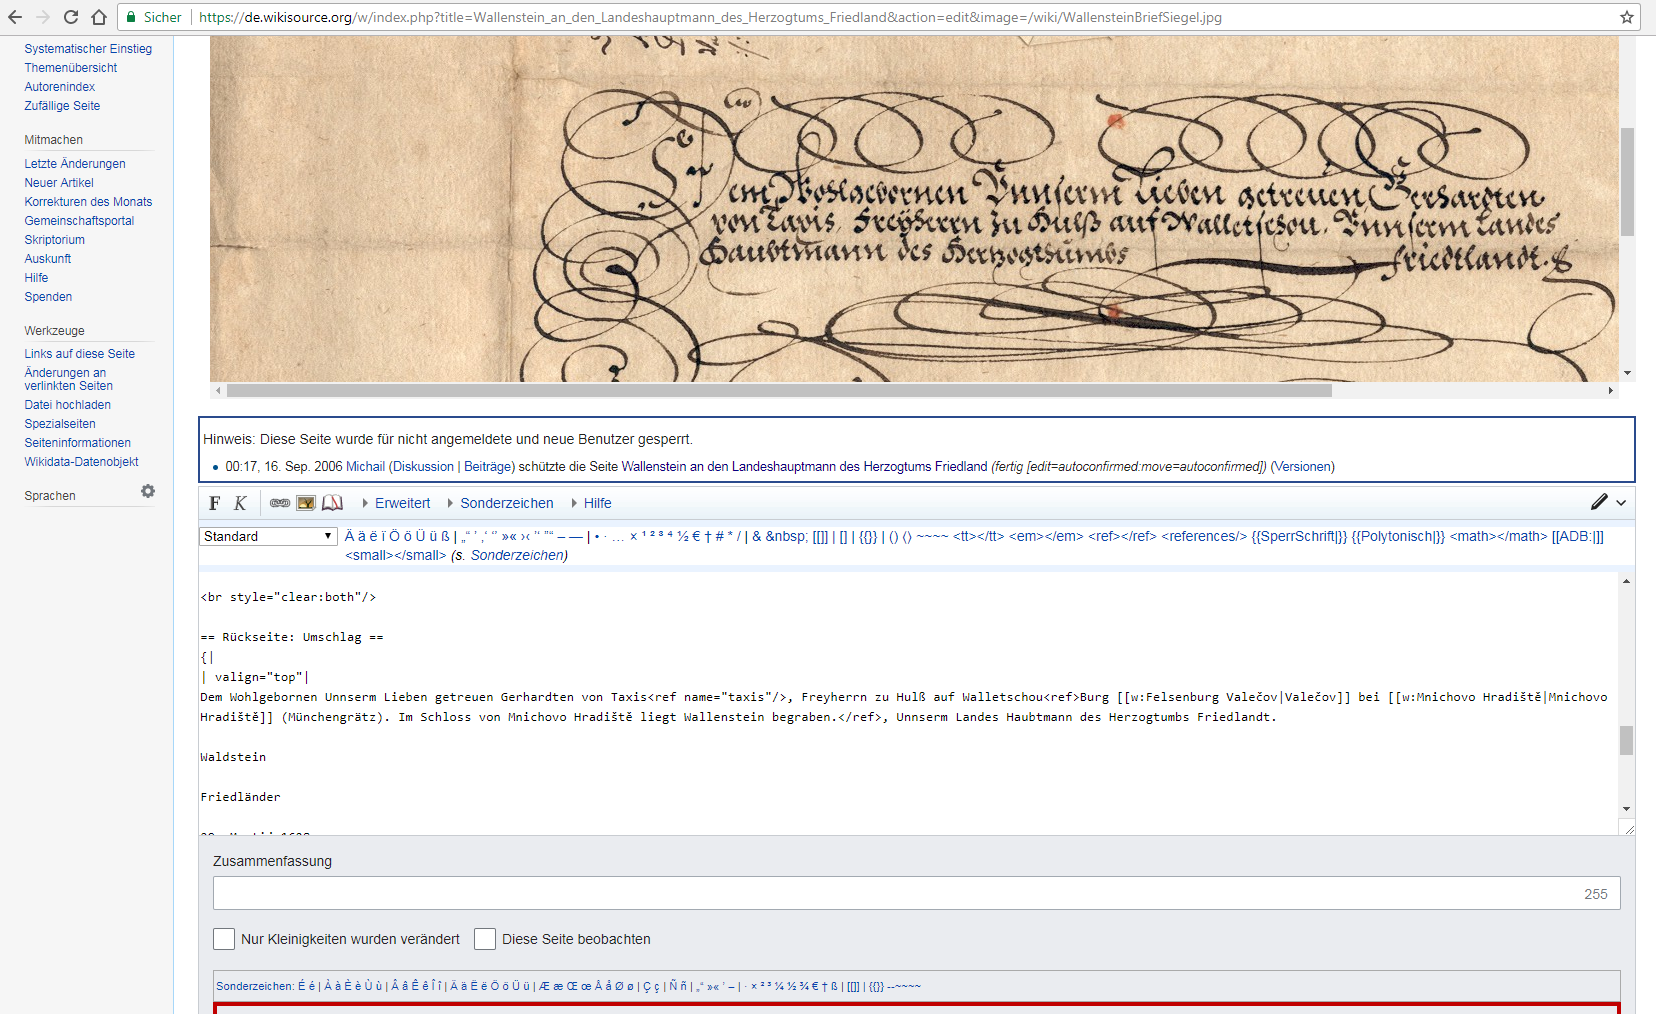
Wikisource Screenshot mit Bilddatei und Bearbeitungsfenster für das Transkript im OriginalDas ist die mühsame Arbeit des Historikers wie des Hobby-Forschers, der etwa Kirchenbücher auf den Spuren seiner Familie auswertet: Man hat ein Dokument. Wenn es älter ist, entziffert man es, indem man es nebenbei notdürftig transkribiert. Mitunter muss man es nebenbei in eine lebende Sprache übersetzen, bevor man im letzten Schritt Informationen aus dem Dokument zieht (und sich notiert, wie man die Information nachher zitiert).
Sollten wir das Projekt der Illuminatenakten Online in einer größeren Kooperation mit den zu beteiligenden Partnern zuwege bringen, werden wir zu alledem noch die Scans der einzelnen Dokumentenseiten zu verwalten haben. Was wäre praktischer für deren Verwaltung als die bereits benutzte Datenbank? Eigene Wikis aufsetzen mit der Wikisource-extension, die es erlaubt, einen Scan neben einem Transkriptionsfenster zu sehen, hieße die Plattformen planlos zu vermehren.
Interessant ist die all-in-one-solution. Sie öffnet den Weg in die Volltextsuche; vor allem aber behält man mit ihr stets die Arbeitsschritte beieinander. Im raschen Zugriff lässt sich erfassen, welche Informationen aus welcher Datenlage gezogen wurden. Beim seltsamen Befund ist man schnell an der Quelle, die falsch gelesen oder fehlinterpretiert worden sein muss. Die Metadaten zum Objekt, die man vor allem mit der Datenbank verwalten möchte, bleiben dicht bei der Objektbearbeitung.
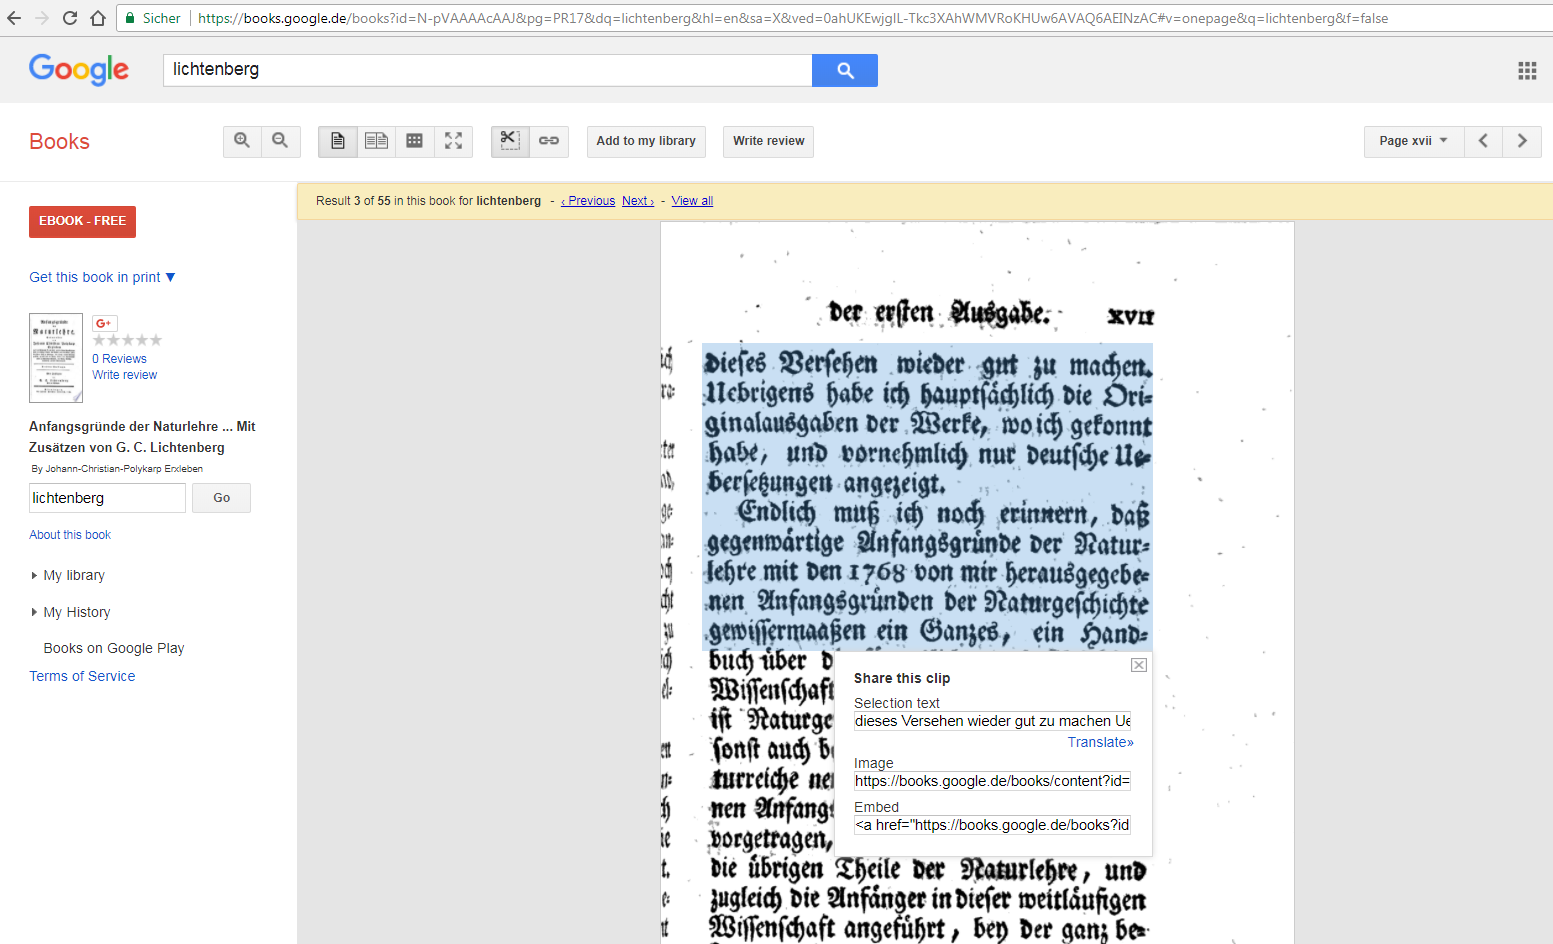
Vielleicht würde man mit Sichtfenstern arbeiten wollen, die man in verschiedenen Tabs, mitunter auch auf zwei Bildschirmen, nebeneinander nach eigenen Wünschen anordnen könnte. Angenehm wäre es, wenn man die Information von anderen Datenbanken einbinden könnte: Oft wünscht man sich eine Funktion, um eine bereits vorhandene Texterkennung – sie läuft bei Google Books und Archive.org im Hintergrund der Scans mit – einfacher bei der eigenen Arbeit benutzen zu können. Man korrigiert schneller als man selbst schreibt.
Screenshot aus Google Books: Man kommt an die OCR zu einzelnen Textpassagen, kann sie aber nicht bearbeiten. Vergrößern / Google Books
Das sind gleich mehrere Baustellen für ein längeres Kopfzerbrechen.
Die Publikationen waren nicht ungewöhnlich. Man entnahm ihnen nach dem kalendarischen Vorspann und den Informationen über die Post-
und Botenverbindungen Überblick über den Aufbau des gesamten Staats und seiner Landeskirche samt den Namen und Posten aller Amts- und Würdenträger bis hinab zu den Angestellten, die der Herrschaft auf dem Schloss aufwarteten.
Netzwerkdarstellungen wurden in den letzten Jahren populär. Sie erlauben es, Knoten in größeren Kommunikationsgefügen auszumachen. Insbesondere informelle offene Korrespondenzgefüge gewinnen hier Transparenz.
Tatsächlich wissen wir aber dank solcher Kalender und vergleichbarerer Publikationen über die Interaktionsgefüge weit mehr. Wir verfügen über Organisationspläne aus staatlichen und kirchlichen Behörden, wir kennen die Gefüge der Armee, größerer Anstalten wie kleinerer Firmen, kennen die Positionen in geheimen und nicht geheimen Gesellschaften, die Gremien und Ausschüsse von Parlamenten und Parteien und so fort.
Eine der interessantesten Leistungen des FactGrids könnte darin liegen, diese Gefüge mit den Personendaten und Archivalien zu erfassen. Hier sind Organisationsstrukturen ausgewiesen samt Titeln, Positionen und den Namen der Amtsinhaber. Wie müsste die Dateneingabe aussehen, um aus ihr Organigramme für jeweils gewünschte Zeitschnitte zu generieren – mit Links zu den Personen und zu Schriftstücken ihrer Hand?
Die Adress-Kalender erfassen, wie der größte Arbeitgeber im frühneuzeitlichen Staat mit der Bevölkerung seines Territoriums verwoben war: Welcher Prozentsatz der Stadt- und der Landbevölkerung stand in Dienstverhältnissen zum Hof? Wie verliefen – hier wird die Serie der Kalender aufschlussreich – Karrieren bei Hof? Welche Positionen erweisen sich als sozial durchlässiger als andere?
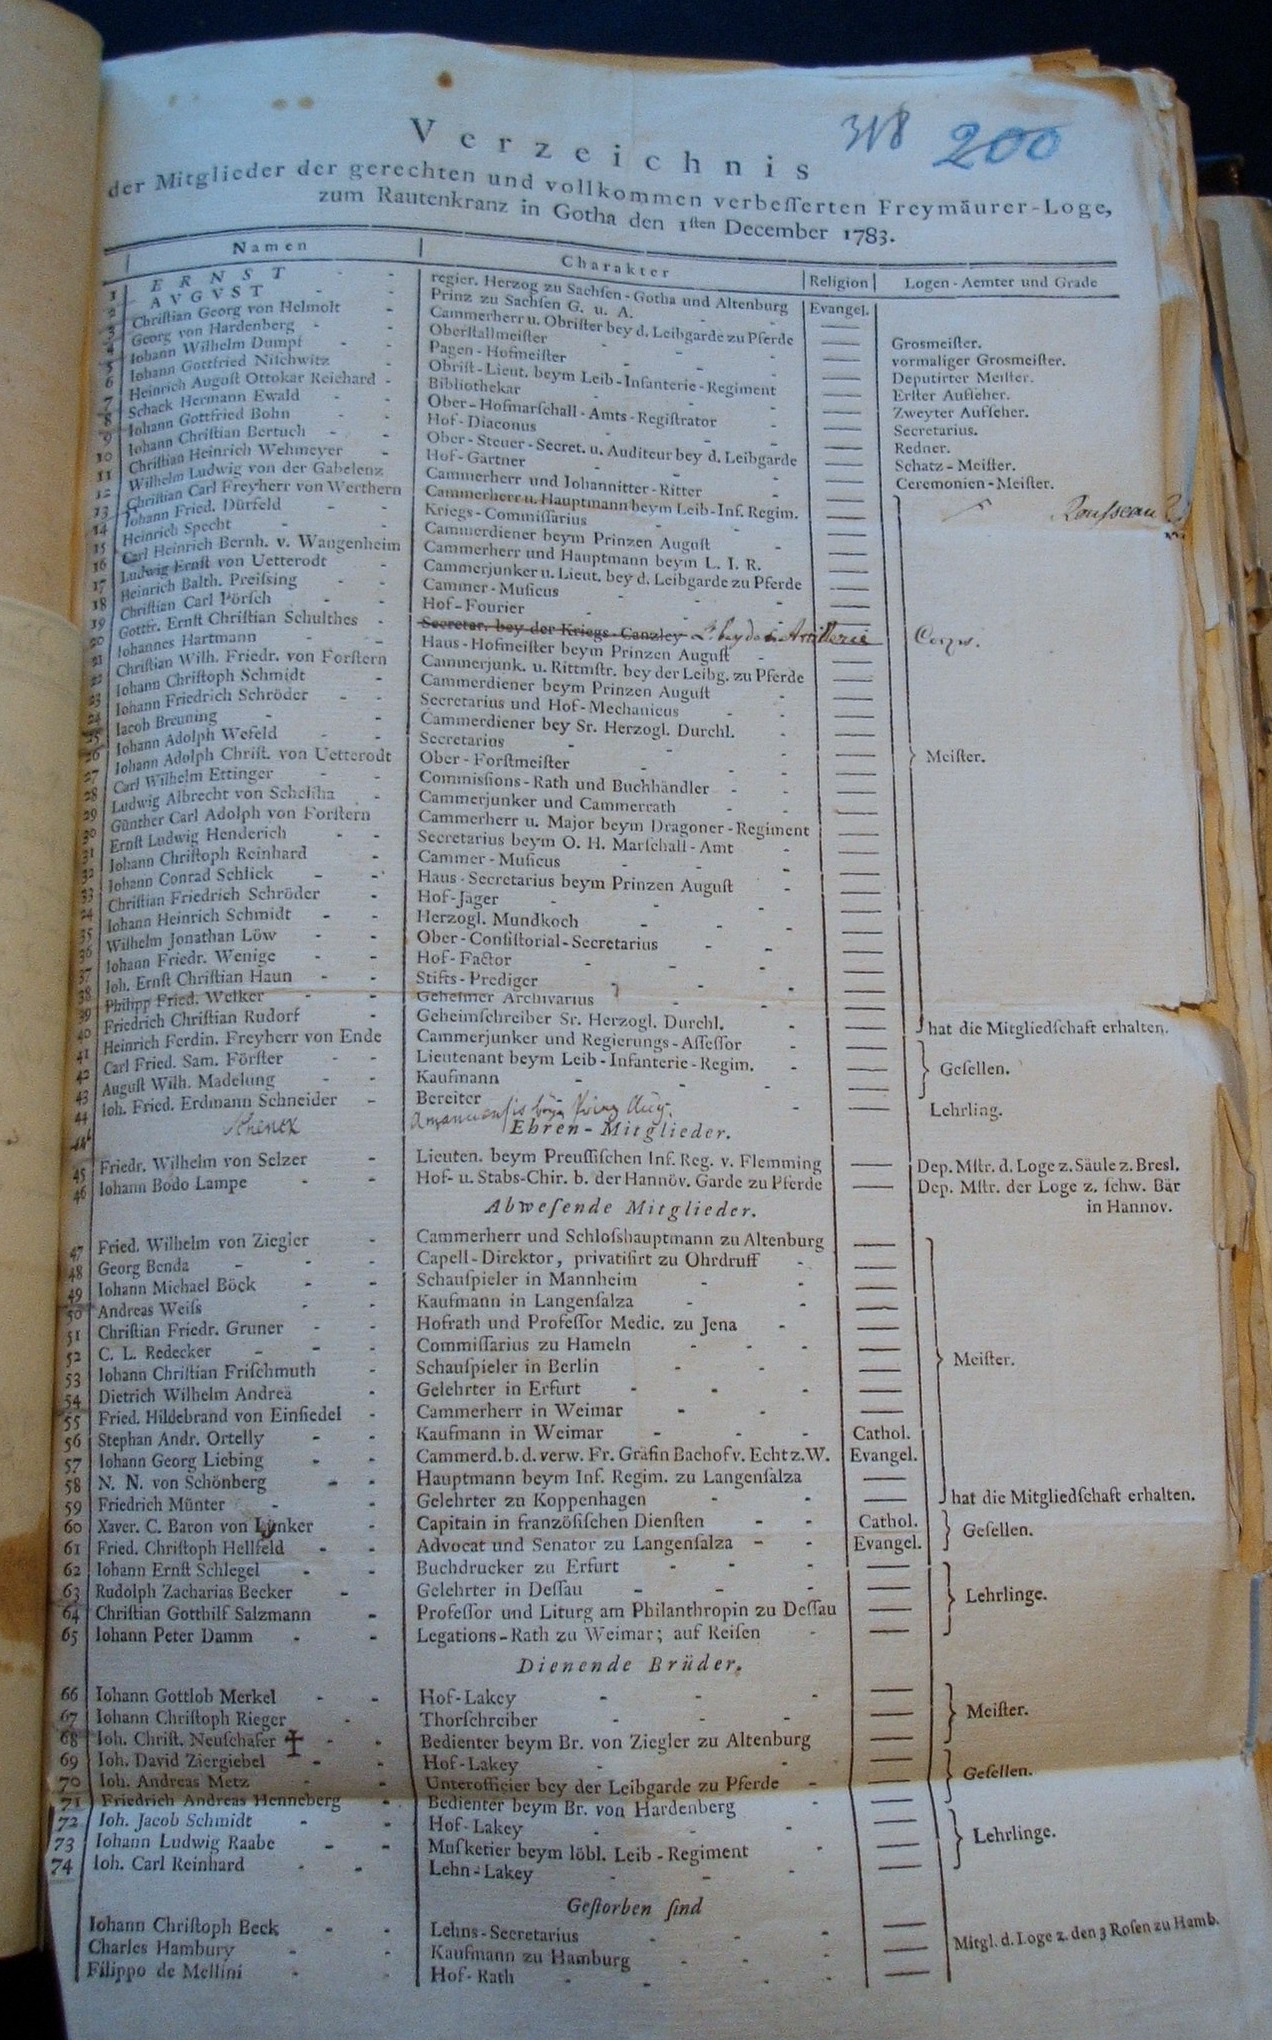
Wie sind – wenn wir Organisationsgefüge miteinander korrelieren – Gothas Freimaurer mit Staat und Kirche des Herzogtums verwoben? In wieweit überlappen sich Kreise des Klubbs, der Thee-Gesellschaft, der Besucher der wissenschaftlichen Vorlesungen des Hofarchivars Ludwig Christian Lichtenbergs in der Stadt, der Illuminaten im Haus des Schlosshauptmanns Christian Georg von Helmolt mit staatlichen Strukturen? Welche Mitgliedschaften waren Eintrittskarten in Karrieren, welche persönlichen Kontakte öffneten Türen?
Aus den Akten des Illuminatenordens Schwedenkiste Band 10, 200: Die Mitgliederliste der Gothaer Freimaurer-Loge von 1783. Deutlich sichtbar: Führende Hofbeamten treffen sich in der Loge wieder – aber nicht alle… Vergrößern
Übersichtlichkeit werden Organigramme generieren, sobald sie mit der Aktenüberlieferung korreliert werden, und man auf die Schnelle in die Arbeit von Behörden Einblick nehmen kann.
Bleibt die zentrale Frage: Was muss wie eingegeben werden, um welche Darstellungen zu erlauben und welche Fragen stellen zu können?
Genealogien durchdringen alle Arbeitsgebiete. Wer Bibliothekskataloge durchsucht, erhält Verlagsangaben und bleibt im Dunkeln darüber, wie diese Angaben zusammenhängen.
Genealogien der Geschäftsführung
Dem Buchhandelshistoriker ist klar, dass er hier genealogisch denken muss: Die städtischen Behörden vergaben Lizenzen für den Druck, Verlag und/oder Verkauf von Büchern. Die Lizenzen wurden innerfamiliär weitergegeben vom Vater auf den Sohn oder, bei ausbleibenden Erben, auf die Witwe und die Kinder, bis jemand in das Geschäft einheiratete oder es von auswärts kommend erwarb.
Neue Lizenzen wurden selten eröffnet. Das Interesse des Hofes konnte hier innserstädtische Interessen an der Vermeidung von Konkurrenz außer Kraft setzen. Eine Geschäftsteilung konnte eine Differenzierung in verschiedene Lizenzen mit sich bringen – fortan bestand ein Unternehmen als reine Druckerei, und eines als reines Verlagsgeschäft mit Buchhandlung.
Dutzende von Namen über drei Jahrhunderte ordnen sich, sobald man die Genealogie der weitergegebenen Rechte erfasst, zu wenigen Strängen pro Stadt – das kann wie folgt für München oder Gotha aussehen:
Gothas Buchhandel 1641-1850 (Ausschnitt – Screenshot aus einer Excelliste)
Vergleichbare Darstellungen der Geschäftsbeziehungen sind bereits Teil des ungeborgenen Katalogwissens. Die Kataloge könnten theoretisch auf die Nahtstellen hinweisen, an denen vermutlich ein Wechsel stattfand, ein Name ausläuft, ein anderer anhebt. Letztlich erfordert die Rekonstruktion der Zusammenhänge jedoch eigenes Wissen über Familienbeziehungen und die Zusammenhänge der städtischen Gewerbeakten.
Auf der Ebene der Software benötigte man die passenden Darstellungsoptionen. Vor allem aber braucht man Schnittstellen, an denen Benutzer die Verbindungen herstellen und die Genealogie ordnen können.
Genetische Verhältnisse: Stemmata
Viel komplizierter liegen die Verhältnisse bei den genetischen Zusammenhängen zwischen Buchausgaben. Manche Kataloge scheitern hier schon im Ansatz wie der hinter Google Books. Man versuche etwa, die Nummern eines Journals aus dem 18. Jahrhundert, dessen Digitalisate irgendwie im System stecken, sich der Reihenfolge nach anzeigen zu lassen. Google hilft einem hier mit einem vagen Angebot weiter nach dem Motto „Leser, die dies lasen, könnten auch diese Links interessant finden“.
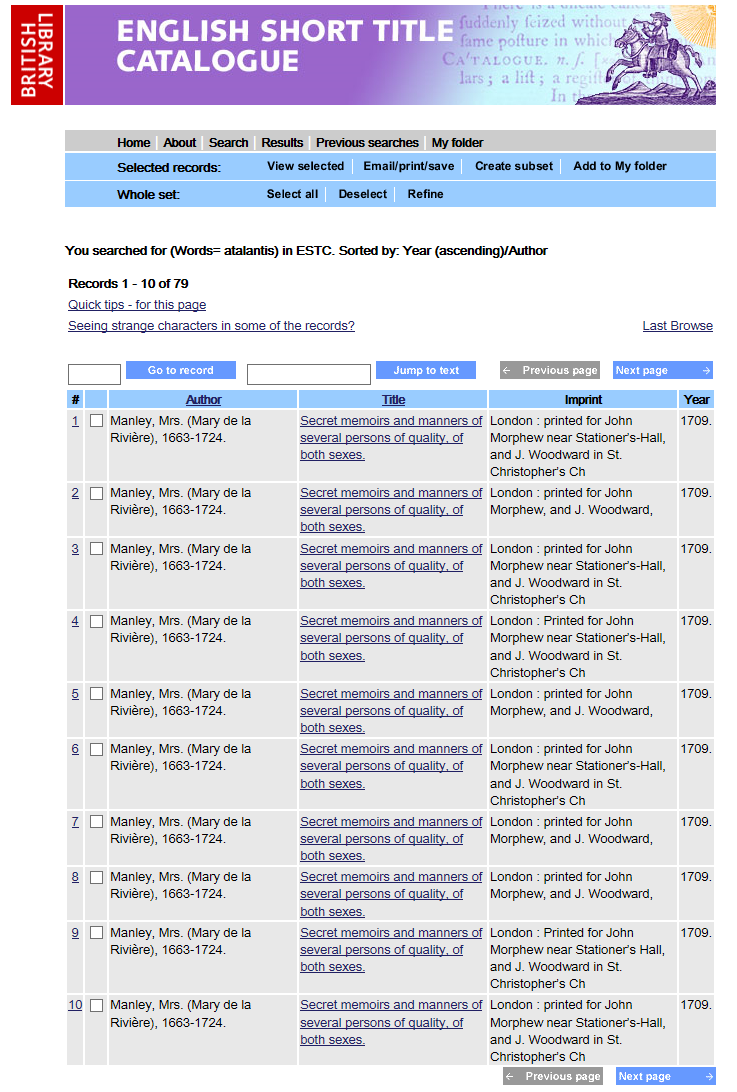
Doch auch ausgefeilte Kataloge wie der ESTC, das Verzeichnis aller englischen Titel der Jahre 1473 bis 1800, weisen hier rasch unüberschaubar werdende Gebiete auf – dann etwa, wenn minimale Varianten von einer Ausgabe, verschiedene Auflagen und zudem einzelne Teilbände auf ein Jahr fallen wie im Fall der Katalogangabe für Delarivier Manleys Atalantis:
ESTC Suche: “Atalantis”. Auch nach der chronologischen Sortierung bleibt unklar, hinter welchem Link der erste Text liegt.
Man wünschte sich hier nicht minder eine Option der genealogischen Strukturierung: Der erste Band erschien im Mai 1709; im Juli musste er nachgedruckt werden. Band zwei folgte im Oktober. 1710 brachte die Autorin ein Werk heraus, das erst einmal einen eigenen Titel trug: die Memoirs of Europe. Ein halbes Jahr später folgte davon Band zwei. Ab 1715/16 wurden diese Bände in Neuausgaben der Atalantis als deren Folgen III und IV notiert.
Dem Markterfolg wurden ab 1711 auch noch ganz andere Bücher untergeschoben: 1705 war erstmals eine Queen Zarah mit ähnlicher Skandalgeschichte erschienen. Deren zweite Ausgabe kommt 1711 „by way of appendix to the New Atalantis“ heraus. Ein weiterer älterer Titel macht denselben Sprung in den Komplex und vier neue wollen unverzüglich in ihn hinein. Siehe hier die geschlossenere genetische Darstellung: http://pierre-marteau.com/library/e-1709-0004.html.
Der ESTC ist im Kern ein Nationalkatalog. Das wird deutlicher, sobald man die weiteren Titel auf dem europäischen Markt nachweisen will – dem versagt sich der ESTC. In den Niederlanden erfolgte 1713 die Übersetzung der ersten zwei Bände ins Französische. Eine nachweisbare, kondensierte deutsche Fassung datiert vermutlich von 1714 und übersetzt nach der französischen Ausgabe.
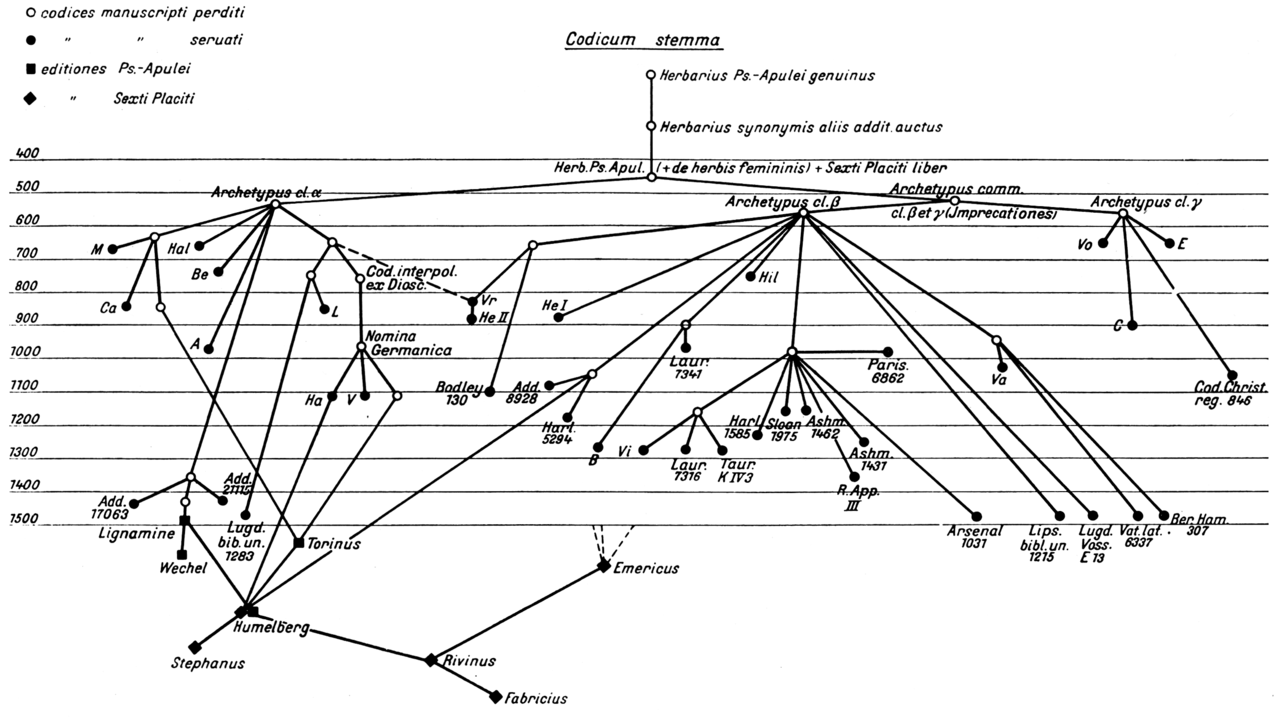
Für die beschriebenen genetischen Beziehungen bräuchte man Stemmata, wie sie in der Handschriftenkunde verbreitet sind. Das Komplizierte ist hier, dass die Beziehungen zwischen Titeln immer über das ganze Schema hinweg verlaufen können. Ein Verlag mag bei einer Neuausgabe nach der letzten ihm greifbare Ausgabe setzen. Er könnte jedoch auch auf die Erstausgabe zurückgreifen, oder eine von der Autorin korrigierte spätere. Die moderne „kritische“ Ausgabe wird sich für eine Leitausgabe entscheiden, und Varianten (wenn vorhanden) mit dem Manuskript der Autorin und den ersten und letzten Ausgaben, die sie selbst beeinflusste, erfassen.
Wieder wäre einem mit einer Schnittstelle geholfen, die es erlaubte, verschiedene genetische Beziehungen zwischen Ausgaben herzustellen, die dann in einer Visualisierung zum Zuge kämen.
Entwicklungen
Natürlich hofft man auf die Software, die selbst rekonstruiert, wie sich die Dinge ordnen – darum geht es im Umgang mit „Big Data“. Das Spannende an der Wikidata-Software ist jedoch im selben Moment, dass der Benutzer mit ihr sein Wissen viel schneller und härter einbringen und damit die großen Schneisen der Diskussion gezielt und diskutierbar schlagen könnte.
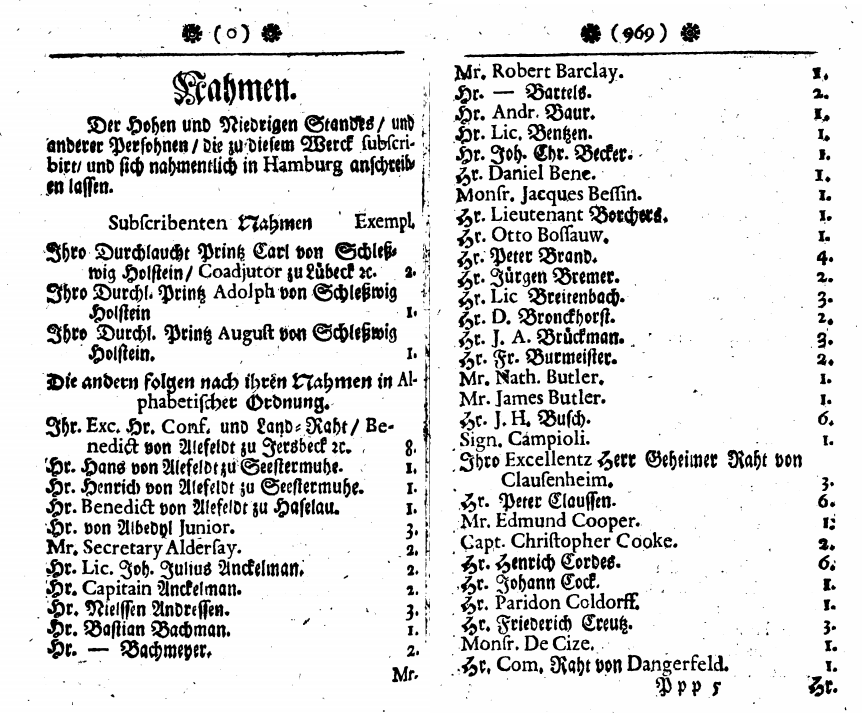
Dem letzten Kopfzerbrechen sehr ähnlich ist dieses: Viele Bücher der (frühen) Neuzeit enthalten Subskribentenlisten. Der Verleger sichert die Publikation ab, indem er vorab um eine Meldung aller Interessenten am kommenden Buch bittet. Sie erhalten das Buch zu günstigeren Konditionen; der Verleger kann sich im selben Moment seines Absatzes sicher sein.
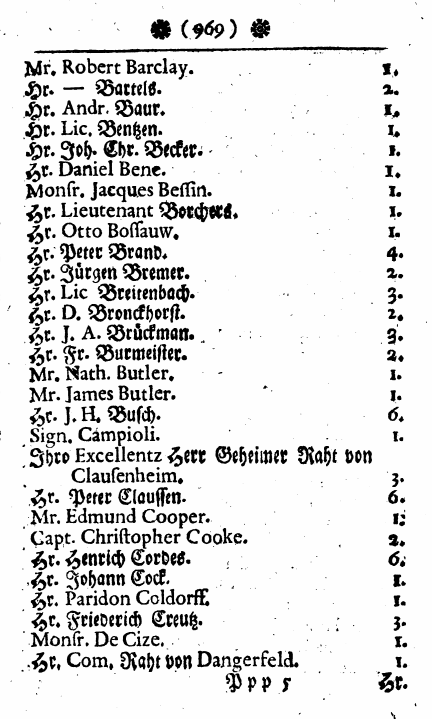
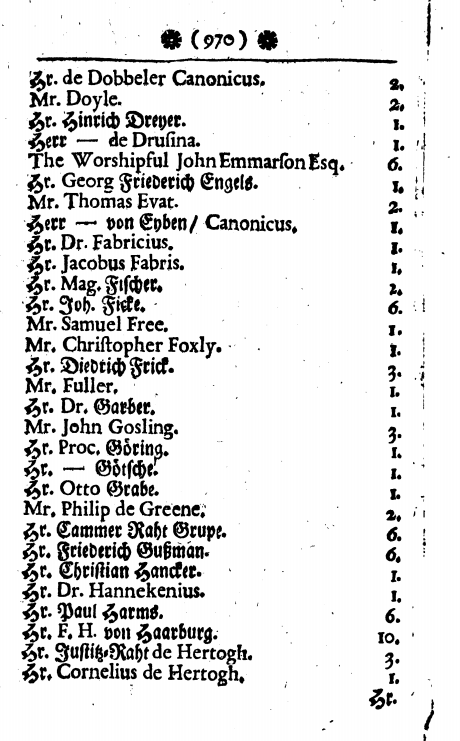
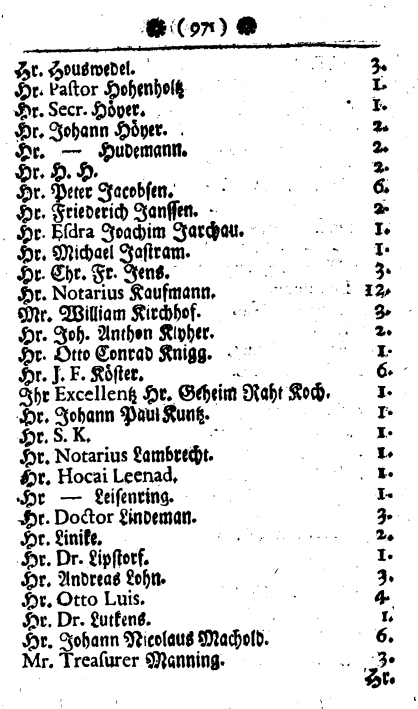
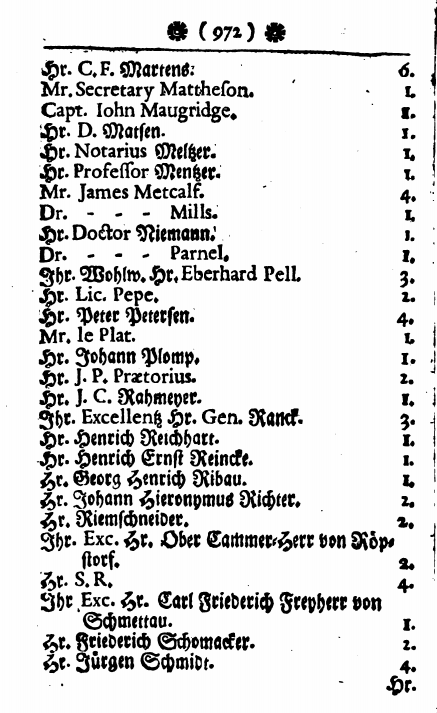
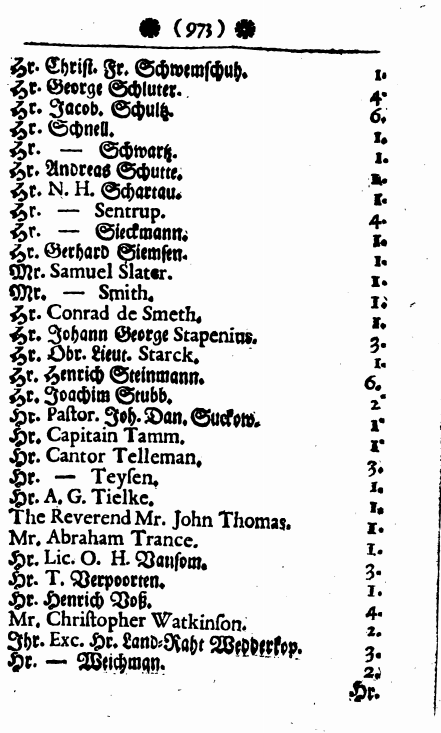
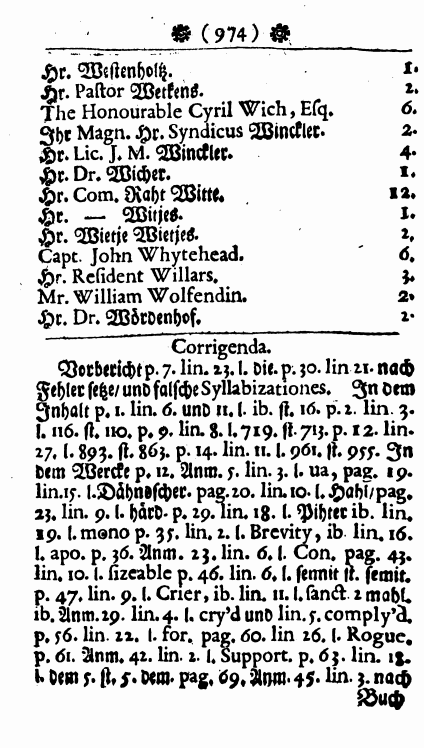
In vielen Büchern des 18. Jahrhunderts sind diese Listen am Ende abgedruckt. Es sind spannende Listen, da wir hiermit für eine ganze Zahl von Büchern – theoretisch – sehr genau wissen, wer sie in der ersten Welle las. Unten inseriere ich die Subsriptionsliste aus Thomas LediardsGrammatica Anglicana (Hamburg: Kißnerscher Buchladen, 1725). Für die nächsten Jahre wurde dies das beste Englischlehrwerk auf dem deutschen Markt.
Wer glaubt, Bücher werden damals nur von hohen Standespersonen gelesen, irrt. Diese machen als abgesetzter Zirkel den Anfang. Es folgen alphabetisch die übrigen Leser: gute 180 Namen, oft mit Vornamen, mit Angaben der Bestellmengen, zuweilen mit Angaben des Berufs.
„Hr. Cantor Tellemann“ ist natürlich der in Hamburg ansässige Georg Philipp Telemann – 1725 demnach begierig, Englisch zu lernen,doch brauchte er dafür gleich drei Exemplare? Hr. Dr. Fabricius wird Johann Albert Fabricius sein, „Mr. Secretary Mattheson“ der Sekretär und Korrespondent des englischen Gesandten, Komponist und Musikkritiker – Johann Mattheson, verheiratet mit einer Engländerin und 1742 der Übersetzer der Pamela ins Deutsche.
Das Auflösen der Namen mit dem individuellen Namensvorrat des Historikers ist müßig. Man müsste die Namen mit Datenbanken abgleichen. Die Eröffnung gibt an, dass alle Genannten sich in Hamburg erreichen ließen. Das ist sowohl eine interessante Beobachtung für den, der sich fragt, wie 1725 Subskriptionen zustande kommen (demnach primär über die Werbung vor Ort), wie eine Hilfe beim Abgleich mit Wikidata und der GND. Die Lage sieht in späteren Listen komplexer aus.
Man würde definitiv die gesamte Liste eingeben. Erst mit ihr weiß man, wie viele Subskribenten es gab, und kann Vergleiche mit anderen Subskriptionsprojekten ziehen.
Es wäre interessant, Namen mit den geringen Informationen, die man hat, einzufüllen und auf die schrittweise Identifikation zu warten, auf die Anreicherung von Information. Man wünschte sich eine Schablone für Subskriptionslisten, um beim Eingeben nicht unnötig viele Parameter berücksichtigen zu müssen, und würde in einem zweiten Lauf, die Datenbank bitten, mögliche Treffer zu nennen.
Im Verlauf könnte man vielleicht soziologische Querschnitte geben. Wie alt ist man, wenn man 1725 in Hamburg Englisch lernt? Wie viele Engländer (sind diese nebenbei Sprachlehrer?), wie viele Deutsche spricht das Buch an? In welchen Berufszweigen lernt man die Fremdsprache, die in den nächsten 200 Jahren die globale Lingua Franca wird?
Die Subskribentenliste von Thomas Lediards Grammatica Anglicana (Hamburg: Kißnerscher Buchladen, 1725), S. 968-974
Gothas Stadtarchiv überließ uns zur weiteren Arbeit drei Exceltabellen, die die Angaben aus den Gothaer Wohnhäuserverzeichnissen der Jahre 1828, 1841, 1846 enthalten.
Die Daten sind ein spannendes Problem für das aufzubauende FactGrid.
Gothas Häuser sind nach Straßen geordnet einfach gezählt von Nr. 1 bis Nr. 1296. Wir können über eine Umrechnungstabelle die genauen Geo-Koordinaten geben und dort, wo Gebäude unverrückt stehen, auch die heutigen Adressen nennen. Für die Fleischgasse (seit 1894 Hünersdorfstraße benannt nach Karl Heinrich Hünersdorf) macht die Tabelle 1828 etwa die Angaben, die ich am Ende gleich tabellarisch liste.
Problemstellung
Die Liste bietet regulär nur Nachnamen, manche doppelt. Viele dieser Namen tauchen 20 Jahre später in der Nachfolgeliste wieder auf. Wir wissen nicht, wann sie Wohnadressen notieren und wann Hausbesitzer. Man wird diese Namen samt und sonders in der Datenbank haben wollen, um sie im Lauf der Zeit mit Informationen anreichern zu können.
Manche Namen tauchen auch in der GND und Wikidata auf. Wir werden versuchen mit einem Import eine Landschaft bereits bekannter Personen zu liefern in der mögliche Treffer komfortabler zu identifizieren sind.
Wie aver handhabt man blanke Nachnamen in der Hoffnung auf eine spätere Anreicherung, sprich so, dass anderen Mitspielern auf derselben Plattform im Verlauf ein rotes Lämpchen leuchtet, wenn es sein könnte, dass bereits eine rudimentäre Information zu der Person ihres Interesses vorhanden ist?
Datenexzerpt aus dem Wohnhäuserverzeichnis von 1828, Gothas Fleischgasse
FactGrid is aiming at licensing its content under CC BY 3.0 (Q14947546). I am not sure this is the way to go forward and recommend serious consideration to go for CC0 (Q6938433) instead to ensure maximal compatibility with Wikidata. There are other databases that have recently switched their licensing to CC0 for this reason, e.g. see the respective announcement by WikiPathways (Q7999828).
Die Mitgliedschaft im Illuminatenorden ist für den Historiker eine komplexe Angelegenheit unter eigenen Ansprüchen darauf, was hier “relevante” Fakten sind. In Wikipedia interessieren ausschließlich Personen, die “enzyklopädisch relevant” sind. Hier machen Kriterienkataloge die strengen Vorgaben. Bei der Erforschung des Illuminatenordens interessiert dagegen vor allem die vollständige Liste und zwar gerade, da sie etwa einzelne 15jährige ohne weiteren Aktenniederschlag umfasst, mit denen sich beweist, dass der Orden, der sich der Ausbildung des Menschengeschlechts verschrieb, anders als die Freimaurerei spezielle Ausbildungsklassen eröffnete, die interessante Jugendliche auf eine Stufe mit Erwachsenen stellten.
Erst mit der Liste aller nachgewiesenen Mitglieder kann man Aussagen über die soziale Zusammensetzung des Ordens und seine Altersstruktur in unterschiedlichen Rängen wie seine geographische Verbreitung machen.
Spannend sind die komplexen Folgefragen: Macht sich die Ordensmitgliedschaft im weiteren Karrierewege bemerkbar? Nutzen Illuminaten Kontakte aus der Ordenszeit später noch?
Die Mitgliedschaft im Illuminatenorden schafft einen Einzelfall möglicher Mitgliedschaften in anders organisierten Gesellschaften. Wer Illuminat ist, muss von jemandem vorgeschlagen werden; er findet im Orden einen ihn betreuenden “Rezipienten”, wird einer Minervalkirche zugeteilt und gerät von dort aus in eine spezifische Betreuung durch “Unbekannte Obere”.
Um Standardisierungen der Eingabe sicherzustellen, wird man eine Schablone mit Fragen schaffen. Jede Zeile wird dabei erneut die Frage nach Belegen stellen (dazu der eigene Artikel Faktenbelege, die “Original Research” zulassen).
*Die Wikidata-Software lässt Vermehrungen von Feldern zu. Ordensmitglieder können tatsächlich mehrere Ordensnamen erhalten, nötig etwa, wenn sie schriftlich in verschiedenen Funktionen agieren, ohne dass Untergeordneten die Identität klar werden soll. Desgleichen können Mitglieder durch Umzug die Zuordnung zu einer Minervalkirche wechseln.
**Mit der Mitgliedschaft im Illuminatenorden muss immer auch die Freimaurermitgliedschaft abgefragt werden (für die eigene Schablonen je nach System erstellt werden müssen).
Unterschiedliche Eingabeformen wären hier die Verknüpfung mit der FactGrid Nummer (etwa einer Person), Freitext, Anklicken un ein Häckchen zu setzen (den Sachverhalt zu bestätigen) Datumseingabe und der diskutierbare Quellenbeleg [Quelle].
Nachtrag von weitern Originalschriften (München: Joseph Lentner, 1787). Google Books
Plus Ultra
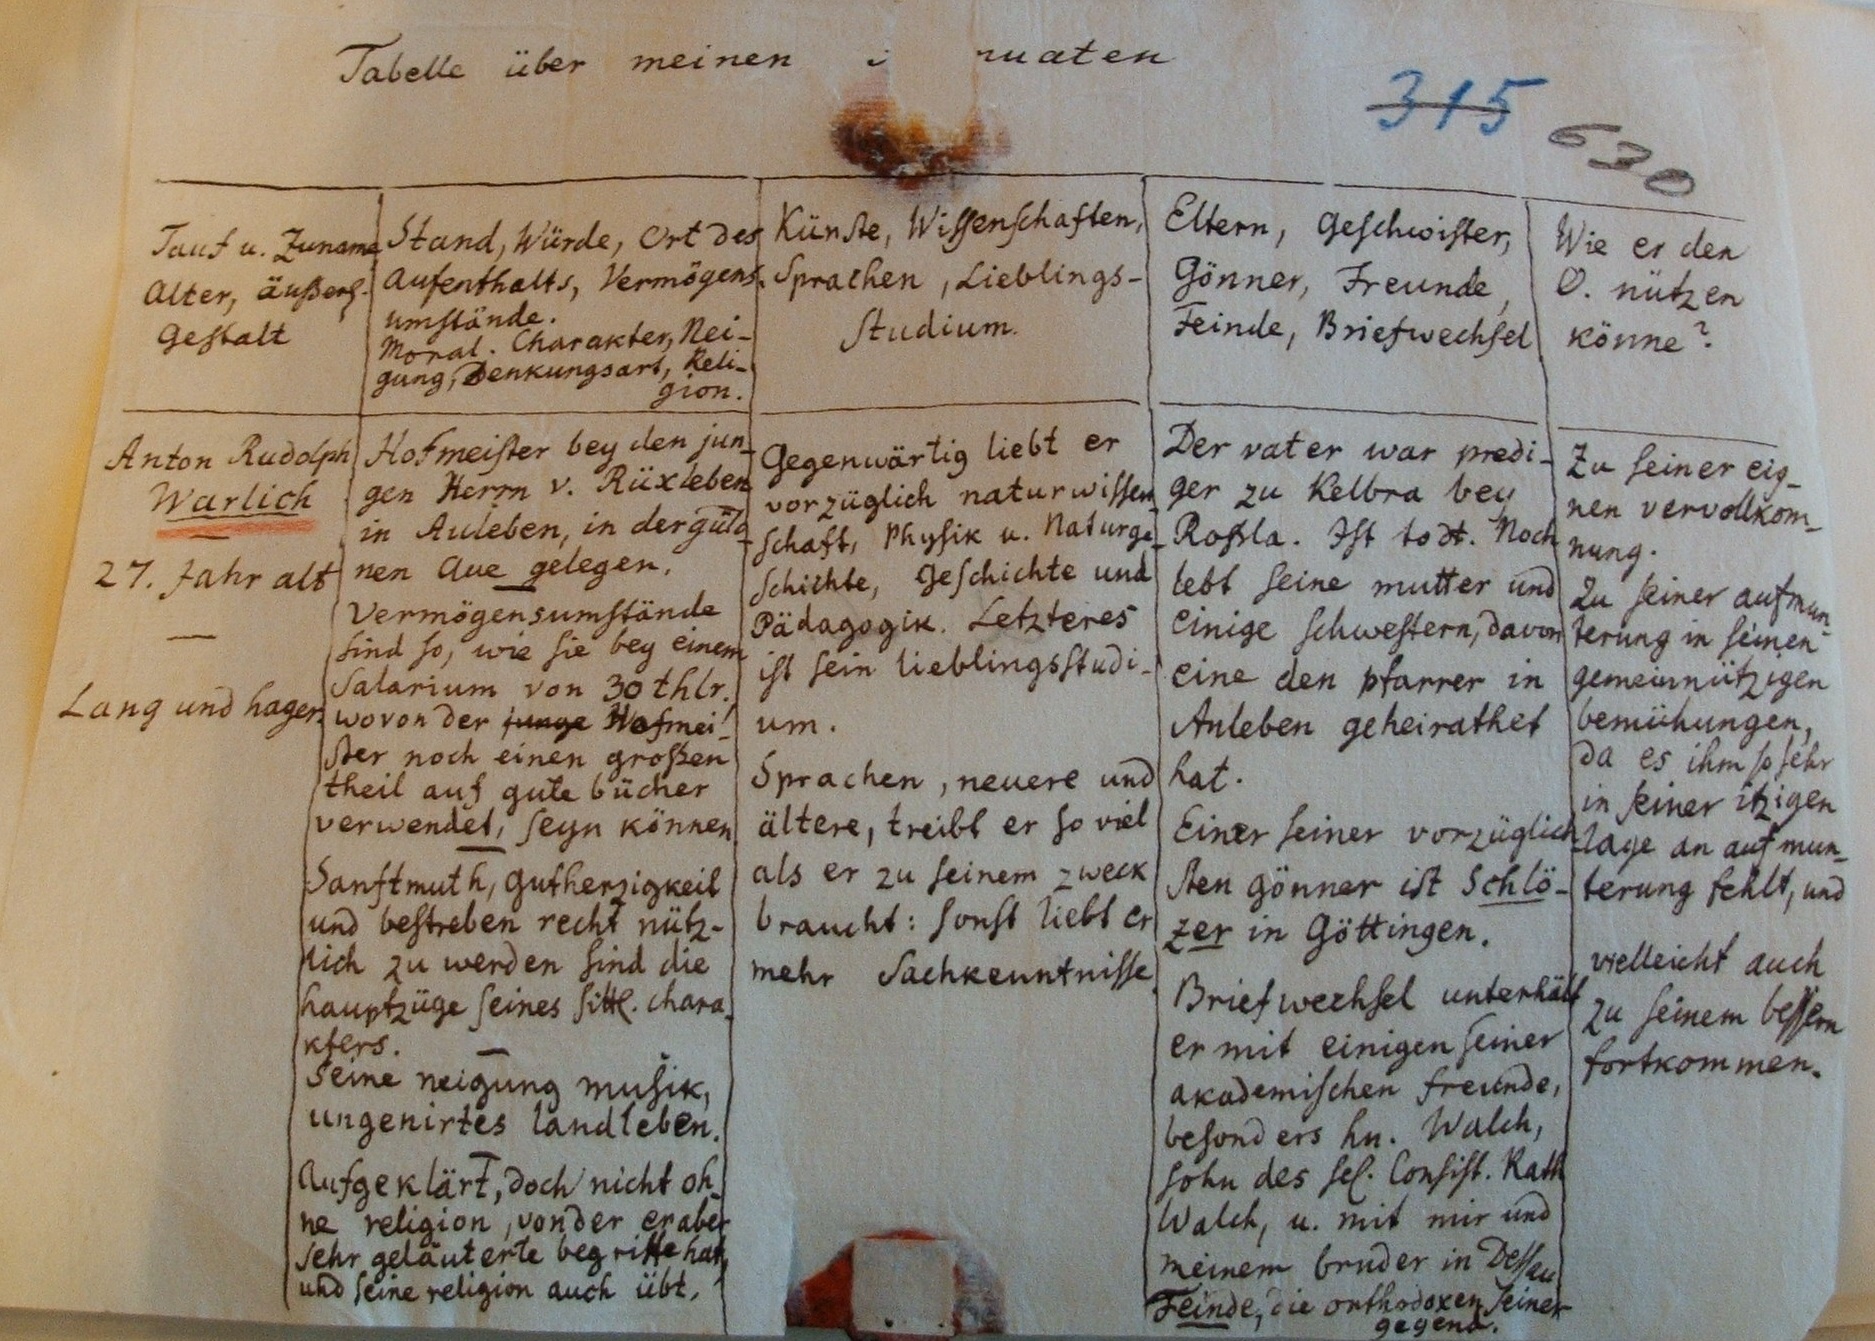
Die Datenbank gestützte Erfassung des Ordens wird auf eine Institution treffen, die gerade um die Datenerhebung und -verwaltung bemüht war. Neumitglieder füllten “Charaktertabellen” aus (aus denen die Unbekannten Oberen, die später mit ihnen kommunizierten, sich ein Bild machen konnten).
Eine Herausforderung wird es sein, die Ordensstruktur in ihrer Theorie mit der Praxis zu messen. Wird es möglich sein zu erfassen, mit welcher Transparenz hier jeweils kommuniziert wurde? Wer wusste wie genau, mit wem er kommunizierte? Welche Kommunikationsverhältnisse blieben semitransparent – so organisiert, dass das Mitglied zwar nicht wusste, mit wem im Orden es Briefe wechselte, die “Unbekannten Oberen” dagegen sehr genau wussten, wer sich an sie in welcher Position und mit welchem biographischen Hintergrund unter welchem Ordensnamen wandte? Letztlich sind es diese spezifischen Korrespondenzoptionen, die den Orden von anderen Gesellschaften unterscheiden.
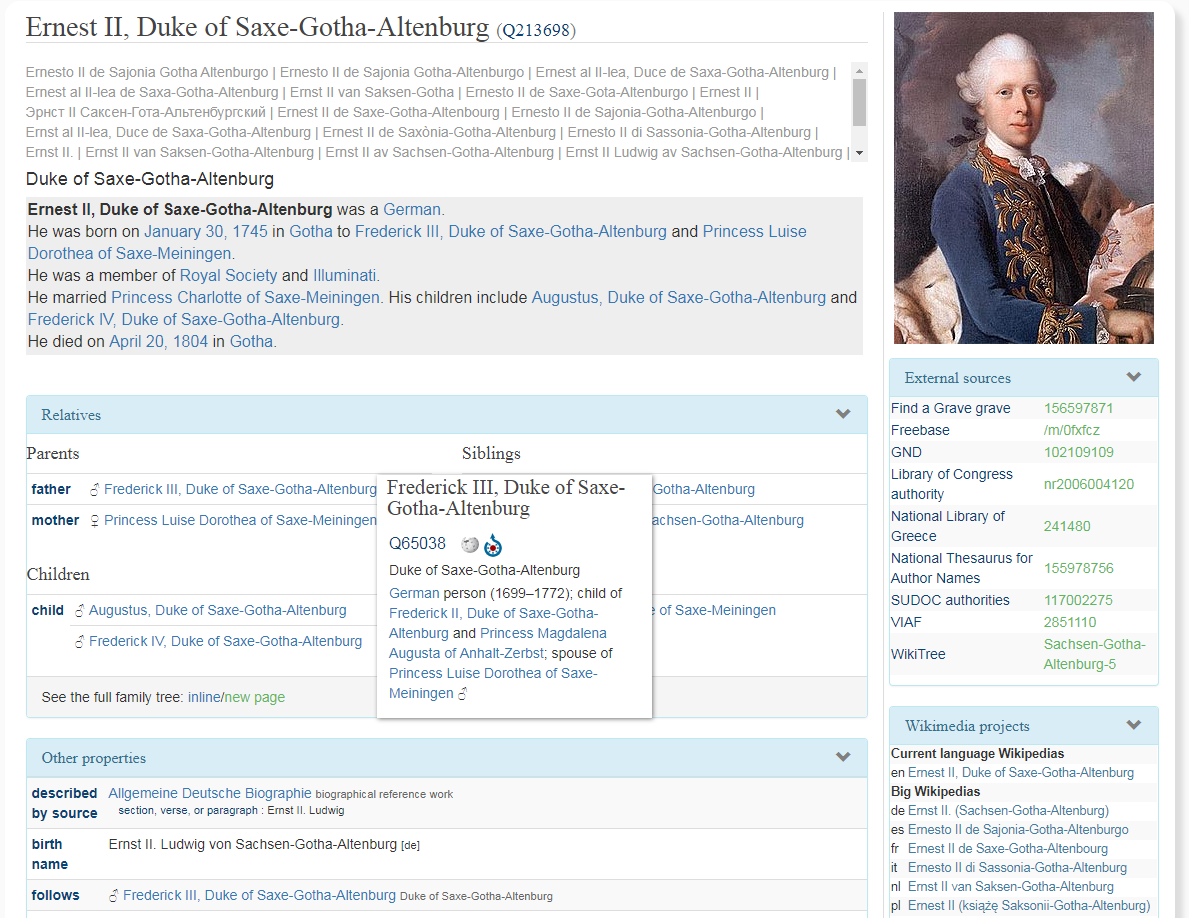
An welchem Tag genau brach Ernst II. 1786 nach Nizza auf? Als Historiker sucht man immer wieder Antworten auf solche spezifischen Fragen, da sich mit ihnen eingehendere Klärungen ergeben (etwa wenn man Dokumente des Umfelds aus den fraglichen Wochen genauer zu verstehen sucht).
Der Wikipedia-Artikel zu Ernst II. wird kein Ort für die Antwort in der gesuchten Präzision – sie ist “enzyklopädisch nicht irrelevant”. Größere Bücher müssen die Information nicht anbieten – sie beantworten größere Fragen in narrativen Bögen.
Was man sich als Historiker in solchen Situationen wünscht, ist eine ganz andere Form von Informationsquelle. Magnus Manskes Wikidata Reasonator nähert sich diesem Ideal an. Man wünschte sich eine Form tabellarischer Lebensläufe, die unter unterschiedlichen Themen beliebig detailliert Auskunft geben.
Das Datenblatt hat einen Kopf mit Eckdaten für die rasche Identifikation: Geschlecht, geboren wann? wo? Sterbedaten, Beruf oder Position, gegebenenfalls zwei zentrale Werke.
Danach sollten Themenblöcke so folgen wie in einem modernen professionellen tabellarischen Lebenslauf. Der Historiker wird dabei keine irrelevanten Details kennen (Informationen können statistisch interessant werden). Standardformulierungen und Tabellenansichten wird man gegenüber kontrovers formulierten Absätzen schätzen, da sie schnellen Überblick verschaffen. Themenblöcke sind dabei:
Begegnungen/ Bekanntschaften (Wohnung, Arbeit, Besuche auf Reisen, Konferenzen etc.)
Korrespondenzen
Werke
…
Im Interesse an der Übersichtlichkeit wird man bei längeren Listen die Vollanzeige auf Wunsch anbieten.
Um Standardisierungen bei der Eingabe zu gewährleisten (und am Ende statistische Auswertungen zu ermöglichen), wird man hier mit modularen Eingabeschablonen arbeiten. Diese werden problemspezifisch zu gestalten sein: Die Mitgliedschaft im Illuminatenorden zeiht ganz andere Fragen nach sich als etwa eine Parteimitgliedschaft. Illuminaten werden von einem Illuminaten vorgeschlagen, sie müssen ab dem dritten Grad Freimaurer sein – was ist die Loge? Sie werden einer Minervalkirche angebunden und können eine Ordenskarriere in einem festen Schema von Graduierungen durchlaufen und dabei bestimmte Ordenspositionen einnehmen. Der Entwurf für eine derartige Schablone gesondert hier. Dasselbe trifft auf Arbeitsverhältnisse zu: Eine militärische Position zieht Fragen nach Rang und Regiment nach sich, eine universitäre nach Universität, Lehrstuhl, Position und Tätigkeit. Man wird Platz schaffen für Angaben zum Gehalt und für eingehendere Ortsangaben, von denen sich lokale Netzwerke ableiten lassen.
Schablonen werden häufig nur rudimentär ausgefüllt sein und Raum für Quellenangaben bieten.
Spannend wird es, wenn statistische Abfragen möglich werden: Welche Altersstruktur hat der Illuminatenorden wann auf welchen Hierarchie-Ebenen? Welche soziale oder berufliche Zusammensetzung haben die Mitglieder? Wie vollzieht sich die Ausbreitung des Ordens auf der Landkarte?
Arbeitssparend wäre es, wenn das System im Verlauf mitzudenken lernt: Die Liste aller Korrespondenzen beantwortet einen Teil der Frage nach Bekanntschaften. Aus einer Information über die berufliche Anstellung ergeben sich weitere Informationen über Bekanntschaften – etwa eines Dozenten zu Studenten, eines Musikers zu anderen Musikern in verschiedenen Orchestern.
Bei der Arbeit mit der Wikidata Software werden Anwender aus dem wissenschaftlichen Feld andere Anforderungen an den Beleg von Informationen stellen.
In Wikipedia-Projekten (und das schließt Wikidata ein) ist der Quellenbeleg zwar die grundlegende Anforderung; da man primär “enzyklopädisch relevantes” Wissen sammeln will, genügt hier jedoch der Verweis auf eine Publikation, die das Faktum so notiert. Bei widersprüchlichen Informationen werden die verschiedenen Angaben kommentarlos nebeneinander gestellt. Wikidata sieht in der Folge in der Regel einen einfachen Beleg vor: die bibliographische Angabe oder ein Link.
Im Moment, in dem Forschung dieselbe Software benutzen will, muss der Beiträger sich mit seinem Namen für den Befund verbürgen können. Der Quellenbeleg ist dabei nicht mehr unbedingt eine bereits verfügbare Publikation. Genauso gut kann eine Archivalie oder eine Schlussfolgerung zum Beleg werden. Die Datenbank muss nun Fakten als Forschungsbeiträge präsentieren können – ein beliebiges Faktum muss als eine Mikropublikation zitierbar sein. Der Forscher, der sich für den Befund verbürgt, muss namentlich genannt werden, seine Erwägungen müssen im komplexen Fall einer Schlussfolgerung mit dem Befund verfügbar werden. Das Einstelldatum des Befunds macht aus dem Beitrag eine wissenschaftliche Publikation. Forscher können andernfalls nicht riskieren, Befunde vor einer anderweitigen Publikation hier bereits allgemein verfügbar zu machen.
Belege im FactGrid werden zu diesem Zweck sich wohl am besten in einem Modul mit Pulldown-Menüs und Eingabefeldern verwalten lassen. Vielleicht wird man über eine Option nachdenken, wie man eine solche Fußnote arbeitssparend duplizieren kann.
1. Ausweis der Forschungsleistung
Die Information liegt öffentlich vor
• Eingabefeld für Publikation und Seitenangabe, respektive Datenbanknennung und Link
• Anweisung, eine Kurzpublikation mit DOI zu erstellen [Daniel Mietchens Tipp]
Die Information wird hier erstmals veröffentlicht
• Eingabefeld für die zu zitierenden Forscher mit Einstelldatum (Default: automatische Signatur)
2. Quelle
Die Quelle ist öffentlich zugänglich
• Eingabefeld für X-Nummer in dieser Datenbank mit dortigem Archivnachweis und wenn möglich mit Scan
Die Quelle ist öffentlich unzugänglich
• Eingabefeld für X-Nummer in dieser Datenbank mit dortigen weiteren Informationen und eventuellem Scan
• persönliches Wissen des Veröffentlichenden
3. Status der Information
solide, laut Dokument
begründete Schlussfolgerung
Arbeitshypothese
vage vorliegende Information
widerlegt
privates Wissen/ Familienwissen
allgemeine Annahme
Behauptung in einem fiktionalen Rahmen
Behauptung in religiöser Annahme
4. Diskussionsfeld
5. Zitierlink, das die Informationen zu einer Fußnote zusammenfasst
Es geht mit diesen Optionen darum, den noch nirgends publizierten Befund notierbar zu machen und an eine Diskussion und Bewertung zu koppeln. Man kann im selben Moment zulassen, dass Beiträger selbst privates Wissen (etwa um persönliche genealogische Beziehungen) einbringen, denn es bleibt als solches in seiner Angreifbarkeit wie seinen ganz eigenen Qualität ausgewiesen.
Auf dem Weg zur automatisch generierten Fußnote in Wikipedia
Aus den Angaben sollten sich letztlich automatisiert Fußnoten in beliebigen Sprachen generieren lassen: Goethe wurde am 28. August 1749 geboren – die Fußnote dazu notiert, aus welchem Dokument oder welcher späteren Quelle wir das wissen und führt im brisanten Fall zu einer Diskussionsseite, auf der Forscher sich über die Angabe einigten.