FactGrid FAQ – Why should I use FactGrid for my research project?

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).

auf Deutsch
en français
magyarul

What is FactGrid?

FactGrid is a Wikibase installation — that is is both, a regular wiki and a database which you can use to make statements about objects of your interest — statements which you can then handle in practically any language in big data sets.

The platform is run by the Gotha Research Centre and hosted by the ThULB Jena. It addresses projects with a specific interest in historical data and is part of the German National Research Data Infrastructure NFDI4Memory.

In joint ventures with Wikimedia Germany and the German National Library’s GND we are trying to bring this platform into the upcoming consort of federated Wikibase instances as a resource for research data.

Why should I use FactGrid for my own research?

The biggest argument for a FactGrid account is the unbeatably flexible software, Wikibase, which we have managed to implement in a pilot project with the help of Wikimedia Germany – outside its primary location, Wikidata:

  • You are looking for a software that speaks practically any language — a platform on which you can enter data in your language and allow others to read your data in their languages? Wikibase is this software.
  • You are looking for software in which you can transparently coordinate a whole team? In Wikibase this is as easy as in the Wikipedia software MediaWiki .
  • You are looking for a database software that can do everything Digital Humanities databases normally want to do: network analysis, map representations, complex linked searches, timeline representations (in various formats) – a software that almost acts like human language yet provides full database services? Wikibase is this software.
  • You have data from previous projects which you want to build on? Wikibase has large-scale automatic input options.
  • You want to make sure that that other projects will actually use your data? Use a platform that allows the download and further work with your data offline in Excel or online in ever new projects.
  • You want to ask entirely new questions in your research? In Wikibase you can link any sort of objects with any kind of statements of your interest.
  • You are worried what will happen to your data and presentations once your funding is over? Work on a platform where you do not stay alone and where, thanks to the CC0 license you are using, you encourage colleagues to continue right were you stopped!

If you are looking for a long term perspective this is what we are trying to offer in our present joint venture with the German National Library. We will base our platform on GND data in order to serve as a broad public tool and with the aim to become a player in the emerging landscape of “Federated Wikibase installations”.

Why not use Wikidata right away?

That is a legitimate question to ask. There will be projects (projects that are mainly using data) for which Wikidata will be the better platform. The FH Potsdam’s “Archivführer zur deutschen Kolonialzeit” has demonstrated the beauty of working directly on Wikidata; we talked about this with Uwe Jung, who demonstrated the technical solutions they have chosen in Potsdam.

On the other hand, there remain basically two things which you will not be able to do on Wikidata or on a platform like the GND: Wikimedia projects (and the GND) have strict “No original Research” policies and observe fundamental decisions to operate on “criteria of notability“, which will not allow the arbitrary opening of database objects and the innovative object relationships researchers would like to test.

Wikidata and the GND focus on information that has already been published and on non-research workers who feed the respective databases from published research. You will not be allowed to state a “working hypotheses” of “your research” on these platforms. You will not be able to create entities with the aim to run “nothing but a statistical analysis” on them at a far later stage of your work.

In FactGrid we encourage the use of the platform as a heuristic research tool.

  • Create database objects on the platform, no matter what their relevance in an encyclopedia or in library catalog could be.
  • Risk provisional chronologies as working hypotheses along with your personal assumptions.
  • Use FactGrid in order to make unconventional statements that are presently interesting only in your research project – the software gives you this freedom.
  • Create specific database objects that state your research in all the data sets which you have substantially modified and become able to submit your research with the particular item as the envelope to your funding institution.
  • Risk any new thesis on the platform and state your respective view with a database object number as a “micro-publication” in order to claim your ingenuity on the data base.

FactGrid is free – how does it work?

The software is freely available and under development in the larger community of Wikimedia projects and among the institutions which are going to use Wikibase over the next years.

The FactGrid platform is presented by the Gotha Research Centre on a virtual server of Jena’s University Library free of charge.

All the Wikidata-tools are available to our users. These include all the standard applications of regular Digital Humanities projects.

With both software and tools being open source you can use any favorite software company you are working with, to generate the specific application which you feel you need.

If you feed your tools into the open compound this will be your best way to make sure that future projects will continue their development.

If you aim at technical solutions which you want to sell with financial profit that again will not be restricted by the software license. You can freely commercialize whatever you create on the basis of the open software.

What do I do with unorthodox research interests?

Wikibase is groundbreaking in its data modelling. Essentially you are only creating relations between Q-numbers (or relations between Q-numbers and dates, Q-numbers and space coordinates, Q-numbers and media files, Q-numbers and URLs).

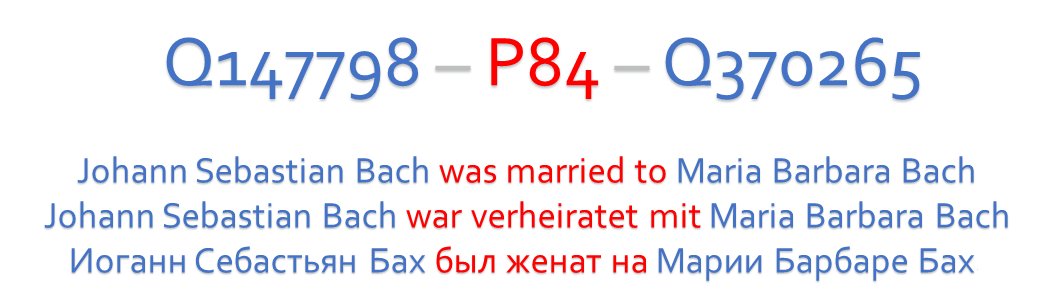
The software does not know what kind of relationships you are stating – these again are just P-numbers: Q1 – P1 – Q2 is a “triple” and can mean “Johann Sebastian Bach (Q1) is the father of (P1) Carl Philipp Emanuel Bach (Q2)”; it can mean just as well “This letter which I found in the archive with the shelf mark XYZ (Q1) has allegedly been sent from (P1) Munich (Q2)”

Q-numbers can be assigned to anything imaginable – people, documents, events, ideas… You decide what kinds of P-numbers you need in order to make statements of your interest. You do not define objects in a system of fixed categories; your statements are adding colour and solidity to whatever object you create as you go along. Do not worry if you do not have the data model on day one. Make statements when you suddenly want to make them and see how they gain the critical mass that can eventually be evaluated.

All statements can be “qualified” – “Johann Sebastian Bach (Q1) was married to (P2) Maria Barbara Bach (Q2) beginning on (P2) October 7, 1707 (date) ending (P3) about July 5 1720 (date).” All of these statements can in turn be equipped with references : “this is clear from (P4) the church book of… (Q3)”,”this is stated in (P5) the well known Bach biography XYZ (Q4)”.
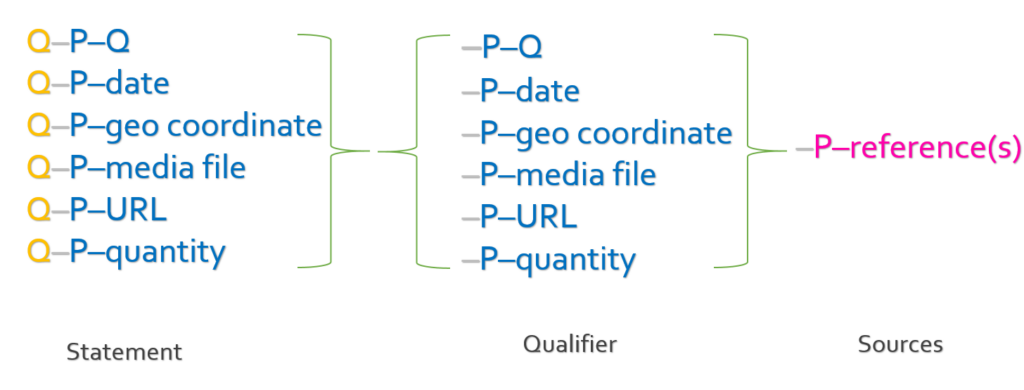
The system allows competing claims at any time. They are simply introduced with their different sources and can be balanced against each other.

You can create practically any normal language statement with triples of this depth of specificity; but above all, this opens the door to the world of statements in all the various languages you might want to speak: The system operates with Q- and P-numbers; the rest is labels in languages which you want to offer to your users. The software will in addition translate dates and quantities into other formats; this is basically the secret that makes it possible for Wikibase platforms to be edited by people in their own languages and to be read by the world in practically any other language.
Which tools does the software provide?

Database entries can be made one by one: Open the object-id in question, go to the bottom of the input page and click the “add statement” link. You will now be asked for the statement you want to make. You do not need to know the P-number. State the property in the language you are using and click at the auto complete you are eventually being offered. The platform will now use the P-number of that statement for you. Complete in the next box that opens your statement. You will again get suggestions to use as you are typing.

Database entries can also be created and substantiated in automated inputs from Excel or CSV lists. (This is the input mask and this is the short guide to it.)

Database queries have to be formulated as “SPARQL” queries, a search language that is (unfortunately) not that easy to use, but that is eventually as complex as the searches you might want to perform.

SPARQL users do not necessarily know how to write SPARQL source code. You usually use sample queries that tell you where you have to change the input in order to run your particular search.

If you know exactly which type of search queries your users should run you can create your own input masks just as you know them from conventional online library interfaces, which will then speak SPARQL with the database.

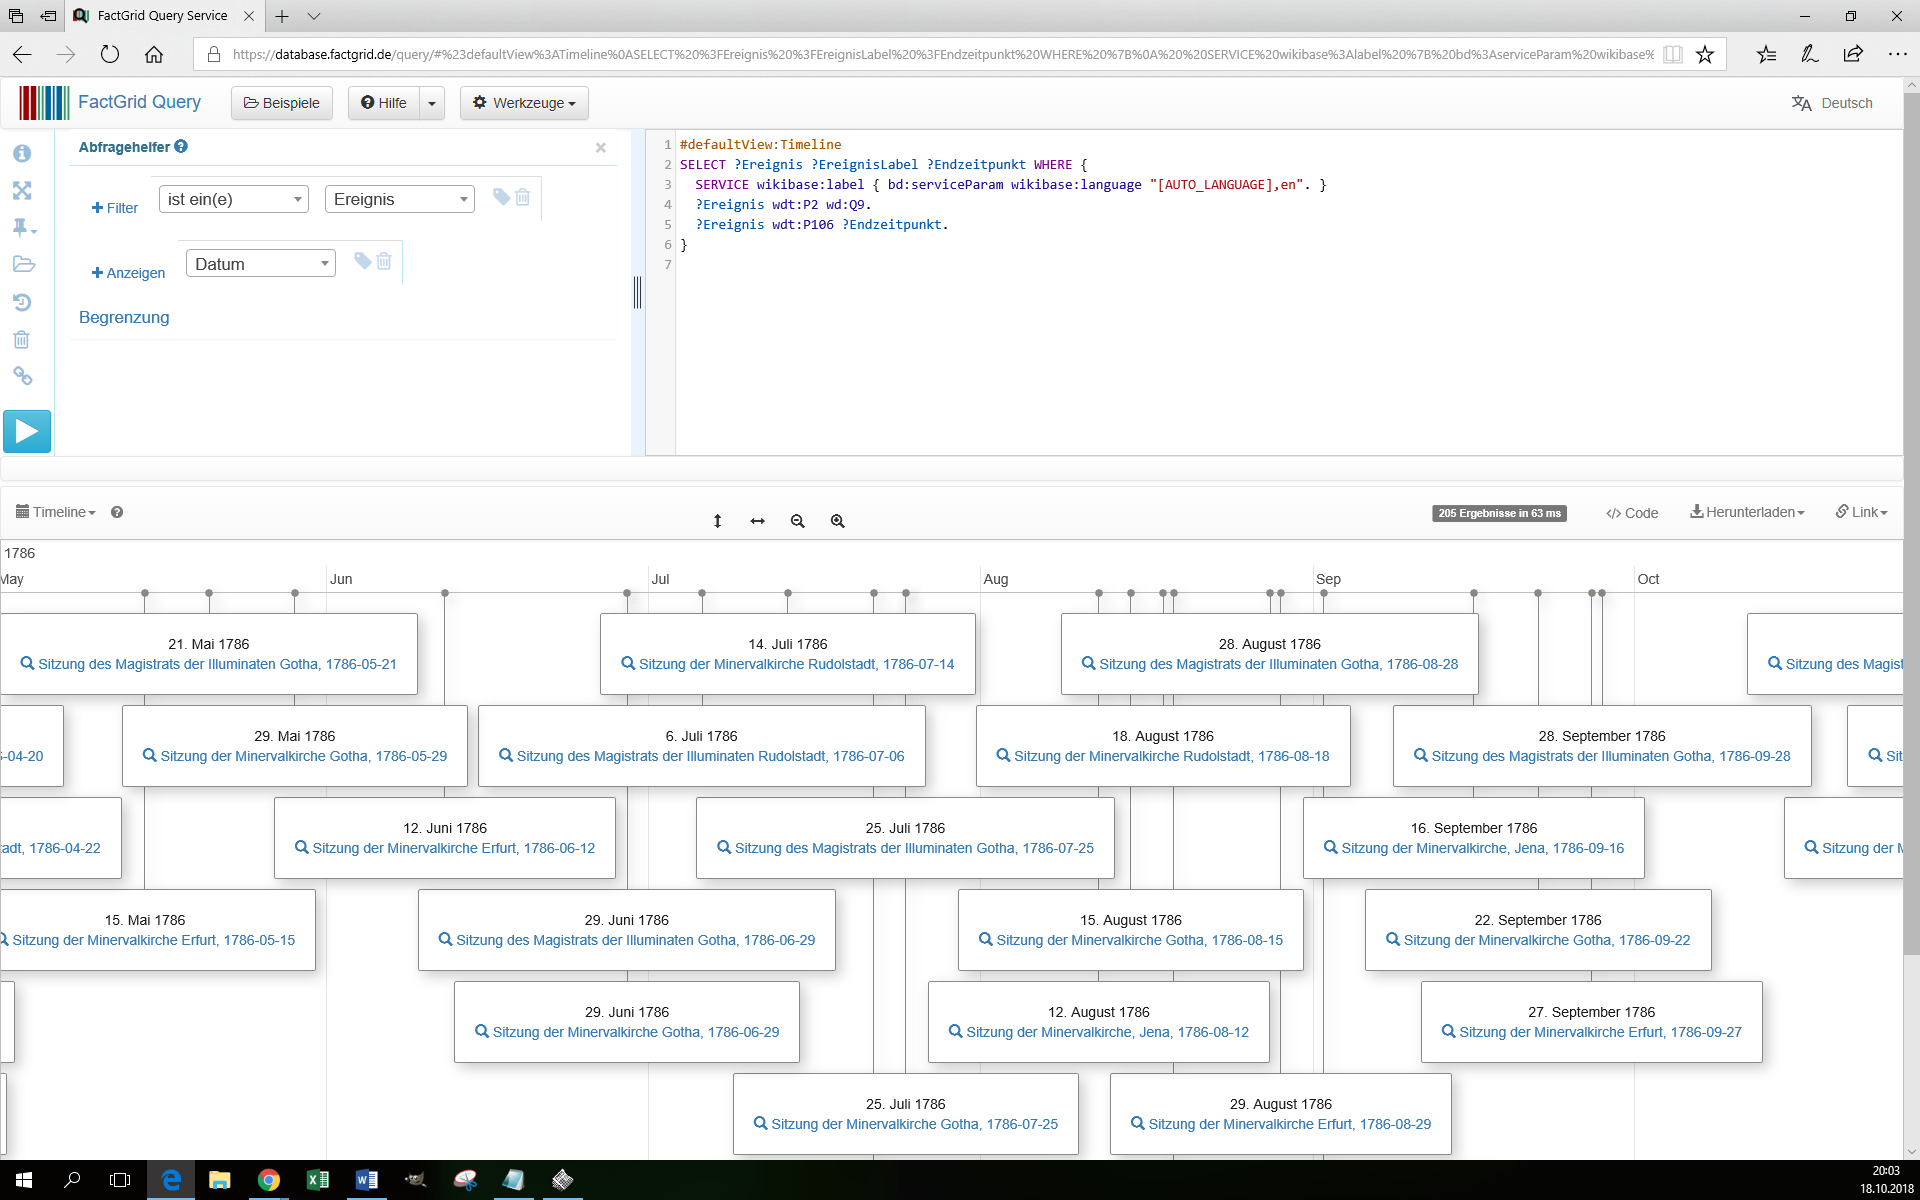
The software package includes illustrations on maps, timelines, networks, genealogical relationships, graphs, and so on. You do not need to download particular applications. You will ask SPARQL to produce the representation you are trying to get. The Scholia project on Wikidata has a beautiful first presentation of some of the visualisations.

What do I do if I want to give my very own data representations on my own platform?

That should not be a technical problem. Uwe Jung demonstrated how the FH Potsdam interface uses Wikidata as its data repository, without letting users see the database they are accessing.

There is nothing wrong with using FactGrid as an external repository and building up your own research project on the server of your home university, where you can offer targeted database accesses under a typical search template of your choice.

FactGrid basically licenses data to CC0 – does that not mean that I give up all rights to my research?

Opting for the Creative Commons 0 license means essentially that you continue to be free to do whatever you want with your data – you, and not your publisher or the platform that received your data under a scheme, continue to control. But above all, the CC0 license means that your data becomes freely usable and that you can thus reduce the danger of obsolete research in the longer run – others will continue to root out the ugly mistakes you could not hope to correct.

Some basic considerations: CC BY 4.0 is at first glance the license that scientists will prefer: It allows the free further use as long as it receives the accurate citation. In practice, this will work for texts (such as this blog post); here it is clear how one would like to see the text cited: with a reference to one’s own name, with the title of the publication, the place of publication and the date. But do you want your data quoted let us say in a visualisation? A letter sent from Paris to Berlin in June 1753 will be a line on a map and how should this line be properly annotated? How do you want to be quoted if you only improved a data set? “Share alike” licenses are even more problematic: “These data are freely available if the subsequent users keep it just as freely available.” That sounds like the ultimate plea for free use. But how can a sub-user ensure that his sub-users, in turn, will respect your license agreement (especially if this sub-user is offering his data on CC0)? Sub-users are well advised not to use data from CC-BY or CC Share-Alike platforms.

Our joint ventures with Wikidata and the German National Library left us only only one option: to make our data as freely available as our partners: CC0, that is without ensuring that subsequent users will still specify exactly who collected the data, and what third-party users are allowed to do with that data.
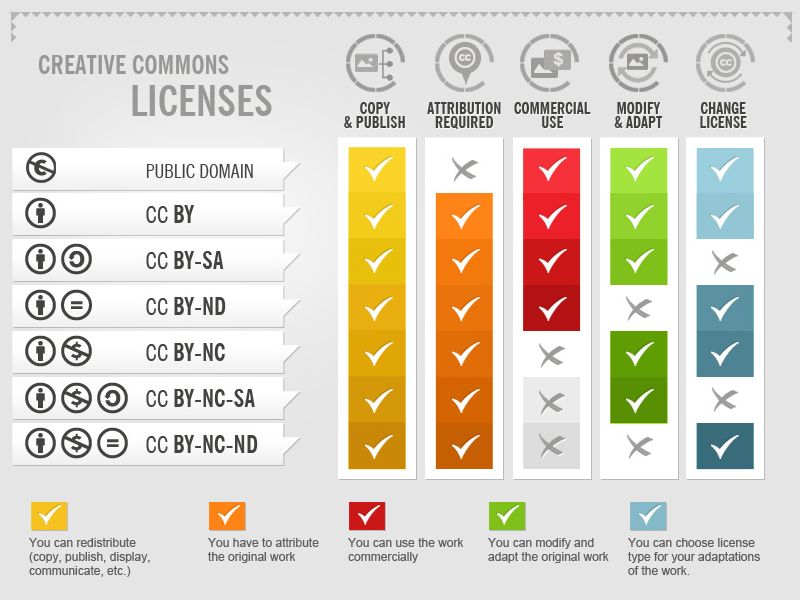

In practice, the maximum open license does not mean that FactGrid data is data without authorship, quite the contrary. We suggest that research is cited and assume that Wikidata and the GND are only too happy to state research from our platform. All changes are linked to respective the author names. If research projects have worked more substantially on a data set, they will have stated this in a separate note on the data set that can now be adopted with the data transfer.

Databases like Wikidata or DNB’s GND are in fact interested to quote research – it boosts their data solidity, and FactGrid is here in the unique position to give both institutions a platform on which people can do what they cannot do on the respective larger platforms.

What happens if I want to continue working with my data on another platform?

Since you entered your data without a copyright restriction, you are free work with them on any other project of your interest. We actually like to be “just an incubator” for research data.

What happens when FactGrid users argue about a “correct” date?

The software makes it possible to handle contradictory data. This is particularly interesting in the field of historical research, where we often have conflicting documentary evidence without being able to determine the correct statement after so much time. The software makes it possible to reproduce such a contradictory situation. Numerous statements can be given side by side with their various respective sources. You can then still balance the statements against each other – either by turning one of them into the statement to privilege in future searches and/or by adding qualifying statements with your personal evaluations.

If two researchers come to different results, think of it as the situation you should actually be interested in. It is far worse that you have made mistakes on a platform where they will never be corrected and where they eventually discredit all your work as obsolete beyond repair.

Why should I risk transparency in my project right from the start?

This is likely to be the toughest issue that currently prevents projects from using the resource which we have opened. The alternative is the resource, which is accessible to the team only under passwords until the publication deadline is reached almost at the end of the project. No competing project can snatch away findings, so the theory. No one sees where you have initially made a mistake. Nobody records what assistants are typing in and where the project leader is involved – such are the presumed advantages of non-transparent working on a platform that will only go online at the end of your funding.

Transparent research offers its own securities: If you find a groundbreaking document and establish a decisive connection, then this is your chance to fix the statement to your name and project. If someone makes the same discovery tomorrow in the archive you have just visited, tough luck. You will have recorded your observation with a link in the version history which your rivals will not be able to deny.

At the same time, the collective platform expresses the invitation to cooperate. Make it clear to other teams what you are working on and allow them to contact you on the platform!

The risks of the allegedly secure website, which is only going online at the end of the project’s funding, are serious: The time for an exchange with users is over. The internet presence goes online in the heated final weeks while the project is totally unable to react with more conceptual changes. If you have done research solely for a book publication, it will remain unclear what you and your team should do with the data, you have still collected in Word files, and Excel spreadsheets. Nobody will be able to feed all these data into any resource – the harmonisation at this late stage will be an insurmountable obstacle. You can only hope that readers of your book will scan all your footnotes for corrections that should reach our library catalogs and the various Wikipedia projects. The risk is here the book that has no influence on the collective data base and of DH projects that become obsolete right after their publication.

The future should lie in a new attitude toward the public data base. Researchers should be able to correct and to further widen this base wherever they access it. The incentive and the security they will need here is the research environment in which they can mark their work and make it citable. For this Wikibase is better equipped than any other software.

How do I get my project accepted on FactGrid?

The FactGrid platform has no invisible deeper layer. Anyone can query the database and the queries will give the same information whether you are logged in or not. Your personal user account just has the advantage that you can now switch to your favorite language when looking at data, and that you see the edit link on each statement.

If you want to feed your own data into the platform and if you want to run a project on the the platform, you will need an account. These are given under real names by the administrators. The software provides an “account request” link. You can also contact us via email. Project leaders can receive administrative accounts which they use to assign to team members and users of their interest.

Once logged in, you can enter data in bulk or make specific corrections wherever you feel like. Any input will be connected to your user account. Others can undo your edits but not without leaving a documented mark of that intrusion in the version history – visible to all the world.

If you want to work on a more complex project —

  • that can be personal family research,
  • it can be a single visualization you need in a seminar paper,
  • it may just as well be the input of thousands of records in a 5-year research project

— speak with those on board and those organising the platform. We will not (necessarily) be interested to sign a public memorandum of understanding with you but it might be cool to advertise your project on the blog and to make it known on the entire platform. Your work becomes exciting, where you modify the work others have already done and where you encourages players from other projects to adopt good models which you are introducing. You do not need to discuss data models with all the others but using models with all the others is also a way to spread your work and to make it appear in queries composed by others, and visualizations you did not think of.

The software is designed to manage both: unique statements which only you are interested in and statements that will spread far beyond your own initial research interest as you are now feeding the unforeseen queries which others will run on their and your data.

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).
Jack Kirby, “The Fourth Dimension is a many splattered thing!” from Alarming Tales, 1 (September 1957).

FactGrid FAQ – Warum sollte ich das FactGrid für die eigene Forschung nutzen?

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).

in English
en français
magyar nyelven

  1. Was ist das FactGrid?
  2. Warum sollte ich das FactGrid für die eigene Forschung benutzen?
  3. Warum nicht gleich Wikidata benutzen?
  4. Das FactGrid kommt kostenfrei – wie geht das an?
  5. Was mache ich mit unorthodoxen Forschungsanliegen?
  6. Welche Tools stellt die Software mir zur Verfügung
  7. Was mache ich, wenn ich ganz eigene Datendarstellungen auf meiner eigenen Plattform realisieren will?
  8. Das FactGrid lizenziert Daten grundsätzlich CC0 – heißt das nicht, dass ich alle Rechte an meiner Forschung aufgebe?
  9. Was geschieht, wenn ich mit meinen Daten auf einer anderen Plattform weiterarbeiten will?
  10. Was passiert, wenn es zwischen FactGrid-Benutzern zum Streit über ein “korrektes” Datum kommt?
  11. Warum sollte ich in meinem Projekt Transparenz schon von Anfang an riskieren?
  12. Wie nutze ich das FactGrid konkret?

Was ist das FactGrid?

Das FactGrid ist eine Wikibase-Instanz, die, vom Forschungszentrum Gotha aus organisiert, an der ThULB Jena gehostet wird.

Wikibase ist die Software, die hinter Wikidata läuft. Die Instanz will historischer Forschung einen eigenen Freiraum zur Verfügung stellen und im Verlauf technisch in der Lage sein, mit der GND und mit Wikidata laufend Daten auszutauschen — Daten, die aus dem FactGrid heraus international als Forschungsdaten zitierbar werden. Seit dem 5. November 2022 ist das FactGrid — als global agierende Plattform — offizielles Repositorium im Spektrum der deutschen Nationalen Forschungsinfrastruktur, NFDI4Memory.

Sehen Sie hierzu auch den Beitrag zu den Zielerwägungen, den Barbara Fischer für die GND und Jens Ohlig für Wikimedia am 9. Mai 2019 im Wikimedia Blog veröffentlichten.

Warum sollte ich das FactGrid für die eigene Forschung benutzen?

Dafür spricht erstens die unschlagbar flexible Software, Wikibase, die wir im Pilotprojekt mit Wikimedia Deutschland bahnbrechend außerhalb ihres eigentlichen Orts, Wikidata, zum Laufen brachten:

  • Sie suchen eine Software, die praktisch jede gängige Sprache spricht und in der sich Daten in jeder Sprache eingeben und in danach in beliebigen anderen Sprachen ausgeben lassen? Wikibase ist diese Software.
  • Sie suchen eine Software, in der Sie ein ganzes Team transparent koordinieren können? In Wikibase ist das so einfach wie in der Wikipedia Software MediaWiki.
  • Sie suchen eine Datenbank-Software, die alles kann, was Datenbanken der Digital Humanities normalerweise können: Netzwerkanalysen, Repräsentationen auf Landkarten, komplex verknüpfte Recherchen, Timeline-Darstellungen (in verschiedenen Datenformaten), und die sich dabei einem Umgang mit normalen Aussagen annähert? Wikibase ist diese Software.
  • Sie haben Datenmengen aus vorheriger Forschung, auf die Sie aufbauen wollen? Wikibase erlaubt den großflächigen automatischen Input.
  • Sie wollen sicherstellen, dass Ihre Daten nachnutzbar werden? Wikibase ist genau darauf eingestellt.
  • Sie wollen neuartige Fragen an Material stellen? In Wikibase können Sie beliebige Objekte mit beliebigen Aussagen Ihres Interesses verknüpfen.
  • Sie fragen sich, was nach Ihrer Projektlaufzeit mit Ihren Daten und Ihren Präsentationstools noch geschieht? Setzen Sie auf eine Plattform, auf der Sie nicht allein arbeiten und auf eine Datenlizenz, die es anderen ermöglicht, Ihre Arbeit wirklich risikolos zu nutzen und fortzuentwickeln!

Für das FactGrid spricht im selben Moment, dass wir im Interesse am breiten und offen bleibenden Datenaustausch in einer Kooperation mit der Deutschen Nationalbibliothek die gesamte Plattform soeben auf GND-Daten aufsetzen, um das Projekt in seiner größeren Breite in der entstehenden Landschaft von “Federated Wikibase Platforms” zu verankern.

Warum nicht gleich Wikidata benutzen?

Das ist eine gute Frage, die man sich stellen sollte. Es wird Projekte geben (die hauptsächlich Daten nutzen), für die Wikidata die bessere Plattform ist. Für die FH-Potsdam demonstrierte dies der „Archivführer zur deutschen Kolonialzeit“; wir sprachen darüber mit Uwe Jung, der die technischen Lösungen vorstellte, die man dort realisierte.

Zwei Dinge, gibt es, die es andererseits interessant machen, gezielt eine (Wikidata und die GND beliefernde) eigene Plattform aufzubauen: Die Wikimedia- (und GND–) spezifische “No Original Research” Grundregel und die fundamentale Entscheidung für Relevanzkriterien auf beiden Plattformen, die das beliebige Aufmachen von Datenbankobjekten und Objektbeziehungen ausschließt.

Wikidata und die GND richten sich auf bereits publizierte Information aus und auf Bearbeiter außerhalb der Forschung, die Publikationen auswerten und Daten eingeben. Unmöglich wird es bleiben, auf diesen Plattformen Arbeitshypothesen zu riskieren, Datierungen, die erst einmal auf Probe gestellt sind, Personeninformationen, die später in einer Publikation nur statistisch ausgewertet werden sollen.

Im FactGrid ermuntern wir zur Nutzung der Plattform als heuristischem Forschungstool.

  • Legen Sie hier Datenbankobjekte an, die Sie weit später erst auswerten wollen, egal welche Relevanz diese in einer Enzyklopädie oder in Bibliothekskatalogen gewinnen können.
  • Riskieren Sie provisorische Datierungen – als Arbeitshypothesen zusammen mit Ihren persönlichen Annahmegründen.
  • Wagen Sie im FactGrid unkonventionelle Aussagen, die erst einmal nur in Ihrem Forschungsprojekt interessant sind – die Software erlaubt es Ihnen.
  • Bauen Sie eigene Datenbankobjekte zu Ihren Forschungsprojekten und verknüpfen Sie diese mit allen Datenbankobjekten, an denen Sie arbeiteten, um so Ihrem Geldgebern die eigene Forschung im Paket der Datenbeziehungen vorlegen zu können.
  • Riskieren Sie im FactGrid Thesen und führen Sie diese in der Datenbank als “Mikro-Publikationen” mit eigenen Datenbank Objekt-Nummern.

Das FactGrid kommt kostenfrei – wie geht das?

Die Software ist frei verfügbar und befindet sich in einer von großen Communities getriebener Entwicklung im Wikimedia-Bereich und in Zukunft in hinzukommenden Institutionen wie denen der europäischen Nationalbibliotheken, die soeben eigene Wikibase Instanzen und Tools bauen.

Das FactGrid selbst läuft unter Ägide des Forschungszentrums Gotha auf einem virtuellen Server der Universität Erfurt. Für die deutsche URL fallen jährlich €36 Domaingebühren an, die vom Forschungszentrum Gotha getragen werden.

Nutzern stehen alle Tools aus dem Wikidata Projekt zur Verfügung. Mit ihnen sind die Standardanwendungen gängiger Humanities Projekten erst einmal abgedeckt.

Da die Software open source ist, können Projekte eigene Software-Etats gezielt in Tools und Präsentationen investieren, um die es ihnen in der eigenen Forschung geht. Arbeiten Sie gerne mit einer favorisierten Softwareschmiede zusammen, so wird diese, was den Quellcode der laufenden Software anbetrifft, vor offenen Türen stehen. Bieten Sie Ihre eigenen Entwicklungen offen zur Weiterentwicklung an, und Sie können darauf vertrauen, dass Visualisierungen auch nach Ihrer Projektförderung noch fortentwickelt werden. Streben Sie dagegen eigene Softwarelösungen mit dem Ziel einer kommerziellen Vermarktung an, so bindet Ihnen die Software-Lizenz hier nicht die Hände: Sie erhalten die bestehenden Softwarelösungen frei und können eigene darauf aufbauenden Tools jederzeit kommerziell verwerten.

Was mache ich mit unorthodoxen Forschungsanliegen?

Wikibase ist bahnbrechend offen in den mit dieser Software möglich werdenden Datenbankanwendungen. Letztlich werden hier nur Beziehungen zwischen Q-Nummern hergestellt (respektive Beziehungen zwischen Q-Nummern und Daten, Q-Nummern und Raumkoordinaten, Q-Nummern und Mediendateien, Q-Nummern und Internetadressen).

Was das für Beziehungen sind, das ist für die Software irrelevant. Q1 – P1 – Q2 ist ein “Triple” und kann bedeuten “Johann Sebastian Bach (Q1) ist der Vater von (P1) Carl Philipp Emanuel Bach (Q2)”; es kann genauso gut bedeuten “Der Brief des Archivs X mit der Signatur YZ (Q1) notiert als Absendeort (P1) München (Q2)”

Q-Nummern können für alles nur Denkbare vergeben werden – Personen, Dokumente, Ereignisse, Ideen… Sie selbst legen fest, was für P-Nummern Sie definieren wollen, um Aussagen Ihres Interesses zu Ihren Datenbankobjekten zu treffen. Im System kristallisiert sich letztlich erst mit den Aussagen, die Sie zu Ihren Objekten treffen, heraus, welcher Art Objekte das sind. Das heißt: Sie benötigen kein Kategoriensystem, das Ihnen im Vorhinein klar sein muss, um mit der Datenbank zu arbeiten. Sie treffen Aussagen dann, wenn Sie sie plötzlich setzen wollen, und sehen zu, wie sich diese zu einer kritischen auswertbaren Masse akkumulieren.

Alle Aussagen lassen sich “qualifizieren” – “Johann Sebastian Bach (Q1) war verheiratet mit (P2) Maria Barbara Bach (Q2) mit Beginn am (P2) 7. Oktober 1707 (Datum) bis zum (P3) ca. 5. Juli 1720 (Datum).” Alle diese Aussagen lassen sich wiederum beliebig mit Quellenaussagen versehen – “das geht hervor aus (P4) dem Kirchenbuch von… (Q3)”, “das wird so behauptet in (P5) der Bach-Biographie XYZ (Q4)”.

Das System lässt jederzeit konkurrierende Behauptungen zu. Sie werden einfach mit ihren unterschiedlichen Quellen eingebracht und können dabei beliebig untereinander bewertet werden. In ihrer weiteren Nutzung im System gewinnen sie ihre eigentliche Bedeutung.

Letztlich lassen sich auf damit beliebige normalsprachliche Aussagen generieren; vor allem aber öffnet dies die Tür in die Welt global handhabbarer Aussagen. Für das System spielen sich alle Aussagen nur als Verknüpfungen von Q-Nummern mittels P-Nummern ab. Sie selbst belegen die Q- und P-Nummern mit “Labeln” in den Sprachen, in denen Sie kommunizieren (Datums- und Mengenangaben verwaltet das System bereits in beliebigen globalen Standards mit automatischer Umrechnung in jede Richtung); so das Geheimnis, das es möglich macht, dass auf Wikibase Plattformen Autoren in ihrer jeweiligen Sprache eingeben und andere Nutzer diese Informationen in beliebigen Sprachen auslesen.

Welche Tools stellt die Software mir zur Verfügung

Datenbank-Eingaben können sukzessive erfolgen: Sie wollen über ein Objekt eine neue Aussage treffen? Rufen Sie das Objekt auf, gehen Sie ans Ende der Eingabe-Seite, wo “Aussage hinzufügen” steht, und beginnen Sie die Aussage in Ihrer Lieblingssprache – das System ergänzt mit Auto-Complete die gesuchte Aussage und sucht sich die P-Nummer dieser Aussage heraus. Tippen Sie in das sich nun eröffnende Feld ein, auf welches andere Objekt diese Aussage laufen soll oder auf welches Datum (in Ihrer Sprache) und die Software macht ihnen immer präzisere Vorschläge, noch während Sie tippen.

Datenbank-Eingaben können zweitens massenweise und automatisiert in gängigen Formaten aus Excel-Listen oder CSV-Listen erfolgen. (Dies ist die Eingabemaske und dies die kurze Anleitung dazu.)

Datenbankabfragen geschehen im Gegenzug mit “SPARQL“, eine Such-Sprache, die (leider) nicht einfach zu bedienen ist, die es jedoch nun erlaubt, die Datenbank beliebig komplex zu befragen – komplexer als jede Standard-Suchmaske Ihnen das erlauben würde. SPARQL-Nutzer müssen nicht unbedingt den SPARQL-Quellcode schreiben können. Man bedient sich in der Regel einer passenden Musterabfrage, die man in einer Sample-Queries-Liste findet, und tauscht hier die Suchbegriffe aus.

Weiß man exakt, welcher Art Suchanfragen Benutzer des eigenen Projektes durchführen können, so lassen sich Suchschablonen wie in herkömmlichen Katalogen bauen, die die Anfragen an das System unterhalb der Benutzeroberfläche in SPARQL formulieren.

Im Software-Paket finden sich Darstellungen auf Landkarten, Timelines, in Netzwerken, genealogischer Beziehungen, Diagramm-Darstellungen und so fort. Für diese Anwendungen müssen keine Softwarepakete eigens installiert werden. Sie formulieren in Ihrer SPARQL Anfrage, was für eine Darstellung Sie wünschen.

Einen sehr schönen Überblick über Visualisierungen gibt das Scholia Projekt auf der Wikidata Plattform.

Was mache ich, wenn ich ganz eigene Datendarstellungen auf meiner eigenen Plattform realisieren will?

Das sollte technisch kein Problem sein. Uwe Jung demonstrierte, wie eine Benutzeroberfläche der FH Potsdam Wikidata als Datenrepositorium benutzt, ohne dass die Benutzer mitbekommen, auf welche Repositorien die Abfragen zugreifen.

Nichts spricht dagegen, das FactGrid als ein externes Repositorium zu benutzen und das eigene Forschungsprojekt auf dem Server der Heimat-Uni aufzubauen und dort die Benutzer mit gezielten Datenbankzugriffen unter einer typischen Suchschablone zu bedienen.

Das FactGrid lizenziert Daten grundsätzlich CC0 – heißt das nicht, dass ich alle Rechte an meiner Forschung aufgebe?

Positiv gesprochen bedeutet die Entscheidung für die Creative-Commons-0-Lizenz, dass Sie die vollen Rechte an allen (Ihren) Daten behalten. Vor allem aber bedeutet die CC0-Lizenz, dass Ihre Daten frei nutzbar werden und damit weniger Gefahr laufen, als Forschung obsolet zu werden.

Einige grundsätzliche Erwägungen dazu: CC BY 4.0 ist auf den ersten Blick die Lizenz, die Wissenschaftlern näher liegt: Man gestattet die freie weitere Nutzung, wenn man dafür fachgerecht zitiert wird. In der Praxis lässt sich diese Lizenz bei Textveröffentlichungen (wie diesem Blogbeitrag) noch gut durchsetzen. Hier ist es klar, wie man den Text, den man verfasste, und Thesen, die man bahnbrechend formulierte, zitiert sehen möchte: Mit einem Verweis auf den eigenen Namen, mit dem Titel der Publikation, dem Publikationsort und dem Datum. Wie aber soll das Datenzitat (etwa die Information, dass ein Brief im Juni 1753 von Paris nach Berlin ging) innerhalb einer Visualisierung erfolgen, auf Strichen, die auf einer Landkarte erscheinen? Wie sollen Benutzer Datensätze zitieren, wenn diese nur zum Teil Informationen aus Ihrem Forschungsprojekt enthalten, zum größeren Teil jedoch andere Datenbankinformationen etwa aus einer öffentlichen Archivdatenbank bieten, die Sie einspielten? Noch größere Probleme stellen sich bei Daten mit Lizenzen, die eine “share-alike” Klausel bergen: “Diese Daten sind frei verfügbar, wenn die Nachnutzer sie genauso frei verfügbar halten.” Das klingt erst einmal nach nachdrücklicher freier Nutzung. Wie aber soll ein Nachnutzer sicherstellen, dass wiederum seine Nachnutzer sich an die von Ihnen gewünschte Lizenzvereinbarung halten (insbesondere, wenn dieser Nachnutzer auf CC0 geht)? Nachnutzer sind gut beraten, keine Daten aus CC-BY oder CC Share-Alike Lizenzen zu verwenden.

In der Praxis der größeren Kooperationen mit Wikidata und der Deutschen Nationalbibliothek kann es darum nur eine Option geben: Genauso frei Daten zur Verfügung zu stellen, wie die Kooperationspartner diese tun: CC0, das heißt ohne, dass sichergestellt wird, dass Nachnutzer noch exakt angeben, wer die Daten einzeln erhob, und was Drittnutzer wiederum mit diesen Daten tun dürfen.

 
Die maximal offene Lizenz heißt in der Praxis durchaus nicht, dass FactGrid Daten Daten ohne Autorschaft sind, ganz im Gegenteil. Wir legen es nahe, Forschung als Forschung zitierbar zu machen und gehen davon aus, dass Wikidata und die GND Zitiervoschläge gerne übernehmen. Alle Datensatzänderungen werden von der Software für alle Nutzer sichtbar an bei uns Real-namentlich gebunden. Haben Forschungsprojekte substanzieller an einem Datensatz gearbeitet, vermerken Sie dies jederzeit mit einer eigenen Notiz Ihrer Arbeit im Datensatz. Jeder kann die Datenbank danach befragen, welche Datensätze im Rahmen eines bestimmten Projektes bearbeitet wurden.

Tatsächlich ist es für Datenbanken wie Wikidata oder die Gemeinsame Normdatenbank der DNB, die GND, ungemein interessant, Daten aus dem FactGrid als dort erstmals publizierte zitieren zu können – es steigert die eigene Datensolidität, wenn sich Forschung benennen lässt und es gibt beiden Institutionen eine Plattform auf der möglich wird, was auf der eigenen Plattform ausgeschlossen bleibt.

Was geschieht, wenn ich mit meinen Daten auf einer anderen Plattform weiterarbeiten will?

Da Sie Ihre Daten ohne Copyright-Aufgabe einpflegten, können Sie sie in beliebig vielen anderen Projekten parallel laufen lassen. Wir sind hier gerne “nur” ein “Inkubator” für Forschungsdaten.

Was passiert, wenn es zwischen FactGrid-Benutzern zum Streit über ein “korrektes” Datum kommt?

Die Software lässt es zu, einander widersprechende Daten zu handhaben – das ist gerade im Feld der Geschichtswissenschaften interessant, wo wir oft dokumentarisch belegte divergierende Informationen haben, ohne noch ermessen zu können, welches die korrekte Aussage ist. Namen werden in verschiedenen Schreibungen gehandhabt; Geschichtsschreiber widersprechen einander.

Die Software erlaubt es, die widersprüchliche Lage abzubilden; sie erlaubt es, Objekte mit Dutzenden Namensschreibweisen zu belegen – es sind nur verschiedene Schreibweisen zu ein und derselben Q-Nummer.

Divergierende Aussagen lassen sich unterschiedlich einstufen – etwa als das derzeit autoritative Datum gegenüber Varianten, für die allein die verschiedenen einander widersprechenden Quellen sprechen.

Sollten zwei Forscher zu unterschiedlichen Befunden kommen, so ist das letztlich der Fall, auf den es jedes Projekt anlegen sollte. Das viel größere Risiko ist die hypothetische Entscheidung, die Sie in Ihrem Projekt treffen, während ein Projekt auf einer anderen Plattform das Rätsel löst und mit dem belastbaren Datum weiterarbeitet, ohne dass Sie davon auch nur erfahren, geschweige denn die Korrektur Jahre nach Ihrer Projektlaufzeit noch einpflegen können.

Warum sollte ich in meinem Projekt Transparenz schon von Anfang an riskieren?

Das dürfte die härteste Frage sein, die Projekte im Moment davon abhält, sich der eröffneten Ressource bereits zu bedienen. Die Alternative ist die Ressource, die bis zum Publikationstermin gegen Projektende nur unter Passwörtern dem Team zugänglich ist. Kein Konkurrenzprojekt kann Ihnen in der verdeckten Arbeit an Ihrer Plattform Befunde wegschnappen, so die Theorie. Auch sieht niemand, wo Sie erst einmal Fehler machten, die Sie erst im Verlauf korrigierten. Niemand erfasst, was Hilfskräfte eingaben und was dagegen Sie als Projektleiter verantworten – so die Vorteile des intransparenten Arbeitens auf einer Plattform, die erst am Projektende online geht und die keinen Blick in die Versionsgeschichten der Datensätze zulässt geschweige denn in die tägliche Projektarbeit.

Die transparente Forschung, zu der das FactGrid einlädt, bietet indes ganz eigene Sicherheiten: Wenn Sie bahnbrechend ein bestimmtes Dokument auffinden und einen bestimmten Zusammenhang herstellen, dann ist der Editiervorgang, mit dem Sie den Datensatz mit Aussagen bestücken, Aussage um Aussage datiert und jeweils mit Ihrem Namen verbunden. Macht morgen jemand im selben Archiv dieselbe Entdeckung, werden Sie im FactGrid nachweisbar und fälschungssicher notiert haben, dass Sie den Zusammenhang schon einen Tag zuvor öffentlich zugänglich machten.

Die kollektive Plattform spricht im selben Moment die Einladung zur Kooperation aus. Machen Sie anderen Teams klar, woran Sie arbeiten und erlauben Sie noch auf Ihrer Plattform die Kontaktaufnahme mit Ihnen!

Die Risiken des vermeintlich sicheren und erst am Ende der Projektzeit online gehenden Internetauftritts sind gravierend: Die Zeit für einen Austausch mit den Nutzern ist mit der finalen Publikation abgelaufen. Der Internetauftritt erfolgt in den letzten Wochen Ihres Projektes, währen alle anderen letzten Arbeiten laufen und für konzeptionelle Änderungen kein Raum mehr bleibt. Ist überhaupt kein Digital Humanities-Part in der Forschung einkalkuliert, so bleibt unklar, was mit den Daten noch geschehen soll, die Mitspieler in Word-Dateien, Excel-Listen oder eigenen Softwarelösungen ganz für sich sammelten – sie noch irgendwo einzupflegen, hat niemand mehr die Kraft. Man kann nur noch hoffen, dass Leser der abschließenden Buchpublikation in dieser alle Fußnoten auf Korrekturen hin durchkämmen, die im öffentlichen Informationsstand nötig werden und diese dann in allen Bibliothekskatalogen und in den verschiedenen Wikipedia-Projekten durchführen. Das Risiko sind hier Bücher, die an der kollektiven Datengrundlage vorbeigehen und DH-Projekte, die nach ihrer Publikation mangels weiterer Pflege in wenigen Monaten veralten.

Die Zukunft sollte darin liegen, dass wir die Datenlage, derer wir uns selbst in der Forschung bedienen, eigenverantwortlich bearbeiten können. Um dies wiederum ohne Gefahr der Aufgabe wichtiger Befunde tun zu können, müssen wir es Forschern erlauben, ihre Forschungsleistung transparent und zitierbar sichtbar zu machen. Hierfür ist Wikibase besser als jeder andere Software ausgerüstet.

Wie nutze ich das FactGrid konkret?

Das FactGrid hat keine unsichtbare Tiefenschicht. Jeder kann die Datenbank befragen und die Abfragen bieten dabei eingeloggten Benutzern dieselben Antworten wie fremden. Alle Datensätze sind in allen Versionsstufen öffentlich präsent. Der eigene Benutzeraccount bietet beim puren Auslesen von Daten nur den Vorteil, dass Nutzer nun die Software auf die eigene Sprache umstellen können.

Wer eigene Daten einspeisen und mit ihnen auf der Plattform arbeiten will, benötigt dagegen einen Account. Diese werden unter Klarnamen von den Administratoren vergeben. Die Software bietet ein Link zur Account-Anforderung. Wir vergeben ansonsten Accounts auf (Email) Anfrage. Projektleiter erhalten administrative Zugänge, mit denen sie selbst Benutzerkonten vergeben können.

Einmal eingeloggt kann man sowohl Daten in Massen eingeben wie an beliebiger Stelle Datenkorrekturen vornehmen. Alle Eingaben werden an den Benutzer-Account gebunden, der sie tätigt, und können von jedem anderen zurückgenommen werden, was wiederum als exakt diese Rücknahme namentlich dokumentiert und mit einem Zeitstempel versehen wird – für eingeloggte und nicht eingeloggte Benutzer gleichermaßen sichtbar.

Wer an einem komplexeren Projekt arbeiten will —

  • das kann die persönliche Familienforschung sein,
  • das kann eine einzelne Visualisierung im Rahmen einer Seminararbeit sein,
  • das kann genauso gut eine Eingabe von Tausenden von Datensätzen in einem auf mehrere Jahre laufenden Forschungsprojekt mit mehreren Mitarbeitern sein

— ist gut beraten, noch bei der Account-Eröffnung den Austausch mit der Plattform zu suchen. Eine Kooperationsvereinbarung kann dem eigenen Projekt Rückhalt gegenüber Geldgebern geben; doch kann auch einfach nur ein Blogbeitrag mit einer Projekteröffnung interessant sein. In jedem Fall sollten andere auf der Plattform von Ihnen wissen. Spannend wird die kollektiven Datenbank, wo man die Vorarbeiten anderer nutzt und Mitspieler aus anderen Projekten anregt, gute Modelle zu übernehmen. Nötig ist die Abstimmung nicht; praktisch aber trägt sie zur Verbreitung der eigenen Arbeit bei – zu Suchanfragen, die man selbst so schnell nicht zu formulieren weiß, zu Visualisierungen, an die man nicht dachte, zu Hilfe, wo man sie benötigt.

Die Software verspricht eine neugierige Nutzung im breiten Netz und dieses Netz sollte man mit Forschung ansprechen.

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).
Jack Kirby, “The Fourth Dimension is a many splattered thing!” from Alarming Tales, 1 (September 1957).

2018-11-16/17: Wikibase/Illuminatenorden Data-Mining Workshop: 10 Reisestipendien nach Gotha zu vergeben

[Google translation of this page]

Das Forschungszentrum Gotha veranstaltet jährlich einen „Illuminatenworkshop“ mit dem Ziel, aktuelle Forschung zum Geheimorden der 1770er und 1780er Jahre zu bündeln.

Nachdem wir dieses Jahr in einer Kooperation mit Wikimedia Deutschland gut 5.000 komplexere Sätze von Metadaten zu den Akten des Illuminatenordens in einer Wikibase-Instanz verfügbar machten, möchten wir mit diesem Aufruf Wikidata-Enthusiasten einladen, gemeinsam mit Forschenden einen ersten Blick in diesen Datenschatz hinein zu wagen.

  1. Welche Visualisierungen (Netzwerke, Timelines, geographischen Erfassungen…) lassen sich aus dem Datenmaterial ziehen?
  2. Wie müsste man die Daten strukturieren, um noch ganz andere Forschungsfragen anzugehen?
  3. Wie lässt sich das dieses Datenmaterial am besten mit Volltext-Transkripten von Dokumenten verknüpfen?
  4. Wie kann unser bisheriges konventionelles Wiki – die Gotha Illuminati-Research Base – aus der Datenbank Information beziehen?
  5. Wie modellieren wir Datenobjekte auf einem Kurs, der Informations-Redundanzen vermeidet?
  6. Wie würde man Daten eingeben, um Zeitschnitte (und Repräsentationen auf alten Landkarten) zu bewerkstelligen?
  7. Wie gelingt es uns, unsere Reasonator-Integration klug in Richtung eines mehrsprachigen, Übersichtlichkeit generierenden Informationsangebots zu nutzen?
  8. Wie machen wir unsere Arbeit optimal im Wikidata-Universum nutzbar?

Unser diesjähriger Workshop soll Datenanalyse und Forschung zusammenbringen. Mitspieler, die sich mit SPARQL Datenbankabfragen und Visualisierungen auskennen, wollen wir einladen, mit der Forschung ins Gespräch zu kommen. Wir haben die Daten, die Datenbank und detailliertes Wissen über die die Aktenlage des Illuminatenordens mit seinen gut 1350 Mitgliedern und Tausenden von internen Dokumenten, um das Data-Mining spannend machen –, aber erfassen im Moment kaum, welche Aufschlüsse uns unser eigenes Material in der ganz neuen technischen Erschließung gibt. Wir verfügen über Erfahrung mit unserem bisherigen Arbeitsinstrument, einem konventionellen Wiki, aber erfassen im Moment gerade in Ansätzen, was uns das komplexere Medium der Wikidata-Technologie an hinzukommenden Optionen der praktischen Arbeit liefert.

Wer am wissenschaftlichen Programm im ganzen Umfang teilnehmen will, kann am Freitag den 16. November 2018 ab 9:00 am Forschungszentrum Gotha in unsere Forschungsdiskussionen Einblick nehmen.

Der Data-Mining-Workshop, dem die vorliegende Einladung speziell gilt, wird am Nachmittag Forschende und Wikidata-Kenner zusammenbringen. Die Veranstaltungen werden im Verlauf des Nachmittags getrennt in einen Wikibase Bastel-Workshop und in die Serie der spezifischeren Fachreferate.

Ein gemeinsames Abendessen ist für 19:00 angesetzt. Das Forschungszentrum steht Bastelwütigen indes danach noch die ganze Nacht offen.

Am zweiten Workshop-Tag wollen wir gegen 11:00 die Gruppen wieder zusammenführen, um voneinander zu lernen:

  • Was können Forschende aus der Datenbank gewinnen?
  • Was wünschten sich Datenbankenthusiasten an Forschungsarbeit, um im Data-Mining wesentlich tiefer einsteigen zu können?
  • Wie würde man ein größeres Aktenerschließungsprojekt mit dieser Datenbank am besten organisieren?

Wir können Reisekosten (unter der sich entwickelnden Etatlage sicher aus dem deutschsprachigen Raum), Unterbringung und Tagegelder übernehmen. Teilnahmewünsche sind mit eingehenderen Aussagen zu Arbeitsinteressen bis zum 5. November 2018 zu richten an olaf.simons@piere-marteau.com.


Erste Suchen und Visualisierungen zur Anregung

Sample queries: https://database.factgrid.de/wiki/Sample_queries

2018-06-11/12: Daten in das FactGrid füllen — praktischer Workshop der Gothaer Forschungsstelle Illuminatenforschung

Liebe Erfurter und Gothaer FactGrid Interessierte,

in den letzten Wochen arbeiteten wir im engeren Kreis an der Einrichtung einer WikiBase-Instanz (der Software hinter dem Wikidata-Projekt) auf dem Server der Uni Erfurt: https://database.factgrid.de/

Es gab einige technische Schwierigkeiten bei der Anpassung der Tools an die neue Server-Umgebung zu bewältigen, doch sind wir seit einigen Tagen soweit, dass die Grundausstattung läuft: QuickStatements steht für den massenweisen Datenimport zur Verfügung. Der Query Service läuft, so dass wir SPARQL-Abfragen von Daten hinkriegen. Das Design (Logo etc.) ist noch offen – was im Moment den Vorteil hat, dass alles wie bei Wikidata aussieht. Matti Blume arbeitet daran, die Datensätze des Illuminatenprojektes für den Projektstart in die Datenbank zu füllen.

Vom Montag den 11. auf Dienstag den 12. Juni 2018 wollen wir gemeinsam mit Matti Blume und Sandra Müllrick am Forschungszentrum Gotha einen Workshop veranstalten, auf dem er praktischen Unterricht in der Befüllung der Datenbank erteilen wird:

  • Wie verändert man einzelne Daten?
  • Wie fügt man über QuickStatements Datenmassen in die Datenbank ein? (Auf dieser Seite ein paar Tutorials: https://factgrid-tools.geschichte.uni-halle.de/blog/archives/811)
  • Wie legt man dazu Properties (Eigenschaften) für Items an?
  • Wie organisieren wir unsere Properties am besten (von dem weit größeren Wikidata-Projekt lernend)?

Projekte, die am Forschungszentrum Gotha und an der Uni-Erfurt im Feld Geschichte und den benachbarten Kulturwissenschaften Datenbankleistung suchen, sind eingeladen, hier praktische Einblicke zu gewinnen. Hilfskräfte, die uns beim Betreuen der Ressource in Zukunft zur Verfügung stehen wollen (und Interesse an den Digital Humanities für die eigene spätere Arbeit haben) betrifft dieselbe Einladung.

Wir werden am Montag einleitend die Software vorstellen und im Austausch mit den Anwesenden ausloten, zu welchen Projekten sie sich eignet. In einem zweiten Arbeitsblock wird es darum gehen, vorbereitete Daten in die Datenbank zu füllen und die Arbeit zu überprüfen. Das wird im Wesentlichen auch das Programm für Dienstag sein, nun mit dem Ziel, Unabhängigkeit bei der Arbeit mit der Datenbank zu gewinnen. Die Uhrzeit für den Beginn der Veranstaltung Montag-Vormittag/Mittag wird im Vorfeld bekannt gegeben.

Die Weitergabe dieser Post an Datenbank-Interessierte ist ausdrücklich erwünscht. Für Voranmeldungen bis zum Mittwoch, den 6. Juni wären wir dankbar, auch für persönliche Notizen zur Hardware: Die Software lässt sich vom Laptop (über Eduroam) bedienen. Wir wollen zusehen, dass wir Computerarbeitsplätze im Forschungszentrum für die Teilnehmer frei halten.

Mit den besten Grüßen,
Olaf Simons

[per e-mail distribuiert]

Zeitplan

Montag, 11. Juni, Pagenhaus des FZG, Seminarraum

(13:15 – 13:40) Olaf Simons: Begrüßung. Kurze Projektgeschichte, eingehenderer Blick auf die Datenblättern aus dem Illuminatenprojekt, die das erste Unterrichtsmaterial geben werden.

(13:45 – 14:15) Sandra Müllrick: Eine kurze Vorstellung von Wikidata und der Wikibase Software. Die Datenbank, die Benutzer editieren können. Versionsgeschichte, Transparenz aller Editiervorgänge über Recent Changes. Triples als Statements. Abfragen über SPARQL, mehrsprachige Datenblätter im Reasonator. Was kann eine Datenbank, was ein reguläres Wiki (wie wir es im Illuminatenprojekt hatten) nicht kann?

(14:25 – 14:45) Praxisteil 1: Wie geht man strategisch vor, wenn man Tabellen aus einem Forschungsprojekt vor sich hat und diese in eine Wikibase Datenbank überführen will? Wie legt man Properties an? Wie behält man Überblick über schon existierende Properties? Wie geht man strategisch vor, wenn man einen solchen Datenberg einarbeiten will?

(15:00 bis zum Erschöpfungsbeginn) Praxisteil 2: Koordinierter Versuch, möglichst viel unserer Daten über QuickStatements in das System zu bringen. Wenn man Tabellenspalten in massenweise Triples überführt – wie legt man die Items an, wie die Properties? (Tutorials unter anderem hier: https://factgrid-tools.geschichte.uni-halle.de/blog/archives/811). Aufgaben für Einzelne oder Zweiergruppen.

Gemeinsames Abendessen

Dienstag, 12. Juni, Pagenhaus des FZG, Seminarraum, respektive Hauptgebäude, Besprechungsraum

(9:00 – 10:30, FZG Hauptgebäude, Besprechungsraum) Planungstreffen: Sandra Müllrick Mitglieder des Forschungszentrums und der Forschungsbibliothek. Projektpläne. Welche Entwicklungen können wir aus eigenen Mitteln finanzieren – wo brauchen wir (etwa bei der Suche von Werkvertragsnehmern) Hilfe von Wikimedia, respektive der Community? Welche Entwicklungen würde Wikimedia gerne anstoßen?

(Parallell 9:00 – 11:00) Praxisteil 3: Fortsetzung von angefangenen Eingaben und individuelle Beratung, insbesondere falls Mitspieler eigene Datensätze in die Datenbank bringen möchten.

(11:15 – 12:00) Praxisteil 4: Wo befinden sich die eingegebenen Daten nun? Was kann man mit ihnen bereits machen? Vielleicht finden wir einige interessante SPARQL-Abfragen.

(12:30 – 13:00) Resümee: Ideen, Desiderate, Pläne.


Google Spreadsheets and Illuminati Project Data

Dataset Google Spreadsheet Content What could be visualised? Web Form to build
Documents produced in the Illuminati Order Mostly Schwedenkiste, Illuminati materials from various archives and those documents that were already published in the late 1780s Network information. Caution: We are operating with fragmented and highly selective data. Describe an archival document
Illuminati members and others A list of the c. 1350 members of the order (including names belonging into the wider context), mostly research (stated in col. AJ) by Hermann Schüttler (2016). — The geographical spread of the Order on the central European map: col. AB to be matched with col. AG
— Already existing Wikidata and GND data sets linked in cols. M and N.
— Age structure of the members col. AC
— Percentage of aristocracy cols. J-L
Write a CV
The order had a complex grade system that created careers within the order, people could also get into different official positions Give information about an Illuminati career
Illuminati Events Mostly protocols of gatherings of “Minerval Churches” under Bode’s supervision. (Missing: Hermann Schüttler’s information about gatherings of the “Minerval Church” in Frankfurt/Main) Give information about a session (as type of an event)
Organisations
Publications  from: Forschungsliteratur

Bildnachweis

2018-04-23/25, Antwerp — the first Federated-Wikibase-Workshop

Thanks to the initiative of Andra Waagmeester and Daniel Mietchen (who are part of the community that is behind Wikidata incorporating such staggering inputs as the complete human genome) we ventured a first workshop of projects that have begun to use the Wikibase software outside the original Wikimedia/Wikidata environment. The event at Antwerp’s fifteenth-century hospice, now the Elzenveld hotel and conference centre, was generously funded by the European Research Council. The participants came from fields which only this software would bring together: the natural sciences, the humanities, the social and political sphere and Wikimedia. Wikidata, the Wikimedia project in the centre, is about to become the broadest compound in the world of collaboratively produced knowledge. Starting with interconnecting the 290 Wikipedias all around the globe it became able to switch between all their respective languages. Knowing all the equivalents of articles as well as all the unique items which individual communities created on their Wikipedias Wikidata is closer than any comparable compound to theoretically knowing what a father, a cat, a religion or a novel structurally is. The multilingual competence is matched only by the database’s openness to all sorts of items: Wikidata is dealing with bacteria, the Mona Lisa, Chinese politicians, obscure philosophical concepts, mathematical equations, individual genes, geo-coordinates, and all sorts of properties and qualities these items can gain. The software is open to the flexible creation of ever new properties interconnecting the bricks. You can read Wikidata on the Reasonator and you can explore Wikidata with machines. It is open to logic, accessible in ever new SPARQL queries – the search language worth learning.

Why federating specialised Wikibase platforms will be a win/win situation for Wikidata and the emerging sister projects

Wikidata has overtaken the individual Wikipedias as a project attracting masses of specialised data. Anyone can contribute. The input can be done by machines – so why not the complete human genome? It is at the same moment no longer clear whether Wikidata is the ideal place to host such infusions. Should Wikidata risk the input of all the astronomical objects that have been referenced – of billions of stars creating usually little more than a number and the information of the original observation? This is not only a question of the software’s technical abilities; it is far more a question of the communities needed in order to keep the data easily accessible and up to date.

The alternative is the environment of interacting, more or less specialised platforms that use the same software and that exchange data wherever that is of interest. The win/win situation will have more than one dimension:

  • Wikidata is saved from a flood of information which no Wikidata community can offer to keep attractive.
  • The individual platforms can establish their own workflows and professionalised user rights managements.
  • Wikidata would function more as the bridge between various databases, referring to knowledge elsewhere – a uniquely attractive position.
  • The individual platforms would win visibility and sustainability in the compound – with Wikidata as the central supplier and distributor of information used all around the globe.

A wikibase compound to interconnect the emerging community

The workshop was immensely practical. The central product was not a mission statement of a future collaboration with tight pledges and attempts to institutionalise the emerging field. We were far more eager to discuss software problems, development plans, and to share practical experiences.

The two Wikimedia software developers, Adam Shorland and Raz Shuty, entered a sportive hunt for the stream of “tickets” that emerged in the various debates which Wikimedia’s Sandra Müllrick helped to organise in ever new groups.

Instead of the mission statement we created a further Wikibase instance with the primary aim to map all the projects that have begun to use the software. A retrospective timeline came gratis with the register:

Desirables

It was apparent that we had all been facing technical problems. Some of the projects found their own solutions, others tried to engage Wikimedia as the software’s mother. It was clear that we will all learn from each other and we should aim to make the practical know how we are individually gathering accessible to future projects.

Wikimedia’s Wikibase software is more versatile than any other comparable database software on the market: it is prepared to deal with a constant flux of concepts and specifically designed to adapt to open growth but it is not yet addressing “normal” users, users who are not primarily interested in the technical solutions they are getting here. The SPARQL query is a brilliant key to mine information, yet it is not a language a coincidental Google visitor or a professor of history organising his team will be immediately able and ready to use. Projects will face a need to develop conventional interfaces that will then secretly speak SPARQL in its further dealings with the database.

We will face similar needs to develop web forms which regular users can handle to contribute their knowledge.

Wikimedia – this was the encouraging signal Sandra Müllerick, Adam Shorland, and Raz Shuty were giving as a formidable team of problem solvers – is interested in the increased use of its new product. New projects are encouraged to test the software and if that is of use to them: to become platforms in a far wider compound of projects that can do what Wikidata should not aim to do.

Projects creating the new compound should at the same moment embrace the chance to meet, to learn from each other, and to exchange data. Any data exchange will create new perspectives on their respective fields, it will inspire new tools, it will promote their work in the growing environment of data driven research. The Wikibase software will become common over the next decade.

Our conference was a first meeting and an attempt to look across the borders of our respective fields. We decided to stabilise this exchange; a follow up meeting with probably more participants in New York is in the pipeline.

Details & Links

The Participants

  1. Susanna Ånäs (Finnish Name project; Open Knowledge Finland)
  2. Diego Chialva (Policy Analyst, European Research Council Executive Agency)
  3. Davy Cielen (Data Scientist, Contractor at the European Research Council Executive Agency)
  4. Rajaram Kaliyaperumal (LUMC, Leiden The netherlands)
  5. Lozana Mehandzhiyska London (South Bank University & Rhizome)
  6. Daniel Mietchen (Data Science Institute, University of Virginia)
  7. Lyndsey Moulds (Rhizome)
  8. Alexis-Michel Mugabushaka (Policy Analyst, European Research Council Executive Agency)
  9. Sandra Müllrick (Wikimedia Germany)
  10. Nuno Nunes (Maastricht University, Maastricht)
  11. Adam Shorland (Wikimedia Germany)
  12. Raz Shuty (Wikimedia Germany)
  13. Olaf Simons (Gotha Research Centre of the University of Erfurt)
  14. Greg Stupp (Scripps Research Institute)
  15. Elena Toma (Policy Analyst, European Research Council Executive Agency)
  16. Andra Waagmeester (micelio)

Presentations

Links

The (sobering) status report of Friday 13, April 2018

[A version of this was originally posted here]

[Postscript Friday 4, May 2018: SPARQL is on, we are in the middle of our first more massiv data input]

Four months have passed since the kick-off workshop shop, and the FactGrid project has run into its first unexpected problems. We are confident that we will solve the – primarily technical – issues, but one of the lessons we have learned so far is that we will need the support of a larger community in order to situate the FactGrid Project with more impact in the Wikidata-community.

What do we want to achieve? We are still trying to launch a Wikibase installation with the aim to offer a platform for original research. Data hosted on the FactGrid will be free to be used by Wikidata. Data will leave the FactGrid database, however, with the personal authorisations of research which Wikidata is not be able to generate.

Digital humanities projects interested to work on the collective FactGrid platform will sponsor software developments with their respective DH-funding. The cooperation with Wikimedia should make sure that tools sponsored by us will become part of the wider Wikibase software package. We want to prevent island solutions.

What kinds of problems have we been facing? And where do we need you?

Problem 1: The software is free but the vital tools do not work outside the Wikidata environment.

Wikibase is – relatively – easy to install, but the central tools you need in order to get data into and out of the database – QuickStatements and SPARQL – proved to be hard wired to the original Wikidata compound. Lucas Werkmeister has managed to free Quick-Statements from these ties. SPARQL remains on his agenda. We have no idea how tools that use SPARQL (in order to create visualisations for instance) will work once we have the independent SPARQL version. The software problems have blasted our entire schedule.

Problem 2: Getting the first sets of data into the FactGrid.

We have four larger spread sheets of data from the Gotha Illuminati project which we want to use in order to create an attractive show case.

  1. Google Spreadsheet: The Illuminati Files
  2. Google Spreadsheet: The Illuminati and others
  3. Google Spreadsheet: Some first Organisations
  4. Google Spreadsheet: Events referred to in the Illuminati Files

Our data sets are intriguing and able to attract a wider public interest without further advertisement. They should create steam for the engine if we manage to convinced all the parties involved (Freemason, Berlin State Archive, Gotha Reasearch Centre and the Wikimedia Community) to risk a crowd sourced identification of the roughly 6,000 digitised documents which we have been gathering over the last four years. We have underestimated, however, the problems an empty database (a database without any properties and any primary items) is causing.

If you feel cool with QuickStatements and if you think an empty wikibase installation is just the free space you have been dreaming of, join the team and help us to learn how we can use our data with the brilliant software.

Problem 3: We will need a more massive Wikidata and/or GND input.

We will need our own landscape of information ready to be improved if we want to attract other projects of historical research and regular internet users (with wider a genealogical project for instance). A strategist is here needed, someone with ideas how we could (for instance) acquire all the names of people with birth dates between 1400 and 1800 from Wkidata and/or the GND for our database. (To keep the database clean we might focus on basic data like names, birth dates, places of birth and death, and family connections). Wikibase fans who feel you could organise such an import, feel inspired! We would offer you all the freedom of the experiment you would ask for.

Problem 4: We will need something like forms which users can fill in in order to create standardised CVs with the Wikibase software.

Adrian Heine has taken the first steps into this project. Our aim is a Wikibase environment which normal people can correspond with like they have been corresponding with the Wikipedia software so far. You pick a person of your interest and you get a questionnaire with modules (on places and addresses that the respective person has lived, on employments he or she has been in, on the person’s genealogy, on personal contacts we can prove). Wikibase is presently not exactly ready to be edited by normal people.

Problem 5 (a project for the future): Wikibase needs something like a standard Wikibase-Interpreter

Magnus Manske’s Reasonator has been the cool thing on all my presentations of the Wikibase software in DH-circles. You can pick your language and you get an organised data sheet.

Things get difficult if you want to correct or augment the Reasonator’s information sheet; and things get even more difficult if you want to run the Reasonator on your own platform. The development of an immediate interface that produces smooth pages of structured information will be necessary in order to motivate people to gather information for Wikidata (or any affiliate). The Wikibase-Interpreter would be ready to offer the complete knowledge on any field of interest. It would be ready to list all the places a person is known to have visited, all the contacts he or she is known to have had – whether face to face or through letters. Think of the thousands of contacts of the Leibniz’ correspondence – a problem to be solved with pages that give an overview and “more” on the user’s particular request. The Reasonator is, so far not reading Wikidata directly, nor is it part of the Wikimedia software development. Wikidata will need its own Interpreter in order to become an independent source of information – an independent source that also serves all the Wikipedias around the Globe.

We need to change the way we are organising all this

We have been able to offer a couple of grants in 2017 in order to get the project going. We should be able to use the further funding of DH-projects interested in the software and the collaborative platform to inspire if not to fully finance future tools. DH-projects will, however, only risk a cooperation with the FactGrid project and with Wikimedia as the software and data-partner if we manage to offer an attractive show case of what can be done. The Illuminati files are an immensely cool project to begin with. The global interest in these files is huge, everyone has heard of the Illuminati and here you get their most secret files. Visualisations of networks and of the geographical spread of the secret order will find a good test case here. If we should be able to inspire a crowd sourced annotation of all the known documents – that would stir up a global press attention.

We are, however, far from the show case which we could present anywhere at this moment.

2017-12-1/2: Erster FactGrid Workshop in Berlin: Ergebnisse

Das Treffen begann mit wechselseitigen Vorstellungen von Wikidata und dem Illuminatenprojekt (mehr zu Wikidata hier, mehr zum Projekt die Illuminatenakten online zu bringen: hier), eine Etherpad Seite dokumentiert, was an Links in der Runde durchgegangen wurde.

Hier die wichtigsten Überlegungen und Ergebnisse:

1| Das FactGrid muss vorbefüllt werden, insbesondere mit bibliographischer Information

In einer Demonstration korrigierten wir das Todesdatum zu August Bohse (Q760965). Die Korrektur selbst war einfach, die Quellenangabe jedoch umständlich und unbefriedigend: Das Bearbeitungsfeld akzeptiert entweder eine URL (hier hätte man das Google Books-Link angeben können) oder ein bereits bestehendes Wikidata Objekt mit seiner Q-Nummer. Das Datenbank-Objekt zu generieren, war mühselig. Das Ergebnis war zudem ohne viel weiteren Nutzen: Man wird das zitierte Buch so nicht in zukünftigen Buchrecherchen wiederfinden. Bibliothekskataloge nehmen Titel weit komplexer auf, ohne dass man Benutzern diese komplexen Eingaben indes zumuten will.

Das Fazit aus dieser Demonstration war: Wir benötigen im FactGrid eine Vorabfüllung, so dass Forschende hier bereits bestehende Objekte in Beziehung miteinander setzen. Das FactGrid sollte bereits eine breite Basis an

  1. Wikidata-Objekten
  2. GND-Objekten
  3. Bibliographischer Information (namentlich der Nationalkatalogen für die frühe Neuzeit: VD16-VD18, ESTC, STCN aufweisen

Man wird erstens nachdenken müssen, wie man für die historische Datenbank auswählt (das menschliche Genom, das in Wikidata vollständig sequenziert erfasst ist, ist uninteressant, auch will man eher unglückliche Informationsangebote aus der neuen Datenbank heraushalten – man benötigt jedoch etwa zu Personen Grunddaten, um sie eindeutig identifizieren zu können). Man wird zweitens nachdenken müssen, wie man bei der Zusammenführung von Wikidata und GND-Informationen mit Doubletten umgeht.

2| Benötigt: Schicke (spielerische) Werkzeuge zur Ausmerzung von Doubletten

Das Problem taucht beim Anlegen bruchstückhafter Datensätze wieder auf – etwa wenn man aus einem Besucherbuch Namen abschreibt, von denen man nur weiß, dass sie zu einem genannten Zeitpunkt am genannten Ort sich so auswiesen.

Die Lösung wird ein Tool sein, dass Wahrscheinlichkeiten misst. Wie wahrscheinlich ist es, dass zwei Personen selben Namens am selben Tag und in der selben Stadt geboren wurden – und dann etwa auch noch das Sterbedatum und den Sterbeort teilen. Vermutlich kann man bei einer Zusammenführung von Daten automatische von Doubletten riskieren, wenn man dabei die statistische Wahrscheinlichkeit der Identität greifbar macht.

Attraktiv wäre ein Tool, das erwägt, wer wer sein könnte: Bei wem liegt die tentative Information im Bereich der Lebensspanne? Wer ist dagegen auszuschließen, da er an diesem Tag ein Alibi hat? Man kann dann massenweise aus Kirchenbüchern Namen und Daten notieren, Objekte anlegen und später das System nach Vorschlägen der Identifikation befragen.

3| Forschungsprojekten in der Ressource Raum bieten, die eigene Arbeit zu präsentieren

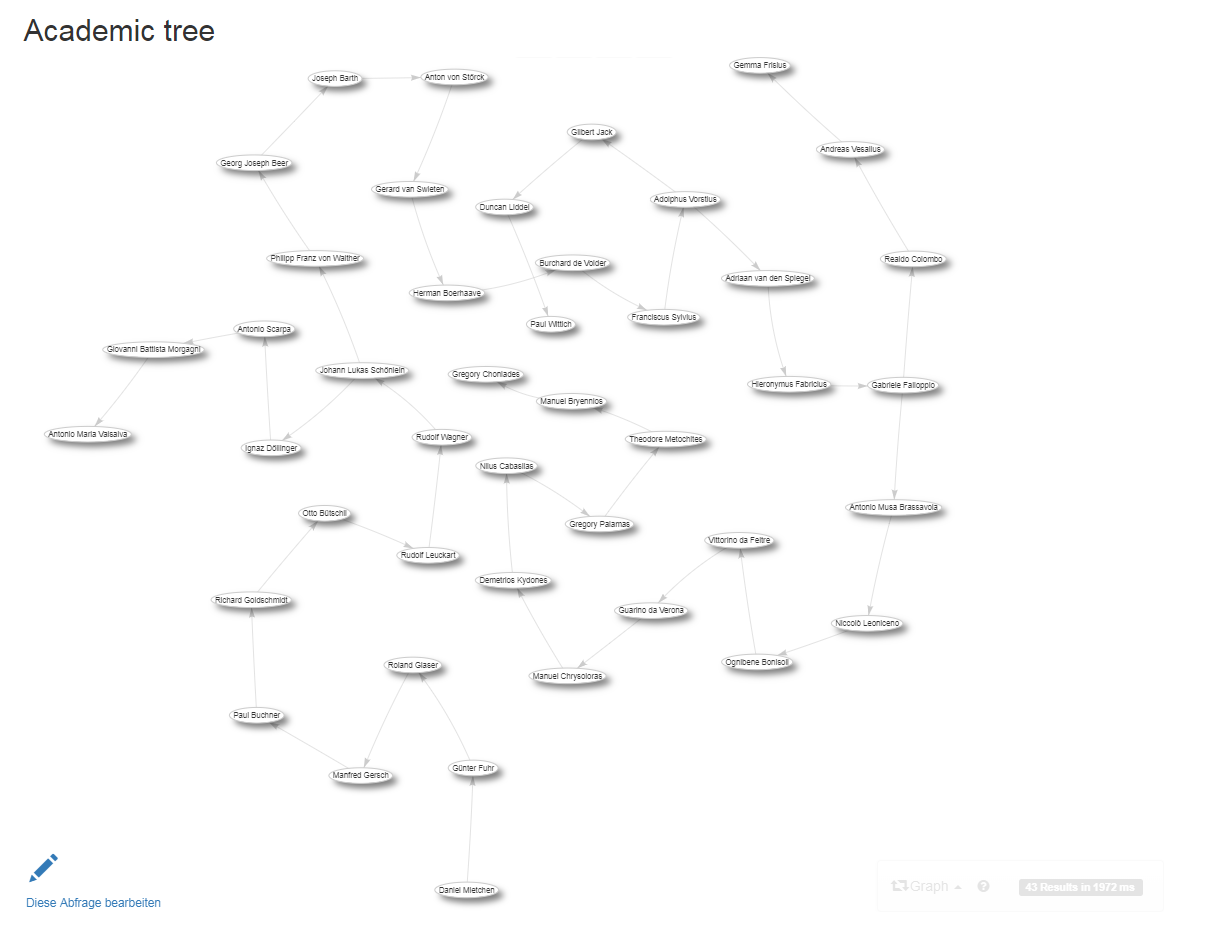
Demonstrationen verschiedener Tools machten klar, dass es bereits wunderbare Anwendungen gibt, die den Rang ganzer wissenschaftlicher Projekte haben könnten. Daniel Mietchen zeigte die Genealogie seiner Doktorväter bis um 1500 zurück:

Screenshot from https://tools.wmflabs.org/scholia/author/Q20895785 / enlarge

Die Entwicklungsrichtung, für die wir uns nach den Demonstrationen entschieden, ist es, vorwiegend mit der Datenbank zu arbeiten und Projekten dabei die Chance selektiver Präsentationen zu geben. Wir werden dafür eine Art Tagging einführen, mit dem Projekte Dokumente und Personen oder (Zeit–)räume ihres Interesses ausmachen können, um dann spezifische Suchangebote innerhalb eines abgesteckten Geländes machen zu können.

4| SQID und Reasonator

Die Entscheidung das „Illuminatenwiki“ langfristig aufzulösen, fiel insbesondere im Blick auf den Reasonator und SQID: Hier die Vergleichsseiten zu Johann Sebastian Bach in den Wikidata-Präsentationen durch beide beide Tools.

Beide Tools lassen sich parallel anbieten und werden einen ähnlichen Entwicklungsbedarf aufwerfen. Beim Umgang mit Dokumenten hätten wir gerne die Scans, Transkripte und Übersetzungen auf denselben Seiten. Eine typische Seite zu einer Quelle ist aus der Gotha Illuminati Research Base diese zu Schwedenkiste Band 13, Dokument SK13-070.

Elegant wäre, es zweispaltig Digitalisate neben Transkriptionen setzen zu können (und die Software für das Editieren zu öffnen). Elegant wäre es, wenn Benutzer zudem hier Übersetzungen anfertigen könnten.

5| Der FactGrid Quellen-Nachweis

Ausgiebig diskutierten wir das Schema des FactGrid Quellennachweises, wie es sich hier als Diskussionsvorschlag findet: Faktenbelege, die “Original Research” zulassen.

Prinzipiell sollte dieses Schema es Forschern erlauben, Befunde erstmals im FactGrid zu präsentieren und dabei selbst Arbeitshypothesen als solche handhaben zu können. Das Ziel ist nicht die Ressource, die ausschließlich mit solider Information bestückt wird, sondern ein Forschungshilfsmittel, das man etwa mit Personenlisten aus Dokumenten befüllen kann, um später zu sehen, welche Aussagen sich dazu machen lassen.

5| CC0 oder CC BY 4.0

Die Lizenz für das Factgrid sollte bislang CC BY 4.0 sein – jeder darf Informationen beliebig verwenden, muss sie aber wie verlangt zitieren. Das ist die wissenschaftliche Praxis, und das Zitat kann in diesem Fall nicht einfach „FactGrid“ lauten, es muss die Forscher nennen, die im FactGrid auf den Befund verwiesen.

Gegen die CC BY 4.0 spricht, dass sie bei einer Föderation mit Wikidata und dortiger CCo Lizenz ein Lizenzgefälle erzeugt, auch dass sich bei vielen Tools am Ende nicht das erwünschte Zitat mitliefern lassen wird: Wo sollen bei einer Visualisierung die Angaben zu den Forschern erscheinen? Fordert man sie ein, verhindert man die Visualisierungen.

Die pragmatische Alternative könnte lauten, dass wir uns auf CC0 einlassen, aber

  • eine best practice Information geben: Dort, wo einzelne Informationen etwa zu einem Todesdatum von uns zitiert werden, stellt ein eigenes Zitierlink zusammen, wie wir das Datum wissenschaftlich zitieren würden. Das ist gerade für uns selbst attraktiv: Wir können dann von hier aus in eigenen Artikeln Fußnoten beziehen.
  • mit Wikidata eine Vereinbarung treffen, wie wir dort Informationen unserer Arbeit zitiert sehen wollen
  • auf eine technische Lösung hinarbeiten, die es Benutzern in Wikipedia leicht macht, ganze Fußnoten zu Informationen von uns zu beziehen – bislang werden Todesdaten etwa regulär ohne Quellenangaben gehandhabt.

6| Die Daten der Schwedenkiste-Excel-Liste in Triple verwandeln

Wir gingen diese Liste spaltenweise durch. Es sollte kein Problem sein, die Tripel zu den gelisteten Dokumenten zu formulieren. Etwas Anpassungsarbeit wird nötig, um etwa nicht mehr vorhandene Dokumente zudem einzeln führen zu können. Die Schwedenkiste enthält Seiten jeweils mehreren Entwürfen von Briefen, die selbst nicht mehr überliefert, aber von hier aus einzeln rekonstruierbar sind.

Matti Blume und Olaf Simons wollen sich am 11.12. in Berlin für das Datenmodell und die Anpassung der Excel-Liste treffen.

7| Zeitschnitte

Spannend wäre es, wenn man im FactGrid historische Situationen darstellbar machen könnte. Der Artikel zu Gotha wird in diesem Fall nach gewünschtem Zeitraum zusammengestellt mit Informationen, die Zeitraum-gerecht arrangiert werden. Gotha hat um 1800 etwa 12.000 Einwohner, es gehört nicht zur BRD sondern ist Residenzstadt im Herzogtum Sachsen-Gotha-Altenburg und so fort.

Eine Website, die Zeitschnitte recherchierbar macht, wäre ein denkbares Objekt für einen coding Wettbewerb.

8| Barcamp Open Science, Coding Da Vinci, Hackathon

Vom Berliner Workshop ging die Anregung aus, einen nächsten Workshop im Frühjahr – vielleicht Anfang März zu veranstalten und dabei absolvierte Arbeitsschritte zu besprechen. Unser Ziel sollte es im selben Moment sein, von hier aus Projekte für coding-events zu formulieren:

9| Koordination

2017-12-1/2: Einige konkrete Fragen für den ersten FactGrid Workshop

siehe https://factgrid-tools.geschichte.uni-halle.de/blog/archives/159

  1. Wäre es sinnvoll, das FactGrid vorab mit ausgewählten (auf Kerndaten reduzierten) Datensätzen aus Wikdata und der GND zu befüllen, um nicht im leeren Raum zu beginnen?
  2. Gäbe es alternativ eine einfache Option, Daten mit den bestehenden Datenbanken abzugleichen und Datensätze ohne Umstände zu übernehmen?
  3. Könnte man den Umgang mit Doubletten – verschiedenen Datensätzen zur selben Person etwa (resultierend aus der Zusammenfügung von Tatenmengen) – nicht zu einem fruchtbaren Problem machen, sprich: die Datenbank einsetzen, um gezielt nach möglichen Übereinstimmungen zu fahnden?
  4. Wie würde man am besten mit ‘tentativen Informationen’ umgehen – mit Personen etwa, von denen man erstmal nur einen Nachnamen, einen Zeitpunkt und Ort in einem ersten Aktenbefund hat? (Siehe das erste und das zweite Kopfzerbrechen hierzu.)
  5. Wäre es nicht klug, Bilddateien und Transkripte in derselben Datenbank zu verwalten? (Siehe das fünfte Kopfzerbrechen.)
  6. Wie gehen wir mit wechselseitigen Beziehungen um? Wenn eine Schablone es erlaubt, zu einer Person Eltern und Kinder zu nennen, wie stellen wir sicher, dass Schablonen zu Kindern wiederum die bereits eröffneten Beziehungen zu den Eltern in den Eingabefeldern haben?
  7. Wenn wir Gegenstände und Eigenschaften definieren, werden wir dafür eigene (sagen wir) X- und Y-Nummern vergeben, um Freiheit bei der Erweiterung und Ausbeutung der Datenlage zu haben? Wenn ja: Wie sichern wir die weitestmögliche Vereinbarkeit mit Wikidata-Einträgen ab?
  8. Magnus Manskes Reasonator erweist sich als ungemein elegantes Werkzeug, um Wikidata-Information enzyklopädisch verfügbar zu machen. Taugt der “article placeholder” als Alternative, wenn wir eine Vermehrung von Plattformen verhindern wollen und wenn wir eine automatische und übersichtliche Datenpräsentation suchen. Braucht Wikidata nicht langfristig einen eigenen “Visualizer”, der die Informationen zu jedem Gegenstand zweckmäßig anordnet und erst beim Editierwunsch in den Bearbeitungsmodus schaltet?
  9. Das FactGrid soll verschiedenen Projekten als gemeinsam betriebene und angereicherte Plattform dienen. Wie machen wir es möglich, dass das jedes einzelne Projekt die Ressource unter seinem eigenen Focus ausbeuten kann? Wie ermöglichen wir Suchen, die etwa speziell im Aktenbestand bleiben, der vorher als die thematisch relevante Datenlage eines Projekts definiert wurde?

2017-12-1/2: Erster FactGrid Workshop in den Räumen der Wikimedia Deutschland, Berlin: Planungsseite

Veranstaltungsort: Tempelhofer Ufer 23-24, 10963 Berlin
Zeit: Freitag, 1.12.2017, 13:00-18:00 und Samstag 2.12.2017, 9:00-13:00
Kartenansicht: https://www.openstreetmap.org/node/2551527703#map=18/52.49841/13.38068

Vom 1. auf den 2. Dezember 2017 veranstalten das Forschungszentrum Gotha und, gastgebend, Wikimedia Deutschland einen ersten gemeinsamen Workshop des FactGrid-Projektes in den Berliner Räumen der WMDE Geschäftsstelle.

Unser Ziel ist es, Wikidata-Entwickler, Wikidata-Begeisterte und Wissenschaftler, die die Software im FactGrid-Projekt in der Forschung zum Einsatz bringen wollen, zu einem ersten größeren Ideenaustausch zusammenzubringen.

  • Was würden (Geistes-)Wissenschaftler mit einer solchen Datenbanksoftware in Forschungsprojekten gerne bewerkstelligen können?
  • Was kann die Software bereits heute?
  • Was müsste man entwickeln?
  • Was sind Entwicklungen, die ohnehin von Wikimedia geplant sind?
  • Mit welchen gemeinsamen Projekten kann die Wikidata/Wikipedia-Community für eine Plattform gewonnen werden, die sich gezielt der “original research” im Geflecht der Wikimedia-Projekte anbieten soll?
  • Inwieweit kann das FactGrid Projekt bestehende Datenressourcen (Wikidata, GND, Sammlungen bibliographischer Daten etc.) konstruktiv nutzen?
  • Wie werden sich FactGrid-Daten in Wikidata nutzen lassen?

An der Software interessierte (Geistes-)Wissenschaftler sollen in den zwei Tagen die Gelegenheit finden, Akteure des Wikidata- und Wikipedia-Feldes näher kennenzulernen und Kontakte zu knüpfen für gemeinsame Projekte – und für Aufträge auf Werkvertragsbasis im anspruchsvolleren Fall, in dem die gemeinsame Software komplexere Aufgaben bewerkstelligen soll.

Generell Interessierte aus dem größeren Wikipedia Bereich sind herzlich eingeladen, mit uns darüber nachzudenken, welchen Raum ein von Wissenschaftlern initiiertes Projekte im größeren Feld der Wikimedia-Projekte gewinnen könnte.

Die eingehenderen Veranstaltungsinformationen werden hier und auf einer parallelen Wikimedia-Seite/Anmeldungen laufend aktualisiert.

Kontaktadressen:
Nicola Zeuner, nicola.zeuner@wikimedia.de
Olaf Simons, olaf.simons@pierre-marteau.com

Ablauf

    Freitag Nachmittag: Kennenlernen

  • Zugverbindung ab Gotha 8:35/ Erfurt 8:58, Berlin Hbf. 11:00
  • Eintreffen/ Mittagessen WAU Hallesches Ufer 32, 10963 Berlin bis 12:45
  • 13:00: Wikimedia Geschäftstelle. Wikidata Vorstellung: Was tut Wikidata im Zusammenspiel mit den Wikipedien? Was sollte man über die Software wissen? Was kann man mit der Software machen? Was wird mit ihr gemacht?
  • Im Lauf des Nachmittags: Projekte der verschiedenen Interessenten. Was für Daten steuern sie bei? Was für Interessen an Datenbankanwendungen haben sie?
  • Gemeinsames Abendessen in der Taverna Athene, Tempelhofer Ufer 12, 10963 Berlin.
  • Samstag Vormittag: Baustellen

  • Nachdenken über ersten vier Werkverträge: Datenimport (hier das Datenangebot des Illuminatenprojekts zur “Schwedenkiste”), Wiki-Integration, Eingabeschablonen, Know-How-Transfer: Hierzu eingehend die Blogposts zu Eingabeschablonen und und zum Ausweis von Original Research sowie die Serie Kopfzerbrechen.
  • Was lässt sich mit der bestehenden Software bereits sehr leicht realisieren?
  • Was müsste erst entwickelt werden? Wo liegen gemeinsame Interessen der Forscher und des Wikidata Teams?
  • Wer kann was? Wie gewinnen Forschungsprojekte Kontakte in die Wikidata Community zu Entwicklern, zu Know-How-Vermittlern, zu Interessierten aus der Wikipedia/Wikidata-Community, die bei bestimmten Forschungsprojekten durchaus gerne mitspielen würden
  • Gemeinsames Mittagessen in der Geschäftsstselle

Eine grundsätzliche Fragesammlung zur Inspiration gibt es auch hier.

Angekündigte Teilnehmer

  1. Lydia Pintscher, Wikimedia Deutschland
  2. Nicola Zeuner, Wikimedia Deutschland
  3. Jens Ohlig, Wikimedia Deutschland
  4. Matti Blume, Wikidata, Werkvertrag in der ersten Projektstufe
  5. Adrian Heine, Wikidata, Werkvertrag in der ersten Projektstufe
  6. Daniel Mietchen, Wikidata, Werkvertrag in der ersten Projektstufe
  7. Lucas Werkmeister, Wikidata, Werkvertrag in der ersten Projektstufe
  8. Olaf Simons, Forschungszentrum Gotha
  9. Markus Meumann, Forschungszentrum Gotha
  10. Erik Liebscher, Forschungszentrum Gotha
  11. Christian Wirkner, Forschungszentrum Gotha
  12. Hendrikje Carius, Forschungsbibliothek Gotha
  13. Daniel Burckhardt, Humboldt Universität, Berlin
  14. ChristianKl, Wikidata Community
Großer Raum der Wikimedia Geschäftsstelle – sieht heute anders aus, Christina Burger auf https://commons.wikimedia.org/wiki/File:Bierkiste_in_neuer_GS.jpg

Memorandum of Understanding zwischen der Universität Erfurt und Wikimedia Deutschland

Mit den Unterschriften vom 8.8. und 23.8.2017 kam die folgende Kooperationsvereinbarung zwischen der Universität Erfurt und Wikimedia Deutschland zustande. Das gemeinsame Memorandum of Understanding umreißt die Projektziele und mag hier zugänglich gemacht sein, um allen Beteiligten, die etwa auf der Basis von Werksverträgen einander begegnen, die institutionelle Rückendeckung zu geben.

Nachfolgend der Text der Vereinbarung:


Memorandum of Understanding

zwischen

Wikimedia Deutschland – Gesellschaft zur Förderung Freien Wissens e.V.
Tempelhofer Ufer 23-24
10963 Berlin

vertreten durch Abraham Taherivand
im Folgenden: WMDE

und

Universität Erfurt
Nordhäuser Straße 63
99089 Erfurt

vertreten durch den Präsidenten, Herrn Prof. Dr. Walter Bauer-Wabnegg

ausführende Einrichtung:
Forschungszentrum Gotha der Universität Erfurt
Schloss Friedenstein
99867 Gotha

im Folgenden: FZG

Präambel

WMDE ist ein gemeinnütziger Verein mit Sitz in Berlin. Zu seinen satzungsgemäßen Aufgaben zählt es unter anderem, die Verbreitung Freier Inhalte (engl. Open Content) in selbstloser Tätigkeit zu fördern, um die Chancengleichheit beim Zugang zu Wissen zu fördern. WMDE ist Teil einer globalen Bewegung für Freies Wissen und ein Partner der Wikimedia Foundation (San Francisco, USA). WMDE fördert, unterstützt und beteiligt sich an Projekten, Programmen und Vorhaben, die den gemeinnützigen satzungsgemäßen Zielen des Vereins zugutekommen.

Im Rahmen des Vereinszwecks ist WMDE daran interessiert, Open-Science-Initiativen zu unterstützen und zu verbreiten. WMDE unterstützt u.a. das Wikimedia-Projekt Wikidata, eine offene Wissensdatenbank für strukturierte Daten, die von Menschen und Maschinen gelesen und editiert werden kann. Bislang fungiert Wikidata in erster Linie als zentrale Wissensdatenbank für die Wikimedia-Projekte, wird aber zunehmend von anderen Anwendern aus dem Kultur, Bildungs- und Wissenschaftsbereich genutzt. Wikidatas Inhalte sind unter freier Lizenz zugänglich, mit Standardformaten exportierbar und können mit anderen offenen Datensätzen verlinkt werden.

Das Forschungszentrum Gotha, eine zentrale wissenschaftliche Einrichtung der Universität Erfurt, beschäftigt sich im Wesentlichen mit der Wissensgeschichte der Neuzeit. Es betreibt seine Forschungen in enger institutioneller und thematischer Anbindung an die im Schloss Friedenstein beheimateten historischen Sammlungen der Forschungsbibliothek Gotha und der Stiftung Schloss Friedenstein mit ihren Schwerpunkten in der frühen Neuzeit und im 19. und 20. Jahrhundert – hier ist insbesondere das Archiv des Perthes-Verlags mit seinen einzigartigen Beständen an Landkarten aus dem 19. und 20. Jahrhundert zu nennen. Das FZG organisiert ein internationales Stipendienprogramm und ist mit Konferenzen und Programmen für Gastwissenschaftler sowie dem Angebot von Arbeitsstätten für drittmittelgeförderte Forschungsprojekte ein Ort internationaler, vor allem historischer Forschung.

Die nachfolgenden Vereinbarungen betreffen das organisatorisch und inhaltlich am FZG sowie in der technischen Betreuung am Rechenzentrum der Universität Erfurt beheimatete FactGrid-Projekt. Mit ihm soll die von Wikidata genutzte Software (Wikibase) Einsatz in der Forschung finden. Praktisch wird sich das Projekt dabei vordringlich darauf ausrichten, die Arbeit der Gotha Illuminati Research Base (einem konventionellen Wiki unter der URL https://projekte.uni-erfurt.de/illuminaten/) rationeller zu gestalten.

Das langfristige Ziel ist es, wissenschaftlichen Projekten, die am FZG angesiedelt sind oder von diesem in Kooperation mit anderen wissenschaftlichen Institutionen betrieben werden, im FactGrid kollektiv Datenbankleistungen zur Verfügung zu stellen und dabei einen Informationsaustausch mit dem Wikidata-Projekt aufzubauen.

Dies vorangestellt, treffen WMDE und das FZG folgende Absichtserklärung:

§ 1          Gemeinsame Vision

Wikibase, die für Wikidata genutzte Software, soll sich zu einem funktionsfähigen Instrument für Wissenschaftler und wissenschaftliche Projekte entwickeln, mit dem in eigenen Installationen Daten offen und kollaborativ geteilt werden können.

§ 2          Gemeinsame Entwicklungsziele

Die folgenden Entwicklungsziele zeichnen sich dadurch aus, dass sie einen ersten möglichen Weg zur oben genannten Vision aufzeigen. Beide Partner wollen – im Rahmen ihrer Ressourcen und Möglichkeiten – auf diese vorläufigen Ziele hinstreben. Ziele sind nicht verbindlich und werden sich im Laufe der Partnerschaft verändern und angepasst werden.

Zum gegenwärtigen Zeitpunkt benennen die Partner die folgenden gemeinsamen Entwicklungsziele:

  1. Die Erarbeitung eines tragfähigen Konzepts zum Einsatz der Wikibase-Software in wissenschaftlichen Projekten
    1. als Datenbankunterstützung konventioneller Wikis, die in Tabellen, Listen und Suchanfragen zum Einsatz kommt;
    2. als Datenbankunterstützung, die auch Forschungsprojekten mit anderen Software-Voraussetzungen Dienste (etwa beim Erstellen von Tabellen, Bewegungsprofilen auf Landkarten, Netzwerkansichten oder genealogischen Stammbäumen) zur Verfügung stellt.
  2. Die Identifizierung von Möglichkeiten zur Erstellung eines Query Service / einer Automated List Generation, die dann in der Gotha Illuminati Research Base Informationen einspielen kann.
  3. Die Einrichtung komplexerer Quellenbelege, die im FactGrid “Original Research” zulassen und Informationen persönlich an die koppeln, die sie einstellten. Die Diskussion von Befunden muss an derselben Stelle möglich sein.
  4. Die Erarbeitung einer Importmöglichkeit, die Forschungsprojekte in die Lage versetzt, Daten aus Tabellen in das FactGrid einzuspielen.
  5. Die Erarbeitung eines Werkzeugkastens, der Forschungsprojekte befähigt, modulare Eingabemasken zu bauen.
  6. Die Einrichtung eines Informationsflusses aus dem FactGrid in Wikidata (bei dem sichergestellt wird, dass Informationen mitsamt den Angaben der Forschung in Wikidata verfügbar werden).
  7. Eine größere Kooperation zwischen dem FZG, WMDE und den an dieser Stelle einzubeziehenden weiteren Institutionen, mit dem Ziel, den Aktenbestand der “Schwedenkiste” öffentlich zugänglich zu machen und wissenschaftlich unterstützt im Crowd-Sourcing zu erschließen.
  8. Die Einführung von Wissenschaftlern in den Umgang mit der neuen Technik mit dem Ziel, hier eine selbständig arbeitende Community zu generieren.

§ 3          Aktivitäten

Zusammenarbeit

Das FZG übernimmt über die Ausschreibung von projektgebundenen Werkverträgen die Finanzierung von Software-Implementierungen und unterstützende Einführungen in die Arbeit mit der Wissensdatenbank im Rahmen der Budgets, die für technische Entwicklungen und Dienstleistungen zur Verfügung stehen.

Da die Arbeit mit der Wikibase-Software zum gegenwärtigen Zeitpunkt (anders als die Arbeit mit regulären Wikis) ohne breitere öffentlich verfügbare Erfahrung geschehen muss, wird WMDE bei der Suche nach geeigneten Auftragnehmern für die Werkverträge unterstützend tätig sein.

Darüber hinaus begleiten Mitarbeiter aus der WMDE-Softwareentwicklung im Rahmen der jeweils gegebenen personellen und finanziellen Ressourcen die Arbeit an den obigen Zielen durch Beratung.

Grundsätzlich ist beiden Partnern dieser Vereinbarung daran gelegen, dass Softwarelösungen und praktische Erfahrungen, die in der Kooperation zustande kommen, im größeren Interesse des Wikidata-Projektes gesucht werden. Ein wesentliches Projektziel ist es, Insellösungen (i.S. einer speziellen Softwarelösung für die Universität Erfurt) zu vermeiden. Die Kooperation soll vielmehr die gemeinsam benutzte und weiterentwickelte Software für breitere Anwendungen attraktiver machen und bewerben.

Kommunikation

WMDE und das FZG benennen einander je einen Ansprechpartner für alle im Rahmen der Zusammenarbeit abzustimmenden Angelegenheiten. Beide sorgen dafür, dass sie sich regelmäßig gegenseitig über Vorhaben und Projekte in den gemeinsamen Arbeitsbereichen informieren.

WMDE und FZG nutzen die ihnen zur Verfügung stehenden Kommunikationskanäle, um die Öffentlichkeit und ihre Communities über gemeinsame Aktivitäten zu informieren. Kommunikation nach außen, welche gemeinsame Vorhaben betrifft, wird vor Veröffentlichung immer zwischen beiden Vertragspartnern abgestimmt.

Für die Außenkommunikation räumen sich WMDE und FZG wechselseitig das nicht-exklusive, zeitlich auf die Laufzeit dieser Vereinbarung begrenzte und nur mit Einverständnis nicht übertragbare Recht ein, die von der jeweils anderen Partei zur Verfügung gestellten Logos-, Namens-, Bild- oder Markenrechte zum Zwecke der Durchführung der vorliegenden gemeinsamen Ziele zu nutzen; dies gilt nur, soweit dies rechtlich zulässig ist und keine Rechte Dritter entgegenstehen. Die für die vereinbarten Zwecke benötigten Materialien, Abbildungen etc. werden kostenfrei von der jeweiligen Partei zur Verfügung gestellt. WMDE und FZG verpflichten sich, die graphischen Gestaltungsvorgaben des jeweils anderen zu erfüllen. Die Verwendung der Logos-, Namens-, Bild- oder Markenrechte von WMDE bedarf stets der Einhaltung des WMDE/WMF-Style-Guides sowie der vorherigen Freigabe durch die Kommunikationsabteilung von WMDE; gleiches gilt analog für die Verwendung der Logos, Namens-, Bild- oder Markenrechte des FZG. Die durch die Zusammenarbeit neu entstehenden Materialien (inkl. Bilder) sind unter freie Lizenzen zu stellen (bevorzugt CC BY-SA 4.0 bzw. CC 0 im Bezug auf Wikidata).

§ 4          Dauer

Diese Vereinbarung tritt mit ihrer Unterzeichnung in Kraft. Sie gilt zunächst für 12 Monate und kann jederzeit unter Einhaltung einer Frist von 30 Tagen einseitig gekündigt oder im beiderseitigen Einvernehmen vorzeitig beendet werden.

§ 5          Sonstiges

Durch diese Vereinbarung entstehen WMDE und FZG keine finanziellen oder vertraglichen Verpflichtungen. Sowohl WMDE als auch FZG stellen jeweils die auf ihrer Seite notwendigen Personal- und Sachleistungen zur Verfügung und tragen die ihnen dadurch entstehenden Kosten selbst. Wechselseitige Schadensersatzansprüche sind ausgeschlossen. Bei Ansprüchen Dritter haftet der Verursachende allein und ausschließlich. Für den Fall,  dass Dienstleistungen oder Gelder ausgetauscht werden, gemeinsam Drittmittel verwaltet werden, oder konkrete Projekte umgesetzt werden, wird eine formelle Kooperationsvereinbarung notwendig.

Für Wikimedia Deutschland               Für das Forschungszentrum Gotha

Berlin, 23.8.2017                                      Erfurt, 8|8|17
Abraham Taherivand                             Prof. Dr. Walter Bauer-Wabnegg