Ein Best-Practice-Szenario für die Erschließung historischer Wissens- und Gebrauchsliteratur als Open Data

In Wikiversity erstveröffentlichter Wikimedia-Wettbewerbsbeitrag

Projektbeschreibung

Das Wissen über die Welt und den menschlichen Umgang mit dieser, über praktische Fähigkeiten und theoretische Erkenntnisse, wurden über Jahrhunderte in Handschriften gesammelt und verfügbar gemacht. Die ältesten deutschen Wissens- und Gebrauchstexte stammen noch aus Althochdeutscher Zeit (8. – 11. Jahrhundert) und besonders in Frühneuhochdeutscher Zeit (ca. 1350¬1650), wächst die Anzahl der Texte und Themengebiete rapide. Immer neue Wissensbereiche wurden in deutscher Sprache erschlossen und ein Großteil der spätmittelalterlichen deutschen Handschriften enthält Wissens- und Gebrauchstexte. Dennoch stehen diese Texte nicht im Zentrum germanistischer Forschung und sind – auch aufgrund ihrer Diversität und Komplexität – wesentlich schlechter erschlossen als literarische Texte. In meiner Forschung versuche ich diese Wissenslücke zu schließen und bislang vernachlässigte Textsorten, wie etwa Losbücher, Kalender, Geomantien, Textamulette, Tintenrezepte oder Anleitungen zur Dämonenbeschwörung (auch hier, hier und hier) so zu erschließen, dass sie von Fachkollegen, aber auch einem größeren Publikum, aufgefunden, gelesen und verstanden werden können. Dies soll auch dazu dienen die Überlieferung dieser Texte und damit die geographische wir soziale Verbreitung historischer Wissensbestände nachvollziehbar zu machen. Ein großes Problem ist dabei die mangelnde Referenzierbarkeit der Texte, die aufgrund ihrer Form (bspw. Rezepte) oder ihre Unbekanntheit keine etablierten Titel haben, in den einschlägigen Fachlexika (Verfasserlexikon) nicht erfasst sind und auch innerhalb der Forschungsliteratur unterschiedlich bezeichnet werden. Im digitalen Umgang mit diesen Texten verstärkt sich dieses Problem, da handschriftlich überlieferte deutsche Texte überhaupt nur in Ausnahmefällen über Normdaten oder andere Linked-Open-Data-Formate erschlossen sind.

Im Rahmen des Fellow-Programm Freies Wissen soll ein Best-Practice-Szenario für die Erschließung historischer Wissens- und Gebrauchsliteratur als Open Data entwickelt werden. Dieses schließt an bisherige Arbeiten zu den Losbüchern und Chiromantien sowie der laufenden Katalogisierung der illustrierten mantischen Prognostiken für den Katalog der deutschsprachigen illustrierten Handschriften an und soll die deutschsprachigen mantischen Texte des Spätmittelalters einem breiteren Publikum erschließen und Forschungsdaten nachnutzbar machen. Dazu ist eine Kombination aus Open-Access-Forschungsbeiträgen, der Überarbeitung von Wikipedia-Artikeln, der Veröffentlichung von Handschriftenabbildungen (im Archive und in Wikimedia Commons) sowie der Generierung von offen zugänglichen Erschließungsdaten vorgesehen. Dabei sollen Erschließungsdaten zu deutschsprachigen Wissens- und Gebrauchstexten des 14. bis 16. Jahrhunderts erstmals in der FactGrid-Datenbank und damit auf einer Wikibase-Instanz erfasst werden. Über die FactGrid-Datenbank sollen nicht nur einzelne Texte dauerhaft und eindeutig identifizierbar gemacht, sondern auch verschiedene digitale (Handschriftendatenbanken, Bibliothekskataloge, Handschriftendigitalisate) und analoge (Forschungsliteratur) Angebote vernetzt werden, sodass Informationen zu einzelnen Texten zentral auffindbar sind. Gleichzeitig ermöglicht die Erfassung von Textereignissen einzelner Handschriften und Werken in FactGrid auch eine maschinelle Auswertung und Visualisierung dieser Daten.

Im Projektzeitraum der Fellow-Programm steht vor allem die Aufbereitung der bereits erschlossenen Daten zu den Losbüchern und Chiromantien für das FactGrid-Repository und die Entwicklung von Arbeitsroutinen zu Integration der Daten im Vordergrund. Über Vorträge, unter anderem im Netzwerk Historische Wissens und Gebrauchsliteratur soll das Projekt während dieser Zeit bekannt gemacht und mit einem Beitrag in der Open-Access-Zeitschrift „Mittelalter. Interdisziplinäre Forschung und Rezeptionsgeschichte“ vorläufig abgeschlossen werden.

Meilensteine

  1. Entwicklung eines Modells der Datenstruktur für die Einträge in FactGrid
  2. Entwicklung eines Routine zur Aufbereitung und Intergration der Daten
  3. Intergration der Daten zu den Chiromantien [student. Hilfskraft]
  4. Intergration der Daten der Dissertation (Das Losbuch. Manuskriptologie einer Textsorte des 14.-16. Jahrhundert. 2018) [student. Hilfskraft]
  5. Zeitschriftenbeitrag zur Überlieferung der deutschsprachigen Chiromantien bis ca. 1520
  6. Überarbeitung des Wikipedia-Artikels ‘Chiromantie’
  7. Zeitschrftenbeitrag über Projekt

Zwischenbericht Oktober/November 2020

Die Monate Oktober und November dienten vor allem zur organisatorischen Vorbereitung der Forschungsarbeit:

1. Personal:

Zunächst war unklar, ob und auf welche Wiese eine studentische Hilfskraft eingestellt werden kann. Dies ist nun über den Lehrstuhl für Ältere Deutsche Literatur der RWTH Aachen möglich. Der Abschluss eines Arbeitsvertrags ist aber erst dann sinnvoll, wenn die gesamt Summe des Stipendiums ausgezahlt wurde. Ansonsten wäre die Laufzeit zu kurz.

2. Forschungscommunity:

Aus einer seit 2019 bestehenden losen Forschergruppe heraus, haben wir am 4.10.2020 den Verein Netzwerk Historische Wissens- und Gebrauchsliteratur] (HWGL) gegründet und ich habe dessen Vorsitz übernommen. Der Verein organisiert regelmäßig Netzwerktreffen, in denen auch die kollaborative Datenspeicherung abgesprochen wird. Es besteht bereits ein von mir betriebenes Wiki. Ob sich FactGrid als Erweiterung desselben eignet, soll in diesem Projekt erkundet werden.

3. Datenmodell/Workshop:

Das Datenmodell soll gleichzeitig praktikabel und theoretisch fundiert sein. Es muss daher mit der Forschungscomunity abgestimmt werden. Einen ersten Entwurf werde ich am 10.12.2020 auf dem 1. HWGL-Abendkolloquium vorstellen. Auf einem Workshop im Rahmen des (virtuelles) Netzwerktreffen Historische Wissens- und Gebrauchsliteratur (08.-11.01.2021) soll der praktische Umgang mit diesem erprobt werden. Ich bin auch an der Organisation beider Veranstaltungen beteiligt. Bei der Gestaltung des Datenmodells sind auch rechtliche Aspekte wichtig. Ursprünglich war ein Import der gesamten Datenbestände des Handschriftencensus angedacht. Dies ist aus rechtlichen Gründen (Unterschiede in der Lizensierung), jedoch nicht möglich. Ein Import von Daten scheint mir nur dann rechtlich zulässig, wenn das Datenmodell der FactGrid Datenbank sich wesentlich von dem des Handschriftencensus unterscheidet.

4. Thematisch relevante Publikationen:

    • Zu den Artikel ‘Sortes’ und ‘German Texts on Superstition’ des Handbuchs Prognostication in the Medieval World mussten noch die Fahnen korrigiert werden. Das Handbuch ist am 09.11.2020 erschienen.
    • Das Manuskript eines Beitrags zur Analyse von handschriftlich Überliefertem mittels Graph-Datenbanken, habe ich im September abgeschlossen. Dieser Beitrag hat Einfluss auf das Datenmodell in FactGrid, denn die dort entwickelten Analyseprozesse sollen auch mit den späteren FactGrid-Daten möglich sein. Der Artikel wird in der Zeitschrift für digitale Geisteswissenschaften erscheinen und wird derzeit redaktionell eingearbeitet.
    • Gemeinsam mit Björn Reich und Matthias Standke gebe ich einen Sammelband mit Editionen früher gedruckter Losbücher heraus. Die eingereichten Texte werden von uns redigiert. Die Erschließungsdaten der Losbücher, die ich hauptsächlich bereits in meiner Dissertation erfasst habe, werden einer der ersten Datenbestände sein, die in FactGrid importiert werden.
    • Die Erschließungsarbeit für den Katalog der deutschsprachigen illustrierten Handschriften der Bayerischen Akademie der Wissenschaften läuft weiter. Auch die Dabei gewonnenen Daten sollen in FactGrid importiert werden.

5. Wissenschaftskommunikation:

Meine Mentorin Anita Runge hat mich durch ihre Perspektive auf meine Forschung davon Überzeugt, dass deren Gegenstände und Ergebnisse auch für ein breiteres Publikum interessant sind. Ich versuche mich daher stärker im Bereich Wissenschaftskommunikation zu engagieren.

    • Bereits seit Anfang des Jahres läuft die Zusammenarbeit mit dem Germanischen Nationalmuseum in Nürnberg zur Ausstellung Zeichen der Zukunft. Wahrsagen in Ostasien und Europa, die eigentlich Anfang Dezember 2020 eröffnet werden sollte. Für den Katalog zur Ausstellung habe ich drei Artikel verfasst.
    • Im Januar werde ich für eine Folge des Podcasts Anno PunktPunktPunkt zum Thema Zukunftsprognostik im 15. Jahrhundert zwischen Aberglaube, Wissenschaft und Spiel. Zur Beziehung zwischen Diskurswandel und Medienwandel interviewt. Die Folge soll im Februar 2021 erscheinen.
    • An der Universität Salzburg werde ich am 13.1.2021 einen Gastvortrag zum Thema Kristallsehen. Praktiken und Erklärungsmodelle von der Antike bis heute halten.

Bild:

Konrad Bollstatter: ‘Complexiones-Würfelbuch’
Augsburg 1455
Schreiber: Konrad Bollstatter, Illustrationen: Werkstatt Johannes Bämler
München, Bayerische Staatsbibliothek, Cgm 312, fol. 51v-52r
(Bild: Bayerische Staatsbibliothek, Montage: Marco Heiles, Lizenz: CC BY-NC-SA 4.0)

Ausgangsüberlegungen

1| Ausgangslage

Für die Arbeit an der Gotha Illuminati Research Base benutzten wir in den letzten Jahren mit Erfolg ein ganz konventionelles Wiki. Das war besonders beim Materialmix von Vorteil, den wir zu verwalten haben:

Das Wiki bewährte sich, da es ohne Vorplanung entlang unserer Befunde wachsen konnte. Unsere Forschungsarbeit griff dank der praktischen Ressource auf die breite Materialbasis aus.

2| Unser Projekt geriet an technische Grenzen —

Metadaten zu einer typischen Archivalie wie sie gleichlautend parallel in mehreren Tabellen verwaltet werden müssen. Link in die Seite
  • da die Anzahl von Listen in ihm wuchs, die letztlich auf dieselben Fakten zugreifen. Ändert sich ein einzelner Befund, muss sichergestellt werden, dass alle Listen die neue Datenlage zeigen.
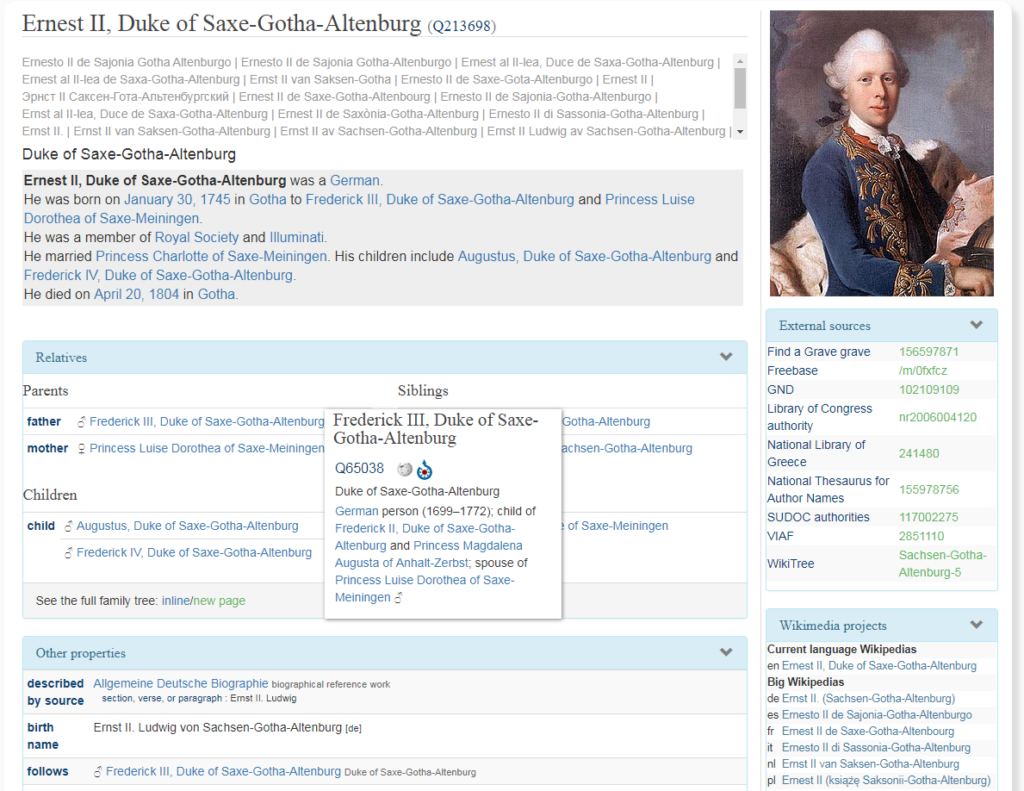
  • da uns bei den Biographien besser mit automatisch generierten CVs gedient wäre – mit gerne auch langen tabellarischen Listungen etwa aller Wohnsitze, aller Ausbildungsetappen, aller Arbeitsverhältnisse, aller Korrespondenzen und so fort. Die biographischen Seiten des Wikidata Reasonators sind hier weitgehend mustergültig. (Man würde sich eine klarere Strukturierung wünschen und bei mehr Einträgen eine Option der vollen Anzeige auf Wunsch – siehe die eigenen Gedanken zu Biographien und Eingabeschablonen in diesem Blog.)
  • da wir mit der bisherigen Verwaltung einzelner Seiten nicht in die Lage kommen, Informationen automatisch zu generieren und etwa zu Netzwerk-Analysen und Bewegungsprofilen auf Landkarten zusammenzuführen.
  • da wir gerne andere Projekte in dieselbe Ressource hineinarbeiten lassen würden, was vor allem im Feld der reinen Datenlage interessant wird.
  • da das Interesse an unserer Arbeit vor allem im anglophonen Ausland liegt, den wir aber nur mit einem erheblichen Arbeitsaufwand ansprechen könnten. Hier beeindruckte erneut der Reasonator bei Vorführungen in seiner Fähigkeit, die Sprachen zu wechseln.
Die automatisch generierte Seite zu Ernst II. von Sachsen-Gotha-Altenburg aus dem Wikidata Reasonator
https://tools.wmflabs.org/reasonator/?&q=213698

3| Wie die Wikidata Software einsetzen?

Die Wikidata Software dürfte die perfekte Problemlösung sein, da sie sich in derselben Problemstellung unter einem sehr viel breiteren Interesse entwickelte und verspricht, in Entwicklung zu bleiben.

Es schien uns nach der ersten Sondierung im Januar 2016 nicht ratsam, Wissenschaftler direkt in den von Wikimedia betreuten Wikidata-Pool hineinarbeiten zu lassen. Die Forschungsressource wird als Ort von “original research” manches anders handhaben, und gerade dass sie manches anders handhabt, wäre für Wikidata als Nutznießer einer Kooperation von Vorteil. Die Lösung wäre hier eine eigene, die Wikidata-Software benutzende Ressource – im Folgenden das FactGrid – die mit Wikidata eine Datenpartnerschaft einginge.

Zentrale technische Fragen sind dabei von Seiten des wissenschaftlichen Projektes:

  • Sollen wir unser bisheriges Wiki in dieser Datenbank aufgehen lassen, indem wir dessen ganze Materialvielfalt (siehe oben Punkt 1) in die Verwaltung der Datenbank überführen, oder würden wir das FactGrid besser ähnlich wie die verschiedensprachigen Wikipedia-Projekte nutzen, die gemeinsam aus Wikimedia Commons etwa Mediendateien beziehen – nun um Fakten zu verwalten?
  • Wie würden verschiedene Projekte in dieselbe Ressource hineinarbeiten und im jeweils eigenen Forschungsinteresse von ihr profitieren?
  • Wie gestaltet sich die Befüllung mit Daten in größeren Mengen (etwa aus Excel-Tabellen wie dieser zu den Akten der “Schwedenkiste“)? Wie generiert man Eingabeschablonen, um Fragekataloge abzuarbeiten? (Dies sind etwa die Optionen einer Mitgliedschaft im Illuminatenorden). Wie stimmen sich Projekte bei der Nutzung der gemeinsame Ressource ab?
  • Wie beziehen unabhängig voneinander arbeitende Projekte Daten in komplexeren Anwendungen aus der gemeinsamen Ressource (etwa um Netzwerke oder Bewegungsprofile einzelner Personen zu erstellen)?
  • Wie lassen sich komplexere Authentifizierungen von Forschungsbefunden bewerkstelligen? Diese müssen Aktenquellen zulassen und als Forschungsbefunde zitierbar werden. Wir brauchen dabei zudem Bewertung von Befunden durch die Forscher, um etwa “hypothetische” Aussagen zur weiteren Verifikation aussetzen zu können.
  • Wie würde sich ein kontrollierter Datenfluss aus dem FactGrid zu Wikidata organisieren lassen? (Sicherzustellen ist hierbei, dass Daten wie bei uns authentifiziert und bewertet bleiben.)

4| Eine Wikimedia Kooperation: Organisatorische Aspekte

Ein konstantes Ärgernis von Projekten der Digital Humanities ist bislang die Produktion von Insellösungen. Eine Software wird auf das einzelne Projekt zugeschnitten. Dessen Befunde enden mit der zunehmend antiquierten Plattform außerhalb einer weiteren Benutzung.

Das Ziel sollte die Investition in Tools sein (z.B. zur Visualiserung von Netzwerken oder Bewegungsprofilen auf Landkarten), die danach mit der breit verwendeten Software verfügbar werden. Forschungsgelder sollten in die Fortentwicklung bestehender Lösungen fließen, in neue Features, wo bislang immer neue Projekte dasselbe Rad für ihre Software neu erfinden.

Für eine Kooperation zwischen Projekten der Digital Humanities und Wikimedia kann Gotha derzeit günstige Ausgangsbedingungen anbieten: Wir verfügen mit der Gotha Illuminati Research Base über ein Startprojekt immensen öffentlichen Sex-Appeals, und das nun nicht mehr nach einer Struktur suchen muss. Im Kern liegen die Datensätze vor, mit denen Folgeprojekte an eine Feinerschließung aller Illuminatenakten gehen können.

Gleichzeitig können wir auf die nächsten fünf Jahre eine koordinierte weit größere integrative Arbeit mit dem Projekt „Gotha um 1800: Natur-Wissenschaft-Geschichte“ anbieten. Dieses Projekt wird unterschiedliche Institutionen zusammenbringen und sehr unterschiedliche Materialien in neue Zusammenhänge setzen: Informationen zu Wissenschaften um 1800, ortsbezogene Informationen zu einem deutschen Fürstentum, Informationen zu zahllosen Artefakten, Informationen zu Büchern und Zeitschriften aus dem Untersuchungszeitraum 1750 bis 1850, Informationen zu Personen und Personengeflechten, öffentlichen und geheimen Gesellschaften, ortsansässigen und korrespondierenden.

Mehrere Projekte am Forschungszentrum meldeten ihr Interesse an einer gemeinsamen Datenbanklösung an, falls wir eine solche angingen. Wir sind hier in der Lage, langfristig eine Community aufzubauen, die das nötige Know How intern verwalten kann, das regulär mit einzelnen Projekten nach deren Förderung verloren geht.

Eine Kooperationsvereinbarung mit Wikimedia sollte:

  • den Rahmen einer Betreuung abstecken, die die Wissenschaftler vor allem in der Anlaufphase benötigen, bevor sie sich in der Lage sehen, Problemlösungen intern mit hinzukommenden Projekten zu teilen.
  • erfassen, wie Software-Entwicklungen angestoßen werden und gegebenfalls aus eigenen Mitteln der Forschungsprojekte finanziert werden können.
  • sicherstellen, dass Entwicklungen neuer Wikidata-Features als Tools in das Angebot der freien Software gelangen, so dass sie von dort aus die breitere Nutzung der Software in Wissenschaftskreisen interessant machen.
  • Ideen entwickeln, wie die Community, die Wikidata betreut, mit den Forschern, die das FactGrid-aufbauen, in einen für beide Seiten interessanten Austausch gelangen. Dabei wird es vor allem um den Datenfluss zu Wikidata und um praktische Erfahrungen bei der Benutzung der gemeinsamen Software gehen.

Entscheidend wird es sein, in den Vorüberlegungen die gemeinsamen Interessen zu erfassen. Die Wikidata Software ist eine der interessantesten Entwicklungen der letzten Jahre. Sie löst auf spannende Weise Probleme, die viele wissenschaftliche Projekte derzeit mit Datenbank-Softwareangeboten haben. Sie ist auf vielfältige Objekte zugeschnitten, kann große Datenvolumina verwalten, notiert Veränderungen und Bearbeitungen nachvollziehbar und ihre Ressource agiert erfolgreich in allen möglichen Sprachen der Welt – doch ist sie gleichzeitig derzeit hermetisch abgeschlossen.

Die wissenschaftliche Arbeit mit dieser Software verspricht einen Erfahrungsaustausch, von dem die Software profitieren kann. Das Wikidata-Projekt hat dabei langfristig das Potential, Limitationen des Wikipedia-Projektes negieren zu können, jene Limitationen, die Forschenden die Arbeit in Wikipedia schwer machen. Der Schritt in die wissenschaftliche Ressource wird indes auch von Software-Anpassungen abhängen, die gemeinsam mit Wissenschaftlern gefunden und ausgetestet werden müssen. Dies vor allem sollte es auf Wikimedia-Seite interessant machen, Pilotprojekte mit der in den letzten Jahren aufgebauten Software betreut arbeiten zu lassen.

Der Aufbau einer Ressource, die “original research” betreiben und autorisieren kann und der Datenfluss von der wissenschaftlichen Ressource zu Wikidata sollten das Interessenspektrum erweitern.

Links etc.

  • The Gotha Illuminati Research Base. Link
  • Hier im Blog: Die Schwedenkiste digital: die ausstehende Durchleuchtung des Illuminatenordens
  • Metadaten zu den knapp über 6000 Dokumenten der “Schwedenkiste”, des zentralen Aktenbestands im Nachlass des Illuminatenordens. Link
  • Bislang ungenützt: der FactGrid Prototyp mit der Wikidata Software. Noch weiß keiner unserer Wissenschaftler, wo er Daten einfüllen soll und wie er sie dann wieder zu Anwendungen herauszieht.