FactGrid FAQ – Why should I use FactGrid for my research project?

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).

auf Deutsch
en français
magyarul

What is FactGrid?

FactGrid is a Wikibase installation — that is is both, a regular wiki and a database which you can use to make statements about objects of your interest — statements which you can then handle in practically any language in big data sets.

The platform is run by the Gotha Research Centre and hosted by the ThULB Jena. It addresses projects with a specific interest in historical data and is part of the German National Research Data Infrastructure NFDI4Memory.

In joint ventures with Wikimedia Germany and the German National Library’s GND we are trying to bring this platform into the upcoming consort of federated Wikibase instances as a resource for research data.

Why should I use FactGrid for my own research?

The biggest argument for a FactGrid account is the unbeatably flexible software, Wikibase, which we have managed to implement in a pilot project with the help of Wikimedia Germany – outside its primary location, Wikidata:

  • You are looking for a software that speaks practically any language — a platform on which you can enter data in your language and allow others to read your data in their languages? Wikibase is this software.
  • You are looking for software in which you can transparently coordinate a whole team? In Wikibase this is as easy as in the Wikipedia software MediaWiki .
  • You are looking for a database software that can do everything Digital Humanities databases normally want to do: network analysis, map representations, complex linked searches, timeline representations (in various formats) – a software that almost acts like human language yet provides full database services? Wikibase is this software.
  • You have data from previous projects which you want to build on? Wikibase has large-scale automatic input options.
  • You want to make sure that that other projects will actually use your data? Use a platform that allows the download and further work with your data offline in Excel or online in ever new projects.
  • You want to ask entirely new questions in your research? In Wikibase you can link any sort of objects with any kind of statements of your interest.
  • You are worried what will happen to your data and presentations once your funding is over? Work on a platform where you do not stay alone and where, thanks to the CC0 license you are using, you encourage colleagues to continue right were you stopped!

If you are looking for a long term perspective this is what we are trying to offer in our present joint venture with the German National Library. We will base our platform on GND data in order to serve as a broad public tool and with the aim to become a player in the emerging landscape of “Federated Wikibase installations”.

Why not use Wikidata right away?

That is a legitimate question to ask. There will be projects (projects that are mainly using data) for which Wikidata will be the better platform. The FH Potsdam’s “Archivführer zur deutschen Kolonialzeit” has demonstrated the beauty of working directly on Wikidata; we talked about this with Uwe Jung, who demonstrated the technical solutions they have chosen in Potsdam.

On the other hand, there remain basically two things which you will not be able to do on Wikidata or on a platform like the GND: Wikimedia projects (and the GND) have strict “No original Research” policies and observe fundamental decisions to operate on “criteria of notability“, which will not allow the arbitrary opening of database objects and the innovative object relationships researchers would like to test.

Wikidata and the GND focus on information that has already been published and on non-research workers who feed the respective databases from published research. You will not be allowed to state a “working hypotheses” of “your research” on these platforms. You will not be able to create entities with the aim to run “nothing but a statistical analysis” on them at a far later stage of your work.

In FactGrid we encourage the use of the platform as a heuristic research tool.

  • Create database objects on the platform, no matter what their relevance in an encyclopedia or in library catalog could be.
  • Risk provisional chronologies as working hypotheses along with your personal assumptions.
  • Use FactGrid in order to make unconventional statements that are presently interesting only in your research project – the software gives you this freedom.
  • Create specific database objects that state your research in all the data sets which you have substantially modified and become able to submit your research with the particular item as the envelope to your funding institution.
  • Risk any new thesis on the platform and state your respective view with a database object number as a “micro-publication” in order to claim your ingenuity on the data base.

FactGrid is free – how does it work?

The software is freely available and under development in the larger community of Wikimedia projects and among the institutions which are going to use Wikibase over the next years.

The FactGrid platform is presented by the Gotha Research Centre on a virtual server of Jena’s University Library free of charge.

All the Wikidata-tools are available to our users. These include all the standard applications of regular Digital Humanities projects.

With both software and tools being open source you can use any favorite software company you are working with, to generate the specific application which you feel you need.

If you feed your tools into the open compound this will be your best way to make sure that future projects will continue their development.

If you aim at technical solutions which you want to sell with financial profit that again will not be restricted by the software license. You can freely commercialize whatever you create on the basis of the open software.

What do I do with unorthodox research interests?

Wikibase is groundbreaking in its data modelling. Essentially you are only creating relations between Q-numbers (or relations between Q-numbers and dates, Q-numbers and space coordinates, Q-numbers and media files, Q-numbers and URLs).

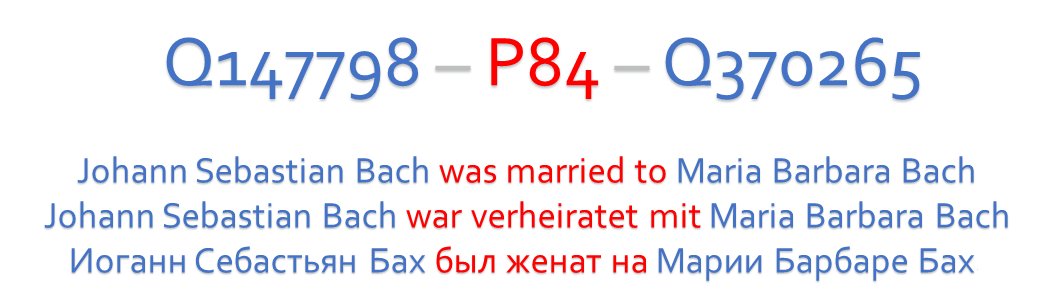
The software does not know what kind of relationships you are stating – these again are just P-numbers: Q1 – P1 – Q2 is a “triple” and can mean “Johann Sebastian Bach (Q1) is the father of (P1) Carl Philipp Emanuel Bach (Q2)”; it can mean just as well “This letter which I found in the archive with the shelf mark XYZ (Q1) has allegedly been sent from (P1) Munich (Q2)”

Q-numbers can be assigned to anything imaginable – people, documents, events, ideas… You decide what kinds of P-numbers you need in order to make statements of your interest. You do not define objects in a system of fixed categories; your statements are adding colour and solidity to whatever object you create as you go along. Do not worry if you do not have the data model on day one. Make statements when you suddenly want to make them and see how they gain the critical mass that can eventually be evaluated.

All statements can be “qualified” – “Johann Sebastian Bach (Q1) was married to (P2) Maria Barbara Bach (Q2) beginning on (P2) October 7, 1707 (date) ending (P3) about July 5 1720 (date).” All of these statements can in turn be equipped with references : “this is clear from (P4) the church book of… (Q3)”,”this is stated in (P5) the well known Bach biography XYZ (Q4)”.
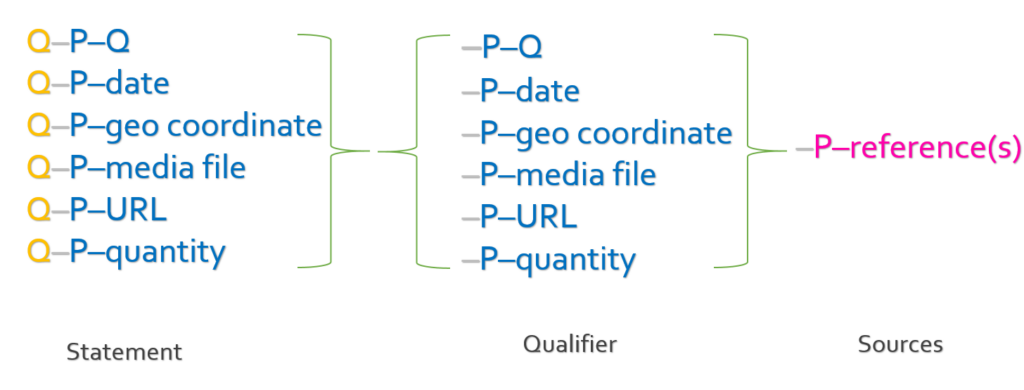
The system allows competing claims at any time. They are simply introduced with their different sources and can be balanced against each other.

You can create practically any normal language statement with triples of this depth of specificity; but above all, this opens the door to the world of statements in all the various languages you might want to speak: The system operates with Q- and P-numbers; the rest is labels in languages which you want to offer to your users. The software will in addition translate dates and quantities into other formats; this is basically the secret that makes it possible for Wikibase platforms to be edited by people in their own languages and to be read by the world in practically any other language.
Which tools does the software provide?

Database entries can be made one by one: Open the object-id in question, go to the bottom of the input page and click the “add statement” link. You will now be asked for the statement you want to make. You do not need to know the P-number. State the property in the language you are using and click at the auto complete you are eventually being offered. The platform will now use the P-number of that statement for you. Complete in the next box that opens your statement. You will again get suggestions to use as you are typing.

Database entries can also be created and substantiated in automated inputs from Excel or CSV lists. (This is the input mask and this is the short guide to it.)

Database queries have to be formulated as “SPARQL” queries, a search language that is (unfortunately) not that easy to use, but that is eventually as complex as the searches you might want to perform.

SPARQL users do not necessarily know how to write SPARQL source code. You usually use sample queries that tell you where you have to change the input in order to run your particular search.

If you know exactly which type of search queries your users should run you can create your own input masks just as you know them from conventional online library interfaces, which will then speak SPARQL with the database.

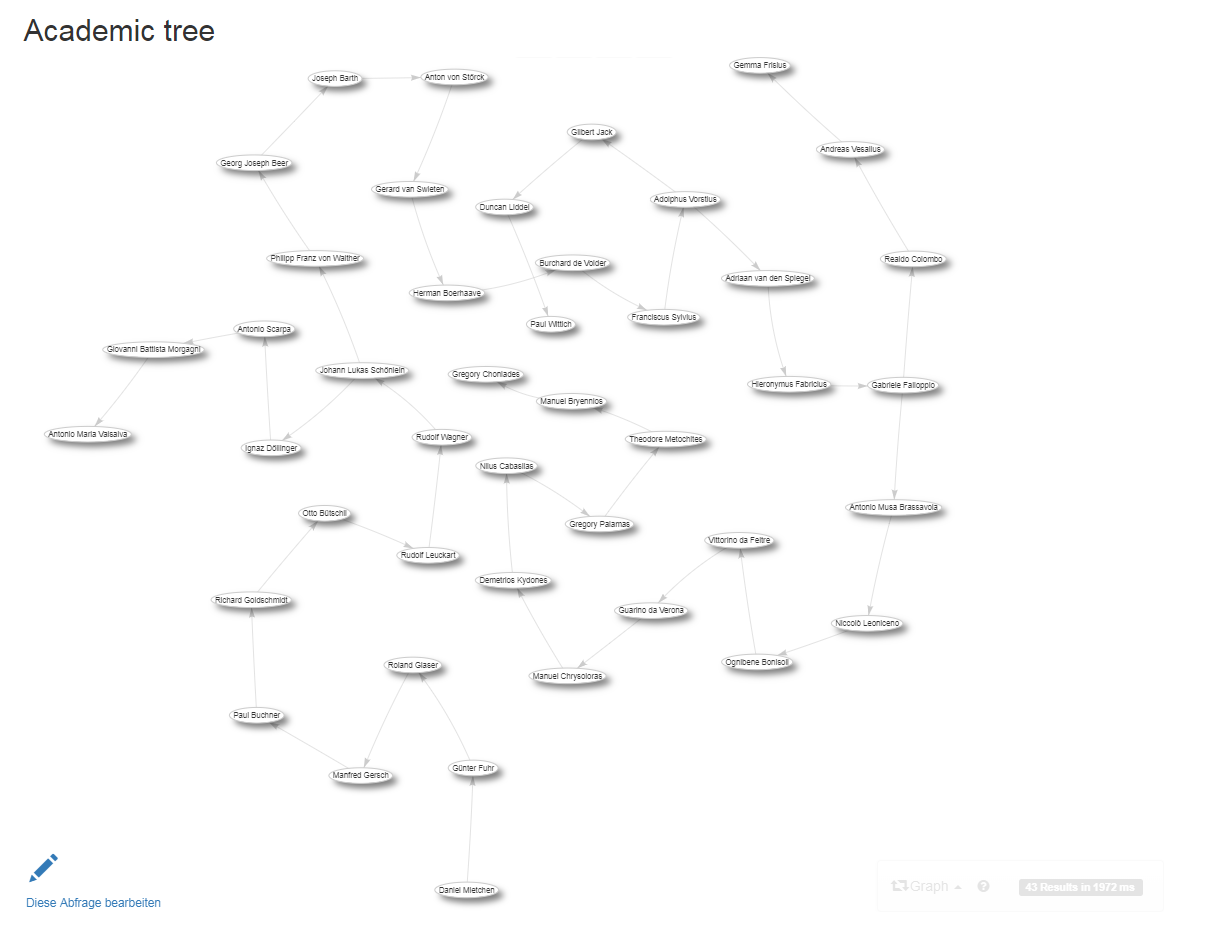
The software package includes illustrations on maps, timelines, networks, genealogical relationships, graphs, and so on. You do not need to download particular applications. You will ask SPARQL to produce the representation you are trying to get. The Scholia project on Wikidata has a beautiful first presentation of some of the visualisations.

What do I do if I want to give my very own data representations on my own platform?

That should not be a technical problem. Uwe Jung demonstrated how the FH Potsdam interface uses Wikidata as its data repository, without letting users see the database they are accessing.

There is nothing wrong with using FactGrid as an external repository and building up your own research project on the server of your home university, where you can offer targeted database accesses under a typical search template of your choice.

FactGrid basically licenses data to CC0 – does that not mean that I give up all rights to my research?

Opting for the Creative Commons 0 license means essentially that you continue to be free to do whatever you want with your data – you, and not your publisher or the platform that received your data under a scheme, continue to control. But above all, the CC0 license means that your data becomes freely usable and that you can thus reduce the danger of obsolete research in the longer run – others will continue to root out the ugly mistakes you could not hope to correct.

Some basic considerations: CC BY 4.0 is at first glance the license that scientists will prefer: It allows the free further use as long as it receives the accurate citation. In practice, this will work for texts (such as this blog post); here it is clear how one would like to see the text cited: with a reference to one’s own name, with the title of the publication, the place of publication and the date. But do you want your data quoted let us say in a visualisation? A letter sent from Paris to Berlin in June 1753 will be a line on a map and how should this line be properly annotated? How do you want to be quoted if you only improved a data set? “Share alike” licenses are even more problematic: “These data are freely available if the subsequent users keep it just as freely available.” That sounds like the ultimate plea for free use. But how can a sub-user ensure that his sub-users, in turn, will respect your license agreement (especially if this sub-user is offering his data on CC0)? Sub-users are well advised not to use data from CC-BY or CC Share-Alike platforms.

Our joint ventures with Wikidata and the German National Library left us only only one option: to make our data as freely available as our partners: CC0, that is without ensuring that subsequent users will still specify exactly who collected the data, and what third-party users are allowed to do with that data.
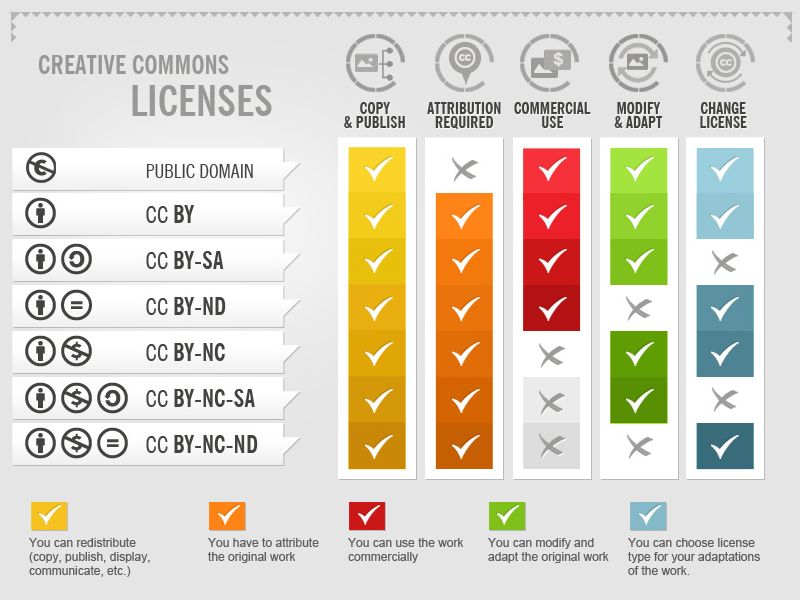

In practice, the maximum open license does not mean that FactGrid data is data without authorship, quite the contrary. We suggest that research is cited and assume that Wikidata and the GND are only too happy to state research from our platform. All changes are linked to respective the author names. If research projects have worked more substantially on a data set, they will have stated this in a separate note on the data set that can now be adopted with the data transfer.

Databases like Wikidata or DNB’s GND are in fact interested to quote research – it boosts their data solidity, and FactGrid is here in the unique position to give both institutions a platform on which people can do what they cannot do on the respective larger platforms.

What happens if I want to continue working with my data on another platform?

Since you entered your data without a copyright restriction, you are free work with them on any other project of your interest. We actually like to be “just an incubator” for research data.

What happens when FactGrid users argue about a “correct” date?

The software makes it possible to handle contradictory data. This is particularly interesting in the field of historical research, where we often have conflicting documentary evidence without being able to determine the correct statement after so much time. The software makes it possible to reproduce such a contradictory situation. Numerous statements can be given side by side with their various respective sources. You can then still balance the statements against each other – either by turning one of them into the statement to privilege in future searches and/or by adding qualifying statements with your personal evaluations.

If two researchers come to different results, think of it as the situation you should actually be interested in. It is far worse that you have made mistakes on a platform where they will never be corrected and where they eventually discredit all your work as obsolete beyond repair.

Why should I risk transparency in my project right from the start?

This is likely to be the toughest issue that currently prevents projects from using the resource which we have opened. The alternative is the resource, which is accessible to the team only under passwords until the publication deadline is reached almost at the end of the project. No competing project can snatch away findings, so the theory. No one sees where you have initially made a mistake. Nobody records what assistants are typing in and where the project leader is involved – such are the presumed advantages of non-transparent working on a platform that will only go online at the end of your funding.

Transparent research offers its own securities: If you find a groundbreaking document and establish a decisive connection, then this is your chance to fix the statement to your name and project. If someone makes the same discovery tomorrow in the archive you have just visited, tough luck. You will have recorded your observation with a link in the version history which your rivals will not be able to deny.

At the same time, the collective platform expresses the invitation to cooperate. Make it clear to other teams what you are working on and allow them to contact you on the platform!

The risks of the allegedly secure website, which is only going online at the end of the project’s funding, are serious: The time for an exchange with users is over. The internet presence goes online in the heated final weeks while the project is totally unable to react with more conceptual changes. If you have done research solely for a book publication, it will remain unclear what you and your team should do with the data, you have still collected in Word files, and Excel spreadsheets. Nobody will be able to feed all these data into any resource – the harmonisation at this late stage will be an insurmountable obstacle. You can only hope that readers of your book will scan all your footnotes for corrections that should reach our library catalogs and the various Wikipedia projects. The risk is here the book that has no influence on the collective data base and of DH projects that become obsolete right after their publication.

The future should lie in a new attitude toward the public data base. Researchers should be able to correct and to further widen this base wherever they access it. The incentive and the security they will need here is the research environment in which they can mark their work and make it citable. For this Wikibase is better equipped than any other software.

How do I get my project accepted on FactGrid?

The FactGrid platform has no invisible deeper layer. Anyone can query the database and the queries will give the same information whether you are logged in or not. Your personal user account just has the advantage that you can now switch to your favorite language when looking at data, and that you see the edit link on each statement.

If you want to feed your own data into the platform and if you want to run a project on the the platform, you will need an account. These are given under real names by the administrators. The software provides an “account request” link. You can also contact us via email. Project leaders can receive administrative accounts which they use to assign to team members and users of their interest.

Once logged in, you can enter data in bulk or make specific corrections wherever you feel like. Any input will be connected to your user account. Others can undo your edits but not without leaving a documented mark of that intrusion in the version history – visible to all the world.

If you want to work on a more complex project —

  • that can be personal family research,
  • it can be a single visualization you need in a seminar paper,
  • it may just as well be the input of thousands of records in a 5-year research project

— speak with those on board and those organising the platform. We will not (necessarily) be interested to sign a public memorandum of understanding with you but it might be cool to advertise your project on the blog and to make it known on the entire platform. Your work becomes exciting, where you modify the work others have already done and where you encourages players from other projects to adopt good models which you are introducing. You do not need to discuss data models with all the others but using models with all the others is also a way to spread your work and to make it appear in queries composed by others, and visualizations you did not think of.

The software is designed to manage both: unique statements which only you are interested in and statements that will spread far beyond your own initial research interest as you are now feeding the unforeseen queries which others will run on their and your data.

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).
Jack Kirby, “The Fourth Dimension is a many splattered thing!” from Alarming Tales, 1 (September 1957).

FactGrid FAQ – Warum sollte ich das FactGrid für die eigene Forschung nutzen?

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).

in English
en français
magyar nyelven

  1. Was ist das FactGrid?
  2. Warum sollte ich das FactGrid für die eigene Forschung benutzen?
  3. Warum nicht gleich Wikidata benutzen?
  4. Das FactGrid kommt kostenfrei – wie geht das an?
  5. Was mache ich mit unorthodoxen Forschungsanliegen?
  6. Welche Tools stellt die Software mir zur Verfügung
  7. Was mache ich, wenn ich ganz eigene Datendarstellungen auf meiner eigenen Plattform realisieren will?
  8. Das FactGrid lizenziert Daten grundsätzlich CC0 – heißt das nicht, dass ich alle Rechte an meiner Forschung aufgebe?
  9. Was geschieht, wenn ich mit meinen Daten auf einer anderen Plattform weiterarbeiten will?
  10. Was passiert, wenn es zwischen FactGrid-Benutzern zum Streit über ein “korrektes” Datum kommt?
  11. Warum sollte ich in meinem Projekt Transparenz schon von Anfang an riskieren?
  12. Wie nutze ich das FactGrid konkret?

Was ist das FactGrid?

Das FactGrid ist eine Wikibase-Instanz, die, vom Forschungszentrum Gotha aus organisiert, an der ThULB Jena gehostet wird.

Wikibase ist die Software, die hinter Wikidata läuft. Die Instanz will historischer Forschung einen eigenen Freiraum zur Verfügung stellen und im Verlauf technisch in der Lage sein, mit der GND und mit Wikidata laufend Daten auszutauschen — Daten, die aus dem FactGrid heraus international als Forschungsdaten zitierbar werden. Seit dem 5. November 2022 ist das FactGrid — als global agierende Plattform — offizielles Repositorium im Spektrum der deutschen Nationalen Forschungsinfrastruktur, NFDI4Memory.

Sehen Sie hierzu auch den Beitrag zu den Zielerwägungen, den Barbara Fischer für die GND und Jens Ohlig für Wikimedia am 9. Mai 2019 im Wikimedia Blog veröffentlichten.

Warum sollte ich das FactGrid für die eigene Forschung benutzen?

Dafür spricht erstens die unschlagbar flexible Software, Wikibase, die wir im Pilotprojekt mit Wikimedia Deutschland bahnbrechend außerhalb ihres eigentlichen Orts, Wikidata, zum Laufen brachten:

  • Sie suchen eine Software, die praktisch jede gängige Sprache spricht und in der sich Daten in jeder Sprache eingeben und in danach in beliebigen anderen Sprachen ausgeben lassen? Wikibase ist diese Software.
  • Sie suchen eine Software, in der Sie ein ganzes Team transparent koordinieren können? In Wikibase ist das so einfach wie in der Wikipedia Software MediaWiki.
  • Sie suchen eine Datenbank-Software, die alles kann, was Datenbanken der Digital Humanities normalerweise können: Netzwerkanalysen, Repräsentationen auf Landkarten, komplex verknüpfte Recherchen, Timeline-Darstellungen (in verschiedenen Datenformaten), und die sich dabei einem Umgang mit normalen Aussagen annähert? Wikibase ist diese Software.
  • Sie haben Datenmengen aus vorheriger Forschung, auf die Sie aufbauen wollen? Wikibase erlaubt den großflächigen automatischen Input.
  • Sie wollen sicherstellen, dass Ihre Daten nachnutzbar werden? Wikibase ist genau darauf eingestellt.
  • Sie wollen neuartige Fragen an Material stellen? In Wikibase können Sie beliebige Objekte mit beliebigen Aussagen Ihres Interesses verknüpfen.
  • Sie fragen sich, was nach Ihrer Projektlaufzeit mit Ihren Daten und Ihren Präsentationstools noch geschieht? Setzen Sie auf eine Plattform, auf der Sie nicht allein arbeiten und auf eine Datenlizenz, die es anderen ermöglicht, Ihre Arbeit wirklich risikolos zu nutzen und fortzuentwickeln!

Für das FactGrid spricht im selben Moment, dass wir im Interesse am breiten und offen bleibenden Datenaustausch in einer Kooperation mit der Deutschen Nationalbibliothek die gesamte Plattform soeben auf GND-Daten aufsetzen, um das Projekt in seiner größeren Breite in der entstehenden Landschaft von “Federated Wikibase Platforms” zu verankern.

Warum nicht gleich Wikidata benutzen?

Das ist eine gute Frage, die man sich stellen sollte. Es wird Projekte geben (die hauptsächlich Daten nutzen), für die Wikidata die bessere Plattform ist. Für die FH-Potsdam demonstrierte dies der „Archivführer zur deutschen Kolonialzeit“; wir sprachen darüber mit Uwe Jung, der die technischen Lösungen vorstellte, die man dort realisierte.

Zwei Dinge, gibt es, die es andererseits interessant machen, gezielt eine (Wikidata und die GND beliefernde) eigene Plattform aufzubauen: Die Wikimedia- (und GND–) spezifische “No Original Research” Grundregel und die fundamentale Entscheidung für Relevanzkriterien auf beiden Plattformen, die das beliebige Aufmachen von Datenbankobjekten und Objektbeziehungen ausschließt.

Wikidata und die GND richten sich auf bereits publizierte Information aus und auf Bearbeiter außerhalb der Forschung, die Publikationen auswerten und Daten eingeben. Unmöglich wird es bleiben, auf diesen Plattformen Arbeitshypothesen zu riskieren, Datierungen, die erst einmal auf Probe gestellt sind, Personeninformationen, die später in einer Publikation nur statistisch ausgewertet werden sollen.

Im FactGrid ermuntern wir zur Nutzung der Plattform als heuristischem Forschungstool.

  • Legen Sie hier Datenbankobjekte an, die Sie weit später erst auswerten wollen, egal welche Relevanz diese in einer Enzyklopädie oder in Bibliothekskatalogen gewinnen können.
  • Riskieren Sie provisorische Datierungen – als Arbeitshypothesen zusammen mit Ihren persönlichen Annahmegründen.
  • Wagen Sie im FactGrid unkonventionelle Aussagen, die erst einmal nur in Ihrem Forschungsprojekt interessant sind – die Software erlaubt es Ihnen.
  • Bauen Sie eigene Datenbankobjekte zu Ihren Forschungsprojekten und verknüpfen Sie diese mit allen Datenbankobjekten, an denen Sie arbeiteten, um so Ihrem Geldgebern die eigene Forschung im Paket der Datenbeziehungen vorlegen zu können.
  • Riskieren Sie im FactGrid Thesen und führen Sie diese in der Datenbank als “Mikro-Publikationen” mit eigenen Datenbank Objekt-Nummern.

Das FactGrid kommt kostenfrei – wie geht das?

Die Software ist frei verfügbar und befindet sich in einer von großen Communities getriebener Entwicklung im Wikimedia-Bereich und in Zukunft in hinzukommenden Institutionen wie denen der europäischen Nationalbibliotheken, die soeben eigene Wikibase Instanzen und Tools bauen.

Das FactGrid selbst läuft unter Ägide des Forschungszentrums Gotha auf einem virtuellen Server der Universität Erfurt. Für die deutsche URL fallen jährlich €36 Domaingebühren an, die vom Forschungszentrum Gotha getragen werden.

Nutzern stehen alle Tools aus dem Wikidata Projekt zur Verfügung. Mit ihnen sind die Standardanwendungen gängiger Humanities Projekten erst einmal abgedeckt.

Da die Software open source ist, können Projekte eigene Software-Etats gezielt in Tools und Präsentationen investieren, um die es ihnen in der eigenen Forschung geht. Arbeiten Sie gerne mit einer favorisierten Softwareschmiede zusammen, so wird diese, was den Quellcode der laufenden Software anbetrifft, vor offenen Türen stehen. Bieten Sie Ihre eigenen Entwicklungen offen zur Weiterentwicklung an, und Sie können darauf vertrauen, dass Visualisierungen auch nach Ihrer Projektförderung noch fortentwickelt werden. Streben Sie dagegen eigene Softwarelösungen mit dem Ziel einer kommerziellen Vermarktung an, so bindet Ihnen die Software-Lizenz hier nicht die Hände: Sie erhalten die bestehenden Softwarelösungen frei und können eigene darauf aufbauenden Tools jederzeit kommerziell verwerten.

Was mache ich mit unorthodoxen Forschungsanliegen?

Wikibase ist bahnbrechend offen in den mit dieser Software möglich werdenden Datenbankanwendungen. Letztlich werden hier nur Beziehungen zwischen Q-Nummern hergestellt (respektive Beziehungen zwischen Q-Nummern und Daten, Q-Nummern und Raumkoordinaten, Q-Nummern und Mediendateien, Q-Nummern und Internetadressen).

Was das für Beziehungen sind, das ist für die Software irrelevant. Q1 – P1 – Q2 ist ein “Triple” und kann bedeuten “Johann Sebastian Bach (Q1) ist der Vater von (P1) Carl Philipp Emanuel Bach (Q2)”; es kann genauso gut bedeuten “Der Brief des Archivs X mit der Signatur YZ (Q1) notiert als Absendeort (P1) München (Q2)”

Q-Nummern können für alles nur Denkbare vergeben werden – Personen, Dokumente, Ereignisse, Ideen… Sie selbst legen fest, was für P-Nummern Sie definieren wollen, um Aussagen Ihres Interesses zu Ihren Datenbankobjekten zu treffen. Im System kristallisiert sich letztlich erst mit den Aussagen, die Sie zu Ihren Objekten treffen, heraus, welcher Art Objekte das sind. Das heißt: Sie benötigen kein Kategoriensystem, das Ihnen im Vorhinein klar sein muss, um mit der Datenbank zu arbeiten. Sie treffen Aussagen dann, wenn Sie sie plötzlich setzen wollen, und sehen zu, wie sich diese zu einer kritischen auswertbaren Masse akkumulieren.

Alle Aussagen lassen sich “qualifizieren” – “Johann Sebastian Bach (Q1) war verheiratet mit (P2) Maria Barbara Bach (Q2) mit Beginn am (P2) 7. Oktober 1707 (Datum) bis zum (P3) ca. 5. Juli 1720 (Datum).” Alle diese Aussagen lassen sich wiederum beliebig mit Quellenaussagen versehen – “das geht hervor aus (P4) dem Kirchenbuch von… (Q3)”, “das wird so behauptet in (P5) der Bach-Biographie XYZ (Q4)”.

Das System lässt jederzeit konkurrierende Behauptungen zu. Sie werden einfach mit ihren unterschiedlichen Quellen eingebracht und können dabei beliebig untereinander bewertet werden. In ihrer weiteren Nutzung im System gewinnen sie ihre eigentliche Bedeutung.

Letztlich lassen sich auf damit beliebige normalsprachliche Aussagen generieren; vor allem aber öffnet dies die Tür in die Welt global handhabbarer Aussagen. Für das System spielen sich alle Aussagen nur als Verknüpfungen von Q-Nummern mittels P-Nummern ab. Sie selbst belegen die Q- und P-Nummern mit “Labeln” in den Sprachen, in denen Sie kommunizieren (Datums- und Mengenangaben verwaltet das System bereits in beliebigen globalen Standards mit automatischer Umrechnung in jede Richtung); so das Geheimnis, das es möglich macht, dass auf Wikibase Plattformen Autoren in ihrer jeweiligen Sprache eingeben und andere Nutzer diese Informationen in beliebigen Sprachen auslesen.

Welche Tools stellt die Software mir zur Verfügung

Datenbank-Eingaben können sukzessive erfolgen: Sie wollen über ein Objekt eine neue Aussage treffen? Rufen Sie das Objekt auf, gehen Sie ans Ende der Eingabe-Seite, wo “Aussage hinzufügen” steht, und beginnen Sie die Aussage in Ihrer Lieblingssprache – das System ergänzt mit Auto-Complete die gesuchte Aussage und sucht sich die P-Nummer dieser Aussage heraus. Tippen Sie in das sich nun eröffnende Feld ein, auf welches andere Objekt diese Aussage laufen soll oder auf welches Datum (in Ihrer Sprache) und die Software macht ihnen immer präzisere Vorschläge, noch während Sie tippen.

Datenbank-Eingaben können zweitens massenweise und automatisiert in gängigen Formaten aus Excel-Listen oder CSV-Listen erfolgen. (Dies ist die Eingabemaske und dies die kurze Anleitung dazu.)

Datenbankabfragen geschehen im Gegenzug mit “SPARQL“, eine Such-Sprache, die (leider) nicht einfach zu bedienen ist, die es jedoch nun erlaubt, die Datenbank beliebig komplex zu befragen – komplexer als jede Standard-Suchmaske Ihnen das erlauben würde. SPARQL-Nutzer müssen nicht unbedingt den SPARQL-Quellcode schreiben können. Man bedient sich in der Regel einer passenden Musterabfrage, die man in einer Sample-Queries-Liste findet, und tauscht hier die Suchbegriffe aus.

Weiß man exakt, welcher Art Suchanfragen Benutzer des eigenen Projektes durchführen können, so lassen sich Suchschablonen wie in herkömmlichen Katalogen bauen, die die Anfragen an das System unterhalb der Benutzeroberfläche in SPARQL formulieren.

Im Software-Paket finden sich Darstellungen auf Landkarten, Timelines, in Netzwerken, genealogischer Beziehungen, Diagramm-Darstellungen und so fort. Für diese Anwendungen müssen keine Softwarepakete eigens installiert werden. Sie formulieren in Ihrer SPARQL Anfrage, was für eine Darstellung Sie wünschen.

Einen sehr schönen Überblick über Visualisierungen gibt das Scholia Projekt auf der Wikidata Plattform.

Was mache ich, wenn ich ganz eigene Datendarstellungen auf meiner eigenen Plattform realisieren will?

Das sollte technisch kein Problem sein. Uwe Jung demonstrierte, wie eine Benutzeroberfläche der FH Potsdam Wikidata als Datenrepositorium benutzt, ohne dass die Benutzer mitbekommen, auf welche Repositorien die Abfragen zugreifen.

Nichts spricht dagegen, das FactGrid als ein externes Repositorium zu benutzen und das eigene Forschungsprojekt auf dem Server der Heimat-Uni aufzubauen und dort die Benutzer mit gezielten Datenbankzugriffen unter einer typischen Suchschablone zu bedienen.

Das FactGrid lizenziert Daten grundsätzlich CC0 – heißt das nicht, dass ich alle Rechte an meiner Forschung aufgebe?

Positiv gesprochen bedeutet die Entscheidung für die Creative-Commons-0-Lizenz, dass Sie die vollen Rechte an allen (Ihren) Daten behalten. Vor allem aber bedeutet die CC0-Lizenz, dass Ihre Daten frei nutzbar werden und damit weniger Gefahr laufen, als Forschung obsolet zu werden.

Einige grundsätzliche Erwägungen dazu: CC BY 4.0 ist auf den ersten Blick die Lizenz, die Wissenschaftlern näher liegt: Man gestattet die freie weitere Nutzung, wenn man dafür fachgerecht zitiert wird. In der Praxis lässt sich diese Lizenz bei Textveröffentlichungen (wie diesem Blogbeitrag) noch gut durchsetzen. Hier ist es klar, wie man den Text, den man verfasste, und Thesen, die man bahnbrechend formulierte, zitiert sehen möchte: Mit einem Verweis auf den eigenen Namen, mit dem Titel der Publikation, dem Publikationsort und dem Datum. Wie aber soll das Datenzitat (etwa die Information, dass ein Brief im Juni 1753 von Paris nach Berlin ging) innerhalb einer Visualisierung erfolgen, auf Strichen, die auf einer Landkarte erscheinen? Wie sollen Benutzer Datensätze zitieren, wenn diese nur zum Teil Informationen aus Ihrem Forschungsprojekt enthalten, zum größeren Teil jedoch andere Datenbankinformationen etwa aus einer öffentlichen Archivdatenbank bieten, die Sie einspielten? Noch größere Probleme stellen sich bei Daten mit Lizenzen, die eine “share-alike” Klausel bergen: “Diese Daten sind frei verfügbar, wenn die Nachnutzer sie genauso frei verfügbar halten.” Das klingt erst einmal nach nachdrücklicher freier Nutzung. Wie aber soll ein Nachnutzer sicherstellen, dass wiederum seine Nachnutzer sich an die von Ihnen gewünschte Lizenzvereinbarung halten (insbesondere, wenn dieser Nachnutzer auf CC0 geht)? Nachnutzer sind gut beraten, keine Daten aus CC-BY oder CC Share-Alike Lizenzen zu verwenden.

In der Praxis der größeren Kooperationen mit Wikidata und der Deutschen Nationalbibliothek kann es darum nur eine Option geben: Genauso frei Daten zur Verfügung zu stellen, wie die Kooperationspartner diese tun: CC0, das heißt ohne, dass sichergestellt wird, dass Nachnutzer noch exakt angeben, wer die Daten einzeln erhob, und was Drittnutzer wiederum mit diesen Daten tun dürfen.

 
Die maximal offene Lizenz heißt in der Praxis durchaus nicht, dass FactGrid Daten Daten ohne Autorschaft sind, ganz im Gegenteil. Wir legen es nahe, Forschung als Forschung zitierbar zu machen und gehen davon aus, dass Wikidata und die GND Zitiervoschläge gerne übernehmen. Alle Datensatzänderungen werden von der Software für alle Nutzer sichtbar an bei uns Real-namentlich gebunden. Haben Forschungsprojekte substanzieller an einem Datensatz gearbeitet, vermerken Sie dies jederzeit mit einer eigenen Notiz Ihrer Arbeit im Datensatz. Jeder kann die Datenbank danach befragen, welche Datensätze im Rahmen eines bestimmten Projektes bearbeitet wurden.

Tatsächlich ist es für Datenbanken wie Wikidata oder die Gemeinsame Normdatenbank der DNB, die GND, ungemein interessant, Daten aus dem FactGrid als dort erstmals publizierte zitieren zu können – es steigert die eigene Datensolidität, wenn sich Forschung benennen lässt und es gibt beiden Institutionen eine Plattform auf der möglich wird, was auf der eigenen Plattform ausgeschlossen bleibt.

Was geschieht, wenn ich mit meinen Daten auf einer anderen Plattform weiterarbeiten will?

Da Sie Ihre Daten ohne Copyright-Aufgabe einpflegten, können Sie sie in beliebig vielen anderen Projekten parallel laufen lassen. Wir sind hier gerne “nur” ein “Inkubator” für Forschungsdaten.

Was passiert, wenn es zwischen FactGrid-Benutzern zum Streit über ein “korrektes” Datum kommt?

Die Software lässt es zu, einander widersprechende Daten zu handhaben – das ist gerade im Feld der Geschichtswissenschaften interessant, wo wir oft dokumentarisch belegte divergierende Informationen haben, ohne noch ermessen zu können, welches die korrekte Aussage ist. Namen werden in verschiedenen Schreibungen gehandhabt; Geschichtsschreiber widersprechen einander.

Die Software erlaubt es, die widersprüchliche Lage abzubilden; sie erlaubt es, Objekte mit Dutzenden Namensschreibweisen zu belegen – es sind nur verschiedene Schreibweisen zu ein und derselben Q-Nummer.

Divergierende Aussagen lassen sich unterschiedlich einstufen – etwa als das derzeit autoritative Datum gegenüber Varianten, für die allein die verschiedenen einander widersprechenden Quellen sprechen.

Sollten zwei Forscher zu unterschiedlichen Befunden kommen, so ist das letztlich der Fall, auf den es jedes Projekt anlegen sollte. Das viel größere Risiko ist die hypothetische Entscheidung, die Sie in Ihrem Projekt treffen, während ein Projekt auf einer anderen Plattform das Rätsel löst und mit dem belastbaren Datum weiterarbeitet, ohne dass Sie davon auch nur erfahren, geschweige denn die Korrektur Jahre nach Ihrer Projektlaufzeit noch einpflegen können.

Warum sollte ich in meinem Projekt Transparenz schon von Anfang an riskieren?

Das dürfte die härteste Frage sein, die Projekte im Moment davon abhält, sich der eröffneten Ressource bereits zu bedienen. Die Alternative ist die Ressource, die bis zum Publikationstermin gegen Projektende nur unter Passwörtern dem Team zugänglich ist. Kein Konkurrenzprojekt kann Ihnen in der verdeckten Arbeit an Ihrer Plattform Befunde wegschnappen, so die Theorie. Auch sieht niemand, wo Sie erst einmal Fehler machten, die Sie erst im Verlauf korrigierten. Niemand erfasst, was Hilfskräfte eingaben und was dagegen Sie als Projektleiter verantworten – so die Vorteile des intransparenten Arbeitens auf einer Plattform, die erst am Projektende online geht und die keinen Blick in die Versionsgeschichten der Datensätze zulässt geschweige denn in die tägliche Projektarbeit.

Die transparente Forschung, zu der das FactGrid einlädt, bietet indes ganz eigene Sicherheiten: Wenn Sie bahnbrechend ein bestimmtes Dokument auffinden und einen bestimmten Zusammenhang herstellen, dann ist der Editiervorgang, mit dem Sie den Datensatz mit Aussagen bestücken, Aussage um Aussage datiert und jeweils mit Ihrem Namen verbunden. Macht morgen jemand im selben Archiv dieselbe Entdeckung, werden Sie im FactGrid nachweisbar und fälschungssicher notiert haben, dass Sie den Zusammenhang schon einen Tag zuvor öffentlich zugänglich machten.

Die kollektive Plattform spricht im selben Moment die Einladung zur Kooperation aus. Machen Sie anderen Teams klar, woran Sie arbeiten und erlauben Sie noch auf Ihrer Plattform die Kontaktaufnahme mit Ihnen!

Die Risiken des vermeintlich sicheren und erst am Ende der Projektzeit online gehenden Internetauftritts sind gravierend: Die Zeit für einen Austausch mit den Nutzern ist mit der finalen Publikation abgelaufen. Der Internetauftritt erfolgt in den letzten Wochen Ihres Projektes, währen alle anderen letzten Arbeiten laufen und für konzeptionelle Änderungen kein Raum mehr bleibt. Ist überhaupt kein Digital Humanities-Part in der Forschung einkalkuliert, so bleibt unklar, was mit den Daten noch geschehen soll, die Mitspieler in Word-Dateien, Excel-Listen oder eigenen Softwarelösungen ganz für sich sammelten – sie noch irgendwo einzupflegen, hat niemand mehr die Kraft. Man kann nur noch hoffen, dass Leser der abschließenden Buchpublikation in dieser alle Fußnoten auf Korrekturen hin durchkämmen, die im öffentlichen Informationsstand nötig werden und diese dann in allen Bibliothekskatalogen und in den verschiedenen Wikipedia-Projekten durchführen. Das Risiko sind hier Bücher, die an der kollektiven Datengrundlage vorbeigehen und DH-Projekte, die nach ihrer Publikation mangels weiterer Pflege in wenigen Monaten veralten.

Die Zukunft sollte darin liegen, dass wir die Datenlage, derer wir uns selbst in der Forschung bedienen, eigenverantwortlich bearbeiten können. Um dies wiederum ohne Gefahr der Aufgabe wichtiger Befunde tun zu können, müssen wir es Forschern erlauben, ihre Forschungsleistung transparent und zitierbar sichtbar zu machen. Hierfür ist Wikibase besser als jeder andere Software ausgerüstet.

Wie nutze ich das FactGrid konkret?

Das FactGrid hat keine unsichtbare Tiefenschicht. Jeder kann die Datenbank befragen und die Abfragen bieten dabei eingeloggten Benutzern dieselben Antworten wie fremden. Alle Datensätze sind in allen Versionsstufen öffentlich präsent. Der eigene Benutzeraccount bietet beim puren Auslesen von Daten nur den Vorteil, dass Nutzer nun die Software auf die eigene Sprache umstellen können.

Wer eigene Daten einspeisen und mit ihnen auf der Plattform arbeiten will, benötigt dagegen einen Account. Diese werden unter Klarnamen von den Administratoren vergeben. Die Software bietet ein Link zur Account-Anforderung. Wir vergeben ansonsten Accounts auf (Email) Anfrage. Projektleiter erhalten administrative Zugänge, mit denen sie selbst Benutzerkonten vergeben können.

Einmal eingeloggt kann man sowohl Daten in Massen eingeben wie an beliebiger Stelle Datenkorrekturen vornehmen. Alle Eingaben werden an den Benutzer-Account gebunden, der sie tätigt, und können von jedem anderen zurückgenommen werden, was wiederum als exakt diese Rücknahme namentlich dokumentiert und mit einem Zeitstempel versehen wird – für eingeloggte und nicht eingeloggte Benutzer gleichermaßen sichtbar.

Wer an einem komplexeren Projekt arbeiten will —

  • das kann die persönliche Familienforschung sein,
  • das kann eine einzelne Visualisierung im Rahmen einer Seminararbeit sein,
  • das kann genauso gut eine Eingabe von Tausenden von Datensätzen in einem auf mehrere Jahre laufenden Forschungsprojekt mit mehreren Mitarbeitern sein

— ist gut beraten, noch bei der Account-Eröffnung den Austausch mit der Plattform zu suchen. Eine Kooperationsvereinbarung kann dem eigenen Projekt Rückhalt gegenüber Geldgebern geben; doch kann auch einfach nur ein Blogbeitrag mit einer Projekteröffnung interessant sein. In jedem Fall sollten andere auf der Plattform von Ihnen wissen. Spannend wird die kollektiven Datenbank, wo man die Vorarbeiten anderer nutzt und Mitspieler aus anderen Projekten anregt, gute Modelle zu übernehmen. Nötig ist die Abstimmung nicht; praktisch aber trägt sie zur Verbreitung der eigenen Arbeit bei – zu Suchanfragen, die man selbst so schnell nicht zu formulieren weiß, zu Visualisierungen, an die man nicht dachte, zu Hilfe, wo man sie benötigt.

Die Software verspricht eine neugierige Nutzung im breiten Netz und dieses Netz sollte man mit Forschung ansprechen.

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).
Jack Kirby, “The Fourth Dimension is a many splattered thing!” from Alarming Tales, 1 (September 1957).

Memorandum of Understanding between the University of Erfurt and the German National Library – to base the FactGrid on GND data in a joint project

German Version

We are proud to announce a new and massive Wikibase project that should keep a large community busy for far more than a year: Last month the president of the University of Erfurt, Prof. Dr. Walter Bauer-Wabnegg, and Dr. Elisabeth Niggemann, director-general of the German National Library in Frankfurt and Leipzig (DNB) signed a memorandum of understanding that aims to bring GND data into the FactGrid – on a grand scale.

The GND, the German Integrated Authority File, is an authority file of millions of persons plus corporate bodies, conferences and events, geographic information, topics and works – designed to shape the exchange between libraries, archives and academic projects in the DACH countries of Germany, Austria and Switzerland.

integrating the GND into the FactGrid had been our constant topic of discussion during the last year. A Wikibase instance becomes a cool thing to contribute to, as soon as it becomes the research tool that you would use yourself in your research. GND data links into the world of open data; they clarify who or what you are speaking of in your research in all German-language contexts – and they will reach out to the other global authority files and to the universe of library data.

In April 2018 it became clearer that the FactGrid would eventually be one of several Wikibase instances which could and should in this case aim for a larger federation. Early in June it transpired that the German National Library was on its way to test Wikibase in a software evaluation, with the aim to run possibly about ten Wikibase instances in a constant exchange with each other. That was when we contacted the DNB with our own agenda to import their data. We wanted to try, so that our proposal, could become a platform for “original research” – a platform without GND or Wikidata criteria of notability – in the evolving network of Wikibase platforms. Users will be allowed to create Q-Numbers for infants who died right after birth on FactGrid, and the GND and Wikidata will be free to decide under their criteria of notability and relevance, whether they would like to use our information – information they can now quote as original research from the FactGrid platform (with the detailed information of the projects behind this research).

Whilst the GND is CCO and free to be copied, the open joint venture with the German National Library aims to bring transparency into the data input. The more transparency we can bring into all the design decisions in this early stage, the better the wikibase platforms we are heading towards, will eventually be able to communicate with each other.

Now a team has to be formed. The German National Library and the Gotha research institutions of the University of Erfurt will send members into the team. The question is: Will we be able to broaden this team? We should have experts from the Wikimedia communities on board – people who know Wikibase and Wikidata, people who are used to community work on a regular wiki.

  • We would like to attract people who know how to formulate SPARQL searches and who will be able to test data models and make suggestions for the improved data models we should use, in order to handle the massive data sets we are expecting.
  • We’re looking for Wikibase experts who know how to bring in tens of millions of records into a Wikibase installation, and who know how to interconnect these records with genealogical and geographical links.
  • We do not yet know how we will keep the FactGrid manageable with respect to the wave of doublets and name parallels we are facing: The GND has these name parallels in unprecedented numbers. We will have to find ways to quickly inform researchers whether a person they have found in a document is already on the FactGrid or whether they will have to create the item. The hunt for items to be merged will become a permanent issue and we do not yet know how to technically support a community on this collective quest.
  • We will create new and complex fields of expertise: Millions of personal data sets will come with career statements. The FactGrid will turn all these statements into Q-Items, which we will have to organise in order to allow sociological searches for instance. The FactGrid project on historical jobs and their evolution will be only one of these projects.
  • We need players with Wikipedia experience: Though we will restrict ourselves to clear name accounts, we widely invite users with professional to private ambition to join the platform with their projects – whether they are focused on private genealogy or on publicly funded historical research.
  • We will have to provide a simplified FactGrid user interface that will bypass the SPARQL QueryService and the mushrooming Wikibase input pages. Magnus Manske’s Reasonator might become our standard interface for regular users, who will access the FactGrid as if they are accessing library catalogues – through organsied input forms.
  • We will eventually need help with database maintenance. It is particularly unfortunate that our project is primarily the work of historians, who do not always have a keen eye on how to optimally supply this technology.

The FactGrid will grow – and it will offer plenty of space for people to develop their own projects within this growth.


Scan of the Memorandum of Understanding (in German)


More

  • Barbara Fischer & Jens Ohlig, “Neues Testfeld für Wikibase: Eine Bundesbehörde geht auf Expedition im Wikiversum.” 2019-05-09 at https://blog.wikimedia.de

Memorandum of Understanding zwischen der Universität Erfurt und der Deutschen Nationalbibliothek – das FactGrid wird in einem Gemeinschaftsprojekt auf GND-Daten aufgesetzt

English Version

Das FactGrid-Projekt steht vor zwölf Monaten neuer Herausforderungen: Mit ihren Unterschriften vom 15. und 25. März 2019 unterzeichneten der Präsident der Universität Erfurt, Prof. Dr. Walter Bauer-Wabnegg, und Dr. Elisabeth Niggemann als Generaldirektorin der Deutschen Nationalbibliothek in Frankfurt und Leipzig ein Memorandum of Understanding, das in großem Umfang GND-Daten ins FactGrid bringen soll – Daten zu mehreren Millionen Personen und Körperschaften. Noch ist nicht klar, aus welcher Datenquelle wir die Ortsinformationen einspielen werden, die wir zudem benötigen werden.

Für die FactGrid-Projektbeteiligten lag hier noch nach der ersten Berührung mit der Software das sich abzeichnende große Desiderat: Eine Wikibase-Instanz wird zum interessanteren Werkzeug, wenn sie Benutzern Recherchen abnimmt und Wissen anbietet, auf das Forschung unmittelbar aufbauen kann. Die GND stand im selben Moment als die Datenquelle im Raum, aus der die Geisteswissenschaften im deutschsprachigen Raum sich in jedem Fall zu bedienen hätten. Von einem GND-Input aus könnte man beliebig weiterdenken, mit dem Blick auf die Verzeichnisse deutscher Drucke oder auf komplementäre internationale Normdaten.

Klar wurde im April 2018, der Europeana Workshop in Antwerpen war hier eine Wegscheide, dass soeben allerorten erste unabhängige Wikibase-Instanzen entstanden; sie würden im optimalen Fall eine „Föderation“ anstreben. Die Deutsche Nationalbibliothek würde, so der Informationsstand nur zwei Monate später, eigene Wikibase-Instanzen aufbauen — erst einmal in einer Software-Evaluation. Das FactGrid-Projekt stand damit vor Entscheidungen: Entweder setzten wir auf eine Plattform, die sich spezialisierte und noch im Frühstadium isolierte und nutzten GND-Daten nur für uns oder wir riskierten eine Ressource, die sich im Verlauf zwischen der GND und Wikidata als Plattform für „Original Research“ anbieten kann. Unser spezielles Angebot lässt sich benennen: Wir werden nicht die GND- oder Wikidata-Relevanzkriterien übernehmen. Bei uns wird man Datensätzen zu Säuglingen anlegen können, die nach der Geburt verstarben, um ein klareres Bild von Säuglingssterblichkeit im historischen Längsschnitt zu gewinnen. Wir werden der GND und Wikidata im selben Moment anbieten können, nach ihren eigenen Relevanzkriterien Informationen von uns zu beziehen — Informationen, die wir als Forschungsbeiträge zitierbar machen.

In welche technische Lösungen sich das übersetzen wird, sprich: wie Wikibase-Instanzen in Zukunft miteinander kommunizieren werden, ist noch offen. Jetzt jedoch schon können wir eine Instanz zur Verfügung stellen, auf der sich die GND in einer Wikibase-Version bearbeiten lassen wird.

Eine solche GND-Version gemeinsam mit der Deutschen Nationalbibliothek zur Verfügung zu stellen, hat vor allem den Zweck, Erfahrungen dabei unter allen Beteiligten verfügbar zu machen. Von der Transparenz der Design-Entscheidungen wird abhängen, wie gut die hier entstehenden Instanzen später miteinander kommunizieren werden.

Ein Team wird jetzt zu sammeln sein — aus den beteiligten Institutionen der Deutschen Nationalbibliothek und der Gothaer Forschungseinrichtungen der Universität Erfurt und, hier soll das unten publizierte Memorandum of Understanding Klarheiten schaffen, aus den Commmunities des Wikimedia-Umfelde, die mit Wikibase und mit Wikis im Moment entschieden vertrauter sind als wir.

  • Wir suchen SPARQL-Bewanderte, die Datenmodelle austesten und Vorschläge für geschicktere Datenkonfigurationen machen werden, mit denen man die auf uns zukommenden großen Informationsmengen intuitiv und fruchtbar handhaben wird.
  • Wir suchen Wikibase-Kenner, die wissen, wie man Mengen von mehreren Millionen Datensätzen in eine Wikibase-Instanz hineinbringt, und diese Datensätze dabei mit genealogischen und räumlichen Vernetzungen durchdringt.
  • Uns fehlt Expertise darin, wie wir das FactGrid in der Woge der Doubletten und Namensgleichheiten handhabbar halten, die nun auf uns zurollt: Die GND birgt Namensgleichheiten in bislang nicht dagewesenem Maße. Wir werden Wege finden müssen, wie man Forschenden in diesem Meer schnell Überblick gibt, ob die Person, die sie in einem Dokument genannt finden, schon über einen Datensatz verfügt oder neu angelegt werden muss. Die Doublettenfahndung wird zum Dauerthema werden, und wir wissen im Moment noch nicht, wie wir sie auf eine interessierte Community ausrichten und diese dabei technisch unterstützen.
  • Eigene diffizile Fachgebiete werden bei uns entstehen: In Millionen der GND-Personeneinträge finden sich Berufsangaben; bei uns wird aus jeder solchen Angabe ein Datenbankobjekt werden, zu dem nun eigene Aussagen zu machen sind. Wir werden hier Fachleute in verschiedensten Gebieten anziehen müssen, die derartige Felder zu durchdringen und zu erschließen wissen.
  • Wir brauchen Mitspieler, die schlicht Community-Erfahrung haben: Das FactGrid visiert die breite Nutzung an, auch wenn wir dabei auf die Verwendung von Klarnamen setzen. Im gelingenden Fall wird das FactGrid in den Wikipedia-Geschichtsprojekten beliebt werden und Accounts an Universitäten, in Bibliotheken und Archiven vergeben. Lokale Geschichtsvereine und Internet-Genealogie-Projekte sollten an der entstehenden Ressource mit ihren komplexen Vernetzungsangeboten Interesse gewinnen.
  • Wir werden das FactGrid mit einer Benutzeroberfläche ausstatten müssen, die technische Laien am SPARQL-QueryService und an den wuchernden Wikibase Eingabeseiten vorbeiführt. Suchmasken, die vermutlich direkt auf Seiten unseres (im Moment noch nicht sonderlich gut funktionierenden) Reasonator-Angebots führen, das Benutzer in beliebigen Sprachen mit strukturierten Datenblättern bedienen wird, könnten der Zielpunkt sein.
  • Wir werden schließlich Hilfe in der Datenbank-Betreuung benötigen. Hier ist ganz besonders misslich, dass unser Projekt im Moment vor allem die Arbeit von Geschichtsfachleuten ist, die nicht in jedem Moment bereits im Blick haben, wie sie die Technik optimal beliefern.

Das FactGrid wird wachsen und Mitspieler brauchen, die in diesem Wachstum vor allem Raum für ihre ganz eigene Projekte entdecken werden.

Mehr

  • Barbara Fischer & Jens Ohlig, “Neues Testfeld für Wikibase: Eine Bundesbehörde geht auf Expedition im Wikiversum.” 9. Mai 2019 at https://blog.wikimedia.de

Nachfolgend der Text der getroffenen Vereinbarung:


Memorandum of Understanding

zwischen

Deutsche Nationalbibliothek, vertreten durch die Generaldirektorin, Frau Dr. Elisabeth Niggemann
Adickesallee 1
60322 Frankfurt am Main

Universität Erfurt, vertreten durch den Präsidenten, Herrn Prof. Dr. Walter Bauer-Wabnegg
Nordhäuser Straße 63
99089 Erfurt

ausführende Einrichtungen:

Forschungszentrum Gotha der Universität Erfurt
Schlossberg 2
99867 Gotha
im Folgenden: FZG

Forschungsbibliothek Gotha der Universität Erfurt
Schloss Friedenstein
99867 Gotha
im Folgenden: FBG

Präambel

Die Deutsche Nationalbibliothek hat die Aufgabe, lückenlos alle deutschen und deutschsprachigen Publikationen, Tonträger und Musikalien (einschließlich Netzpublikationen und digitaler Objekte) ab 1913, im Ausland erscheinende Germanica und Übersetzungen deutschsprachiger Werke sowie die zwischen 1933 und 1945 erschienenen Werke deutschsprachiger Emigranten zu sammeln, dauerhaft zu archivieren, bibliografisch zu verzeichnen sowie der Öffentlichkeit zur Verfügung zu stellen.

Die FBG und das FZG sind zentrale wissenschaftliche Einrichtungen der Universität Erfurt. In ihrer Arbeit sind sie auf der einen Seite auf die Gothaer Bestände ausgerichtet; über ihre Stipendienprogramme und Forschungsprojekte, mit Schwerpunkten in der Erforschung der Frühen Neuzeit und der Globalisierung des 19. Jahrhunderts, andererseits international aktiv.

Die nachfolgenden Vereinbarungen betreffen die vom FZG initiierte und vom Universitätsrechen- und Medienzentrum der Universität Erfurt unter der URL https://database.factgrid.de gehostete Wikibase-Instanz, die seit dem August 2017 in einer Kooperation zwischen dem FZG und Wikimedia Deutschland aufgebaut wurde, um historischer Forschung insbesondere im Interesse an der internationalen Zusammenarbeit wissenschaftlicher Projekte zur Verfügung zu stehen.

Dies vorangestellt, treffen die DNB und die Universität Erfurt folgende Absichtserklärung:

§ 1 Gemeinsame Vorstellungen

Wikibase, die für Wikidata genutzte Software, soll sich in Zukunft zu einem funktionsfähigen Werkzeug für Wissenschaftler und wissenschaftliche Projekte entwickeln, mit dem in eigenen Installationen Daten offen und kollaborativ geteilt werden können.

Die gemeinfreien Daten der Gemeinsamen Normdatei (GND) – speziell die Daten für Personen und Körperschaften – sollen hierzu in der bestehenden Installation die Datengrundlage bieten, die es Wissenschaftlern erlaubt, Informationen in der Datenbank zu verknüpfen und anzureichern.

Für die GND liegt hierin ein erster Testfall einer größeren Datenintegration in eine Wikibase Instanz. Größere Aufgabenfelder werden im Rahmen dieser Vereinbarung im Blick zu halten sein: Wie lässt sich eine Wikibase Instanz in einen kontinuierlichen Datenabgleich mit Schwesterprojekten bzw. anderen Wikibase Instanzen bringen? Wie lassen sich etablierte Nutzungen der GND auf Seiten von Anwendern und Recherchierenden in neuer Systemumgebung realisieren?

§ 2 Gemeinsame Ziele

Die Partner wollen – im Rahmen ihrer Ressourcen und Möglichkeiten – im Erfahrungsaustausch miteinander die bestehende FactGrid Wikibase-Instanz mit Personen- und Körperschaftsdaten der GND befüllen.

Folgendes soll in diesem Projekt umgesetzt und evaluiert werden:

  1. Import von GND-Datensätzen in die (Factgrid-)Wikibase-Instanz
  2. Anforderungserhebung zur Synchronisation von Daten verschiedener Wikibase-Instanzen
  3. Anforderungserhebung für das Retrieval
  4. Evaluation bestehender Werkzeuge zur Qualitätssicherung und zur Präsentation der Daten
  5. Dokumentation der Projektarbeit und der Evaluationsergebnisse

§ 3 Aktivitäten

Zusammenarbeit

Die Partner stellen ein Team zusammen, das sich im ersten halben Jahr nach Vereinbarungsabschluss mindestens alle sechs Wochen in Treffen und Video-Konferenzen koordiniert und Aufgaben unter sich aufteilt.

Bis zum März 2019 streben sie die Erstellung eines Arbeitsplans mit Aufgabenverteilungen an.

Die DNB erhält Zugriff auf die Datenbank und administrative Benutzer-Accounts im FactGrid.

Die Partner dokumentieren im Blick auf spätere Datenbankverbindungen zu Wikidata und eventuellen DNB-Wikibase-Instanzen ihre Designentscheidungen und Arbeitserfahrungen.

Kommunikation

Die DNB und das FZG/FBG benennen einander je einen Ansprechpartner für alle im Rahmen der Zusammenarbeit abzustimmenden Angelegenheiten. Die Beteiligten sorgen dafür, dass sie sich regelmäßig gegenseitig über Vorhaben und Projekte in den gemeinsamen Arbeitsbereichen informieren.

Die Partner nutzen die ihnen zur Verfügung stehenden Kommunikationskanäle, um die Öffentlichkeit und ihre Communities über gemeinsame Aktivitäten zu informieren. Kommunikation nach außen, die das gemeinsame Vorhaben betrifft, wird vor Veröffentlichung immer zwischen den Partnern abgestimmt.

Für die Außenkommunikation räumen sich die Partner wechselseitig das nicht-ausschließliche, zeitlich auf die Laufzeit dieser Vereinbarung begrenzte und nur mit vorheriger Zustimmung übertragbare Recht ein, die von dem jeweils anderen Partner zur Verfügung gestellten Logos-, Namens-, Bild- oder Markenrechte zum Zwecke der Durchführung der vorliegenden gemeinsamen Ziele zu nutzen; dies gilt nur, soweit dies rechtlich zulässig ist und keine Rechte Dritter entgegenstehen. Die für die vereinbarten Zwecke benötigten Materialien, Abbildungen etc. werden kostenfrei vom jeweiligen Partner zur Verfügung gestellt. Die Partner verpflichten sich, die graphischen Gestaltungsvorgaben des jeweils anderen zu erfüllen.

§ 4 Dauer

Diese Vereinbarung tritt mit ihrer Unterzeichnung in Kraft. Sie gilt zunächst für 12 Monate und kann danach jederzeit unter Einhaltung einer Frist von 30 Tagen zum Ende eines Kalendervierteljahres einseitig gekündigt oder im beiderseitigen Einvernehmen vorzeitig beendet werden.

§ 5 Sonstiges

Durch diese Vereinbarung entstehen der DNB und der Universität Erfurt keine finanziellen Verpflichtungen. Die Partner stellen jeweils die auf ihrer Seite notwendigen Personal- und Sachleistungen zur Verfügung und tragen die ihnen dadurch entstehenden Kosten selbst. Wechselseitige Schadensersatzansprüche sind ausgeschlossen. Bei Ansprüchen Dritter haftet der Verursachende allein und ausschließlich.

Frankfurt am Main,
den 25.03.2019
Dr. Elisabeth Niggemann
Erfurt,
den 15. MRZ. 2019
Prof. Dr. Walter Bauer-Wabnegg


Scan der originalen Vereinbarung

„Archivführer zur deutschen Kolonialzeit“ online – ein Gespräch mit Uwe Jung, FH Potsdam, über den Einsatz von Wikidata als Forschungsplattform

Google translate English Version

Uwe Jung ist wissenschaftlicher Mitarbeiter beim Projekt “Quellen zur deutschen Kolonialzeit” an der Fachhochschule Potsdam. Die Beta-Version des Archivführers geht dieser Tage online. Im folgenden Interview geht es u.a. um die Frage, welche Rolle Wikidata im Projekt spielt.

Olaf Simons: Wir sprachen im vergangenen Sommer miteinander über die Möglichkeiten, Wikibase in Forschungsprojekten und bei der Präsentation von Forschungsarbeit einzusetzen, und tauschten uns dabei über verschiedene Optionen aus. Mit Ihrem Projekt gehen Sie soeben online. Worum geht es darin?

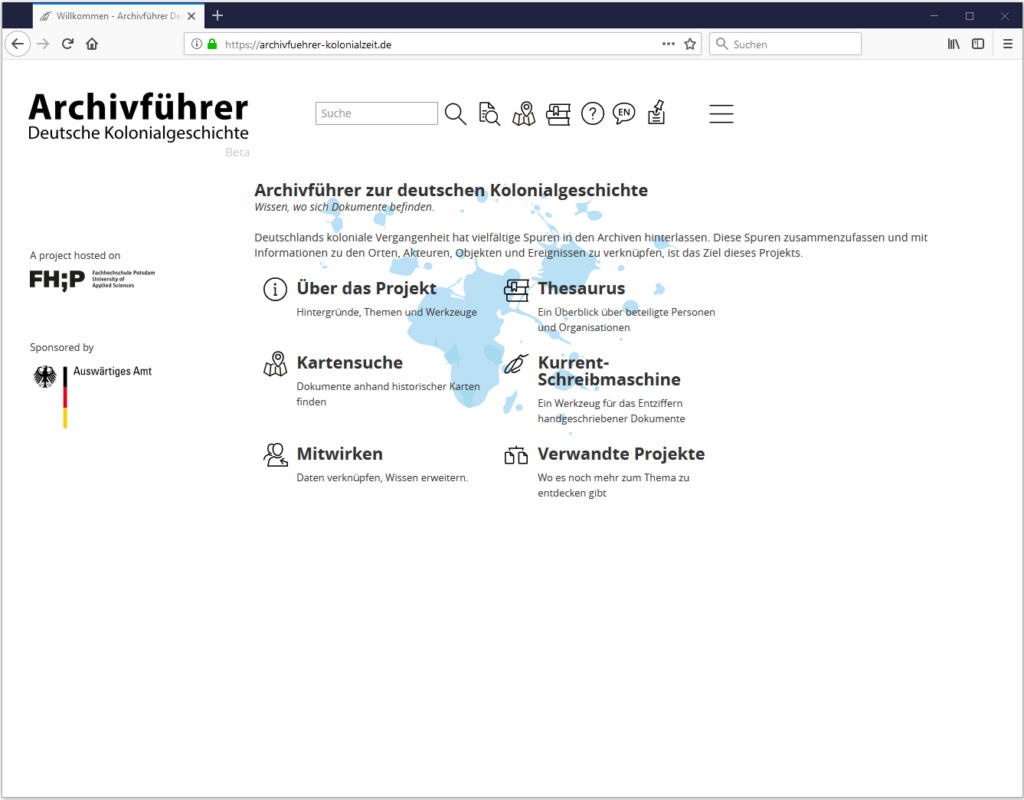
Uwe Jung: Deutschlands koloniale Vergangenheit hat vielfältige Spuren in den Archiven hinterlassen. Im Projekt “Archivführer zur Deutschen Kolonialgeschichte” https://archivfuehrer-kolonialzeit.de/ geht es darum, diese Spuren zusammenzufassen und mit Informationen zu den Orten, Akteuren und Ereignissen zu verknüpfen. Dabei kommt der freien Datenbank Wikidata eine zentrale Rolle zu.


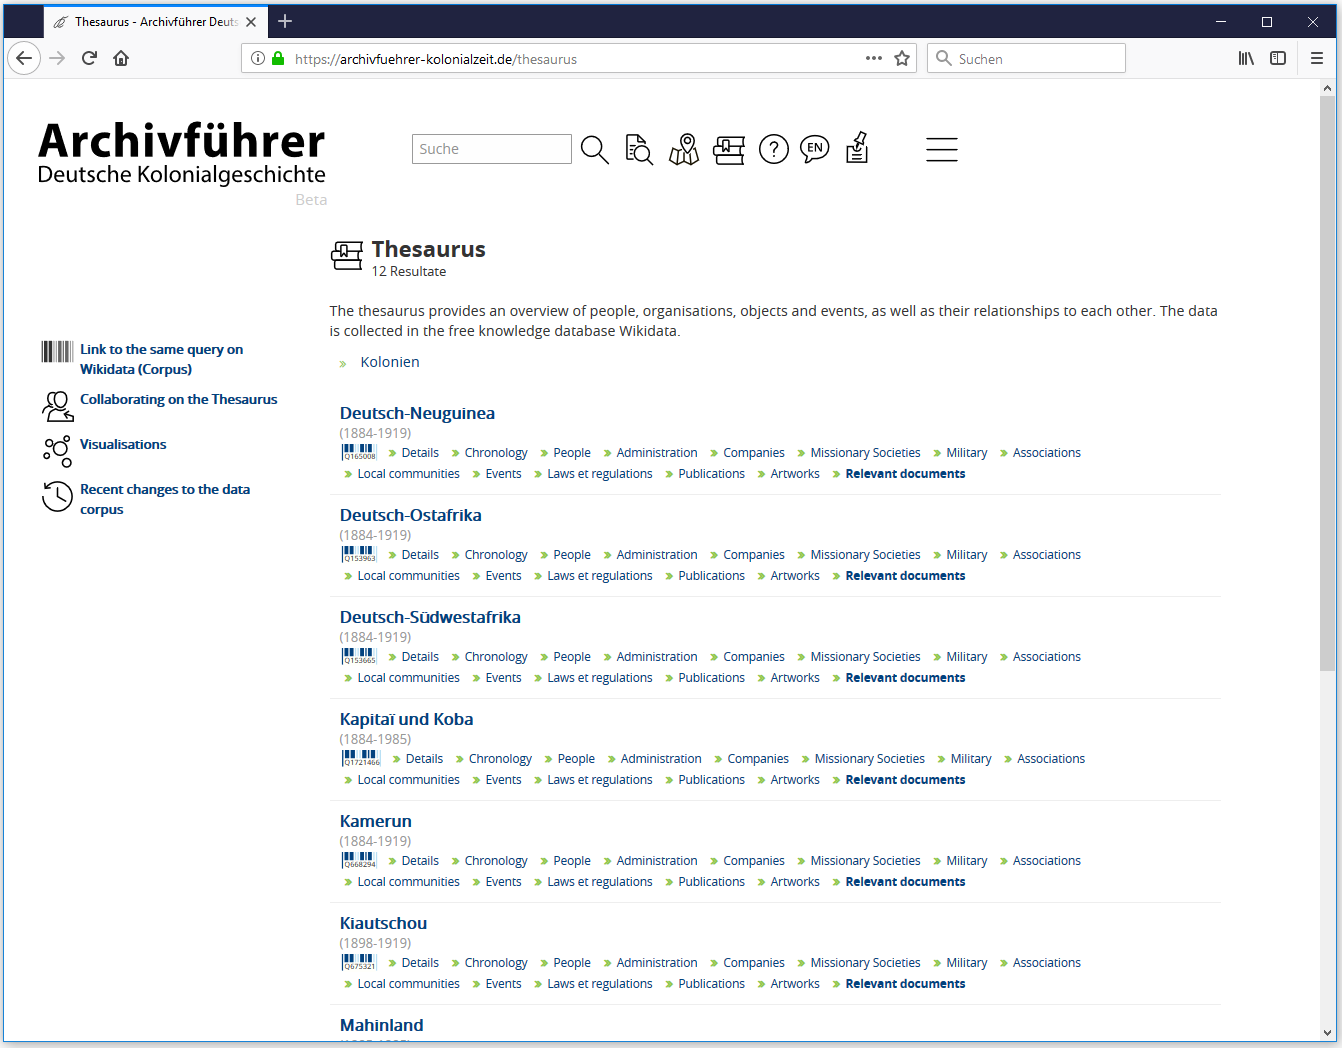
Screenshot der Startseite https://archivfuehrer-kolonialzeit.de/

Olaf Simons: Das Projekt läuft an der Fachhochschule Potsdam?

Uwe Jung: Ja, das Projekt ist dort am Fachbereich Informationswissenschaften angesiedelt. Es wird zum größten Teil vom Auswärtigen Amt finanziert.

Olaf Simons: Sie entschlossen sich schon in der Antragsphase auf eine Realisierung mit Wikidata als Datenbank zu setzen – war das mutig? und was gab die Idee dazu?

Uwe Jung: Ich denke, mehrere Punkte haben dazu beigetragen. Zum einen war mir Wikidata bereits vorher bekannt. Persönlich unterstütze ich die freie Zugänglichmachung von Wissen. Die verschiedenen Wikimedia-Projekte sind hierfür sicher ein zentraler Ort. Zum anderen wurde mir aufgrund meiner beruflichen Erfahrung in Kamerun klar, dass es in den Nachfolgestaaten der deutschen Kolonien andere Prioritäten bei der Beschäftigung mit der gemeinsamen Geschichte gibt. Wir haben das Problem, dass Thesauri und Vokabulare in Europa häufig nur einen europäischen Blick auf diese Geschichte werfen. Das fängt bei der Schreibweise von Namen und Orten an. Viel wichtiger ist aber noch die Tatsache, dass z.B. in der Gemeinsamen Normdatei, an sich ein sehr gutes Werkzeug, in der Regel nur Entitäten auftauchen, die entweder selbst veröffentlicht haben oder über die zentral in einem Werk berichtet wird. Das Vokabular selbst wird in Europa verfasst, also weitgehend unter Ausschluss der “anderen” Seite.

Wikidata bietet nunmehr die Möglichkeit, gemeinsam an einem Vokabular zu arbeiten und ganz nebenbei auch noch das Thema “Kolonialgeschichte” in einen historischen Gesamtzusammenhang zu stellen.

Olaf Simons: Das ist, nebenbei, unser aktuelles Projekt: die gesamte GND – Personen und Körperschaften in unsere Instanz importieren und, soll ich sagen: sie öffnen? In jedem Fall sie benutzen und sie veränderbar machen – gemeinsam mit der GND, denn dort sieht man die Problemstellen nicht minder.

Wie sieht in Ihrem Projekt das Verhältnis von Projektarbeit und Mitarbeit der Öffentlichkeit aus? (Das ist in unseren Projekten ein zentraler Punkt: wir sind es die darin einen Großteil der Erschließungsarbeit in Teams oder in der Forschung Einzelner leisten).

Uwe Jung: Was die praktische Erfahrung betrifft, stehen wir noch am Anfang. Die Arbeit an der Seite selbst und das Zusammentragen von archivischen Beschreibungen hatten bisher Vorrang. Geplant ist, dass über eine thematische Wikimedia User Group zukünftig die Arbeit zum Thema Kolonialgeschichte koordiniert werden soll. Dabei lassen wir uns von folgenden Überlegungen leiten: Erstens basiert die Partizipation der Öffentlichkeit meistens auf freiwilliger Basis. Es kann also niemand gezwungen werden. Besser ist es, die Leute dort abzuholen, wo sie sich zu Hause fühlen. In ihrem jeweiligen Teilthema. Zweitens gibt es bereits viele Personen, welche in verschiedenen Wikimedia-Projekten sich mit Teilaspekten des Themas beschäftigt haben. Die Wikimedia User Group würde also lediglich auf Vorhandenem aufbauen. Das dann jedoch zum Vorteil aller. Wie gesagt, es geht hier nicht nur um Wikidata, sondern auch um Wikipedia, Wikisource und andere Projekte. Für Wikidata ist jetzt mit dem WikiProject “European Colonialism” ein Anfang gesetzt.

Olaf Simons: Bei der Arbeit über die Kontinente hinweg dürfte die Mehrsprachigkeit von Wikidata interessant werden. Wie wird die Software in Afrika angenommen?

Uwe Jung: Ich habe den Eindruck, dass es für die Leute einfacher ist, Fakten miteinander zu verknüpfen, als längere Texte in einem enzyklopädischen Stil zu verfassen. Vorausgesetzt, die Zuordnung der Properties ist klar. Wir sollten nicht vergessen, dass die Art und Weise, wie Lexika verfasst sind, keine universell gültige ist.

Olaf Simons: Keine universell gültige – und auch keine besonders neutrale, ist doch in unserem Kulturraum die Tatsache, dass man eines Lexikon-Eintrags “würdig” wird, so etwas wie der bildungsbürgerliche Ausweis von persönlicher sozialer Bedeutung geworden…

Unser eigenes Projekt ging aus eigenen Debatte mit Leuten des Wikidata-Projektes hervor; sie ermutigten uns, eine eigene Instanz aufzumachen. Ein wichtiges Argument war dabei, dass wir im externen Bereich sozusagen als “Incubator for Original Research” agieren können – als eine Seite, auf der es möglich wird, Dinge zu konstatieren, die noch nicht veröffentlicht sind, und die von hier aus erst zitierbar werden.

Gibt es in Eurem Projekt an dieser Stelle Grenzen, wo Ihr das Gefühl habt, das würden wir gerne mit der öffentlichen Ressource Wikidata tun, aber könnten wir so eigentlich nur auf einer eigenen Ressource riskieren?

Uwe Jung: Nein, die sehe ich nicht. Koloniale Geschichte wirkt bis heute täglich nach. Sie ist ein Politikum und sie wird von vielen Seiten aus betrachtet und interpretiert. Wir sind uns im Projekt darüber bewusst, dass eine Vollständigkeit und Unveränderbarkeit der Daten nicht erreicht werden kann. Das gilt sowohl für die archivischen Beschreibungen als auch für die “Norm”-Daten. Es soll keine “Bibel” werden, sondern vielmehr Hinweise auf derzeit noch verborgene Informationen und Zusammenhänge geben. Aufzeigen, was alles zum Thema gehört und wie weit es in die verschiedenen Sphären der damaligen und heutigen Gesellschaften hinein reicht.

Olaf Simons: Eine solche Problemstelle sind in unserem letzten Projekt die Dokumente, über die wir arbeiten – Akten, die wir zwar zitieren und transkribieren dürfen, die jedoch ansonsten nur eingeschränkt öffentlich zugänglich sind. Es wäre eigenartig, für diese Objekte so einfach Wikidata-Items zu eröffnen. Ein zweites Problem ist, dass wir die Datenbank als Arbeitswerkzeug benutzen, gerade auch um etwa Datierungen einfach einmal versuchsweise zu setzen und dann zu sehen, wie eine solche Entscheidung in der Arbeit aufgeht.

Woher kommen bei Euch die Dokumente? Ich sah beim Probeblick in den Internet-Auftritt, dass Dokumente eine wichtige Rolle spielen.

Uwe Jung: Das wäre in der Tat eigenartig. Zwar ließen sich in Wikidata auch archivierte Dokumente beschreiben, doch sind diese Beschreibungen selbst wohl besser bei den besitzenden Einrichtungen aufgehoben. Etwas anderes ist die Anreicherung von Daten zum besseren Verständnis der Dokumente. Diese neu hinzukommenden Daten stehen aber für sich selbst und brauchen nicht zwangsläufig mit einem bestimmten Dokument verknüpft zu werden. Vielmehr bieten das Datenmodell und die implementierten Tools von Wikidata die Möglichkeit, diese Daten mit vielen anderen Beschreibungen zu verknüpfen, z.B. Publikationen, Denkmäler, Museumsobjekte, Geschichten, Kochrezepte u.s.w.


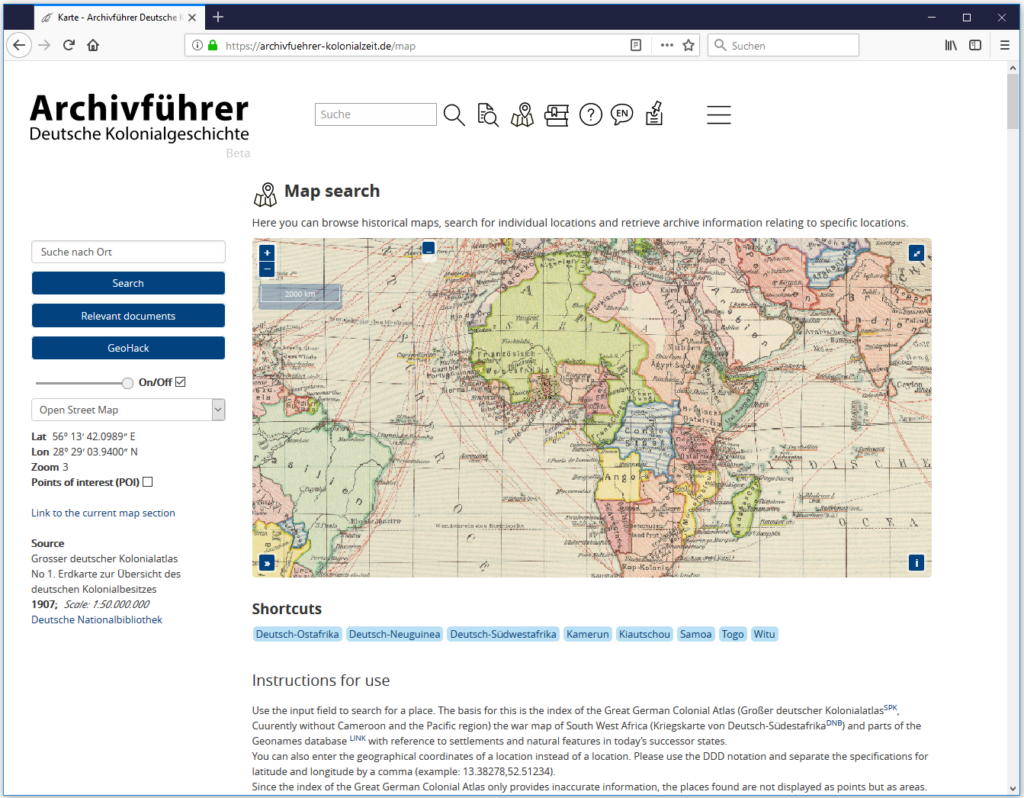
Der Kartenbrowser https://archivfuehrer-kolonialzeit.de/map

Olaf Simons: Euer Webauftritt hat sich seit dem Juni sehr verändert. Was bietet Ihr wem?

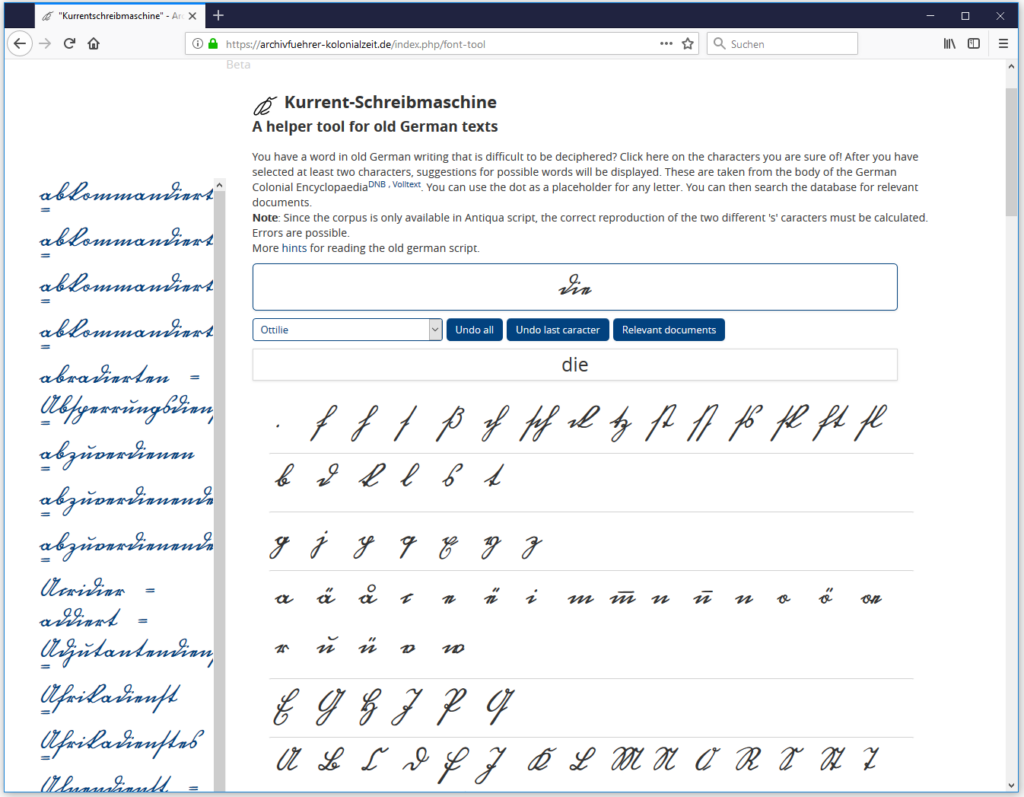
Uwe Jung: Es ist wichtig, die unterschiedliche Herangehensweise beim Publikum im Blick zu behalten. Deshalb gibt es zum Beispiel mehrere Sucheinstiege. Neben “Suchschlitz”, Facettensuche und erweiterter Suche kann auch ein Einstieg über die Normdaten erfolgen. Zusätzlich gibt es den Einstieg über den Thesaurus, welcher de facto ein Set von Wikidata-Abfragen darstellt. Und einen historischen Kartenbrowser, welcher wiederum mit einem historischem geografischen Index verknüpft ist. Eine weitere Besonderheit ist die “Kurrentschreibmaschine”, ein Werkzeug, das beim Lesen von alten Texten helfen soll.


Screenshot der Kurrentschreibmaschine

Olaf Simons: “Archivportal zur deutschen Kolonialgeschichte, Wissen, wo sich Dokumente befinden. Deutschlands koloniale Vergangenheit hat vielfältige Spuren in den Archiven hinterlassen. Diese Spuren zusammenzufassen und mit Informationen zu den Orten, Akteuren und Ereignissen zu verknüpfen, ist das Ziel dieses Projekts.” steht auf der Startseite. Ihr versucht, zu erfassen, wo es überhaupt Dokumente zur deutschen Kolonialgeschichte gibt. Wie geht Ihr dabei mit den Archivkatalogen und den größeren Verbundkatalogen (etwa dem Arcinsys) um, die ja ihre Archivalien gar nicht alle in Wikidata anmelden?

Uwe Jung: Auch wenn sich eventuell noch etwas am Einleitungstext ändern wird, die Intention bleibt gleich. Archivkataloge sind sicher ein Thema für sich. Auch hier basiert vieles auf der Freiwilligkeit. Eine große Hilfe sind die Deutsche Digitale Bibliothek bzw. das Archivportal-D. Viele Einrichtungen sind dort bereits vertreten und ermöglichen auch die Übernahmen von Metadaten. Ähnliches gilt für den Kalliope-Verbund. Einige Archive, wie z.B. das Bundesarchiv, stellen die Daten ihrer Bestände komplett als Open Data zum Download zur Verfügung. Von anderen haben wir die Daten in isolierter Form erhalten und konvertiert. Wiederum bei anderen Einrichtungen haben wir die Daten zunächst aus deren Online-Katalog gezogen und dann abgesprochen, was davon übernommen werden kann. Nicht zu vergessen ist, dass die Landschaft sehr heterogen ist und sich “Archivalien” letztendlich überall befinden können. Nicht nur in Archiven. Die Besucher/innen wiederum dürften wahrscheinlich eher daran interessiert sein, alles zusammen geliefert zu bekommen. Also Publikationen, Archivalien, Museumsobjekte, Debatten, usw.

Olaf Simons: Sicher auch zu recht. – Technisch gesehen habt Ihr eine Benutzeroberfläche aufgebaut, die Suchanfragen an Wikidata weitergibt – und an weitere Kataloge? (oder ist Wikidata hier das Nadelöhr, über das Ihr auf weitere Kataloge zugreift?

Uwe Jung: Hier muss unterschieden werden. Wikidata wird von uns in verschiedenen Zusammenhängen benutzt. Zum einen in Form des Thesaurus auf der Webseite. Diese Übersicht basiert direkt auf Wikidata-Abfragen und dient der allgemeinen Information sowie als ein Sucheinstieg in die Datenbank innerhalb des Portals.

Für die Auswahl, welche Daten aus den verschiedenen Online- und Offline-Katalogen übernommen werden, wird ebenfalls Wikidata benutzt. Hierzu gibt es eine zentrale Abfrage, die einen Korpus an Objekten zum Thema generiert. Die Labels und AlternateLabels aus diesem Ergebnis-Set dienen wiederum als Suchbegriffe für die Abfragen in den Katalogen. Ein Script sorgt dafür, dass allzu viel Noise (wie z.B. “Müller”) nicht übernommen wird. Dieses Script ist regelbasiert, da ein Rückgriff auf neuronale Netze keine befriedigenden Ergebnisse brachte.

Ein weiteres Mal wird Wikidata verwendet, um die zusammen mit den Beschreibungen importierten Normdaten der jeweiligen Einrichtungen zu vereinheitlichen. Die Normdaten werden über ihre Bezeichnungen mit existierenden Wikidata-Objekten verknüpft. Auch hier wird ein Großteil mit Skripten erledigt. Allerdings wird dann auch immer noch eine manuelle Kontrolle notwendig.

Olaf Simons: Visualisierungen sind mit einem eigenen Programmpunkt im Angebot…

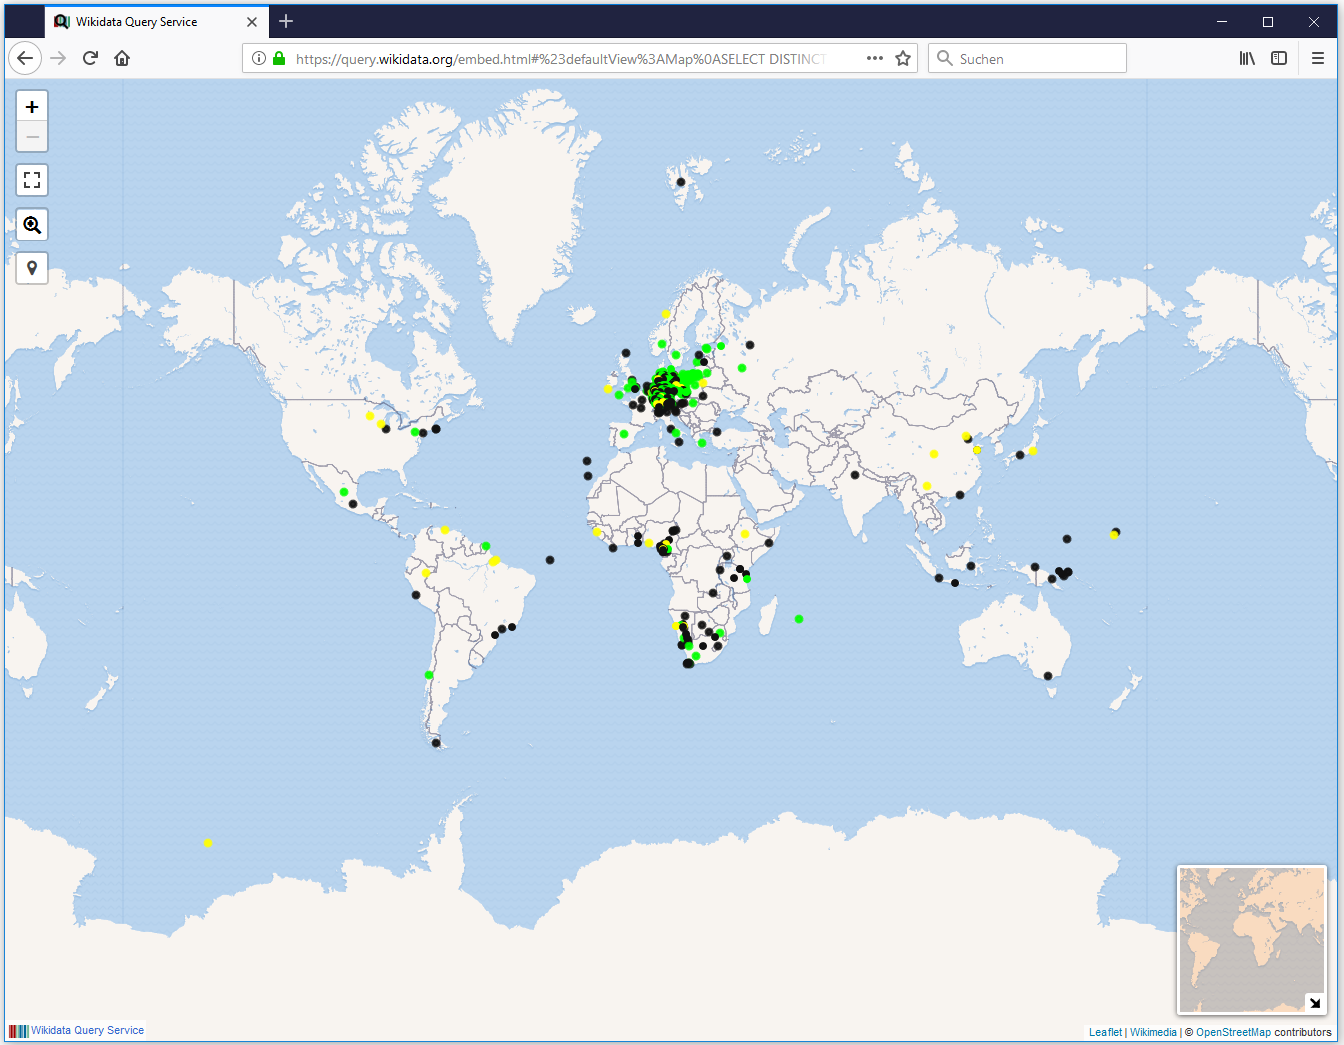
Uwe Jung: Ja, eine der Stärken von Wikidata ist die Möglichkeit, Beziehungen zu visualisieren. Wir nutzen hier u.a. den SPARQL-Endpoint mit seiner Möglichkeit auch Ausgaben  in Karten- oder Diagrammform zu generieren.

Wikidata Screenshot
Screenshot Wikidata-Abfrage: Geburts, Wirkungs- und Sterbeorte von Personen mit Bezug zum Thema deutsche Kolonialgeschichte

Olaf Simons: Davon, worauf Eure Seite zugreift, merkt man als Besucher, wenn man dann bei Ausgaben auf die “Datenquelle” sieht?


Schritte bei der Durchsuchung des Thesaurus – sukzessive Screesnhots

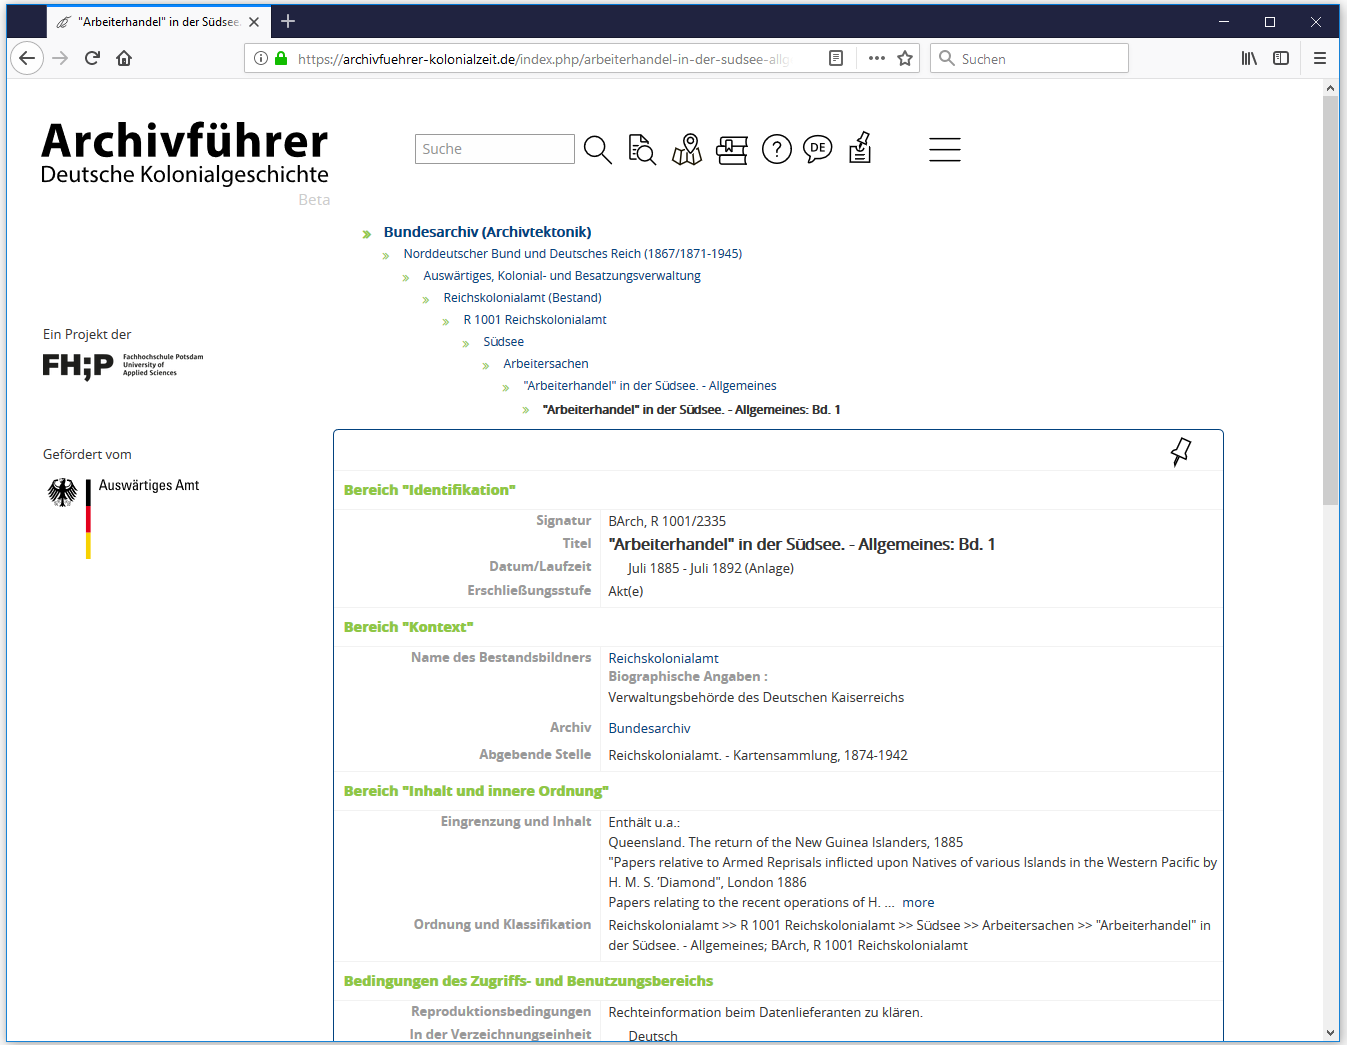
Uwe Jung: Sofern ein Link zur Webseite der besitzenden Einrichtung mit übernommen werden konnte, wird dieser eingeblendet. Mit etwas Glück geht es dann von dort aus zum Volltext weiter. Leider gibt es aber auch noch Online-Kataloge ohne Persistent Identifier bzw. Permanentlinks zu einzelnen Beschreibungen.

Die Beschreibungen selbst werden einmalig übernommen, automatisch übersetzt und in einer lokalen Datenbank gespeichert. Die Daten des Thesaurus werden direkt aus Wikidata eingespielt, lassen sich also jederzeit von Dritten ändern und hoffentlich auch erweitern. Ein weiteres Script sorgt dafür, dass wir Änderungen am Korpus während der letzten 7, 30 bzw. 90 Tage zurückverfolgen, um eventuell auf Vandalismus reagieren zu können. Das alles spielt sich dann aber in Wikidata ab.

Olaf Simons: Und ist in Java-Script Interaktionen mit den Datenanbietern organisiert?

Uwe Jung: Nein, das wäre zu aufwändig. Wir verweisen darauf, dass Daten auf deren Webseiten aktueller und vollständiger sein können.

Olaf Simons: Ich meine Euer Angebot – wie ist das technisch gestrickt und woher hattet Ihr die Expertise, so etwas zu stemmen?

Uwe Jung: Die “Expertise” beantwortet gerade diese Frage 😉 Ich habe Afrikanistik mit der Spezialisierung Geschichte studiert. Hinzu kamen noch ein Studium in Bibliotheks- und Informationswissenschaften, Erfahrungen in der Auswärtigen Kultur- und Bildungspolitik und diverse IT-Kenntnisse. Vieles musste nebenbei noch gelernt werden, schließlich ändern sich Technologien ständig. Eine sehr große Hilfe sind dabei die diversen offenen Technologien. Für die gibt es im Netz viel Unterstützung und Anleitungen. Und man ist unabhängig von Service-Verträgen proprietärer Softwareanbieter.

Technisch basiert das Portal auf der freien Archivsoftware AtoM, die wiederum auf einem Ubuntu-Server agiert. Die Datenimporte und deren Weiterverarbeitung erfolgen hauptsächlich durch Python-Skripte. Für die Präsentation helfen Javascript zusammen mit den Frameworks jQuery und OpenLayer. Für die Georeferenzierung und Kachelung der Karten wurde QGIS mit den Plugins Georeferencer und QTiles benutzt.

Olaf Simons: Gut, Wir sollten Sie mal ausleihen ;).

Uwe Jung: Ab 2020 gerne 😉

Olaf Simons: An welcher Stelle des Webauftritts wird die Chance zum Zuge kommen, den Benutzer selbst die Datensätze verändern zu lassen, oder eigene Datensätze einzuspeisen? Wikidata ist ja gerade hier als interaktive Software interessant. Aus der Startseite geht das Interaktive nicht klar hervor…

Uwe Jung: An der Startseite wird sich bis zum Start noch einiges ändern. Im Portal selbst wird es keine gespeicherten benutzergenerierten Inhalte geben. Hierfür müssten zuvor diverse datenschutzrechtliche Dinge beachtet werden. Der Aufwand wäre zu hoch. Die eigentliche Interaktivität ist in der anzustrebenden Wikimedia User Group zu suchen. Vollständigere Daten im Wikidata-Korpus führen automatisch zu einem besseren Thesaurus im Portal. Außerdem ist es schwer, freiwillige Mitarbeit zu bekommen, wenn die Ergebnisse dieser Mitarbeit nicht unmittelbar und für alle zugänglich sind. Das Portal ist quasi nur ein Auszug aus (in der Mehrheit) bereits öffentlich einsehbaren Daten, welche rund um ein Thema gefiltert werden. Und selbst dieser Filter kann aufgrund der Vielschichtigkeit des Themas niemals fehlerfrei die Spreu vom Weizen trennen. Für die Zukunft wäre zu wünschen, dass sich ähnliche Portale zu anderen Themen mit weniger Aufwand herstellen lassen.

Nur um einen Einblick in die Vielfalt zu geben. Diverse Hauptverantwortliche der mörderischen Schlachten des ersten Weltkriegs waren zuvor einige Zeit in den Kolonien tätig. Zu nicht Wenigen davon gibt es verzeichnete Nachlässe. In den Kolonien waren Ingenieure tätig, zu deren Arbeiten es Pläne gibt. Das gleiche gilt für Naturwissenschaftler*innen und Mediziner. Diverse Künstler haben sich am Thema versucht oder waren gar vor Ort. Und über allen saßen Beamte mit ihren täglichen Problemen, die versucht haben, das Ganze zu verwalten. Unter anderem auch, damit einige Unternehmen und Missionen vor Ort tätig werden konnten. Schließlich spielte die Anti-Kolonialfrage spätestens ab 1919 eine wichtige Rolle in Systemauseinandersetzungen zwischen Ost und West. Sie finden also nüchterne amtliche Berichte neben wissenschaftlichen Abhandlungen, Gemälde neben Kartenwerken und Urlaubsfotos neben dem Ernst-Thälmann-Lied in Duala-Übersetzung.

Was jedoch klar wird, die deutsche Kolonialgeschichte lässt sich nicht auf einige herausragende historische Ereignisse bzw. auf einen reinen militärisch-politischen Aspekt reduzieren. Sie ist kein fest eingegrenztes Teilstück der deutschen Geschichte, welches sich bei Bedarf ausklammern lässt. Sie lässt sich eher mit einer Vielzahl von Flecken vergleichen, die zu einer nur scheinbar weißen Wand mit dazu gehören.

Olaf Simons: Vielen Dank für die Einblicke und das Interview.

Uwe Jung: Gern geschehen 😉


Bildquelle Featured Image: Uniformierung der Schutztruppe für Deutsch-Ostafrika (Brockhaus 1892), Dateiquelle Wikimedia Commons.

Nachklapp zur ersten GNDCon der Deutschen Nationalbibliothek, Frankfurt am Main, 3./4. Dezember 2018

Die Tickets für die erste große – vom 3. auf den 4. Dezember 2018 an der Frankfurter Nationalbibliothek veranstaltete – GNDCon waren Monate zuvor restlos vergeben. Um die 300 Interessenten füllten schließlich den großen Saal der Adickesallee 1 mit seiner Empore und am Rande aufgestellten Stehtischen: Bibliotheksrepräsentanten, Informatiker, die an Museen und in Archiven im deutschsprachigen Raum Datenbanken betreuen, Geisteswissenschaftler aus den Digital Humanities aller möglichen Projekte. Schließlich sollte es um nicht weniger als die „Öffnung der GND“, der Gemeinsamen Normdaten gehen, mit denen die Deutsche Nationalbibliothek Kultureinrichtungen im gesamten deutschsprachigen Raum und weltweit versorgt. CC0, frei lizenziert, sind sie schon seit längerem, doch das soll erst der Beginn der Öffnung sein.

Die anwesende Forschung war angereist zum guten Teil mit dem Willen aufzubegehren: Man sollte drauf dringen, in Zukunft höhere Rechte erhalten als das bescheidene, Vorschläge zu neuen Einträgen und zu dringenden Korrekturen machen zu dürfen. Bibliothekare äußerten sich unter der Spannung eines auf sie zurollenden Softwareumbruchs. Wer auch immer von der „Öffnung der GND“ redete, hatte womöglich noch kaum verstanden, wie die GND ihre Autorität bislang verteidigte. Für Wikidata sollte die Veranstaltung zu einer eigenartigen Geburtstagsfeier werden: Sechs Jahre waren vergangen und Wikidata war, anders als die Wikipedien zuvor, nach diesem sehr kurzen Spurt in der Lage, unter den globalen Normdatenanbietern mit Autorität zu punkten und mit der Software um die sich alles immer wieder drehte.

Durch das Programm führten Barbara Fischer und Jürgen Kett, erstere von Wikimedia an die DNB gewechselt. Internetkulturen mischten sich plötzlich mit ganz unerwartetem Charme.


Bildquelle: https://wiki.dnb.de/display/GNDCON2018/Bilder+%7C+GNDCon, Lizenz: Creative Commons unter Namensnennung, Weitergabe unter gleichen Bedingungen 2.5 Generic

Normdaten – Dreh- und Angelpunkte der Verständigung über die Dinge im Internet

Über die Normdaten organisieren sich mittlerweile die Katalogsysteme der Archive, Bibliotheken und Museen – und zunehmend auch Forschungsprojekte in den Digital Humanities.

Früher vermerkte jede Bibliothek, jedes Museum und jedes Forschungsprojekt für sich, von wem es soeben sprach; ob von „Thomas Mann“, dem Autor der Buddenbrooks, dem 1946 geborenen CDU-Politiker, dem zwanzig Jahre jüngeren Juristen oder von einem anderem der insgesamt 28 Träger dieses Namens, die die GND listet. Eindeutigkeit und Referenzdaten gewährleistet heute die GND-Nummer, an die sich alle Daten koppeln, über die die Trennungen verlaufen: biographische Eckdaten, geographische Informationen, Berufsbezeichnungen, zentrale Werkzuweisungen. Natürlich sollte Forschung der Digitalen Geisteswissenschaften sich der GND bei jedem Arbeitsschritt bedienen. Ein Projekt, das in Periodika der Weimarer Republik Autoren namentlich identifiziert, sollte diesen GND-Nummern zuweisen, wo immer solche bereits vorliegen, und so für spätere Auswertungen nachvollziehbar machen, wen genau man identifizierte. Es wäre im selben Moment praktisch, wenn das Projekt selbst GND-Nummern vergeben könnte. Am Ende erwartet man von der Deutschen Nationalbibliothek, dass sie die Forschung auswertet und neue Einträge generiert. Die Forschung weiß eigentlich am präzisesten, welche Datensätze sie soeben generieren möchte.

Im Rahmen des organisatorischen Verbunds, der die GND effektiv unter dem „DACH“ deutsch-österreichisch-schweizerischer Institutionen produziert, agieren in der GND eben darum längst schon Forscher mit eingeschränkten Editierrechten, mit Vorschlagsrechten – was indes eben immer noch weit entfernt bleibt von der Offenheit, mit der Wikidata jedem Nutzer erlaubt, Datensätze zu Personen und Werken anzulegen und Q-Nummern zu vergeben.

Die Eröffnungsvorträge der GNDCon folgten aufeinander wie zum Fanal abgestimmt. Harriet Aagaard, die Vertreterin der königlichen Bibliothek Schwedens, Vincent Boulet von der Bibliothéque Nationale de France und Jürgen Kett von der Deutschen Nationalbibliothek mit ihren Verschwisterungen nach Österreich und in die Schweiz verkündeten ihre Entscheidung, Wikidata in Zukunft als Brückenkopf im Informationsaustausch einzubeziehen. Darüber hinaus werde man prüfen, ob nicht Wikibase, die Software von Wikidata, die neue allgemeine Software im Bereich werden könne. Lydia Pintscher führte in Abrundung dieses Fanals in Wikidata ein. Spannung lag im Saal, da diese Weichenstellung verwirrende Unsicherheiten schafft: Wie vermittelt sich diese Entscheidungen der Bibliotheksleiter nach unten? Und: Was genau war hier den Forschern gesagt, die in der GND editieren wollen – dass sie besser gleich in Wikidata Datensätze erzeugten?

Wie Wikidata solches Gewicht gewann

Wikidata, der Startschuss zur Softwareentwicklung fiel erst 2012, begann mit dem Versuch, die Binnenverlinkung zwischen den gut 200 weltweit arbeitenden Wikipedien zu übernehmen – bis dahin hatten Wikipedianer sichergestellt, dass man über die „Interwiki-Links“ korrekt in Parallelartikel der anderen Sprachen gelenkt wurde. Wikidata weiß aus dieser Datenübernahme, in welchen Sprachen es einen „Thomas Mann“-Wikipedia-Artikel gibt und trennt die Artikel zum Lübecker Autor dabei mühelos von den Artikeln zu den anderen Namensträgern in allen Sprachen. Das allein wäre keine Revolution. Die kam mit der Entscheidung, die eigenen Identifikationen im nächsten Schritt mit allen wichtigeren Normdatensätzen weltweit zu verbinden. Wikidata wurde damit unvermerkt das Normdaten Repositorium, das den nationalen (und primär bibliothekarischen) Normdatenprojekten zueinander hilft: BNF-Mitarbeiter schlagen in Wikidata nach, welche GND-Datensätze den in der BNF identifizierten entsprechen. Doch wäre auch das vermutlich nur ein praktisches kleines Geschenk gewesen, wäre Wikidata nicht in jedem Moment dabei ganz anders aufgestellt gewesen: Wikidata kennt nicht nur alle Personen, die in irgendeiner Wikipedia einen Artikel haben, und kann dabei sagen, wo sich zwei Artikel auf dieselbe Person beziehen. Wikidata hat daneben auch Normdatensätze für Apfelsorten, Tische, Stühle und Bänke, ob namhafte Einzelstücke oder den Apfel, den Stuhl, den Tisch als solchem. Die Aussagen, die Wikidata in den Datensätzen macht, sind struktureller Natur: Wikidata erfasst (wie die DNB), dass Heinrich Mann Thomas Manns Bruder war. Anders als die GND-Datenbank weiß Wikidata jedoch zudem, sofern Wissen struktureller Natur ist, nicht nur nebenbei, was „Bruder“ auf Chinesisch oder Koreanisch heißt. „Bruder“, „Vater“, „Mutter“… sind in Wikidata selbst wieder Objekte mit Q-Nummern und mit Aussagen durch P-Nummern, die nun klären, was einen „Vater“ von einem „Bruder“ und einer „Mutter“ im Geflecht struktureller Aussagen zu nun Generation und Geschlecht unterscheidet – und hier wird im nächsten Zug wieder mit Q-Nummern und P-Aussagen definiert.

Die Normdatensätze der Bibliotheken sind, verglichen mit diesen Projekt, eng in ihrer vornehmlich nationalen Orientierung wie ihren Relevanzkriterien, die darauf abzielen, primär Autoren zu identifizieren und Schlagwortkataloge zu beliefern. Auf die Enzyklopädie aller Begriffe und Diskussionsgegenstände in allen Sprachen hatte es keine der Nationalbibliotheken abgesehen – Wikidata dagegen entspringt dieser globalen Enzyklopädie.

Wikibase: Eine Datenbank-Software für jedermann, die typische Bibliothekssoftware überraschend schlägt

Ich begriff am Vormittag des zweiten Tags klarer, warum man in der Deutschen Nationalbibliothek und eben nicht nur hier soeben über Wikibase nachdenkt. Interessierten war im Keller der Nationalbibliothek Zugriff auf eine Datenbankdoublette der GND eingeräumt.

Für den, der in Wikibase bereits Datensätze anlegte, ist die Software ein Schritt zurück in die 1990er Jahre: Die Benutzeroberfläche verlangt Einarbeitung. Jede Zeile eines Datensatzes eröffnet mit einer Nummer, der Ankündigung der nachfolgenden Aussage für den späteren Katalogeintrag. Hinter jeder Nummer muss Information in einer sehr speziellen Sprache abgelegt werden, um nachher korrekt ausgelesen zu werden. Man öffnet die begleitende Dokumentation im zweiten Browserfenster, sieht nach, welche Nummern etwa in einem Personendatensatz verwendet werden könnten und wie dabei die Eingabe zu geschehen hat – hier werden nicht Q-Nummern miteinander verbunden, hier wird vergleichsweise oft Text standardisiert eingegeben. Die Software arbeitet flach: Speichert man ab, wird der bisherige Datensatz überschrieben. Wikibase notiert dagegen, welche einzelne Aussage im Datensatz geändert oder hinzugefügt wurde und bietet Raum für Quellenangaben im Plural hinter jedem beliebigen Statement eines jeden Datensatzes. Die GND-Software ist zufrieden mit einer einzigen Quellenangabe für den ganzen Datensatz – und selbst die fehlt, wo immer man Daten aus vorhandenen Bibliotheksrepositorien übernahm.

Große Entscheidungen muss auch die DNB fällen und vorher diskutieren – die Diskussionen bleiben intern und außerhalb des Systems, wo in Wikidata ganz wie in den Wikipedien über alles öffentlich beraten, wenn nicht gestritten wird, was nachher Richtungsänderungen mit sich bringt.

Braucht man die Wikipedia-Öffentlichkeit in nationalen Bibliotheken? Und ist die Versionsverliebtheit der Wikibase-Software mit ihren Bearbeiterstempeln und Datierungen wie ihren „undo“-Aufforderungen mehr als eine nutzlose Anschwellung der Datenbank, die sich besser darauf konzentrierte, Fakten zu präsentieren?

Aus Sicht des Historikers ist die Antwort klar: Was heute erst einmal nach unnütz viel mehr Daten anmutet, wird in fünf Jahren von Laptops geleistet; und natürlich braucht man die Versionierung und die Quellen zu jedem einzelnen Statement. Es genügt nicht, irgendein Geburtsdatum zu kennen. Man sollte sagen können, woher dieses Datum bezogen ist. Und bei interessanten größeren Entscheidungen würde man gerne wissen, auf welcher Argumentation sie zustande kamen, um diese entweder übernehmen oder die Revision diskutieren zu können.

Die Autorität des Monopols

Die Autorität der nationalen Normdatenanbieter war bislang primär institutionell gewährleistet. Die deutsche Nationalbibliothek bietet das Geburtsdatum des Autors der Buddenbrooks, das jede Bibliothek übernehmen kann, weil eine Änderung (wenn sie denn unter einem neuen Befund nötig würde) eben der Nationalbibliothek gemeldet würde, um von hier aus in den vielen Katalogen zu erscheinen.

Den Scan der Geburtsurkunde benötigt die DNB dabei nicht. Wikidata würde ihn benötigen, die Datenbank, in der jeder Dahergelaufene Unsinn behaupten könnte, und die erst mit einem öffentlichen Quellenbeleg eine korrekte Information durchsetzen kann. Wikibase bietet die Nachweis-Aufforderung bis hin zur Option, einander widersprechende Daten mit den jeweiligen Quellen als genau solche divergierenden Daten verwalten zu können – eine extrem attraktive Option, da wir in der Datenüberlieferung oft nicht mehr haben, als einander widersprechende Quellen.

Eine neue GND-Software wird mindestens so leistungsfähig sein müssen wie Wikibase gegenwärtig ist. Sie wird in der Lage sein müssen, Nummern mehrsprachig zu belegen. Sie wird Edits einzeln versionieren können, um in Datensätzen jede einzelne Stellungnahme überprüfbar zu machen. Sie wird den Quellennachweis zu jeder Aussage einfordern und der Öffentlichkeit Einblick in Entscheidung gewähren, um mehr Sicherheit als Wikidata zu geben.

Wikibase ist frei lizenziert. Theoretisch könnte man die Software wohl so umprogrammieren, dass sie danach wesentliche Hierarchien in Bearbeitungsrechten aufweist, wie intransparente, „rein interne“ gegenüber öffentlich sichtbaren Bereichen. Praktisch wird der Schritt in Wikibase viel einfacher sein, wenn es gelingt, Instanzen in Kommunikation miteinander zu bringen. Man wird dann von der Nationalbibliothek aus mehrere Instanzen betreiben – öffentliche und weniger öffentliche und zwischen diesen die Richtungen im fortlaufenden Datenfluss autoritativ festlegen.

Dass Wikibase-Instanzen sich untereinander austauschen können, das Projekt von „Federated Wikibase Instances“, steht unabhängig davon in den Wikimedia Entwicklungsplänen.

Einigten die zentralen Normdatenanbieter sich global auf Softwarestandards, wäre man einen immensen Schritt weiter im Streben nach neuer Eindeutigkeit im weltweiten Datenaustausch. Gemeinsam mit Wikidata würden die alten Bibliotheken wieder Sicherheiten von Aussagen ins Netz bringen, härtere Aussagen als die der fuzzy Google searches, an die wir uns gewöhnten.

Und die Forschung?

In der GND zu editieren ist unter den gegenwärtigen Bedingungen für Forschungsprojekte nur bedingt attraktiv. Die Software ist unbefriedigend, doch natürlich wäre man gerne als Lieferant und Bezieher von GND-Nummern mit dabei, falls diese nicht soeben rapide an Wert verlieren. Im Moment sticht die GND – sobald man auf die nationale Ebene geht – Wikidata noch in der puren Quantität der Daten in den Kerngebieten aus; ein Rechenexempel aus Gothas Illuminaten-Projekt kann das verdeutlichen:

Zahl der nachgewiesenen Mitglieder im Illuminatenorden 1354 100%
Zahl der nachgewiesenen Illuminaten mit GND-Nummern 553 41%
Zahl der nachgewiesenen Illuminaten mit Wikidata-Nummern 191 14%

Die GND erfasst mehr historische Personen. Dass sie Studenten mit einer bibliotheksnotierten Dissertation beim Namen nennt, macht sie bei den Illuminaten überlegen; diese rekrutierten vornehmlich Studenten mit guten Karriereprognosen.

Im Zeitalter des freien Datenflusses hat ein solcher Vorsprung sein Verfallsdatum. Wikidata könnte die gesamte GND-Personenliste importieren (man mag ob der Doubletten, die man sich einhandeln würde, wie der fehlenden Vernetzung der Datensätze, vor einem solchen Import zurückschrecken). Die Masse Wikidata-nummerierter Personen bleibt im Gegenzug für die GND so uninteressant wie chinesische Lokalpolitiker, die Artikel in der Wikipedia ihrer Sprache haben. Die Überlegung lässt erahnen, von wo nach wo der Informationsfluss verlaufen wird: von den feinmaschigen vielen nationalen Datenbanken hin zu Wikidata.

Die Frage der „Relevanzkriterien“, die es bei der GND und weniger hart bei Wikidata gibt, ist am Ende die Frage, die für ganz eigene Forschungsplattformen spricht, denn die Forschung benötigt in letzter Konsequenz gänzlich offene Plattformen, auf denen man Datensätze bereits anlegen kann, wenn man erst noch sehen muss, ob sich mehr Dokumente zum Namen finden, über den man soeben stolperte. Ein Forschungsprojekt zum Bevölkerungsaufbau in frühneuzeitlichen Städten wird Datensätze für Säuglinge anlegen, die in den ersten zwei Lebensjahren verstarben – eine Erlaubnis, solche Personen einfügen zu dürfen, wird ein solches Forschungsprojekt von niemandem erbitten wollen. Was in der Forschung „relevant“ ist, darauf wetten Projekte kompetitiv in einer Zukunftsprognose: Was wichtige Forschung und damit relevante Information ist, das stellt sich dann heraus, wenn die Zitate der Arbeit beginnen und die Daten-Nutzung in Gang kommt, so die Spekulation jedes einzelnen Projekts.

Es ist dies der Grund, warum eine unabhängige Wikibase-Instanz mit den GND-Daten für die deutschsprachige Forschung so besonders spannend wäre – eine Plattform, die danach Schrittweise Datensätze anderer Nationen aufnähme.

Die große Kulturrevolution steht am Ende weniger für die GND oder Wikidata an, als für die Geisteswissenschaften, für deren bedeutendste Repräsentanten das Internet im Moment noch immer nicht viel mehr als ein grandioser Selbstbedienungsladen ist. Hier stellen, so die professorale Sicht, Großkonzerne wie Google gemeinsam mit Bibliotheken Hunderttausende von Büchern ins Netz, und hier schreiben fleißige namenlose Bienchen Wikipedia-Artikel, aus denen man mit copy & paste Informationen schnell mal eben beziehen kann, verblüffend verlässlich. Man selbst schreibt ein großes Buch und erwartet im Gegenzug mit dem Selbstverständnis des wissenschaftlich Publizierenden, dass die Leute aus dem Internet die eigene Arbeit geflissentlich beachten und noch aus den Fußnoten, die man setzte, die biographischen Richtigstellungen beziehen und korrekt in die Kataloge und Wikipedia-Artikel bringen. (Empört ist man, wenn die eigene Arbeit dabei nicht ordnungsgemäß zitiert wird; enttäuscht, wenn sie von denen im Internet unbeachtet bleibt.)

Die GND wird in der Transformation der Geisteswissenschaften, die hier noch immer ansteht, den interessantesten Impuls geben, wenn sie ihre Haltung zu den Wissenschaftlern wie zur eigenen Arbeit ändert. Es wird nötig werden, dass Wissenschaftler die Datenlage, die sie nutzen, unter der laufenden Arbeit in gesellschaftlicher Verantwortung in Stand halten – offen proklamiert. Sie benötigen dazu Plattformen, auf denen sie auch marginale Korrekturen von Daten noch als Forschungsbeiträge verbuchen können – sie ziehen es andernfalls vor, den persönlichen Wissensvorsprung auf dem privaten Rechner in Word-Dateien für sich und gegenüber den Kollegen zu behaupten, die ihre eigenen Word-Dateien mit bahnbrechenden Informationen für sich sorgsam hüten.

Die GND und Wikidata sind gegenwärtig in der einmaligen Lage, die Plattformen zur Verfügung stellen zu können, auf denen sich in Zukunft Wissen diskursiv – durch das Angebot des Belegs und der nachvollziehbaren Forschung – von der Flut der haltlosen bleibenden Behauptungen abgrenzt. Der Aufbau der neuen überlegenen, weil zitierbaren Ressourcen ist dabei derzeit noch gar nicht als Zentrum der Verantwortung der Geisteswissenschaften für das Wissen unserer Gesellschaften (wieder) in den Blick genommen.

Mehr Links

Wikidata x ConedaKOR: Ein Anwendungsbeispiel für den Bereich Digitale Kunstgeschichte

in diesem Blog Wikidata erklären zu wollen, würde wahrlich Q1373747 bedeuten. Daher will ich mich hier zu Beginn auf die Punkte beschränken, die mir entscheidend für die Beschäftigung mit Wikidata am Deutschen Forum für Kunstgeschichte Paris (DFK Paris) erscheinen.

Das Potenzial der frei bearbeitbaren, mehrsprachigen Wissensdatenbank Wikidata besteht nicht zuletzt darin, dass es nicht um Deutungen geht, vielmehr ist das Ziel, den Wissensstand zu einem definierten Zeitpunkt belegbar abzubilden. Das Modell von Wikidata weist eine enorme Flexibilität auf, ist entsprechend erweiterbar und die derzeit mehr als 50.000.000 Datensätze[1] stehen unter der CC0 1.0-Lizenz, womit sie frei von urheberrechtlichen und verwandten Schutzrechten sind. Neben der Lesbarkeit für Mensch und Maschine sind an den Objekten zahlreiche Identifikatoren aufgeführt, die in Datenbanken von externen Organisationen verwendet werden und – spätestens hier wird es für die Kunstgeschichte spannend – Wikidata führt mehr Kunstwerke auf, als z.B. die GND.

Ein Framework also, welches diverse Szenarien der Nachnutzung eröffnet – auch jenseits der Verwendung in Wikidata-Schwesterprojekten wie Wikipedia et al. – und vor dessen Hintergrund am DFK Paris der Gedanke aufkam, das oben beschriebene Potenzial für die eigenen Vorhaben zu nutzen.

Ausgangslage

Mit dem quelloffenen ConedaKOR[2] wird im DFK Paris eine graphbasierte Datenbanklösung genutzt, die das in der Fachwissenschaft relevante Beziehungsgeflecht zwischen Werken und ihren Kontexten abzubilden vermag. Die digitale Bildersammlung hat sich hierbei im Laufe der Zeit zu einer Wissensdatenbank und einem Instrument zur Vermittlung kunsthistorischer Kompetenzen weiterentwickelt. Die Software erfüllt in diesem Szenario sehr spezifische Anforderungen der kunsthistorischen Forschung, ohne jedoch als spezifische Anwendung konzipiert zu sein. Das Konzept einer modularen Softwarearchitektur erlaubt es, die Spezialisierung über Konfigurationsmöglichkeiten und einzelne kleinere Dienste zu erreichen. Das Datenmodell ist innerhalb der Applikation frei konfigurier- und erweiterbar, erlaubt sowohl die Kompatibilität mit einer Top-Level-Domäne (CIDOC CRM) als auch die lokale Ausprägung.[3] Ein rollen- und sammlungsbasiertes Rechtemanagement erlaubt hier die – in Verbundprojekten und institutsweiten Anwendungen so kritische – granulare Rechtekontrolle. Diese spezifische Konfiguration, Verwaltung und Betreuung (Datenmodellierung, Objekterschließung usw.) begründen das Bestehen und die Weiterentwicklung dieser lokalen Infrastrukturen als Komplement zu zentralen, generischen Werkzeugen oder Portalen.[4]

Überlegung

Aus der Beobachtung heraus, dass in vielen neu startenden, datenbankgestützten Projekten jedes Mal aufs Neue ein Grundstock bereits vorliegender Informationen angelegt wird (insbesondere Personen, Werke, Orte etc.), kann Wikidata eine Möglichkeit bieten, die begrenzten Ressourcen eines Projekts in die Erschließung neuer Informationen zu investieren. Aus demselben Grund kann sich der Einsatz von Wikidata als externe Datensammlung selbstverständlich auch für das Tagesgeschäft in kunsthistorischen Einrichtungen mit ihren zahlreichen Bilddatenbanken lohnen.
Es geht hierbei aber nicht nur um die einbahnstraßenhafte Nutzung der Daten aus Wikidata, denn die in den Instituten und Projekten erhobenen Informationen können auch wieder in den Wikidata-Bestand hineingeschrieben werden und kommen damit der Allgemeinheit, der Sichtbarkeit und dem Gedanken der Nachnutzung (= Nachhaltigkeit) zugute. Eine in der Tat verführerische Idee, wenn in der Kunstgeschichte nicht das zentrale Objekt der Untersuchung das Bild wäre, welches zugleich Gegenstand einer oft schwierigen Rechtelage ist. Und somit entsteht die Notwendigkeit, zumindest dort ein eigenes Repositorium für die Bilddaten zu betreiben, wo diese aus rechtlichen Gründen nicht gezeigt werden dürfen oder aus forschungsrelevanten Überlegungen heraus (z.B. bei Aufnahmen, die im Projektkontext noch auszuwerten sind) vorerst nicht gezeigt werden sollen. Aus diesem Dilemma heraus wurde daher am DFK Paris ein Workflow entwickelt, der die Verknüpfung lokaler Daten mit Wikidata ermöglicht.[5]

Umsetzung

Um diese angestrebte Kopplung bei größtmöglicher Kompatibilität und zugleich geringem Aufwand (Entwicklung und Anwendung) zu erreichen, wurde bei der Implementerung auf eine Browser-Erweiterung gesetzt. Verfügbar für Firefox und Chrome wird nach der Installation des Add-ons bei jedem Besuch einer Website nachgesehen, ob diese eine Wikidata-ID enthält[6]. Ist das der Fall, dann meldet die Extension, wenn eine korrespondierende Entität in der eigenen Datenbank vorhanden ist[7] und das a) Abbildungen dazu vorliegen, die bereits im Extension-Fenster als Vorschaubild erscheinen und im eigenen Repositorium angezeigt werden können oder b) es noch keine zugehörigen Abbildungen gibt und – falls verfügbar – nun ins eigene System hochgeladen werden können (s. Szenario 01 bzw. 02).

https://www.youtube.com/watch?v=A_lsGmYQF7w

Szenario 1


https://www.youtube.com/watch?v=QhfliHjsM9I

Szenario 2

Damit ist die Nutzung der Datenbasis in Wikidata möglich und die häufig rechtesensible Situation der Abbildungen wird bei diesem Vorgehen weiterhin im System der Nutzer*innen geklärt. Dieser Ablauf ermöglicht, dass neu erarbeitete Informationen, die in Wikidata abgelegt werden können, auch direkt dort hineingeschrieben werden. Damit erhält – wie oben bereits angedeutet – projektspezifisches kunsthistorisches Wissen Sichtbarkeit in Wikidata und kann darüber hinaus entsprechend nachgenutzt werden.

Konkret angewendet wurde dieses Vorgehen im DFK Paris zum Beispiel im Projekt „Wissenschaftliche Bearbeitung des Palais Beauharnais“, wo im Zusammenhang mit der Erstellung einer online recherchierbaren Version des vollständigen Inventars der Möbel, Bronzen, Gemälde und anderer Gegenstände des Palais Beauharnais zahlreiche Entitäten in Wikidata angelegt wurden[8].

Die Browser-Erweiterung ermöglicht aber auch die Übernahme von Wikidata-Inhalten in die eigene Datenbank. Wenn die zugehörige Entität einer entdeckten Wikidata-ID noch nicht im eigenen System vorhanden ist, bietet die Extension eine konfigurierbare Importmöglichkeit an (s. Szenario 03).

https://www.youtube.com/watch?v=lvvTN-6aYXw

Szenario 3

Bei diesem Import wird ferner nachgesehen, ob über Relationen zu verbindende Entitäten bereits in der eigenen Installation vorhanden sind und im positiven Fall werden diese Verbindungen zeitgleich angelegt. Im obigen Beispiel (Szenario 03) werden somit gleich Verknüpfungen zwischen dem Werk („Susanna and the Elders“), der aufbewahrenden Sammlung (Bayerische Staatsgemäldesammlungen) und dem Urheber (Albrecht Altdorfer) erzeugt.

Ausblick

Voraussetzung für das beschriebene Verfahren mit einer Forschungssoftware mit spezifischen Funktionalitäten und einem externen Datenbestand ist selbstverständlich die Bereitschaft, die Daten im Netz, in Wikidata, vorzuhalten, zu ergänzen und nicht mehr primär im eigenen Datenbanksystem. Damit ergeben sich – neben technisch zu berücksichtigenden Aspekten – natürlich Fragen, die u.a. die Redaktionshoheit betreffen. Welche neuen datenkuratorischen Wege sind zu gehen, welche Prozesse ergeben sich, wenn eine größere Gruppe an den Datensätzen mitschreibt? Hier könnte z.B. der in der Wikidata community diskutierte Ansatz der „signed statements“ interessant werden, womit Institutionen ihre Aussagen mit einem Label versehen könnten.[9]

Aber auch generell steht diese Kombination aus Forschungssoftware mit spezifischen Funktionalitäten, sowie einem externen Datenbestand, beispielhaft für eine flexible und wissenschaftsgetriebene Nutzung digitaler Infrastrukturen, deren Services sich bedarfsspezifisch zusammensetzen. Ein derart modularer Aufbau dürfte zukünftig wichtiger werden, als monolithische Virtuelle Forschungsumgebungen. Im Falle von Drittmittelprojekten ist allerdings noch zu diskutieren, wie erarbeitete Daten gegenüber der jeweiligen Förderinstitution klar ausgewiesen werden können, wenn diese Arbeit im großen Ganzen von Wikidata aufgegangen ist?

Sicher ist, dass – neben einem zweckmäßige(re)n Einsatz von Ressourcen – auf diesem Weg eine Reduzierung der isolierten Datenbestände einer Fachdomäne erfolgen kann, wie sie derzeit als Datensilos eben immer noch als (ein) Ergebnis von zeitlich begrenzten Vorhaben zurückbleiben und die Förderung des freien Zugangs zu den Kultur- und Forschungsdaten in maschinenlesbarer und standardisierter Form gestärkt werden kann.

——————————————-

[1] Siehe hierzu: https://www.wikidata.org/wiki/Wikidata:Statistics

[2] ConedaKOR: https://github.com/coneda/kor und https://coneda.net.

[3] Vgl. Sven Peter: Abbildung relationaler Daten auf die Ontologie des CIDOC CRM, 2015, DOI: https://doi.org/10.11588/artdok.00003454.

[4] Der technische Betrieb dieser webbasierten Anwendungen vor Ort erfordert Ressourcen und Kompetenzen, die vielen Projekten und Instituten nicht zur Verfügung stehen. Als Antwort auf dieses Szenario wurde ConedaKOR daher in Kooperation mit DARIAH-DE (https://de.dariah.eu/en/) zu einem „Software-as-a-Service“-Modell weiterentwickelt und steht als erste community-driven Software über DARIAH-DE zur Verfügung.

[5] In der Folge bezieht sich die Darstellung auf eine ConedaKOR-Installation, aber die hier beschriebene Erweiterung ließe sich auch für andere Datenbanksysteme entwickeln.

[6] Die Extension reagiert auf Wikidata-IDs einer Website – die nicht nur auf Wikidata-Seiten vorhanden sein müssen – und somit zum Beispiel auch beim Browsen auf Wikipedia.

[7] Dazu muss eine zugehörige Wikidata-ID im eigenen System abgelegt sein. Alternativ auch andere Identifier, über welche die Wikidata-IDs importiert werden können.

[8] Öffentlich zugängliche Online-Version des Katalogs unter: https://dfk-paris.org/de/WissenschaftlicheBearbeitungdesPalaisBeauharnais/Datenbank.html

[9] https://phabricator.wikimedia.org/T138708

2017-12-1/2: Erster FactGrid Workshop in Berlin: Ergebnisse

Das Treffen begann mit wechselseitigen Vorstellungen von Wikidata und dem Illuminatenprojekt (mehr zu Wikidata hier, mehr zum Projekt die Illuminatenakten online zu bringen: hier), eine Etherpad Seite dokumentiert, was an Links in der Runde durchgegangen wurde.

Hier die wichtigsten Überlegungen und Ergebnisse:

1| Das FactGrid muss vorbefüllt werden, insbesondere mit bibliographischer Information

In einer Demonstration korrigierten wir das Todesdatum zu August Bohse (Q760965). Die Korrektur selbst war einfach, die Quellenangabe jedoch umständlich und unbefriedigend: Das Bearbeitungsfeld akzeptiert entweder eine URL (hier hätte man das Google Books-Link angeben können) oder ein bereits bestehendes Wikidata Objekt mit seiner Q-Nummer. Das Datenbank-Objekt zu generieren, war mühselig. Das Ergebnis war zudem ohne viel weiteren Nutzen: Man wird das zitierte Buch so nicht in zukünftigen Buchrecherchen wiederfinden. Bibliothekskataloge nehmen Titel weit komplexer auf, ohne dass man Benutzern diese komplexen Eingaben indes zumuten will.

Das Fazit aus dieser Demonstration war: Wir benötigen im FactGrid eine Vorabfüllung, so dass Forschende hier bereits bestehende Objekte in Beziehung miteinander setzen. Das FactGrid sollte bereits eine breite Basis an

  1. Wikidata-Objekten
  2. GND-Objekten
  3. Bibliographischer Information (namentlich der Nationalkatalogen für die frühe Neuzeit: VD16-VD18, ESTC, STCN aufweisen

Man wird erstens nachdenken müssen, wie man für die historische Datenbank auswählt (das menschliche Genom, das in Wikidata vollständig sequenziert erfasst ist, ist uninteressant, auch will man eher unglückliche Informationsangebote aus der neuen Datenbank heraushalten – man benötigt jedoch etwa zu Personen Grunddaten, um sie eindeutig identifizieren zu können). Man wird zweitens nachdenken müssen, wie man bei der Zusammenführung von Wikidata und GND-Informationen mit Doubletten umgeht.

2| Benötigt: Schicke (spielerische) Werkzeuge zur Ausmerzung von Doubletten

Das Problem taucht beim Anlegen bruchstückhafter Datensätze wieder auf – etwa wenn man aus einem Besucherbuch Namen abschreibt, von denen man nur weiß, dass sie zu einem genannten Zeitpunkt am genannten Ort sich so auswiesen.

Die Lösung wird ein Tool sein, dass Wahrscheinlichkeiten misst. Wie wahrscheinlich ist es, dass zwei Personen selben Namens am selben Tag und in der selben Stadt geboren wurden – und dann etwa auch noch das Sterbedatum und den Sterbeort teilen. Vermutlich kann man bei einer Zusammenführung von Daten automatische von Doubletten riskieren, wenn man dabei die statistische Wahrscheinlichkeit der Identität greifbar macht.

Attraktiv wäre ein Tool, das erwägt, wer wer sein könnte: Bei wem liegt die tentative Information im Bereich der Lebensspanne? Wer ist dagegen auszuschließen, da er an diesem Tag ein Alibi hat? Man kann dann massenweise aus Kirchenbüchern Namen und Daten notieren, Objekte anlegen und später das System nach Vorschlägen der Identifikation befragen.

3| Forschungsprojekten in der Ressource Raum bieten, die eigene Arbeit zu präsentieren

Demonstrationen verschiedener Tools machten klar, dass es bereits wunderbare Anwendungen gibt, die den Rang ganzer wissenschaftlicher Projekte haben könnten. Daniel Mietchen zeigte die Genealogie seiner Doktorväter bis um 1500 zurück:

Screenshot from https://tools.wmflabs.org/scholia/author/Q20895785 / enlarge

Die Entwicklungsrichtung, für die wir uns nach den Demonstrationen entschieden, ist es, vorwiegend mit der Datenbank zu arbeiten und Projekten dabei die Chance selektiver Präsentationen zu geben. Wir werden dafür eine Art Tagging einführen, mit dem Projekte Dokumente und Personen oder (Zeit–)räume ihres Interesses ausmachen können, um dann spezifische Suchangebote innerhalb eines abgesteckten Geländes machen zu können.

4| SQID und Reasonator

Die Entscheidung das „Illuminatenwiki“ langfristig aufzulösen, fiel insbesondere im Blick auf den Reasonator und SQID: Hier die Vergleichsseiten zu Johann Sebastian Bach in den Wikidata-Präsentationen durch beide beide Tools.

Beide Tools lassen sich parallel anbieten und werden einen ähnlichen Entwicklungsbedarf aufwerfen. Beim Umgang mit Dokumenten hätten wir gerne die Scans, Transkripte und Übersetzungen auf denselben Seiten. Eine typische Seite zu einer Quelle ist aus der Gotha Illuminati Research Base diese zu Schwedenkiste Band 13, Dokument SK13-070.

Elegant wäre, es zweispaltig Digitalisate neben Transkriptionen setzen zu können (und die Software für das Editieren zu öffnen). Elegant wäre es, wenn Benutzer zudem hier Übersetzungen anfertigen könnten.

5| Der FactGrid Quellen-Nachweis

Ausgiebig diskutierten wir das Schema des FactGrid Quellennachweises, wie es sich hier als Diskussionsvorschlag findet: Faktenbelege, die “Original Research” zulassen.

Prinzipiell sollte dieses Schema es Forschern erlauben, Befunde erstmals im FactGrid zu präsentieren und dabei selbst Arbeitshypothesen als solche handhaben zu können. Das Ziel ist nicht die Ressource, die ausschließlich mit solider Information bestückt wird, sondern ein Forschungshilfsmittel, das man etwa mit Personenlisten aus Dokumenten befüllen kann, um später zu sehen, welche Aussagen sich dazu machen lassen.

5| CC0 oder CC BY 4.0

Die Lizenz für das Factgrid sollte bislang CC BY 4.0 sein – jeder darf Informationen beliebig verwenden, muss sie aber wie verlangt zitieren. Das ist die wissenschaftliche Praxis, und das Zitat kann in diesem Fall nicht einfach „FactGrid“ lauten, es muss die Forscher nennen, die im FactGrid auf den Befund verwiesen.

Gegen die CC BY 4.0 spricht, dass sie bei einer Föderation mit Wikidata und dortiger CCo Lizenz ein Lizenzgefälle erzeugt, auch dass sich bei vielen Tools am Ende nicht das erwünschte Zitat mitliefern lassen wird: Wo sollen bei einer Visualisierung die Angaben zu den Forschern erscheinen? Fordert man sie ein, verhindert man die Visualisierungen.

Die pragmatische Alternative könnte lauten, dass wir uns auf CC0 einlassen, aber

  • eine best practice Information geben: Dort, wo einzelne Informationen etwa zu einem Todesdatum von uns zitiert werden, stellt ein eigenes Zitierlink zusammen, wie wir das Datum wissenschaftlich zitieren würden. Das ist gerade für uns selbst attraktiv: Wir können dann von hier aus in eigenen Artikeln Fußnoten beziehen.
  • mit Wikidata eine Vereinbarung treffen, wie wir dort Informationen unserer Arbeit zitiert sehen wollen
  • auf eine technische Lösung hinarbeiten, die es Benutzern in Wikipedia leicht macht, ganze Fußnoten zu Informationen von uns zu beziehen – bislang werden Todesdaten etwa regulär ohne Quellenangaben gehandhabt.

6| Die Daten der Schwedenkiste-Excel-Liste in Triple verwandeln

Wir gingen diese Liste spaltenweise durch. Es sollte kein Problem sein, die Tripel zu den gelisteten Dokumenten zu formulieren. Etwas Anpassungsarbeit wird nötig, um etwa nicht mehr vorhandene Dokumente zudem einzeln führen zu können. Die Schwedenkiste enthält Seiten jeweils mehreren Entwürfen von Briefen, die selbst nicht mehr überliefert, aber von hier aus einzeln rekonstruierbar sind.

Matti Blume und Olaf Simons wollen sich am 11.12. in Berlin für das Datenmodell und die Anpassung der Excel-Liste treffen.

7| Zeitschnitte

Spannend wäre es, wenn man im FactGrid historische Situationen darstellbar machen könnte. Der Artikel zu Gotha wird in diesem Fall nach gewünschtem Zeitraum zusammengestellt mit Informationen, die Zeitraum-gerecht arrangiert werden. Gotha hat um 1800 etwa 12.000 Einwohner, es gehört nicht zur BRD sondern ist Residenzstadt im Herzogtum Sachsen-Gotha-Altenburg und so fort.

Eine Website, die Zeitschnitte recherchierbar macht, wäre ein denkbares Objekt für einen coding Wettbewerb.

8| Barcamp Open Science, Coding Da Vinci, Hackathon

Vom Berliner Workshop ging die Anregung aus, einen nächsten Workshop im Frühjahr – vielleicht Anfang März zu veranstalten und dabei absolvierte Arbeitsschritte zu besprechen. Unser Ziel sollte es im selben Moment sein, von hier aus Projekte für coding-events zu formulieren:

9| Koordination

2017-12-1/2: Erster FactGrid Workshop in den Räumen der Wikimedia Deutschland, Berlin: Planungsseite

Veranstaltungsort: Tempelhofer Ufer 23-24, 10963 Berlin
Zeit: Freitag, 1.12.2017, 13:00-18:00 und Samstag 2.12.2017, 9:00-13:00
Kartenansicht: https://www.openstreetmap.org/node/2551527703#map=18/52.49841/13.38068

Vom 1. auf den 2. Dezember 2017 veranstalten das Forschungszentrum Gotha und, gastgebend, Wikimedia Deutschland einen ersten gemeinsamen Workshop des FactGrid-Projektes in den Berliner Räumen der WMDE Geschäftsstelle.

Unser Ziel ist es, Wikidata-Entwickler, Wikidata-Begeisterte und Wissenschaftler, die die Software im FactGrid-Projekt in der Forschung zum Einsatz bringen wollen, zu einem ersten größeren Ideenaustausch zusammenzubringen.

  • Was würden (Geistes-)Wissenschaftler mit einer solchen Datenbanksoftware in Forschungsprojekten gerne bewerkstelligen können?
  • Was kann die Software bereits heute?
  • Was müsste man entwickeln?
  • Was sind Entwicklungen, die ohnehin von Wikimedia geplant sind?
  • Mit welchen gemeinsamen Projekten kann die Wikidata/Wikipedia-Community für eine Plattform gewonnen werden, die sich gezielt der “original research” im Geflecht der Wikimedia-Projekte anbieten soll?
  • Inwieweit kann das FactGrid Projekt bestehende Datenressourcen (Wikidata, GND, Sammlungen bibliographischer Daten etc.) konstruktiv nutzen?
  • Wie werden sich FactGrid-Daten in Wikidata nutzen lassen?

An der Software interessierte (Geistes-)Wissenschaftler sollen in den zwei Tagen die Gelegenheit finden, Akteure des Wikidata- und Wikipedia-Feldes näher kennenzulernen und Kontakte zu knüpfen für gemeinsame Projekte – und für Aufträge auf Werkvertragsbasis im anspruchsvolleren Fall, in dem die gemeinsame Software komplexere Aufgaben bewerkstelligen soll.

Generell Interessierte aus dem größeren Wikipedia Bereich sind herzlich eingeladen, mit uns darüber nachzudenken, welchen Raum ein von Wissenschaftlern initiiertes Projekte im größeren Feld der Wikimedia-Projekte gewinnen könnte.

Die eingehenderen Veranstaltungsinformationen werden hier und auf einer parallelen Wikimedia-Seite/Anmeldungen laufend aktualisiert.

Kontaktadressen:
Nicola Zeuner, nicola.zeuner@wikimedia.de
Olaf Simons, olaf.simons@pierre-marteau.com

Ablauf

    Freitag Nachmittag: Kennenlernen

  • Zugverbindung ab Gotha 8:35/ Erfurt 8:58, Berlin Hbf. 11:00
  • Eintreffen/ Mittagessen WAU Hallesches Ufer 32, 10963 Berlin bis 12:45
  • 13:00: Wikimedia Geschäftstelle. Wikidata Vorstellung: Was tut Wikidata im Zusammenspiel mit den Wikipedien? Was sollte man über die Software wissen? Was kann man mit der Software machen? Was wird mit ihr gemacht?
  • Im Lauf des Nachmittags: Projekte der verschiedenen Interessenten. Was für Daten steuern sie bei? Was für Interessen an Datenbankanwendungen haben sie?
  • Gemeinsames Abendessen in der Taverna Athene, Tempelhofer Ufer 12, 10963 Berlin.
  • Samstag Vormittag: Baustellen

  • Nachdenken über ersten vier Werkverträge: Datenimport (hier das Datenangebot des Illuminatenprojekts zur “Schwedenkiste”), Wiki-Integration, Eingabeschablonen, Know-How-Transfer: Hierzu eingehend die Blogposts zu Eingabeschablonen und und zum Ausweis von Original Research sowie die Serie Kopfzerbrechen.
  • Was lässt sich mit der bestehenden Software bereits sehr leicht realisieren?
  • Was müsste erst entwickelt werden? Wo liegen gemeinsame Interessen der Forscher und des Wikidata Teams?
  • Wer kann was? Wie gewinnen Forschungsprojekte Kontakte in die Wikidata Community zu Entwicklern, zu Know-How-Vermittlern, zu Interessierten aus der Wikipedia/Wikidata-Community, die bei bestimmten Forschungsprojekten durchaus gerne mitspielen würden
  • Gemeinsames Mittagessen in der Geschäftsstselle

Eine grundsätzliche Fragesammlung zur Inspiration gibt es auch hier.

Angekündigte Teilnehmer

  1. Lydia Pintscher, Wikimedia Deutschland
  2. Nicola Zeuner, Wikimedia Deutschland
  3. Jens Ohlig, Wikimedia Deutschland
  4. Matti Blume, Wikidata, Werkvertrag in der ersten Projektstufe
  5. Adrian Heine, Wikidata, Werkvertrag in der ersten Projektstufe
  6. Daniel Mietchen, Wikidata, Werkvertrag in der ersten Projektstufe
  7. Lucas Werkmeister, Wikidata, Werkvertrag in der ersten Projektstufe
  8. Olaf Simons, Forschungszentrum Gotha
  9. Markus Meumann, Forschungszentrum Gotha
  10. Erik Liebscher, Forschungszentrum Gotha
  11. Christian Wirkner, Forschungszentrum Gotha
  12. Hendrikje Carius, Forschungsbibliothek Gotha
  13. Daniel Burckhardt, Humboldt Universität, Berlin
  14. ChristianKl, Wikidata Community
Großer Raum der Wikimedia Geschäftsstelle – sieht heute anders aus, Christina Burger auf https://commons.wikimedia.org/wiki/File:Bierkiste_in_neuer_GS.jpg

Zwischenbericht nach erstem Gedankenaustausch

Nach dem ersten gemeinsamen Brainstorming zwischen Wikimedia-Vertretern und den Vertretern des Forschungszentrums aus dem bisherigen Illuminatenprojekt am 27. März 2017 in Berlin einige Konkretisierungen:

1| Können Wissenschaftler in der Kooperation mit Wikimedia mit einer Creative Commons Lizenzierung auskommen?

Ja. Bei wissenschaftlichen Büchern mag sie zwar ein Problem sein, da hier Übersetzungsrechte tangiert sind. Bei Veröffentlichungen von Fakten aus einer Datenbank ist CC3.0 jedoch durchaus komfortabel und das, was Wissenschaftler überhaupt bestenfalls erwarten können: Ihre Ergebnisse dürfen frei benutzt werden, solange sie, wie von ihnen vorgegeben, zitiert werden. Wikimedia kann zwar nicht garantieren, dass Nachnutzer diese Vereinbarung achten; das jedoch ist das generelle Problem aller wissenschaftlichen Arbeit.

Entscheidend wird an dieser Stelle sein, dass Datenbankeinträge, „original research“ als solche zitierbar machen. (Siehe hier eingehender zu Faktenbelegen, die Original Research” zulassen.)

Für Wikidata müsste es interessant sein, eine solche Zitation für “orginal research” zu bekommen. Im Idealfall müsste sie Fußnoten generieren können, die sich in Wikipedia-Artikeln hinter Informationen wie etwa Angaben von Geburts- und Sterbedaten setzen lassen.

2| Lässt sich die Kooperation bereits mit dem bisherigen Stand der Wikidata-Technik realisieren?

Soweit ersichtlich kann das Wikidata WikiBase in Kooperation mit dem Reasonator alles, was das FactGrid auf Anhieb leisten soll.

Die zentralen Schwierigkeiten liegen im Moment beim fehlenden Query-Service. Die WikiBase Technologie spielt zwar im Moment schon Informationen in die Wikipedia Info-Boxen ein. Sie kann dies jedoch nur, da sie hier Tabellen bedient, in denen Zeile um Zeile eine spezifische Frage gestellt ist, die einen einzelnen Datenbank-Eintrag einholt. (Wann ist Adam Weishaupt geboren? – Aus der Datenbank wird das Datum eingespielt.)

Was dagegen derzeit noch nicht so einfach funktioniert, ist die Datenbankabfrage, bei der Tabellen aus dem gesamten Bestand generiert werden.

Wir könnten so Listen generieren wie diese der Illuminati Research Base zu allen Dokumenten des 13. Bandes der Schwedenkiste – solange wir in einer Tabelle die 124 Dokumente benennen, zu denen sodann die eingehenden Informationen aus der Datenbank abgefragt werden. Wir könnten dagegen nicht das FactGrid beauftragen, selbstständig eine Liste zu finden – etwa indem in einem ersten Arbeitsgang alle “Korrespondenzen” ausfindig gemacht werden, und in dieser Menge die Teilmenge der mit dem Illuminatenorden verbundenen zu der (bislang von Hand gepflegten) Liste der Korrespondenz des Illuminatenordens zusammengesetzt wird.

Die Einrichtung des Query-Service steht in der Wikidata-Entwicklung auf dem Programm. Es wäre zu klären, wann hier die Realisierung anvisiert ist.

3| Das FactGrid als Projekt-Plattform und Anbieter von Datenbankfunktionen für unabhängig agierende Projekte – Architekturfragen

Die WikiBase Technologie ist darauf eingerichtet, mit Wikis im selben Netzwerk (besser noch auf demselben Server) zu kooperieren. Die freie Konnektivität soll in einem der zukünftigen Arbeitsschritte realisiert werden. Grundsätzlich sind beim Neuaufbau der Ressource zwei verschiedene Architekturen denkbar mit eigenen Vor- und Nachteilen:

(A) Das bisherige Wiki bleibt bestehen; auf seinen Seiten werden in Zukunft unvermerkt Daten aus dem FactGrid eingespielt – so wie Wikipedia Info-Boxen derzeit bereits Daten von Wikidata beziehen. Beide Ressourcen müssen dazu auf im selben Netzwerk laufen.
(B) Bei der Alternative übernimmt das FactGrid als WikiBase Installation alle Funktionen des bisherigen Wikis (das danach aufgelöst wird). Dabei ist denkbar, dass verschiedene Projekte in einem eigenen “Namensraum” des FactGrids ihre Repräsentanzen aufbauen, und dort jeweilige Befunde bündeln und kommentieren.

Die erste Lösung ist für das laufende Illuminaten-Wiki bequem, jedoch keine Einladung an andere Projekte (diese werden nicht auf dem Uni-Erfurt Server Wikis aufbauen).

Die zweite Variante schließt die erste nicht aus und wird interessanter mit einem klareren Konzept der Leistungen, die das FactGrid übernimmt. Unser bestehendes Wiki wird sich absehbar auflösen, wenn das FactGrid auch nur mit der Leistungsfähigkeit des Reasonators Informationsseiten produziert, schlicht da 99% unserer Seiten Dokumenten und Personen gelten oder Übersichten über Dokumente und Personen anbieten.

Schon eine Datenbank, die Wissenschaftler auch nur benutzen können, um beliebige Personeninformationen abzulegen, wird von breitem Interesse sein, da es mit ihr spannend wird, Fachkollegen zu finden, die in dieselben Personengeflechte eindringen und dieselben Namen mit ganz anderen Informationen aus ganz anderen Dokumenten versehen.

Die folgenden Projektschritte sind mit der jetzigen Software möglich:

  1. die Einrichtung des FactGrids als WikiBase Installation (ist bereits geschehen unter der url http://factgrid.eu/, zu überlegen ist jedoch, ob wir die Ressource erneut auf Erfurts Uni-Server aufsetzen, das hat Vorteile der Reputation und langfristigen Sicherung aber auch mögliche Nachteile der Offenheit für Projektpartner anderer Unis),
  2. die Integration des zentralen Bestands strukturierter Daten aus den bislang geführten Tabellen zur Schwedenkiste und zu den Mitgliedern des Illuminatenordens,
  3. das Erreichen einer Funktionalität, mit der das FactGrid zu Dokumenten und Personen Seiten von der Qualität erzeugt wie der Reasonator sie aus Wikidata erstellt,
  4. Beratung der Wissenschaftler, die Interesse haben, mit dem FactGrid zu arbeiten, wie sie eigenständig Daten in die Ressource füllen – über (a) einzulesende Listen und (b) Eingabeschablonen,

Mit den folgenden Punkten sind Features und Tools berührt, die zum Teil für Wikidata anvisiert sind, bei denen jedoch kein Terminplan besteht, der sofort in eine Kooperationsvereinbarung einfließen könnte:

  1. die Einrichtung eines Datentransfers vom FactGrid zu Wikidata, der Forschungsdaten am Ende für Wikipedia-Artikel zitierbar macht,
  2. die Einrichtung von Query-Services, mit denen die Datenbank sich komplexer auswerten lässt,
  3. der Bau von Tools, mit denen sich Bewegungungsprofile und Beziehungsgeflechte insbesondere auf Landkarten visualisieren lassen,
  4. der Bau von Tools, mit denen sich institutionelle Geflechte und Informationsflüsse in diesen skizzieren lassen,
  5. die Arbeit an technischen Lösungen, mit denen sich vage Informationen zu Personen akkumulieren und verfestigen lassen. (Der Forscher hat einen Namen, ein Datum und einen Ort und will erfassen, ob bereits Personen in dieser oder anderen Ressourcen bekannt sind, die hinter diesem Namen stecken könnten. Er will seinen einmaligen Datenpunkt hier ablegen können, auf dass andere Forscher, die einen ähnlichen Namen finden, mit der Möglichkeit experimentieren können, dass dies Informationen zur selben Person sind.)

4| Wie steht das FactGrid zu anderen Datenbanken und ihm angebotenen Daten?

Die komplementäre Frage der Architektur unserer Ressource wird sein, wie wir mit bereits bestehenden Datenangeboten und Datenbanken umgehen sollen – mit dem Katalog der Forschungsbibliothek, der bereits Informationen zu uns interessierenden Materialien und Personen enthält, mit der GND-Datenbank, die Kontakt zu uns aufnahm, um Mitgliedschaften im Illuminatenorden zu verifizieren, mit Daten in Wikidata. Eine grundlegende Frage ist hier, ob Forschungsprojekten mit Übernahmen von Daten gedient ist, die bereits andernorts betreut werden (wir haben danach das Problem, dass wir sie im FactGrid aktuell halten müssen, indes den Vorteil, dass wir viele Strukturen nicht selbst anlegen müssen). Das Gegenmodell ist die Ressource, die in Zukunft Datenbank-Informationen miteinander verbindet, und gerade hier zeichnet sich die große Leistungsfähigkeit des Wikidata Projektes ab.

5| Könnte man die Digitalisate der Schwedenkiste auf Wikimedia Commons veröffentlichen?

Vom Gothaer Illuminatenprojekt aus wäre das eine Wunschlösung (siehe auch hier). Die Dokumente, über 21.000 Filmaufnahmen, wurden von uns in den letzten drei Jahren komplett digitalisiert. Die Verfügungsrechte liegen jedoch bei der deutschen Freimaurerei in Händen der Großloge “Zu den drei Weltkugeln”, die die Akten als Depositum im Geheimen Staatsarchiv Preußischer Kulturbesitz der Forschung zugänglich macht. Eine Kooperationsvereinbarung mit dem Ziel einer Erschließung unter den Augen der Öffentlichkeit wäre hier zwischen vier Partnern zu arrangieren, in Anbetracht des immensem öffentlichen Interesses am Illuminatenorden (und in Anbetracht der kursierenden Missverständnisse) jedoch gerade der spannendste Schritt.

Für Wikimedia wäre die in Aussicht auf eine “Befreiung” der Digitalisate und deren Erschließung mit Beteiligung durch die internationalen Wikipedia-Community ein Projekt extrem hohen Interesses, bei dem sich ganz verschiedene Gruppen bis hin zu Wikisource-Community zusammentun würden.

6| Fragen der Beziehung zwischen den Kooperationspartnern

Wikimedia ist als “Verein zur Förderung freien Wissens” nicht in der Lage, als Dienstleister zu agieren, der technische Lösungen realisiert, sobald das Geld für diese von Auftraggebern aufgeboten wird. Wissenschaftliche Projekte agieren ihrerseits unter weitgehend denselben Bedingungen. Die beteiligten Forscher ziehen keinen unmittelbaren finanziellen Nutzen aus der Software. Sachmittel, die sie anbieten können, sind projektgebundene öffentliche Gelder.

Wikimedia kann behilflich sein, Personen zu finden, die auf Werkvertragsbasis Dienstleistungen erbringen – etwa um Tools zu bauen oder den Wissenschaftlern am Aufbau der Ressource als Coaches zu helfen.

Die anvisierten technischen Lösungen wie die Produktion öffentlich verfügbaren Wissens stehen darüber hinaus zum größeren Teil in beiderseitigem Interesse. Viele der angedachten technischen Problemlösungen sind mit dem Blick auf Wikidata diskutiert worden. Letztlich steht hier die Frage im Raum, welches Interesse Wikimedia daran hat, die Wikidata Software-Lösung ähnlich wie Wikis breiter verfügbar zu machen.

Die beteiligten Projektpartner müssen vorab auf ihren Seiten eruieren, welche Handlungsspielräume sie haben und in einer Kooperationsvereinbarung fixieren können.