GT-Viz is a browser-based tool for visualizing geospatial and temporal data from SPARQL endpoints. You write a SPARQL query, provide the SPARQL endpoint for example FactGrid or Wikidata, and the results appear on an interactive map with a timeline.
It was built by a group of students at RWTH Aachen University as part of the Knowledge Graph Lab course.
The only input needed is a SPARQL query. A set of built-in example queries covers FactGrid (Thirty Years’ War battles), Wikidata (Napoleon, WW1 & WW2, Magellan and Columbus voyages, Olympic venues), and can be loaded for testing the functionalities. The sidebar holds a SPARQL editor with syntax highlighting and validation. A Help panel documents the expected query variables.
The tool reads these variables from your query results: ?location (WKT point), ?time (date), ?category, ?parentCategory, and optionally ?name, ?description, and ?pathId.
Map View
Query results appear as markers on an OpenStreetMap base layer. Parent categories each get a distinct color; sub-categories within a parent are separated by fill patterns. Clicking a marker shows its name, description, category, and date.
Two display options can be toggled: whether to draw connecting lines between points that share a ?pathId, and whether to show points that have no date.
The Group Visibility panel shows the full category hierarchy from the query results. Individual sub-groups or entire parent categories can be toggled on or off. Item counts are shown at every level.
Timeline and Animation
The timeline at the bottom filters the map to a selected date window. Drag the handles to set start and end dates; the map updates immediately. The Play button animates the window forward through time at an adjustable speed (configurable in days, weeks, months, or years per second).
Historic Map Overlays
As an experimantal feature it is possible to load historic maps. The historic maps are overlayed on the base layer as they only cover a small portion of the globe. For testing we provided a small set of over 20 different historic maps. Only thing needed to integrate such a historic map is a tile server serving the map thus the set of supported historic maps can easaly be extended.
Click the lightbulb icon and select “FactGrid: Battles of the Thirty Years’ War” — the endpoint and query fill in automatically.
Click Run. Battles appear across central Europe; the timeline sets itself to 1618–1648.
From there, use the Play button to step through the war year by year, the filter panel to isolate specific belligerents, and the Map Config tab to add a period map beneath the markers.
Feedback
GT-Viz is a student project in its early stages. We are looking for feedback from the FactGrid community on what works, what is missing, and what would be most useful.
A FactGrid egy Wikibase-alapú platform történeti adatokkal dolgozó projekteknek számára, amely egyszerre hagyományos wiki és adatbázis. Az oldalon állításokat rögzíthetsz az általad feltöltött vagy téged érdeklő elemekről, majd ezeket szinte bármilyen nyelven tudod használni és megjeleníteni.
Együttműködésben a Wikimédia Németországgal és a Német Nemzeti Könyvtár GND-adatbázisával szeretnénk elhelyezni a platformot mint kutatási adatokra építkező erőforrást a kialakulóban lévő, összekapcsolt Wikibase-oldalak rendszerében.
Miért használjam a FactGridet a saját kutatásomhoz?
A fő érv a FactGrid mellett a verhetetlenül rugalmas szoftver, a Wikibase, amelyet a Wikimédia Németország segítségével, elsődleges felhasználási helyén, a Wikidatán kívül, egy kísérleti projekt keretében implementáltunk:
Egy olyan szoftvert keresel, amely gyakorlatilag bármilyen nyelven tud beszélni? Egy platformot, ahol felvihetsz adatokat a saját nyelveden, mások pedig a saját anyanyelvükön olvashatják ugyanezt, és fordítva? Ez a szoftver a Wikibase.
Egy olyan szoftverre van szükséged, amivel átlátható módon koordinálhatsz egy egész kutatói csapatot? A Wikibase-zel ez ugyanolyan könnyű, mint a Wikipédia szoftverével, a MediaWikivel.
Egy olyan adatbázisszoftvert keresel, amely tud mindent, amire egy digitális bölcsészeti adatbázisnak szüksége lehet: kapcsolatháló-elemzés, térképes megjelenítés, komplex összekapcsolt keresések, megjelenítés többféle idővonalon? Egy szoftver, amely szinte emberi nyelvként működik, és még teljes körű adatbázis szolgáltatással is rendelkezik? A Wikibase ez a szoftver.
Szeretnél egy előző projektedből származó adatgyűjteményre építeni? A Wikibase-en lehetséges a nagy mennyiségű, automatizált adatbevitel.
Szeretnél biztosra menni, hogy más projektek is hozzáférnek az adataidhoz, és ténylegesen fel is tudják használni azokat? A platformról könnyen letöltheted az összes adatot, hogy offline, Excelben vagy bármilyen más online projektben dolgozhass velük.
Szeretnél teljesen új kérdéseket feltenni a kutatásodban? A Wikibase-en bármelyik elemet összekapcsolhatod bármiféle állítással.
Aggódsz, hogy mi történik majd az adataiddal miután véget ér a kutatásod finanszírozása? Támaszkodj egy platformra, ahol nem egyedül dolgozol, ami olyan licenc alatt működik, amely lehetővé teszi másoknak is, hogy folytassák a munkát az adataiddal és eszközeiddel.
Ha hosszú távú perspektívát keresel, akkor ezt szeretnénk nyújtani a Német Nemzeti Könyvtárral való együttműködésünkkel. A platform egyik támpillére a GND-adatgyűjtemény lesz, ami által széles körben használható eszközként működhetünk. Továbbá célunk ezzel, hogy fontos szereplőjévé váljunk az összekapcsolt Wikibase-rendszerek kialakuló világának.
Miért ne egyből a Wikidatát használjam?
Ez egy teljesen jogos kérdés. Vannak olyan projektek (amelyek elsősorban csak felhasználják adatokat), amelyekhez a Wikidata megfelelőbb platformot nyújt. Az FH Potsdam “Archivführer zur deutschen Kolonialzeit” nevű projektje remekül illusztrálta annak szépségét, amikor közvetlenül Wikidatára dolgozunk – erről beszélgettünk Uwe Junggal, aki bemutatta, milyen technikai megoldásokat használtak Potsdamban.
Ugyanakkor alapvetően két dolog van, amiket nem fogsz tudni sem a Wikidatán, sem egy GND-hez hasonló platformon csinálni: a Wikimédia-projektek (és a GND) szigorú szabályokkal rendelkeznek arról, hogy nem közölhető saját kutatómunka, és döntéseiket nevezetességi kritériumok alapján hozzák meg, ami nem enged teret tetszőleges adatbázis-elemek létrehozásának vagy tárgyak közötti kísérleti kapcsolatok tesztelésének.
A Wikidata és a GND olyan információkra koncentrálnak, amelyeket már korábban publikáltak és a kutatást nem végző alkalmazottak már közzétett kutatásokból viszik fel az adatokat. Ezeken a platformokon nem tudsz létrehozni munkahipotézisként szolgáló állításokat a kutatásodhoz. Nem hozhatsz létre elemeket kizárólag azzal a céllal, hogy majd statisztikai elemzést végezhess rajtuk a munka egy jóval későbbi szakaszában.
A FactGriden bátorítjuk a platform használatát heurisztikus kutatási eszközként.
Létrehozhatsz elemeket az adatbázisban függetlenül attól, milyen relevanciájuk lenne egy enciklopédiában vagy könyvtári katalógusban.
Megkockáztathatsz ideiglenes kronológiákat, egyéni feltevéseket kiinduló hipotézisként.
Használd a FactGridet nem konvencionális állításokhoz, amelyek jelenleg csak a saját kutatási projekted számára érdekesek – a szoftver lehetővé teszi ezt a fajta szabadságot.
Hozz létre adatbázis elemeket, amelyek részletezik, a kutatásod során milyen adatgyűjteményeket módosítottál jelentős mértékben. Ezáltal könnyen benyújthatod ezt az adott elemet mint a kutatásodat összegző “mappát” a téged finanszírozó intézménynek.
A platformon megkockáztathatsz bármilyen új tézist, és egy saját adatbázis elemben összegezheted mint “mikro-publikációt”, ezáltal is láthatóvá téve a hozzájárulásod.
A FactGrid ingyenes – hogy működik ez?
A szoftver ingyenesen használható, és folyamatosan fejlesztik a Wikimédia projektek közösségei, illetve a Wikibase-t használó intézmények.
A FactGrid platformot a Gotha Kutatóközpont szolgáltatja az Erfurti Egyetem virtuális szerverén. A német URL évi 36 eurós költséget jelent, ezt a Gotha Kutatóközpont fedezi.
Az összes Wikidata-segédeszköz a felhasználóink rendelkezésére áll. Ezek biztosítják az átlag digitális bölcsészeti projekthez szükséges összes funkciót.
Mivel mind a szoftver, mind az eszközök nyílt forráskóddal rendelkeznek, bármilyen általad kedvelt szoftverrel módosíthatod őket, ha új alkalmazási módra van szükséged.
Ha saját eszközeiddel is hozzájárulsz a nyílt rendszerhez, biztosíthatod, hogy jövőbeli projektek is használhatják és fejleszthetik ezeket.
Amennyiben olyan technikai megoldásokra törekszel, amelyeket később anyagi haszonért értékesíthetsz, a szoftver licence ebben sem fog meggátolni. Szabadon kereskedelmi alapokra helyezhetsz bármit, amit nyílt forráskóddal építettél.
Mihez kezdhetek az unortodox kutatási témákkal?
A Wikidata úttörő adatmodellel rendelkezik. A felhasználó gyakorlatilag csak kapcsolatokat hoz létre Q-számok között (vagy kapcsolatokat Q-számok és időpontok, Q-számok és földrajzi koordináták, Q-számok és médiafájlok, Q-számok és URL-ek között).
A szoftver maga nem tudja, milyen típusú kapcsolatokat hozol létre – ezek szintén csak P-számok: a Q1 – P1 – Q2 egy ún. “triple”, ami jelentheti, hogy “Johann Sebastian Bach (Q1) fia (P1) Carl Philipp Emanuel Bach (Q2)”, de azt is, hogy “Az archívumban talált, XY raktári jelzetű levél (Q1) állítólagos feladási helye (P1) München (Q2).”
Q-számokat bármihez hozzárendelhetünk – emberekhez, dokumentumokhoz, eseményekhez, eszmékhez… Te döntöd el, milyen P-számokra van szükséged az általad kívánt állításokhoz. Az elemeket nem egy rögzített, módosíthatatlan kategóriarendszerben kell meghatároznod, a létrehozott állításaid pedig új árnyalatot és szilárdságot adnak az új vagy meglévő elemekhez. Ne aggódj, ha nem rögtön az első napon áll össze az adatmodelled. Hozd létre folyamatosan az állításokat, amikor csak szükséged van rájuk, közben figyeld, hogy érik el a kritikus tömeget, amellyel kiértékelhetővé válnak.
Minden állítás “minősíthető” – “Johann Sebastian Bach (Q1) felesége (P2) Maria Barbara Bach (Q2) házasság kezdete (P2) 1707. október 7. (dátum), házasság vége (P3) 1720. július 5 körül (dátum).” Ezeket az állításokat ugyanakkor hivatkozásokkal is elláthatjuk: “erre bizonyíték (P4) XY egyházi évkönyv (Q3)”,”állítás forrása (P5) XYZ Bach-életrajz (Q4)”.
A rendszerben lehetséges egymással versengő értékeket megadni, mindössze külön-külön forrásmegjelölést kapnak, illetve rangsorolni is lehet őket.
Ilyen mélységben meghatározott triple-ekkel gyakorlatilag bármilyen állítást létrehozhatsz, ami viszont még fontosabb, ezzel lehetőséged nyílik állításokat létrehozni bármely nyelven. A rendszer Q- és P-számokkal működik, minden egyéb pedig címke, amit azon a nyelven adhatsz meg, amelyet fel szeretnél kínálni a felhasználónak. Ezen felül a szoftver automatikusan lefordítja a dátumokat és mértékegységeket az adott nyelv által használt formátumra. Ez a titka annak, hogy a Wikibase-platformokat mindenki a saját nyelvén szerkesztheti, miközben az egész világon olvasható szinte bármilyen nyelven.
Milyen segédeszközöket biztosít a szoftver?
Készíthetsz adatbázis-bejegyzéseket egyesével: nyisd meg a szerkeszteni kívánt elemet, menj a beviteli lap aljára, és kattints az “állítás hozzáadása”-linkre. Itt kell megadnod, milyen állítást szeretnél létrehozni. Nem szükséges fejből tudnod a P-számot, kezdd el begépelni a tulajdonság nevét a saját nyelveden, majd válassz a felkínált lehetőségek közül az automatikus befejezéshez. A platform tudni fogja az adott állítás P-számát. Az állítás második részét a következő szövegdobozban adhatod meg, szintén elég elkezdeni begépelni.
Excel- és CSV-listákból, automatikus bevitellel is készíthetsz adatbázis bejegyzéseket. (Itt találod a beviteli felületet, itt pedig egy rövid útmutatót hozzá.)
Az adatbázis-lekérdezéseket SPARQL nyelven kell megfogalmazni. Ez (sajnos) nem egy könnyű keresőnyelv, de végső soron annyira komplex, mint a futtatni kívánt keresések.
A SPARQL-t használók nem feltétlen tudnak SPARQL-forráskódot írni. Általában keresési mintákat tudsz használni, amik megmutatják, hol kell változtatnod a bevitt szövegen, hogy lefuttathasd a saját keresésed.
Amennyiben pontosan tudod, milyen típusú keresési lekérdezést kell futtatnia a felhasználóidnak, készíthetsz a könyvtárak megszokott online felületeihez hasonló, egyéni beviteli maszkokat, amelyek majd SPARQL-ben kommunikálnak az adatbázissal.
A szoftvercsomag tartalmaz illusztrációs lehetőségeket térképekhez, idővonalakhoz, hálózatokhoz, genealógiai kapcsolatokhoz, grafikonokhoz, stb. Nem kell letöltened egyéb, külső alkalmazásokat. A SPARQL-en keresztül kérheted az általad kívánt reprezentáció létrehozását. Gyönyörű bemutatót láthatsz vizualizációkból, ha felkeresed a Wikidata Scholia-projektjét.
Mit tegyek, ha a saját platformomon szeretném megjeleníteni az adatvizualizációm?
Ennek nincs technikai akadálya. Uwe Jung demonstrálta, hogyan használja az FH Potsdam felülete a Wikidatát adattárként úgy, hogy közben a felhasználók nem látják a háttérben lévő adatbázist.
Nincs semmi gond azzal, ha a FactGridet külső adattárként használod, és a saját kutatási projekted az egyetemed szerverén építed fel, ahol célzott adatbázis-hozzáférést teszel lehetővé saját keresősablonon keresztül.
A FactGrid CC0-licenc alatt teszi közzé az adatokat – ez azt jelenti, hogy lemondok a kutatásom jogairól?
Ha a Creative Commons 0-licencet választod, továbbra is teljes szabadsággal használhatod az adataidat, amire csak szeretnéd – te irányítasz, és nem a kiadó vagy az adatokat kezelő platform. Ezen felül a CC0 azt jelenti, hogy az adataid szabadon felhasználhatóvá válnak mások által is. Mivel a közösség így bármikor kijavíthatja az észrevétlenül maradt hibákat, csökken annak a kockázata, hogy hosszabb távon elavuljon a kutatásod.
Néhány megfontolandó tényező: Tudósok számára első pillantásra a CC BY 4.0-licenc tűnik kedvezőnek. Ez engedélyezi az ingyenes felhasználást, amennyiben az megfelelően módon megjelöli a forrást. A gyakorlatban ez működhet szövegeknél (mint ez a blogposzt), mivel itt egyértelmű, hogy milyen hivatkozást szeretnénk látni: a nevünk megadásával, a publikáció címével, a kiadás helyével és dátumával. De szeretnéd, hogy az adataid idézetként szerepeljenek, például egy vizualizációban? Egy 1753 júniusában Párizsból Berlinbe küldött levél a térképen egy vonalként szerepel – hogyan lássuk el ezt megfelelő jegyzetekkel? Hogyan idézzenek téged, ha csak javításokat végeztél egy adathalmazon? Az “Így add tovább”-licencek még problematikusabbak: ezek az adatok szabadon hozzáférhetők bárki számára, amennyiben a további felhasználók is ugyanezekkel a feltételekkel osztják meg. Ez úgy hangzik, mint a szabad felhasználás melletti határozott kiállás. De egy al-felhasználó hogyan tudja biztosítani, hogy az ő al-felhasználói is betartják a licencbe foglalt feltételeket (főleg ha ez az al-felhasználó CC0 alatt teszi közzé az adatokat)? Az al-felhasználóknak általában azt tanácsolják, ne használjanak adatokat CC-BY vagy CC Így add tovább licenccel rendelkező platformokról.
A Wikidatával és a Német Nemzeti Könyvtárral közös vállalkozásunk egyetlen lehetőséget hagyott számunkra: hogy partnereinkhez hasonlóan szabadon felhasználhatóvá tegyük az adatainkat. A CC0-licenc által nem biztosított, hogy a további felhasználók is feltüntetik majd, ki gyűjtötte az adatokat, illetve felhasználásuk feltételeit.
A gyakorlatban a legtágabb nyílt licenc nem jelenti azt, hogy a FactGrid-adatok szerző nélküliek, épp ellenkezőleg. Mi azt szorgalmazzuk, hogy hivatkozzunk a kutatásra, és megelőlegezzük, hogy a Wikidata és a GND is boldogan feltünteti, ha a kutatás a mi platformunkról származik.
A FactGriden minden szerkesztéshez kapcsolva van a szerző neve. Ha egy kutatási projekt lényeges mértékben járult hozzá egy adatgyűjteményhez, akkor ezt jelezhetik egy külön jegyzetben, amelyet tovább lehet adni adatátvitelnél.
A Wikidatához vagy a GND-hez hasonló adatbázisok amúgy érdekeltek is a kutatások hivatkozásában – ez hozzájárul az adataik szilárdságához. A FactGrid abban a különleges helyzetben van, hogy mindkét szervezet számára olyan platformot szolgáltat, ahol a felhasználók olyasmiket csinálhatnak, ami saját, nagyobb platformjaikon nem engedett.
Mi történik, ha szeretném az adataimmal egy másik platformon folytatni a munkát?
Mivel szerzői jogi korlátozások nélkül vitted fel az adatokat, szabadon dolgozhatsz velük bárhol máshol. Valójában örülünk is, ha afféle inkubátor lehetünk kutatási adatok számára.
Mi történik, amikor FactGrid-felhasználók a “helyes” dátumról vitatkoznak?
A szoftver lehetővé teszi az egymásnak ellentmondó adatok kezelését – ez különösen fontos a történelmi kutatás területén, ahol gyakran találunk egymásnak ellentmondó forrásokat anélkül, hogy biztosan tudjuk, melyikük állítása igaz. A szoftverrel reprodukálhatjuk az ellentmondásos helyzetet, az állításokat pedig külön-külön alátámaszthatjuk hivatkozásokkal. Az eltérő állításokat súlyozhatjuk is egymáshoz képest – például a jelenleg irányadó állítást az egyéb variánsokkal szemben, vagy akár minősítőkkel az egyéni kiértékeléshez.
Tekintsük inkább érdekes helyzetként arra, amikor két kutató eltérő eredményekre jut. Sokkal rosszabb, amikor egy olyan platformon hibázol, ahol sosem lesznek kijavítva, és hitelteleníthetik az egész munkádat.
Miért kockáztassam meg az átláthatóságot rögtön a projektem kezdetétől?
Ez kemény dió, valószínűleg ez gátolja meg a legtöbb projektet, hogy használja a FactGrid erőforrásait. Az alternatíva egy platform, amihez csak a jelszóval rendelkező csapat férhet hozzá a projektet lezáró publikáció határidejéig. Így, szól az érv, semelyik versengő projekt sem tudja elcsaklizni a kutasi eredményeket. Senki sem látja, hol hibáztál az elején. Senki sem rögzíti, melyik adatot vitték fel asszisztensek és melyiket a projektvezető – ehhez hasonlók a feltételezett előnyei a nem átlátható munkának egy olyan platformon, amely csak a finanszírozás végével lesz online elérhető.
Az átlátható kutatás saját biztosítékokkal rendelkezik. Ha egy találsz egy minden eddigit felülíró dokumentumot vagy rögzítesz egy úttörő kapcsolódási pontot, akkor itt a lehetőség, hogy a saját nevedhez és projektedhez kösd az állítást. Ha holnap valaki ellátogat ugyanabba az archívumba és szintén felfedezi, amit te – pech, hiába. Te már rögzítetted a megfigyelést a platformon, amit a laptörténetben lekövethető változtatás minden kétséget kizáróan bizonyít.
Mindeközben a kollektív platform meghívásként is működik az együttműködésre. Tedd egyértelművé a többi csapat számára, min dolgozol, hogy felvehessék veled a kapcsolatot.
Egy elméletileg biztonságos, csak a projekt végén nyilvánosságra hozott weboldal kockázatai komolyak. A felhasználókkal ekkor már nem lehetséges ötleteket cserélni. Az internetes jelenlét időzítése a projekt rohanós utolsó heteire esik, amikor már nem lehetséges semmiféle, koncepciót érintő változtatás. Ha a kutatást kizárólag egy könyves publikációhoz végeztétek, bizonytalan marad, mihez kezdjen a csapat a Word- és Excel-fájlokban összegyűjtött adatokkal. Senki sem tudja ekkor felvinni az adatokat egy nagyobb erőforrásba – egy ilyen késői fázisban a harmonizáció szinte megugorhatatlan akadály. Csak reménykedni lehet, hogy a könyv olvasói beszkennelik az összes lábjegyzetet, hogy a bennük lévő korrigálások elérhessék a könyvtári katalógusokat és a különféle Wikimédia-projekteket. A kockázatot itt a könyv jelenti, amely semmiféle hatással nincs a kollektív adatbázisra, illetve a digitális bölcsészet projektek, amelyek publikáció után elavulnak.
A jövő inkább egy újfajta hozzáállásban kell keresni egy közös, nyilvános adatbázis felé. A kutatóknak képesnek kell lenniük javítani és bővíteni ezt az adatbázist bárhol, bármikor hozzáférve. Az szükséges motivációt és biztonságot a kutató környezet jelenti, ahol megjelölhetik és idézhetővé tehetik saját munkájukat. Erre a Wikibase bármely más szoftvernél alkalmasabb.
Mi kell ahhoz, hogy a FactGrid befogadja a projektem?
A FactGrid-platformnak nincs láthatatlan mélyrétege. Bárki lekérdezhet az adatbázisból, és ugyanazt az eredményt fogja kapni akár be van jelentkezve, akár nincs. A személyes felhasználói fiók annyi előnnyel jár, hogy kiválaszthatod a kívánt nyelvet, miközben az adatokat böngészed, illetve lesz egy “szerkesztés”-link minden állítás alatt.
Ha szeretnéd betáplálni az adataid a FactGridbe, és ha szeretnél egy projektet futtatni a platformon, akkor szükséged lesz felhasználói fiókra. Ezt a valódi neved megadásával kaphatsz az adminisztrátoroktól. Ehhez az oldalon találsz egy “Request account” (felhasználó fiók igénylése) szövegű linket. E-mailben is felveheted velünk a kapcsolatot. Projektvezetők kaphatnak adminisztratív fiókokat, amivel kijelölhetnek csapattagokat, projekthez kapcsolódó személyeket.
Miután bejelentkeztél, felvihetsz adatokat nagy mennyiségben vagy végezhetsz meghatározott javításokat bármelyik elemen. Minden változtatásod a felhasználói fiókodhoz lesz kapcsolva. Mások visszavonhatják a szerkesztéseid, de nem nyomtalanul, dokumentálva lesz az elem történetében, mindenki láthatja.
Ha egy összetettebb projekten szeretnél dolgozni, —
ami lehet személyes családkutatás,
lehet egy egyszeri vizualizáció egy szemináriumi dolgozathoz,
vagy akár több ezer tételnyi adat bevitele egy 5 éves projekt folyamán
— egyeztess a többi felhasználóval és a platform szervezőivel. Nem (feltétlen) fogunk egy nyilvános egyetértési nyilatkozatot aláírni, de a blogunkon hírt adhatunk a projektedről, hogy eljusson mindenkihez a platformon. A munka akkor válik igazán izgalmassá, amikor mások befejezett munkáját módosítod, illetve amikor más projektek résztvevőit inspirálod az általad bevezetett modellezés használatára. Nem kötelező átbeszélni az adatmodelleket a többiekkel, de a modellek megosztása segíthet a kutatásodnak új embereket elérni, illetve felhasználhatók lesznek mások által létrehozott lekérdezésekben vagy vizualizációkban.
A szoftvert arra tervezték, hogy kezelni tudja mind az olyan állításokat, amelyek csak számodra érdekesek, mint azokat, amelyek az eredeti kutatási témádnál jóval távolabbra elérnek majd.
Jack Kirby, “The Fourth Dimension is a many splattered thing!”, Alarming Tales, 1 (1957. szeptember).
FactGrid est une installation Wikibase – c’est-à-dire à la fois un wiki ordinaire et une base de données que vous pouvez utiliser pour faire des déclarations sur les objets qui vous intéressent – déclarations que vous pouvez ensuite traiter sur de grands jeux de données dans pratiquement toutes les langues.
La plate-forme est gérée par le Centre de recherche de Gotha et hébergée par l’ThULB Iéna. Elle s’adresse à des projets ayant un intérêt spécifique pour les données historiques.
En collaboration avec Wikimedia Allemagne et le GND de la Bibliothèque nationale allemande, nous essayons d’intégrer cette plateforme dans le prochain consortium d’instances fédérées de Wikibase comme ressource pour les « données de recherche ».
Pourquoi devrais-je utiliser FactGrid pour mes propres recherches ?
Le principal argument en faveur d’un compte FactGrid est la flexibilité imbattable du logiciel Wikibase, que nous avons réussi à installer, dans le cadre d’un projet pilote, en dehors de son site principal Wikidata et avec l’aide de Wikimedia Allemagne :
Vous recherchez un logiciel qui parle pratiquement toutes les langues – une plate-forme où vous pouvez entrer des données dans votre propre langue tout en permettant à d’autres de les lire dans leur propre langue ? Wikibase est ce logiciel.
Vous recherchez un logiciel qui vous permet de coordonner toute une équipe de manière transparente ? Dans Wikibase, c’est aussi simple que dans le logiciel MediaWiki de Wikipedia.
Vous recherchez un logiciel de base de données qui peut faire tout ce que les bases de données d’humanités numériques veulent normalement faire : analyses de réseau, représentations cartographiques, recherches croisées complexes, frises chronologiques (dans différents formats) – un logiciel qui se comporte presque comme un langage humain, tout en fournissant des services complets de base de données ? Wikibase est ce logiciel.
Vous avez des données provenant de projets antérieurs que vous voulez développer ? Wikibase dispose d’options de saisie automatique à grande échelle.
Vous voulez que vos données puissent être réutilisées ? Wikibase permet le téléchargement et le travail avec vos données, aussi bien hors ligne dans Excel qu’en dligne dans le cadre de nouveaux projets.
Vous voulez poser des questions entièrement nouvelles pour votre recherche ? Dans Wikibase, vous pouvez lier n’importe quel objet à n’importe quelle déclaration en fonction de vos intérêts.
Vous vous demandez ce qu’il adviendra de vos données et de vos outils de présentation une fois votre projet terminé ? Comptez sur une plate-forme sur laquelle vous ne travaillez pas seul et utilisez une licence de données qui permettra à d’autres personnes de continuer à travailler avec votre travail sans aucun risque !
Vous voulez poser des questions entièrement nouvelles dans votre recherche ? Dans Wikibase, vous pouvez relier n’importe quel type d’objet à n’importe quelle déclaration d’intérêt.
Vous vous inquiétez de ce qui arrivera à vos données et à vos présentations une fois votre financement terminé ? Comptez sur une plateforme où vous ne travaillez pas seul et utilisez une licence de données qui permet à d’autres de continuer à travailler à la fois avec vos données et vos outils !
Si vous recherchez une perspective à plus long terme, c’est ce que nous essayons d’offrir grâce à notre accord de collaboration en cours avec la Bibliothèque nationale allemande. Nous baserons notre plate-forme sur les données GND afin d’en faire aussi un outil grand public, avec pour objectif de devenir un acteur dans le paysage émergent des “installations fédérées Wikibase”.
Pourquoi ne pas utiliser Wikidata dès maintenant ?
Wikidata et le GND se concentrent sur les informations qui ont déjà été publiées ; ils mobilisent des travailleurs non chercheurs qui alimentent leurs bases de données à partir de recherches déjà publiées. Vous ne serez pas autorisé sur ces plateformes à énoncer des “hypothèses de travail” relevant de “votre recherche”. Vous ne pourrez pas créer des objets de base de données dans le seul but de mener sur eux à un stade ultérieur de votre recherche “rien de plus qu’une analyse statistique”.
Dans FactGrid, nous encourageons au contraire l’utilisation de la plate-forme comme un outil de recherche heuristique.
Créez des objets de base de données sur la plate-forme, quelle que soit par ailleurs leur pertinence pour une encyclopédie ou un catalogue de bibliothèque.
Risquez comme hypothèses de travail des chronologies provisoires en fonction de vos intérêts personnels.
Utilisez FactGrid afin de faire des déclarations non conventionnelles et qui n’ont d’intérêt que pour votre projet de recherche – le logiciel vous donne cette liberté.
Créez des objets de base de données spécifiques mentionnant votre projet de recherche dans les jeux de données que vous aurez substantiellement modifiés, ce qui vous permettra d’identifier votre contribution lorsque vous soumettrez votre recherche à votre institution de financement.
Risquez de nouvelles hypothèses sur la plateforme et indiquez votre point de vue par un numéro d’objet de base de données (servant en quelque sorte de “micro-publication”), afin d’attester de votre inventivité sur la base de données.
FactGrid est gratuit – comment est-ce possible ?
Le logiciel est disponible gratuitement et en cours de développement dans la communauté plus large des projets Wikimedia et au sein des institutions qui entendent utiliser Wikibase dans les prochaines années.
La plate-forme FactGrid est gérée par le Centre de recherche de Gotha sur un serveur virtuel de l’université d’Erfurt. L’URL allemande coûte 36 euros par an en frais de domaine, financés par le Centre de recherche de Gotha.
Tous les outils Wikidata sont à la disposition de nos utilisateurs. Ils comprennent toutes les applications standard dans les projets d’humanités numériques.
En outre, les logiciels et les outils étant open source, vous pouvez faire appel à votre prestataire de service informatique extérieur pour développer l’application spécifique dont vous auriez besoin.
Proposez à la communauté FactGrid vos propres développements d’outils et de présentation, ce sera le meilleur moyen pour que vos propres visualisations continuent à être développées après la fin du financement de votre projet. Si vous visez plutôt des solutions que vous voulez vendre, vous ne serez pas limité par la licence du logiciel. Vous pourrez commercialiser librement tout ce que vous aurez créé sur la base du logiciel ouvert.
Que dois-je faire des demandes de recherche non orthodoxes ?
Wikibase fait œuvre de pionnier dans la modélisation des données. Pour l’essentiel, vous ne créez que des relations entre des numéros Q (ou entre des numéros Q et des dates, des numéros Q et des coordonnées spatiales, des numéros Q et des fichiers média, des numéros Q et des URL).
Le logiciel ignore le type sémantique des relations que vous avez créées- il s’agit là encore de simples numéros P : Q1 – P1 – Q2 est un “triplet”, qui peut tout aussi bien signifier “Jean-Sébastien Bach (Q1) est le père de (P1) Carl Philipp Emanuel Bach (Q2) ” que “Cette lettre que j’ai trouvée dans les archives avec la cote XYZ (Q1) aurait été envoyée de (P1) Munich (Q2)”
Les numéros Q peuvent être attribués à toute espèce d’identité : personnes, documents, événements, idées… C’est vous qui décidez des types des numéros P dont vous avez besoin pour faire les déclarations qui vous intéressent. Vous n’avez pas à définir les objets dans un système de catégories a priori ; ce sont vos déclarations qui ajoutent de la chair aux objets que vous créez au fur et à mesure. Ne vous inquiétez pas si vous n’avez pas de modèle de données dès le premier jour. Faites des déclarations dès que vous en avez envie et voyez comment elles acquièrent la masse critique. C’est alors seulement que vous pourrez juger de la valeur de l’ensemble.
Toutes les déclarations peuvent elles-mêmes être « qualifiées » – “Jean-Sébastien Bach (Q1) était marié avec (P2) Maria Barbara Bach (Q2) à partir du (P2) 7 october 1707 (date) jusqu’à (P3) environ 5 juillet 1720 (date).” Toutes ces déclarations peuvent à leur tour être dotées de références : “cela ressort du (P4) registre paroissial de… (Q3)”, ”cela est indiqué dans (P5) la biographie bien connue de Bach XYZ (Q4)”.
Le système permet à tout moment de proposer des affirmations concurrentes. Elles sont simplement introduites avec leurs différentes sources et peuvent être comparées les unes avec les autres.
En fin de compte, n’importe quelle déclaration en langue naturelle peut être générée avec des triplets de ce genre, mais, surtout, cela permet d’exprimer cette déclaration dans n’importe quelle langue du monde : pour le système, toutes les déclarations ne sont que des liens entre des numéros Q et des numéros P. C’est vous seul qui attribuez aux numéros Q et P des “libellés” et des “définitions” qui leur donnent sens, et cela dans les langues avec lesquelles vous communiquez (le système gère par ailleurs les informations de date et de quantité dans toutes les normes mondiales avec une conversion automatique dans n’importe quelle direction) ; c’est là le secret des plateformes Wikibase, qui permet aux auteurs de saisir les informations dans leurs langues respectives et aux utilisateurs de lire ces informations dans n’importe quelle langue.
Quels sont les outils fournis par le système ?
Les entrées dans la base de données peuvent être effectuées une à une : ouvrez pour cela l’objet-id en question, allez au bas de la page de saisie et cliquez sur le lien “ajouter une déclaration”. Il vous sera alors demandé de saisir la déclaration que vous souhaitez faire. Vous n’avez pas besoin de connaître le numéro P. Il suffit d’indiquer l’objet dans la langue que vous utilisez et de cliquer sur l’auto-complétion qui vous est proposée. La plate-forme utilisera pour vous le numéro P de cette déclaration. Indiquez alors dans le champ qui s’ouvre l’objet de votre déclaration. Le système, là encore, vous proposera, à mesure que vous tapez le texte de votre déclaration, des suggestions de plus en plus précises.
Les entrées dans la base de données peuvent également être créées et enregistrées automatiquement à partir de tableaux Excel ou CSV. (Ceci est le masque de saisie et voici le guide succinct pour le faire).
Les requêtes dans la base de données doivent être formulées sous forme d’interrogations “SPARQL”, un langage de requêtes qui n’est (malheureusement) pas si facile à utiliser, mais qui, au fond, n’est pas plus complexe que les recherches que vous pourriez vouloir effectuer.
Le plus souvent les utilisateurs de SPARQL ne savent pas écrire leurs requêtes dans le code source. Vous pouvez cependant utiliser des modèles de requêtes où sont indiquées les entrées qu’il faut modifier afin d’exécuter votre recherche spécifique.
En outre, si vous savez exactement le type de requêtes que vos utilisateurs doivent exécuter, vous pouvez créer vos propres masques de saisie, comme ceux que vous utilisez dans les interfaces habituelles des bibliothèques en ligne, qui parleront alors SPARQL avec la base de données.
Le système comprend aussi des outils cartographiques, des frises chronologiques, des réseaux, des arbres généalogiques, des graphiques, etc. Vous n’avez pas besoin de télécharger des applications particulières. Vous demanderez à SPARQL de produire la représentation que vous essayez d’obtenir. Le projet Scholia sur Wikidata présente certaines de ces visualisations.
Que dois-je faire si je veux donner mes représentations de données sur ma propre plate-forme ?
Il n’y a rien de mal à utiliser FactGrid comme dépôt externe et à monter son propre projet de recherche sur le serveur de son université d’origine, en y proposant des accès ciblés à la base de données selon un modèle de recherche de son choix.
FactGrid octroie essentiellement des licences d’utilisation des données à CC0 – cela veut-il dire que je renonce à tous les droits sur mes recherches ?
Opter pour la licence Creative Commons signifie essentiellement que vous conservez tous les droits sur l’ensemble de vos données. Mais surtout, la licence CC0 signifie que vos données deviennent librement utilisables et que vous pouvez ainsi réduire le danger de recherches obsolètes à long terme.
Quelques considérations de base : CC BY 4.0 est à première vue la licence que les scientifiques préféreront. Elle permet l’utilisation gratuite des données à la condition que celles-ci soient correctement citées. En pratique, cela fonctionne pour les textes (comme ce billet de blog) ; dans ce cas, on voit clairement comment on aimerait que le texte soit cité : avec une référence à l’auteur, le titre de la publication, le lieu de publication et la date. Mais supposons que vous souhaitiez que vos données soient citées, disons dans une visualisation ? Une lettre envoyée de Paris à Berlin en juin 1753 se réduisant à une ligne sur une carte, comment cette ligne doit-elle être correctement annotée ? Comment voulez-vous être cité si vous n’avez fait qu’améliorer un ensemble de données existantes ? Les licences “share alike” sont encore plus problématiques : “Ces données sont disponibles gratuitement si les utilisateurs ultérieurs les gardent tout aussi libres”. Cela semble être le plaidoyer ultime pour la gratuité. Mais comment un sous-utilisateur peut-il s’assurer que ses sous-utilisateurs respecteront à leur tour votre contrat de licence (surtout si ce sous-utilisateur offre ses données sous CC0) ? Les sous-utilisateurs seront bien avisés de ne pas utiliser de données provenant de plateformes CC-BY ou CC Share-Alike.
Nos entreprises communes avec Wikidata et la Bibliothèque nationale allemande ne nous ont finalement laissé qu’une seule option : rendre nos données aussi librement disponibles que nos partenaires, autrement dit sous CC0, c’est-à-dire sans garantie que les utilisateurs ultérieurs préciseront toujours exactement qui a collecté les données, ni sur ce que les utilisateurs tiers seront autorisés à faire avec ces données.
En pratique, la licence ouverte maximale ne signifie pas que les données de FactGrid sont des données sans auteur, bien au contraire. Outre que nous suggérons aux utilisateurs de toujours citer la recherche qu’ils utilisent, nous faisons l’hypothèse que Wikidata et le GND souhaiteront renvoyer à la recherche sur notre plate-forme. Toutes les modifications apportées aux jeux de données sont liées par le système à nos vrais noms, visibles par tous les utilisateurs. Si un jeu de données a été tout particulièrement travaillé par un projet de recherche, vous pouvez l’indiquer dans une note à part qui sera transférée avec ce jeu de données. Vous pouvez également noter votre travail dans le jeu de données lui-même. Enfin, tout le monde peut interroger la base de données pour savoir quels jeux de données ont été travaillés dans le cadre d’un projet particulier.
En fait, les bases de données comme Wikidata ou le GND de DNB sont intéressées à citer la recherche – cela renforce la solidité de leurs données, et FactGrid est dans la position unique de fournir aux deux institutions une plate-forme sur laquelle les gens peuvent faire ce qu’ils ne pourraient pas faire sur leurs grandes plates-formes.
Que se passe-t-il si je veux continuer à travailler avec mes données sur une autre plateforme ?
Puisque vous avez saisi vos données sans restriction de droits d’auteur, vous pouvez travailler librement avec elles sur tout autre projet qui vous intéresse. En fait, nous aimons être “juste un incubateur” pour les données de recherche.
Que se passe-t-il si les utilisateurs de FactGrid se disputent sur une date “correcte” ?
Le logiciel permet de traiter des données contradictoires – ce qui est particulièrement intéressant dans le domaine de la recherche historique où nous disposons souvent de preuves documentaires contradictoires, sans pouvoir être certain de l’information correcte. Les noms sont traités avec des orthographes différentes ; il arrive que les historiens se contredisent.
Le système permet de reproduire la situation contradictoire ; il permet d’étayer les déclarations avec des dizaines de références et dans différentes orthographes.
Des déclarations divergentes peuvent être comparées les unes avec les autres – par exemple, la déclaration qui fait actuellement autorité et les variantes qui ne circulent qu’en raison des diverses sources contradictoires.
Que deux chercheurs arrivent à des résultats différents, voilà qui devrait en général vous intéresser. Le danger majeur est d’avoir fait une hypothèse erronée et qu’un autre projet sur une autre plateforme donne la solution de l’énigme et travaille sur la bonne date sans que vous le sachiez, ou pire, sans que vous ayez même la possibilité de corriger votre erreur des années après la fin de votre projet.
Pourquoi devrais-je risquer la transparence de mon projet dès le début ?
C’est probablement le problème le plus difficile, celui qui empêche actuellement certains projets d’utiliser la ressource que nous avons ouverte. L’alternative est une ressource accessible seulement avec un mot de passe aux membres de l’équipe jusqu’à la date de publication, c’est-à-dire quasiment jusqu’à la fin du projet. Aucun projet concurrent ne peut alors s’emparer des résultats, du moins en théorie. Personne ne peut voir l’erreur par où vous avez commencé et que vous avez ultérieurement corrigée. Personne ne peut voir non plus le travail fourni par les assistants qui entrent les données dans la base, ni l’implication réelle du chef de projet – tels sont les avantages supposés d’un travail non transparent sur une plateforme qui ne sera mise en ligne qu’à la fin de votre financement.
La recherche transparente offre ses propres garanties : si vous trouvez un document révolutionnaire et établissez une connexion décisive, c’est l’occasion d’attacher la découverte à votre nom et à votre projet. Si quelqu’un, demain, fait la même découverte dans les archives que vous venez de visiter, pas de chance pour lui : vous aurez enregistré votre observation avec un lien dans l’historique des versions que vos rivaux ne pourront pas nier.
En même temps, la plate-forme collective invite à coopérer. Expliquez clairement aux autres équipes sur quoi vous travaillez et permettez-leur de vous contacter sur la plate-forme !
Les inconvénients d’un site web prétendument sécurisé et qui ne sera mis en ligne qu’à la fin du financement du projet sont sérieux : Lorsque le projet est publié, le temps des échanges avec les utilisateurs est déjà révolu. Si la mise sur Internet se fait dans les dernières semaines, celles où le projet est sous pression, vous vous trouverez totalement incapable de réagir par des changements plus conceptuels. Et si vous avez mené des recherches uniquement pour la publication d’un livre, que ferez-vous, vous et votre équipe, des données que vous avez rassemblées dans des fichiers Word et des feuilles de calcul Excel ? Personne ne pourra les verser dans des bases de données, car l’harmonisation à ce stade tardif sera un obstacle insurmontable. Votre seul espoir est que des lecteurs de votre livre parcourront toutes vos notes de bas de page pour en tirer des corrections pour nos catalogues de bibliothèque et pour différents projets Wikipédia. Le risque, finalement, est d’avoir un livre sans impact sur la base de données collective et sur les projets d’humanités numériques et qui sera, à cet égard au moins, obsolète dès sa publication.
L’avenir devrait résider dans une nouvelle attitude à l’égard de la base de données publique. Les chercheurs devraient pouvoir corriger et élargir encore cette base chaque fois qu’ils y accèdent. Pour cela, il leur faut une incitation et une sécurité que seul peut leur donner un environnement de recherche dans lequel le travail soit référençable et citable. Pour cela, Wikibase est mieux équipée que tout autre système.
Comment puis-je faire accepter mon projet sur FactGrid ?
La plate-forme FactGrid ne comporte pas de couche profonde invisible. Tout le monde peut interroger la base de données et les requêtes donneront les mêmes informations, que vous soyez connecté ou non. Votre compte d’utilisateur personnel présente simplement l’avantage de vous permettre de passer à votre langue préférée lorsque vous consultez les données et de voir le lien d’édition sur chaque déclaration.
Si vous souhaitez alimenter la plate-forme avec vos propres données et si vous souhaitez y mener un projet, vous devez disposer d’un compte. Les comptes sont donnés sous des noms réels par les administrateurs. Le logiciel fournit un lien “demande de compte”. Vous pouvez également nous contacter par courrier électronique. Les chefs de projet peuvent recevoir des comptes administratifs leur permettant de donner accès aux membres de leur équipe et aux utilisateurs qui les intéressent.
Une fois connecté, vous pouvez saisir des données en masse ou apporter des corrections spécifiques où bon vous semble. Toute entrée sera connectée à votre compte d’utilisateur. D’autres utilisateurs peuvent annuler vos modifications, mais non sans laisser une trace documentée de cette intrusion dans l’historique des versions – visible par le monde entier.
Si vous souhaitez travailler sur un projet plus complexe, qu’il s’agisse d’une recherche familiale personnelle, d’une visualisation unique dont vous auriez besoin pour une communication, ou encore de l’intégration dans la base de milliers de documents que vous auriez rassemblés dans le cadre d’un projet de recherche de 5 ans, parlez-en à ceux qui sont déjà sur FactGrid et à ceux qui organisent la plate-forme. Nous ne serons pas (nécessairement) désireux de signer un protocole d’entente avec vous, mais il pourrait être très intéressant de faire connaître votre projet sur le blog, ainsi que sur l’ensemble de la plateforme. Là où votre travail devient passionnant, c’est lorsque vous modifiez le travail que d’autres ont déjà fait et que vous encouragez les acteurs d’autres projets à adopter les bons modèles que vous introduisez. Il n’est pas indispensable de discuter des modèles de données avec tous les autres utilisateurs, mais cela peut aider, ne serait-ce que pour diffuser votre travail sur la plateforme. Adoptez des requêtes de recherche composées par d’autres, découvrez des visualisations auxquelles vous n’avez pas pensé, obtenez de l’aide sur la plateforme.
FactGridest conçu pour gérer un environnement de recherche excitant que vous ne trouverez pas ailleurs.
FactGrid is a Wikibase installation — that is is both, a regular wiki and a database which you can use to make statements about objects of your interest — statements which you can then handle in practically any language in big data sets.
The platform is run by the Gotha Research Centre and hosted by the ThULB Jena. It addresses projects with a specific interest in historical data and is part of the German National Research Data Infrastructure NFDI4Memory.
In joint ventures with Wikimedia Germany and the German National Library’s GND we are trying to bring this platform into the upcoming consort of federated Wikibase instances as a resource for research data.
Why should I use FactGrid for my own research?
The biggest argument for a FactGrid account is the unbeatably flexible software, Wikibase, which we have managed to implement in a pilot project with the help of Wikimedia Germany – outside its primary location, Wikidata:
You are looking for a software that speaks practically any language — a platform on which you can enter data in your language and allow others to read your data in their languages? Wikibase is this software.
You are looking for software in which you can transparently coordinate a whole team? In Wikibase this is as easy as in the Wikipedia software MediaWiki .
You are looking for a database software that can do everything Digital Humanities databases normally want to do: network analysis, map representations, complex linked searches, timeline representations (in various formats) – a software that almost acts like human language yet provides full database services? Wikibase is this software.
You have data from previous projects which you want to build on? Wikibase has large-scale automatic input options.
You want to make sure that that other projects will actually use your data? Use a platform that allows the download and further work with your data offline in Excel or online in ever new projects.
You want to ask entirely new questions in your research? In Wikibase you can link any sort of objects with any kind of statements of your interest.
You are worried what will happen to your data and presentations once your funding is over? Work on a platform where you do not stay alone and where, thanks to the CC0 license you are using, you encourage colleagues to continue right were you stopped!
If you are looking for a long term perspective this is what we are trying to offer in our present joint venture with the German National Library. We will base our platform on GND data in order to serve as a broad public tool and with the aim to become a player in the emerging landscape of “Federated Wikibase installations”.
Why not use Wikidata right away?
That is a legitimate question to ask. There will be projects (projects that are mainly using data) for which Wikidata will be the better platform. The FH Potsdam’s “Archivführer zur deutschen Kolonialzeit” has demonstrated the beauty of working directly on Wikidata; we talked about this with Uwe Jung, who demonstrated the technical solutions they have chosen in Potsdam.
On the other hand, there remain basically two things which you will not be able to do on Wikidata or on a platform like the GND: Wikimedia projects (and the GND) have strict “No original Research” policies and observe fundamental decisions to operate on “criteria of notability“, which will not allow the arbitrary opening of database objects and the innovative object relationships researchers would like to test.
Wikidata and the GND focus on information that has already been published and on non-research workers who feed the respective databases from published research. You will not be allowed to state a “working hypotheses” of “your research” on these platforms. You will not be able to create entities with the aim to run “nothing but a statistical analysis” on them at a far later stage of your work.
In FactGrid we encourage the use of the platform as a heuristic research tool.
Create database objects on the platform, no matter what their relevance in an encyclopedia or in library catalog could be.
Risk provisional chronologies as working hypotheses along with your personal assumptions.
Use FactGrid in order to make unconventional statements that are presently interesting only in your research project – the software gives you this freedom.
Create specific database objects that state your research in all the data sets which you have substantially modified and become able to submit your research with the particular item as the envelope to your funding institution.
Risk any new thesis on the platform and state your respective view with a database object number as a “micro-publication” in order to claim your ingenuity on the data base.
FactGrid is free – how does it work?
The software is freely available and under development in the larger community of Wikimedia projects and among the institutions which are going to use Wikibase over the next years.
All the Wikidata-tools are available to our users. These include all the standard applications of regular Digital Humanities projects.
With both software and tools being open source you can use any favorite software company you are working with, to generate the specific application which you feel you need.
If you feed your tools into the open compound this will be your best way to make sure that future projects will continue their development.
If you aim at technical solutions which you want to sell with financial profit that again will not be restricted by the software license. You can freely commercialize whatever you create on the basis of the open software.
What do I do with unorthodox research interests?
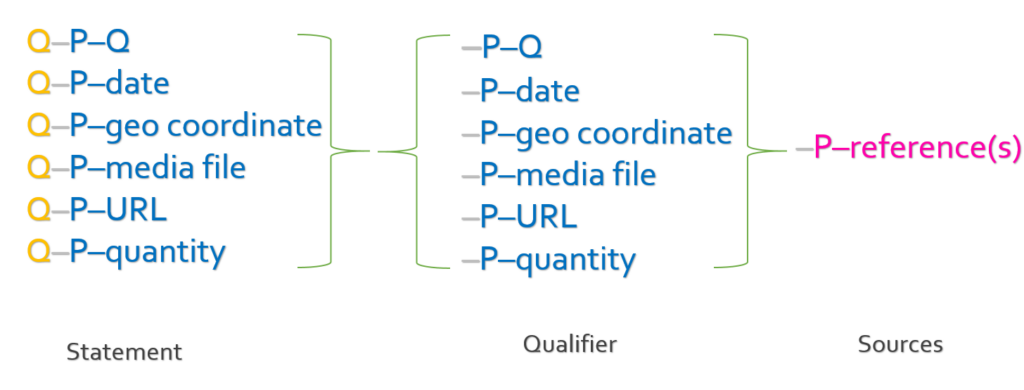
Wikibase is groundbreaking in its data modelling. Essentially you are only creating relations between Q-numbers (or relations between Q-numbers and dates, Q-numbers and space coordinates, Q-numbers and media files, Q-numbers and URLs).
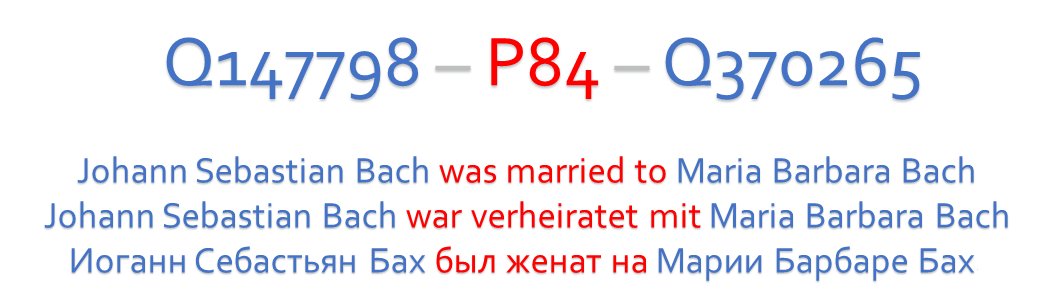
The software does not know what kind of relationships you are stating – these again are just P-numbers: Q1 – P1 – Q2 is a “triple” and can mean “Johann Sebastian Bach (Q1) is the father of (P1) Carl Philipp Emanuel Bach (Q2)”; it can mean just as well “This letter which I found in the archive with the shelf mark XYZ (Q1) has allegedly been sent from (P1) Munich (Q2)”
Q-numbers can be assigned to anything imaginable – people, documents, events, ideas… You decide what kinds of P-numbers you need in order to make statements of your interest. You do not define objects in a system of fixed categories; your statements are adding colour and solidity to whatever object you create as you go along. Do not worry if you do not have the data model on day one. Make statements when you suddenly want to make them and see how they gain the critical mass that can eventually be evaluated.
All statements can be “qualified” – “Johann Sebastian Bach (Q1) was married to (P2) Maria Barbara Bach (Q2) beginning on (P2) October 7, 1707 (date) ending (P3) about July 5 1720 (date).” All of these statements can in turn be equipped with references : “this is clear from (P4) the church book of… (Q3)”,”this is stated in (P5) the well known Bach biography XYZ (Q4)”.
The system allows competing claims at any time. They are simply introduced with their different sources and can be balanced against each other.
You can create practically any normal language statement with triples of this depth of specificity; but above all, this opens the door to the world of statements in all the various languages you might want to speak: The system operates with Q- and P-numbers; the rest is labels in languages which you want to offer to your users. The software will in addition translate dates and quantities into other formats; this is basically the secret that makes it possible for Wikibase platforms to be edited by people in their own languages and to be read by the world in practically any other language.
Which tools does the software provide?
Database entries can be made one by one: Open the object-id in question, go to the bottom of the input page and click the “add statement” link. You will now be asked for the statement you want to make. You do not need to know the P-number. State the property in the language you are using and click at the auto complete you are eventually being offered. The platform will now use the P-number of that statement for you. Complete in the next box that opens your statement. You will again get suggestions to use as you are typing.
Database entries can also be created and substantiated in automated inputs from Excel or CSV lists. (This is the input mask and this is the short guide to it.)
Database queries have to be formulated as “SPARQL” queries, a search language that is (unfortunately) not that easy to use, but that is eventually as complex as the searches you might want to perform.
SPARQL users do not necessarily know how to write SPARQL source code. You usually use sample queries that tell you where you have to change the input in order to run your particular search.
If you know exactly which type of search queries your users should run you can create your own input masks just as you know them from conventional online library interfaces, which will then speak SPARQL with the database.
The software package includes illustrations on maps, timelines, networks, genealogical relationships, graphs, and so on. You do not need to download particular applications. You will ask SPARQL to produce the representation you are trying to get. The Scholia project on Wikidata has a beautiful first presentation of some of the visualisations.
What do I do if I want to give my very own data representations on my own platform?
That should not be a technical problem. Uwe Jung demonstrated how the FH Potsdam interface uses Wikidata as its data repository, without letting users see the database they are accessing.
There is nothing wrong with using FactGrid as an external repository and building up your own research project on the server of your home university, where you can offer targeted database accesses under a typical search template of your choice.
FactGrid basically licenses data to CC0 – does that not mean that I give up all rights to my research?
Opting for the Creative Commons 0 license means essentially that you continue to be free to do whatever you want with your data – you, and not your publisher or the platform that received your data under a scheme, continue to control. But above all, the CC0 license means that your data becomes freely usable and that you can thus reduce the danger of obsolete research in the longer run – others will continue to root out the ugly mistakes you could not hope to correct.
Some basic considerations: CC BY 4.0 is at first glance the license that scientists will prefer: It allows the free further use as long as it receives the accurate citation. In practice, this will work for texts (such as this blog post); here it is clear how one would like to see the text cited: with a reference to one’s own name, with the title of the publication, the place of publication and the date. But do you want your data quoted let us say in a visualisation? A letter sent from Paris to Berlin in June 1753 will be a line on a map and how should this line be properly annotated? How do you want to be quoted if you only improved a data set? “Share alike” licenses are even more problematic: “These data are freely available if the subsequent users keep it just as freely available.” That sounds like the ultimate plea for free use. But how can a sub-user ensure that his sub-users, in turn, will respect your license agreement (especially if this sub-user is offering his data on CC0)? Sub-users are well advised not to use data from CC-BY or CC Share-Alike platforms.
Our joint ventures with Wikidata and the German National Library left us only only one option: to make our data as freely available as our partners: CC0, that is without ensuring that subsequent users will still specify exactly who collected the data, and what third-party users are allowed to do with that data.
In practice, the maximum open license does not mean that FactGrid data is data without authorship, quite the contrary. We suggest that research is cited and assume that Wikidata and the GND are only too happy to state research from our platform. All changes are linked to respective the author names. If research projects have worked more substantially on a data set, they will have stated this in a separate note on the data set that can now be adopted with the data transfer.
Databases like Wikidata or DNB’s GND are in fact interested to quote research – it boosts their data solidity, and FactGrid is here in the unique position to give both institutions a platform on which people can do what they cannot do on the respective larger platforms.
What happens if I want to continue working with my data on another platform?
Since you entered your data without a copyright restriction, you are free work with them on any other project of your interest. We actually like to be “just an incubator” for research data.
What happens when FactGrid users argue about a “correct” date?
The software makes it possible to handle contradictory data. This is particularly interesting in the field of historical research, where we often have conflicting documentary evidence without being able to determine the correct statement after so much time. The software makes it possible to reproduce such a contradictory situation. Numerous statements can be given side by side with their various respective sources. You can then still balance the statements against each other – either by turning one of them into the statement to privilege in future searches and/or by adding qualifying statements with your personal evaluations.
If two researchers come to different results, think of it as the situation you should actually be interested in. It is far worse that you have made mistakes on a platform where they will never be corrected and where they eventually discredit all your work as obsolete beyond repair.
Why should I risk transparency in my project right from the start?
This is likely to be the toughest issue that currently prevents projects from using the resource which we have opened. The alternative is the resource, which is accessible to the team only under passwords until the publication deadline is reached almost at the end of the project. No competing project can snatch away findings, so the theory. No one sees where you have initially made a mistake. Nobody records what assistants are typing in and where the project leader is involved – such are the presumed advantages of non-transparent working on a platform that will only go online at the end of your funding.
Transparent research offers its own securities: If you find a groundbreaking document and establish a decisive connection, then this is your chance to fix the statement to your name and project. If someone makes the same discovery tomorrow in the archive you have just visited, tough luck. You will have recorded your observation with a link in the version history which your rivals will not be able to deny.
At the same time, the collective platform expresses the invitation to cooperate. Make it clear to other teams what you are working on and allow them to contact you on the platform!
The risks of the allegedly secure website, which is only going online at the end of the project’s funding, are serious: The time for an exchange with users is over. The internet presence goes online in the heated final weeks while the project is totally unable to react with more conceptual changes. If you have done research solely for a book publication, it will remain unclear what you and your team should do with the data, you have still collected in Word files, and Excel spreadsheets. Nobody will be able to feed all these data into any resource – the harmonisation at this late stage will be an insurmountable obstacle. You can only hope that readers of your book will scan all your footnotes for corrections that should reach our library catalogs and the various Wikipedia projects. The risk is here the book that has no influence on the collective data base and of DH projects that become obsolete right after their publication.
The future should lie in a new attitude toward the public data base. Researchers should be able to correct and to further widen this base wherever they access it. The incentive and the security they will need here is the research environment in which they can mark their work and make it citable. For this Wikibase is better equipped than any other software.
How do I get my project accepted on FactGrid?
The FactGrid platform has no invisible deeper layer. Anyone can query the database and the queries will give the same information whether you are logged in or not. Your personal user account just has the advantage that you can now switch to your favorite language when looking at data, and that you see the edit link on each statement.
If you want to feed your own data into the platform and if you want to run a project on the the platform, you will need an account. These are given under real names by the administrators. The software provides an “account request” link. You can also contact us via email. Project leaders can receive administrative accounts which they use to assign to team members and users of their interest.
Once logged in, you can enter data in bulk or make specific corrections wherever you feel like. Any input will be connected to your user account. Others can undo your edits but not without leaving a documented mark of that intrusion in the version history – visible to all the world.
If you want to work on a more complex project —
that can be personal family research,
it can be a single visualization you need in a seminar paper,
it may just as well be the input of thousands of records in a 5-year research project
— speak with those on board and those organising the platform. We will not (necessarily) be interested to sign a public memorandum of understanding with you but it might be cool to advertise your project on the blog and to make it known on the entire platform. Your work becomes exciting, where you modify the work others have already done and where you encourages players from other projects to adopt good models which you are introducing. You do not need to discuss data models with all the others but using models with all the others is also a way to spread your work and to make it appear in queries composed by others, and visualizations you did not think of.
The software is designed to manage both: unique statements which only you are interested in and statements that will spread far beyond your own initial research interest as you are now feeding the unforeseen queries which others will run on their and your data.
Jack Kirby, “The Fourth Dimension is a many splattered thing!” from Alarming Tales, 1 (September 1957).