A Quarter of a Million Items on FactGrid – just a brief reflection

Germany’s national author Johann Wolfgang von Goethe called it a “masquerade in red and white”, but was himself a member (just as he became a member of the Illuminati a little bit later; it made sense to join such organisations and to know from within what they were all about). Freemasonry was in its most idealistic terms an updated edition of the brotherhood of men united under a simple and strikingly anti aristocratic system: the system of the old craft guilds. With their three degrees of apprentice, fellow and master there was no room for privilege of birth. German masonry evolved from the late 1730’s through the 1750’s principally as a system of four degrees, with Scots Master at the apex and the development did not stop there. The chivalric degrees of the 1760’s and 1770’s gave way to increasingly complex systems, overgrowing this initial construct. These high-degree systems claimed roots in the middle ages if not deeper pasts, synthesising Christianity with alchemy, magic, and theosophy. Masonic entrepreneurs travelled through Europe selling secrets which they would convey in extraordinary lodges. What they offered would have been considered heresies only a generation before, and now became a market of esotericism – a market that turned the masonic world into its first framework and distributor. The Strict Observance or Order of the Temple, the masonic high-grade-system founded by Carl Gotthelf von Hund und Altengrotkau in Germany in 1751 was the biggest player on this stage in central Europe – the system of red and white, the colours of the Knights Templars.

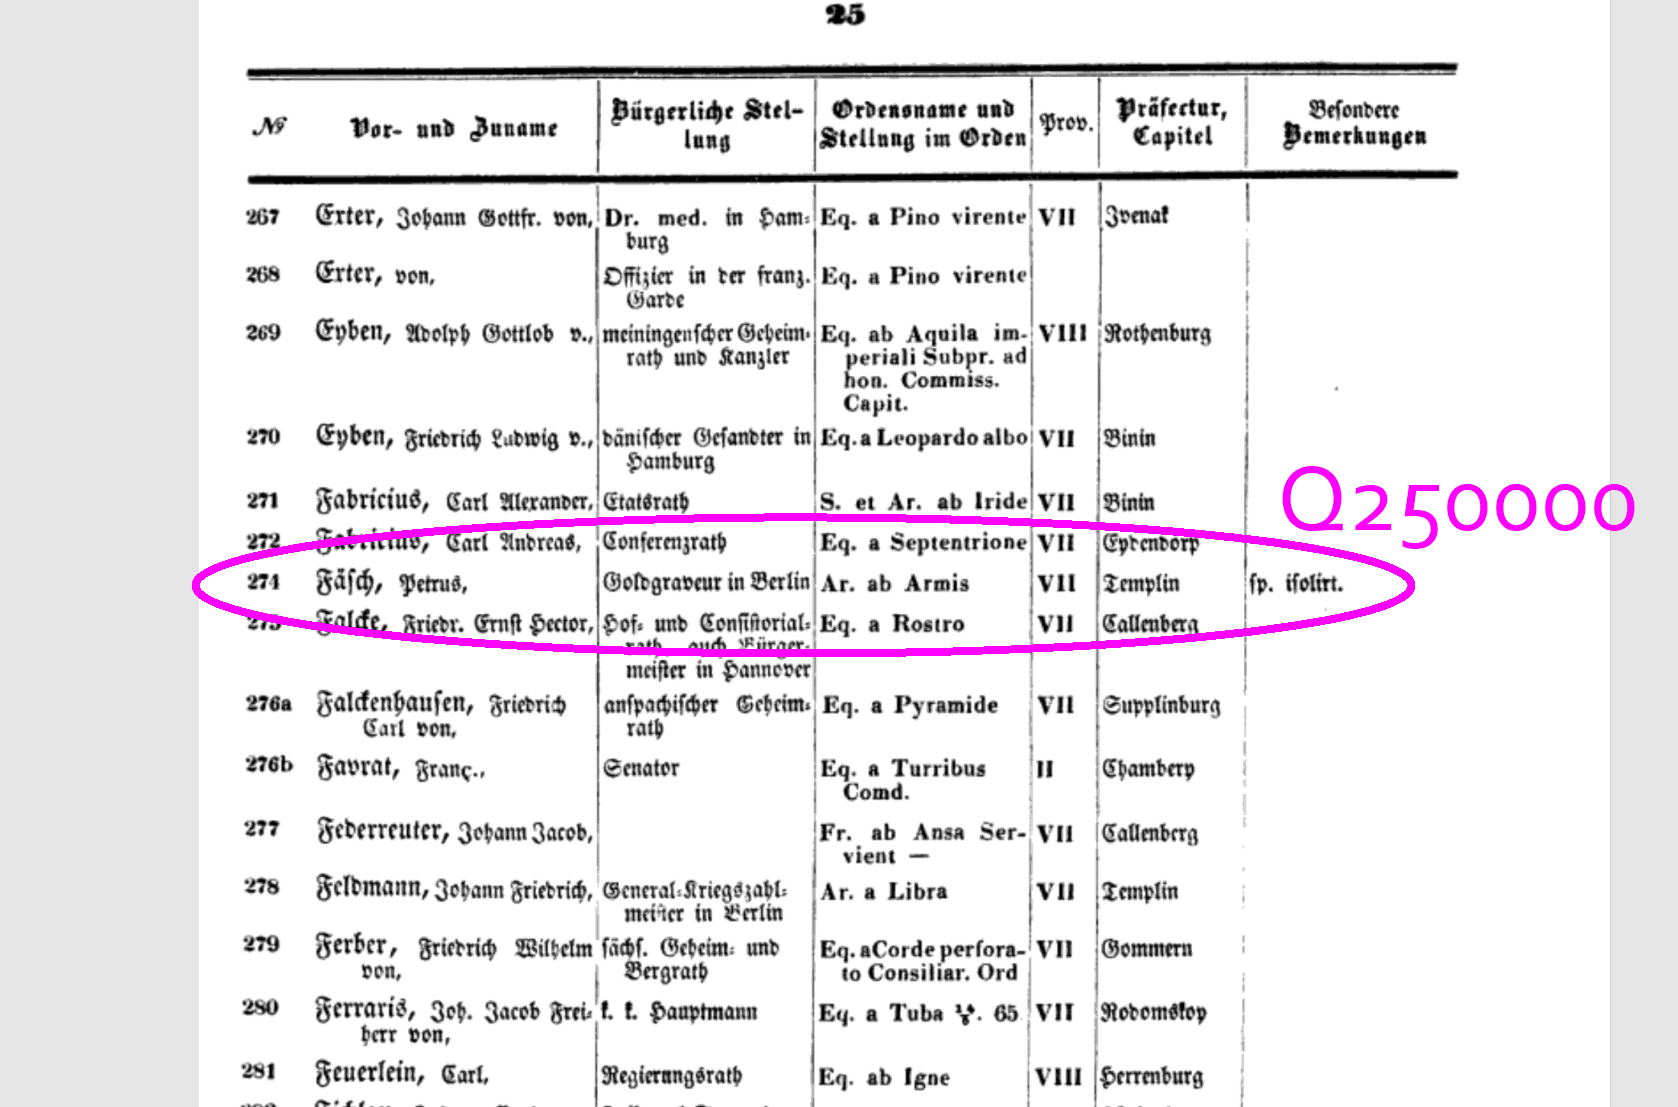
Q250000 is the FactGrid item number of Pierre Faesch, a Frenchman, by profession a gold engraver, who settled in Berlin where he and some of his friends eventually founded their own lodge “Indissolubilis”. He was number 274 in von Lindt’s list of the members of the Strict Observance, published 1846 – number 274 of the 1,266 members he could establish.

Josef Wäges broke the quarter of a millionth item with the input of this list on May 10, 2021 at 7:20 (EST). FactGrid became immediately the most interesting environment for this dataset. 180 of his 1,266 records were old acquaintances: members who already had their Q-numbers on FactGrid. But the new data set which anyone can now create on FactGrid is substantially bigger: it lists 1,595 members with interesting overlaps of projects that have been working on FactGrid over the last three years:

Josef Wäges will publish a more detailed article on the dataset in a lavishly illustrated blog post. The links to the Illuminati are perhaps the most interesting thing to explore in this data set. Von Hund’s claim that the Strict Observance had its roots in the order of the Knights Templar had been both immensely attractive and explosive. The heads of the medieval Order had burned on the stake on May 12, 1310 – but the organisation had gone underground and fused into Scotland’s crypto Catholicism, so the story goes, including the idea that the “Pretender” (to the British throne) was the secret leader of the organisation. The Strict Observance soon expanded from Germany to France, Sweden, Italy, the Baltics and Russia. State leaders became Knights of the Order and met in fancy costumes while members like Goethe or Christoph Bode could easily cast doubts on the historical construct. Von Hund died in 1776 without having given the final proof of the legacy. The organisation itself was by that time in financial troubles over plans to create an insurance system for its members on a foundation of factories, which were to be built under command of the Order on the eve of industrialisation, an organisation that was not really established in the world of modern capitalism.

The internal conflicts culminated in the summer of 1782 when the rank and file of the Observance met at their last convention in the resort of Wilhelmsbad near Frankfurt am Main. The alleged history stood in the centre of the debates and tore the Order apart while a new organisation was secretly emerging behind the scenes: the Order of Illuminati, both as an antithesis and also as a potential heir of the entire infrastructure. They too were by 1782 a masonic high degree system, and they infiltrated lodges far more cunningly from below than from above. With the help of young “Minervals” which they tunnelled from below into the lodges of their interest, and from above with the help of masonic functionaries in the Illuminati leadership. The fascinating thing about the Illuminati was that all the bombastic narratives were handled as little more than a Machiavellian façade by those who acted as “Unknown Superiors” in the hidden centre of this organisation.

Our critical mass: strange organisations of the second half of the 18th century

FactGrid is growing fast. We are doubling our numbers almost every year; that is the more superficial message of the Q250000 jubilee. The more complex message will be: We are (thus far) growing particularly well where we reached our particular critical mass. Entries like Pierre Faesh are the almost ideal subject matter for a Wikibase installation. No portrait has survived, we know little about the biography but we can produce some interesting details with far reaching network information. A genealogy software would not be versatile enough to handle such knowledge. A regular Wiki, with its focus on articles to be written, would on the other hand need to be filled with desolate fragments of repetitive information – we do not know enough to write interesting articles about these people. Using a Wikibase we can easily turn the few points of data we have into an asset. If you want to know more about the “Strict Observance” we can offer the sociological details, networks of the members, family ties, knowledge of the organisation and its surroundings: We can list the various organisational ties of these members and we can – theoretically – give a picture of the landscape of Masonic organisations as they grew and changed from the 17th into the 19th century.

Not quite the software of citizen science: Our Gotha specialisation

At an early point we decided to test the software on the wider audience in a local experiment. Gotha is a small town of some 45,000 inhabitants. We could easily give database courses at the Research Centre. The local project developed with mixed success: Gotha’s Archive of the Lutheran City Church embraced the offer of the free database. Heino Richard of Gotha’s genealogical society entered this project and created its biographical backbone with some 20,000 biographical records linked to the archive’s work and to the city’s history. The integrative appeal remained, however, comparatively weak.

The Wikibase conclusion so far, is interesting in the hands of researchers who are delighted about the flexibility they get with this software. The same tool remains opaque in wider use. We will need interfaces for genealogists and archivists to make broad editing easier, and these interfaces will come.

Novels, religious dissidents, medieval codices and Nazi concentration camps – leaving our comfort zone

We are, nonetheless leaving our comfort zone, the zone of late 18th-century biographies, and this is challenging wherever it leads into fields of information without more comfortable background knowledge:

  • Marie Gunreben of the University of Konstanz has started a project on German novels 1670 to 1750. We have widened this project. We should get the European flow of developments into the picture, the exports and imports, the flow of translations and influences across the European borders. The move is an immense theoretical challenge: We are using a software that creates essential notions of sameness wherever it sets a Q-number. The modern English “novel” should, of course, be the modern French or German “Roman”. But the conceptual equivalents do not really lead us back into the early 18th century. The English “novel” was back then what we will today call a “novella”. Robinson Crusoe, if anything, was a “romance” – a spectacular move in 1719 as the romance had just been pronounced dead, finished by the modern novel(la). How should we handle different conceptual developments in different languages? We are experimenting with set language Items and with Q-items that use the modern conceptual frame as an alleged continuum. It remains to be seen how this will work.
  • Lionel Laborie is about to open the long-expected section on Early Modern religious dissent which our present data have been calling for for the last three years. Freemasons, Rosicrucians and Illuminati, quasi-religious associations built upon a new consensus that their members would leave all their confessional controversies aside and focus on a truth beyond. The result was not exactly deism that shined through all the allusions to God as the master builder and supreme architect. It was rather a competition of increasingly eclectic historical constructs of diverse religious dimensions – of heresies in the old terms of the Catholic or Lutheran orthodoxy and these new orthodoxies emerged within this spectrum with different systems that would not necessarily acknowledge each other. If successful we should be able to eventually give a sketch of the changing map – now with a perspective on the biographies that travelled on this map of ever changing options.
  • Isabella Schwaderer already wrote about her project. She mapped the members of the first two years of the German Schopenhauer Society founded in 1912. The project that began as an experiment led to experiments: Isabel Heide and Martin Gollasch introduced a couple of bigger data sets with the prominent prisoners of Theresienstadt, the map of German concentration camps, and the list of German university academics who signed the declaration of allegiance to the new Regime in 1933. These sets have not yet gained a greater depth of information. They were rather created in order to break the ground for new projects that will discover with a look at early 20th-century networks.

Steps into uncharted territories are a challenge on a Wikibase. You want to augment and to interconnect known objects, you want to work on the basis of our collective present knowledge and suddenly you have to create ever new objects that need ever new objects in order to make sense.

The Middle Ages – the new territory where we will see the biggest growth on our course to Q500000

We will enter new fields and Q500000 is already knocking at our doors. Led by Charles Faulhaber the trilingual PhiloBiblon project has decided to fuse their data into FactGrid – 450.000 items of (late) medieval Iberian books and manuscripts. The project will be a test. We might arrive at the conclusion that the global text production deserves its own Wikibase. It might just as well dissolve the present demarcation lines between archives and libraries on the one hand and historical research on the other. Historical information is in its last consequence not much more than an interpretation of remaining textual and documented evidence. We will bring the evidence and the interpretation onto the same platform.

FactGrid will learn Spanish and Portuguese in the course of this project. The PhiloBiblon group arrives as a team of superbly informed people with different specialisations from data management and librarianship to (literary) history. The technical aim will be to create a user interface on the specific material base that will communicate with the database. FactGrid will act here in the background – nothing to regret, rather the model to go for: The model of a single compound of knowledge that serves various projects as the reservoir of broader collective knowledge.

In the middle of technical developments

Wikibase is not yet a widely used software – it has the potential to become this software. The problem is apparent in any imaginable “normal” use case. You search something – but how do you search anything on the SPARQL Query Service? – on a Query Service that expects you to know what you can search and how you would ask for it – without giving you the slightest hint on either question.

You can use the Wiki surface but here again you will be puzzled. What exactly is the message of these Item pages that collect various statements without order and cohesion? Even if you arrive at a complex item like Q133, Christoph Bode, that item will not tell you half of the story – it does not tell you that this man is the author of hundreds of letters stored in this database, and the recipient of as many – who is mentioned in hundreds of other sources the database has registered.

Markus Manske’s Reasonator gave a glimpse of what one could do with a Wikibase such as Wikidata: One could produce well-structured pages of information automatically in hundreds of languages. The Reasonator did not make it into the software package nor is it easy to use on an external Wikibase.

We will get such browsers – not in the singular but in the plural of general and specific purposes and two of these have entered a test phase last month: Bruno Belhoste’s “FactGrid Viewer” and Michael Ringgaard’s “SLING Browser”. Both seem to do pretty much the same job, but they are doing it differently, opening doors into quite different future developments.
Bruno Belhoste’s FactGrid Viewer (you have been using it over the last minutes wherever you followed the Item-links in this article) is drawing its information straight from the database as you see it. Change data on FactGrid and you will see the new situation with the next browser update. You can switch languages. You get a history of your movements on the site and you get an idea of where you are with a specific item as the object is connected to “what links here?” information.

You can implement Bruno Belhoste’s viewer – pure Javascript – on any website anywhere in the world to see your choice of FactGrid data – the solution for projects who want to use the FactGrid database simply as their database without a further interest in the broader platform.
Michael Ringgaard’s SLING Browser works on the basis of the data dump which FactGrid supplies every evening around 21:15 CET. A new edition of the SLING browser’s presentation of information is created every day. The potential is visible in an intricate detail: The Q-Numbers of SLING browser searches are not necessarily FactGrid Q-Numbers (Christoph Bode our Q133 is on the SLING Browser Q213880). If there is information about the same object available on Wikidata the SLING Browser will give it under the Wikidata Q-Number, and this is only the beginning of the upcoming development: We will eventually see pages that accumulate information from various Wikibases – not in a show of serialised harvests but in a single coordinated representation that accumulates information and that marks the differences only where it arrives at disagreeing statements. This is a tremendous step into the world of “federated Wikibases” that will eventually present the best information of specialised platforms that all speak a common language of triple based statements.

Both browsers are part of the FactGrid-menu-structure but not yet the breakthrough to a simple widespread use of our data. The big issue is at the moment the missing search interface. Google will lead you straight into our items – where you will be lost before you understand how you can navigate on such a platform. The two browsers do not give you a better search interface than the input field on the database’s wiki. If you have just the last name of a person and a rough idea of where they lived that will not help you here or there. You will get to the family name without a hint of how to find those who lived with this Family name. Future Wikibase browsers will have to overcome these dead ends of the individual browsing histories; they will need an advanced search to access data in the first place and internal information that shows why the database has listed the particular object. We will see these interfaces becoming available in a variety of technical options and a broad range of integrations over the next few years.

Integrating FactGrid: NFDI-4Memory participant and GND partner project

We have been surfing a wave of success over the last three years – the wave which Wikibase was creating, the software that is about to be used by national libraries worldwide and in “National Research Data Infrastructures” all over the world.

The reason why National Libraries are experimenting with Wikibase platforms is simple: They have all created authority control data to run the various catalogues that use these data. Humans can understand that Death in Venice was written by Thomas Mann, the 1929 Nobel Prize in Literature laureate. Fresh publications under the same name must have other authors of the same name and this is where databases need a superior form of knowledge. They will handle the 28 authors under that name in a combination of unique identifiers (supplied for instance by the German National Library’s GND’s) and specific biographic background information detailed enough to define who is who in this mess. The system has been working well in its various national boundaries but it was difficult to tell who a specific Thomas Mann was on the BnF’s complementary cataloguing system. It is this riddle that Wikidata has begun to solve. Not only does Wikidata interconnect the up to 300 Wikipedia articles that exist on the various language projects on “the same” entities. The respective Wikidata items will also clarify who these people, organisations and places will be on hundreds of external databases – from the GND to the BnF catalogue.

Historians should states these references on all data they are producing (wherever available) since this is the only way for anyone using their data to automatically check who is who in the different sets they are merging.

The easiest thing FactGrid could do is offer simply all the GND items in the basic pool of objects available on the site to link to. Yet the easiest thing will not be the best thing here. As the National Libraries are about to create and to interconnect their own Wikibases we should enter this compound more as a partner than an interested user. “Our” data should profit from corrections made elsewhere in the wider environment. Corrections made on FactGrid should in return enter the global exchange with information about the research that led to these changes.

We are still living in a world in which DH projects are basically transferring their view of the book world into the new medium of the internet. Books have to be quoted as do web projects – so the common logic, that is creating ever new islands of information on isolated web-platforms.

The future is not the web project quoted in a book or by another web project. The future is in data ready to be downloaded and used in ever new environments. We will need authority to control data, to ensure that those who use our data know what they have downloaded, and we will need collective platforms to offer data in an environment in which the augmentation and further development of information can take place.
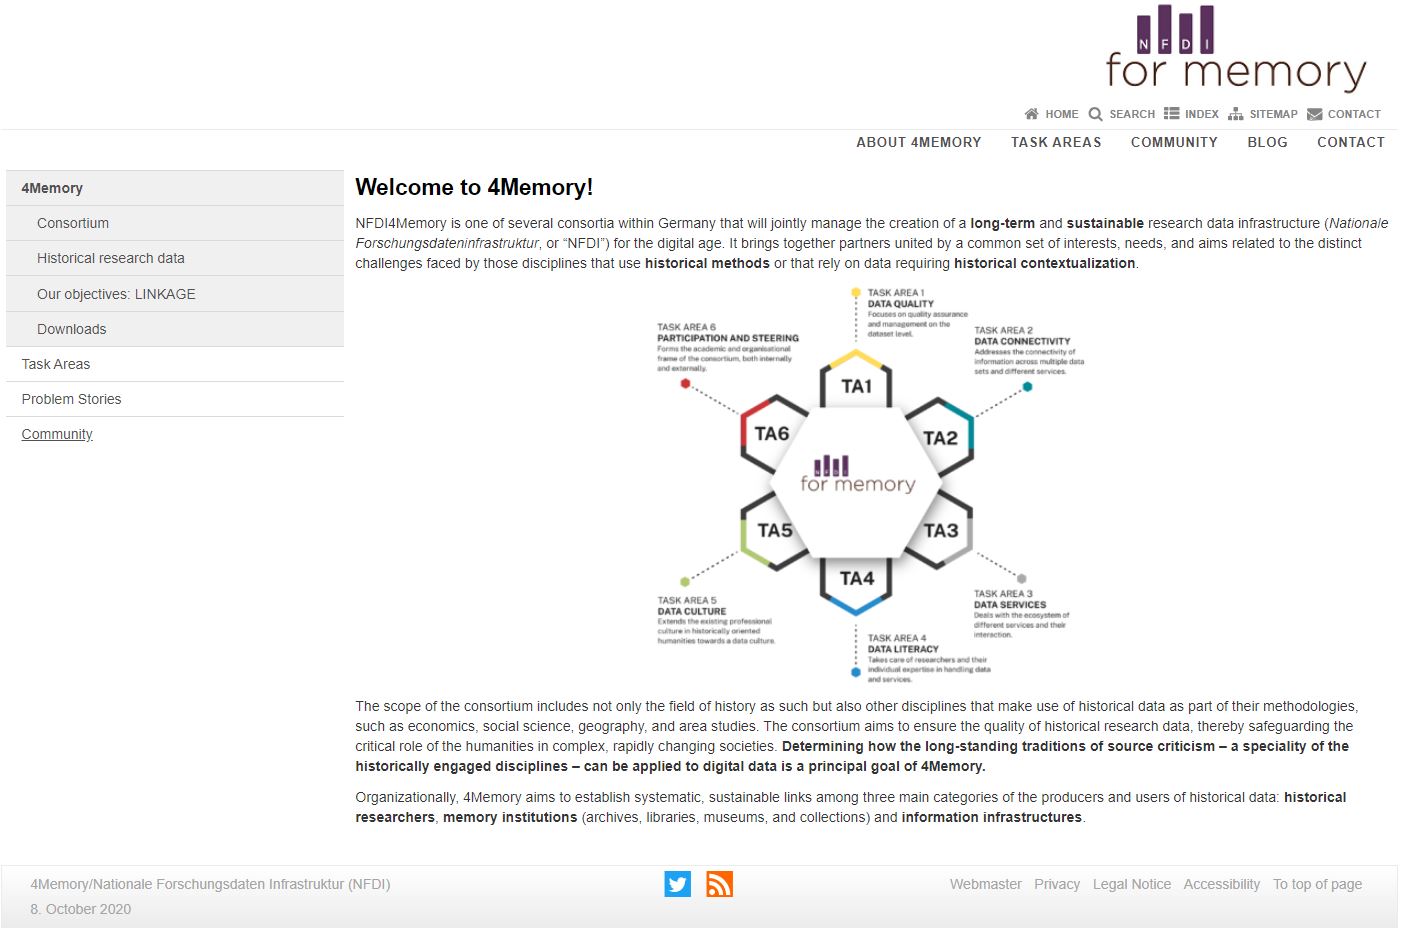
https://4memory.de/

It was therefore paramount for us to enter Germany’s present NFDI process. The process is on a trajectory of creating research data repositories in all the fields of the sciences and academic studies – repositories, that will eventually present their data under a broader search engine. We have entered this development as a “participant” of the NFDI’s upcoming 4Memory compound (the compound of the studies that are dealing with historical data).

Our present consideration is how to balance such an integration as a decidedly international site. We will need an international board of FactGrid Stakeholders since this is what we have become over the last three years: an international platform using a multilingual software in order to interconnect research across the borders.
FactGrid GYIK – Miért használjam a FactGridet a kutatási projektemhez?

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).

in English
auf Deutsch
en français

  1. Mi a FactGrid?
  2. Miért használjam a FactGridet a saját kutatásomhoz?
  3. Miért ne egyből a Wikidatát használjam?
  4. A FactGrid ingyenes – hogy működik ez?
  5. Mihez kezdhetek az unortodox kutatási témákkal?
  6. Milyen segédeszközöket biztosít a szoftver?
  7. Mit tegyek, ha a saját platformomon szeretném megjeleníteni az adatvizualizációm?
  8. A FactGrid CC0-licenc alatt teszi közzé az adatokat – ez azt jelenti, hogy lemondok a kutatásom jogairól?
  9. Mi történik, ha szeretném az adataimmal egy másik platformon folytatni a munkát?
  10. Mi történik, amikor FactGrid-felhasználók a “helyes” dátumról vitatkoznak?
  11. Miért kockáztassam meg az átláthatóságot rögtön a projektem kezdetétől?
  12. Mi kell ahhoz, hogy a FactGrid befogadja a projektem?

Mi a FactGrid?

A FactGrid egy Wikibase-alapú platform történeti adatokkal dolgozó projekteknek számára, amely egyszerre hagyományos wiki és adatbázis. Az oldalon állításokat rögzíthetsz az általad feltöltött vagy téged érdeklő elemekről, majd ezeket szinte bármilyen nyelven tudod használni és megjeleníteni.

A platform szervezője a Gotha Kutatóközpont, a szervert pedig ThULB Jena biztosítja.

Együttműködésben a Wikimédia Németországgal és a Német Nemzeti Könyvtár GND-adatbázisával szeretnénk elhelyezni a platformot mint kutatási adatokra építkező erőforrást a kialakulóban lévő, összekapcsolt Wikibase-oldalak rendszerében.

Miért használjam a FactGridet a saját kutatásomhoz?

A fő érv a FactGrid mellett a verhetetlenül rugalmas szoftver, a Wikibase, amelyet a Wikimédia Németország segítségével, elsődleges felhasználási helyén, a Wikidatán kívül, egy kísérleti projekt keretében implementáltunk:

  • Egy olyan szoftvert keresel, amely gyakorlatilag bármilyen nyelven tud beszélni? Egy platformot, ahol felvihetsz adatokat a saját nyelveden, mások pedig a saját anyanyelvükön olvashatják ugyanezt, és fordítva? Ez a szoftver a Wikibase.
  • Egy olyan szoftverre van szükséged, amivel átlátható módon koordinálhatsz egy egész kutatói csapatot? A Wikibase-zel ez ugyanolyan könnyű, mint a Wikipédia szoftverével, a MediaWikivel.
  • Egy olyan adatbázisszoftvert keresel, amely tud mindent, amire egy digitális bölcsészeti adatbázisnak szüksége lehet: kapcsolatháló-elemzés, térképes megjelenítés, komplex összekapcsolt keresések, megjelenítés többféle idővonalon? Egy szoftver, amely szinte emberi nyelvként működik, és még teljes körű adatbázis szolgáltatással is rendelkezik? A Wikibase ez a szoftver.
  • Szeretnél egy előző projektedből származó adatgyűjteményre építeni? A Wikibase-en lehetséges a nagy mennyiségű, automatizált adatbevitel.
  • Szeretnél biztosra menni, hogy más projektek is hozzáférnek az adataidhoz, és ténylegesen fel is tudják használni azokat? A platformról könnyen letöltheted az összes adatot, hogy offline, Excelben vagy bármilyen más online projektben dolgozhass velük.
  • Szeretnél teljesen új kérdéseket feltenni a kutatásodban? A Wikibase-en bármelyik elemet összekapcsolhatod bármiféle állítással.
  • Aggódsz, hogy mi történik majd az adataiddal miután véget ér a kutatásod finanszírozása? Támaszkodj egy platformra, ahol nem egyedül dolgozol, ami olyan licenc alatt működik, amely lehetővé teszi másoknak is, hogy folytassák a munkát az adataiddal és eszközeiddel.

Ha hosszú távú perspektívát keresel, akkor ezt szeretnénk nyújtani a Német Nemzeti Könyvtárral való együttműködésünkkel. A platform egyik támpillére a GND-adatgyűjtemény lesz, ami által széles körben használható eszközként működhetünk. Továbbá célunk ezzel, hogy fontos szereplőjévé váljunk az összekapcsolt Wikibase-rendszerek kialakuló világának.

Miért ne egyből a Wikidatát használjam?

Ez egy teljesen jogos kérdés. Vannak olyan projektek (amelyek elsősorban csak felhasználják adatokat), amelyekhez a Wikidata megfelelőbb platformot nyújt. Az FH Potsdam “Archivführer zur deutschen Kolonialzeit” nevű projektje remekül illusztrálta annak szépségét, amikor közvetlenül Wikidatára dolgozunk – erről beszélgettünk Uwe Junggal, aki bemutatta, milyen technikai megoldásokat használtak Potsdamban.

Ugyanakkor alapvetően két dolog van, amiket nem fogsz tudni sem a Wikidatán, sem egy GND-hez hasonló platformon csinálni: a Wikimédia-projektek (és a GND) szigorú szabályokkal rendelkeznek arról, hogy nem közölhető saját kutatómunka, és döntéseiket nevezetességi kritériumok alapján hozzák meg, ami nem enged teret tetszőleges adatbázis-elemek létrehozásának vagy tárgyak közötti kísérleti kapcsolatok tesztelésének.

A Wikidata és a GND olyan információkra koncentrálnak, amelyeket már korábban publikáltak és a kutatást nem végző alkalmazottak már közzétett kutatásokból viszik fel az adatokat. Ezeken a platformokon nem tudsz létrehozni munkahipotézisként szolgáló állításokat a kutatásodhoz. Nem hozhatsz létre elemeket kizárólag azzal a céllal, hogy majd statisztikai elemzést végezhess rajtuk a munka egy jóval későbbi szakaszában.

A FactGriden bátorítjuk a platform használatát heurisztikus kutatási eszközként.

  • Létrehozhatsz elemeket az adatbázisban függetlenül attól, milyen relevanciájuk lenne egy enciklopédiában vagy könyvtári katalógusban.
  • Megkockáztathatsz ideiglenes kronológiákat, egyéni feltevéseket kiinduló hipotézisként.
  • Használd a FactGridet nem konvencionális állításokhoz, amelyek jelenleg csak a saját kutatási projekted számára érdekesek – a szoftver lehetővé teszi ezt a fajta szabadságot.
  • Hozz létre adatbázis elemeket, amelyek részletezik, a kutatásod során milyen adatgyűjteményeket módosítottál jelentős mértékben. Ezáltal könnyen benyújthatod ezt az adott elemet mint a kutatásodat összegző “mappát” a téged finanszírozó intézménynek.
  • A platformon megkockáztathatsz bármilyen új tézist, és egy saját adatbázis elemben összegezheted mint “mikro-publikációt”, ezáltal is láthatóvá téve a hozzájárulásod.

A FactGrid ingyenes – hogy működik ez?

A szoftver ingyenesen használható, és folyamatosan fejlesztik a Wikimédia projektek közösségei, illetve a Wikibase-t használó intézmények.

A FactGrid platformot a Gotha Kutatóközpont szolgáltatja az Erfurti Egyetem virtuális szerverén. A német URL évi 36 eurós költséget jelent, ezt a Gotha Kutatóközpont fedezi.

Az összes Wikidata-segédeszköz a felhasználóink rendelkezésére áll. Ezek biztosítják az átlag digitális bölcsészeti projekthez szükséges összes funkciót.

Mivel mind a szoftver, mind az eszközök nyílt forráskóddal rendelkeznek, bármilyen általad kedvelt szoftverrel módosíthatod őket, ha új alkalmazási módra van szükséged.

Ha saját eszközeiddel is hozzájárulsz a nyílt rendszerhez, biztosíthatod, hogy jövőbeli projektek is használhatják és fejleszthetik ezeket.

Amennyiben olyan technikai megoldásokra törekszel, amelyeket később anyagi haszonért értékesíthetsz, a szoftver licence ebben sem fog meggátolni. Szabadon kereskedelmi alapokra helyezhetsz bármit, amit nyílt forráskóddal építettél.

Mihez kezdhetek az unortodox kutatási témákkal?

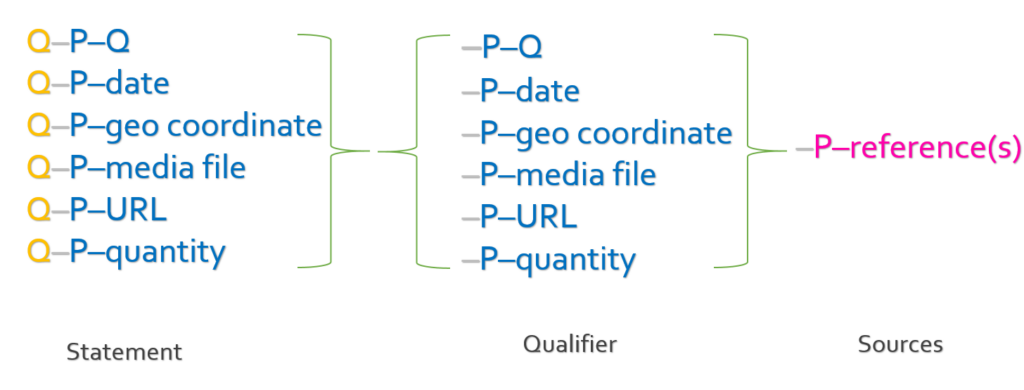
A Wikidata úttörő adatmodellel rendelkezik. A felhasználó gyakorlatilag csak kapcsolatokat hoz létre Q-számok között (vagy kapcsolatokat Q-számok és időpontok, Q-számok és földrajzi koordináták, Q-számok és médiafájlok, Q-számok és URL-ek között).

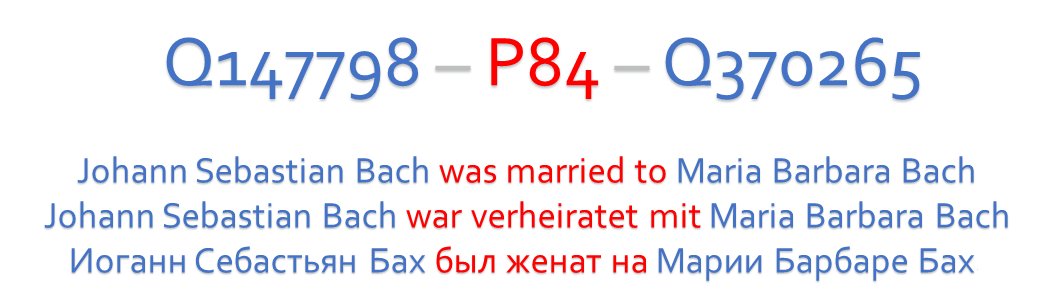
A szoftver maga nem tudja, milyen típusú kapcsolatokat hozol létre – ezek szintén csak P-számok: a Q1 – P1 – Q2 egy ún. “triple”, ami jelentheti, hogy “Johann Sebastian Bach (Q1) fia (P1) Carl Philipp Emanuel Bach (Q2)”, de azt is, hogy “Az archívumban talált, XY raktári jelzetű levél (Q1) állítólagos feladási helye (P1) München (Q2).”

Q-számokat bármihez hozzárendelhetünk – emberekhez, dokumentumokhoz, eseményekhez, eszmékhez… Te döntöd el, milyen P-számokra van szükséged az általad kívánt állításokhoz. Az elemeket nem egy rögzített, módosíthatatlan kategóriarendszerben kell meghatároznod, a létrehozott állításaid pedig új árnyalatot és szilárdságot adnak az új vagy meglévő elemekhez. Ne aggódj, ha nem rögtön az első napon áll össze az adatmodelled. Hozd létre folyamatosan az állításokat, amikor csak szükséged van rájuk, közben figyeld, hogy érik el a kritikus tömeget, amellyel kiértékelhetővé válnak.

Minden állítás “minősíthető” – “Johann Sebastian Bach (Q1) felesége (P2) Maria Barbara Bach (Q2) házasság kezdete (P2) 1707. október 7. (dátum),  házasság vége (P3) 1720. július 5 körül (dátum).” Ezeket az állításokat ugyanakkor hivatkozásokkal is elláthatjuk: “erre bizonyíték (P4) XY egyházi évkönyv (Q3)”,”állítás forrása (P5) XYZ Bach-életrajz (Q4)”.

A rendszerben lehetséges egymással versengő értékeket megadni, mindössze külön-külön forrásmegjelölést kapnak, illetve rangsorolni is lehet őket.

Ilyen mélységben meghatározott triple-ekkel gyakorlatilag bármilyen állítást létrehozhatsz, ami viszont még fontosabb, ezzel lehetőséged nyílik állításokat létrehozni bármely nyelven. A rendszer Q- és P-számokkal működik, minden egyéb pedig címke, amit azon a nyelven adhatsz meg, amelyet fel szeretnél kínálni a felhasználónak. Ezen felül a szoftver automatikusan lefordítja a dátumokat és mértékegységeket az adott nyelv által használt formátumra. Ez a titka annak, hogy a Wikibase-platformokat mindenki a saját nyelvén szerkesztheti, miközben az egész világon olvasható szinte bármilyen nyelven.

Milyen segédeszközöket biztosít a szoftver?

Készíthetsz adatbázis-bejegyzéseket egyesével: nyisd meg a szerkeszteni kívánt elemet, menj a beviteli lap aljára, és kattints az “állítás hozzáadása”-linkre. Itt kell megadnod, milyen állítást szeretnél létrehozni. Nem szükséges fejből tudnod a P-számot, kezdd el begépelni a tulajdonság nevét a saját nyelveden, majd válassz a felkínált lehetőségek közül az automatikus befejezéshez. A platform tudni fogja az adott állítás P-számát. Az állítás második részét a következő szövegdobozban adhatod meg, szintén elég elkezdeni begépelni.

Excel- és CSV-listákból, automatikus bevitellel is készíthetsz adatbázis bejegyzéseket. (Itt találod a beviteli felületet, itt pedig egy rövid útmutatót hozzá.)

Az adatbázis-lekérdezéseket SPARQL nyelven kell megfogalmazni. Ez (sajnos) nem egy könnyű keresőnyelv, de végső soron annyira komplex, mint a futtatni kívánt keresések.

A SPARQL-t használók nem feltétlen tudnak SPARQL-forráskódot írni. Általában keresési mintákat tudsz használni, amik megmutatják, hol kell változtatnod a bevitt szövegen, hogy lefuttathasd a saját keresésed.

Amennyiben pontosan tudod, milyen típusú keresési lekérdezést kell futtatnia a felhasználóidnak, készíthetsz a könyvtárak megszokott online felületeihez hasonló, egyéni beviteli maszkokat, amelyek majd SPARQL-ben kommunikálnak az adatbázissal.

A szoftvercsomag tartalmaz illusztrációs lehetőségeket térképekhez, idővonalakhoz, hálózatokhoz, genealógiai kapcsolatokhoz, grafikonokhoz, stb. Nem kell letöltened egyéb, külső alkalmazásokat. A SPARQL-en keresztül kérheted az általad kívánt reprezentáció létrehozását. Gyönyörű bemutatót láthatsz vizualizációkból, ha felkeresed a Wikidata Scholia-projektjét.

Mit tegyek, ha a saját platformomon szeretném megjeleníteni az adatvizualizációm?

Ennek nincs technikai akadálya. Uwe Jung demonstrálta, hogyan használja az FH Potsdam felülete a Wikidatát adattárként úgy, hogy közben a felhasználók nem látják a háttérben lévő adatbázist.

Nincs semmi gond azzal, ha a FactGridet külső adattárként használod, és a saját kutatási projekted az egyetemed szerverén építed fel, ahol célzott adatbázis-hozzáférést teszel lehetővé saját keresősablonon keresztül.

A FactGrid CC0-licenc alatt teszi közzé az adatokat – ez azt jelenti, hogy lemondok a kutatásom jogairól?

Ha a Creative Commons 0-licencet választod, továbbra is teljes szabadsággal használhatod az adataidat, amire csak szeretnéd  – te irányítasz, és nem a kiadó vagy az adatokat kezelő platform. Ezen felül a CC0 azt jelenti, hogy az adataid szabadon felhasználhatóvá válnak mások által is. Mivel a közösség így bármikor kijavíthatja az észrevétlenül maradt hibákat, csökken annak a kockázata, hogy hosszabb távon elavuljon a kutatásod.

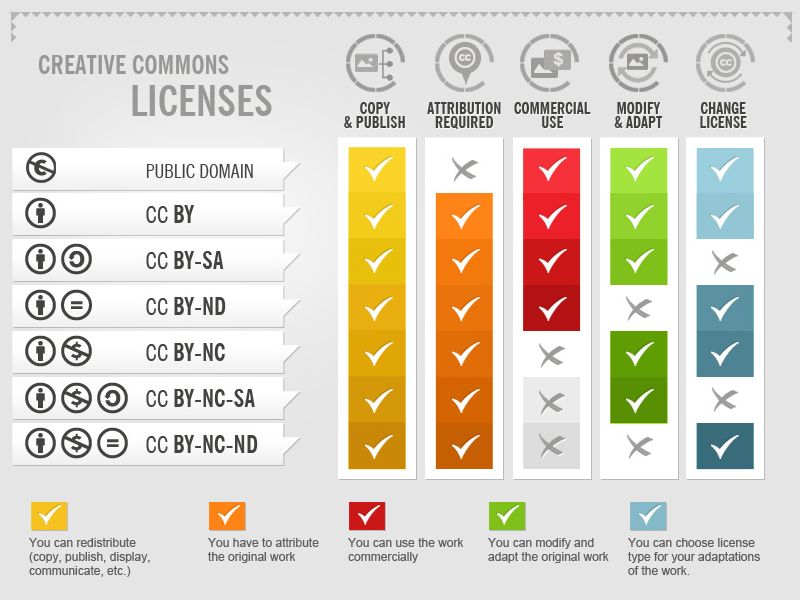
Néhány megfontolandó tényező: Tudósok számára első pillantásra a CC BY 4.0-licenc tűnik kedvezőnek. Ez engedélyezi az ingyenes felhasználást, amennyiben az megfelelően módon megjelöli a forrást. A gyakorlatban ez működhet szövegeknél (mint ez a blogposzt), mivel itt egyértelmű, hogy milyen hivatkozást szeretnénk látni: a nevünk megadásával, a publikáció címével, a kiadás helyével és dátumával. De szeretnéd, hogy az adataid idézetként szerepeljenek, például egy vizualizációban? Egy 1753 júniusában Párizsból Berlinbe küldött levél a térképen egy vonalként szerepel – hogyan lássuk el ezt megfelelő jegyzetekkel? Hogyan idézzenek téged, ha csak javításokat végeztél egy adathalmazon? Az “Így add tovább”-licencek még problematikusabbak: ezek az adatok szabadon hozzáférhetők bárki számára, amennyiben a további felhasználók is ugyanezekkel a feltételekkel osztják meg. Ez úgy hangzik, mint a szabad felhasználás melletti határozott kiállás. De egy al-felhasználó hogyan tudja biztosítani, hogy az ő al-felhasználói is betartják a licencbe foglalt feltételeket (főleg ha ez az al-felhasználó CC0 alatt teszi közzé az adatokat)? Az al-felhasználóknak általában azt tanácsolják, ne használjanak adatokat CC-BY vagy CC Így add tovább licenccel rendelkező platformokról.

A Wikidatával és a Német Nemzeti Könyvtárral közös vállalkozásunk egyetlen lehetőséget hagyott számunkra: hogy partnereinkhez hasonlóan szabadon felhasználhatóvá tegyük az adatainkat. A CC0-licenc által nem biztosított, hogy a további felhasználók is feltüntetik majd, ki gyűjtötte az adatokat, illetve felhasználásuk feltételeit.

A gyakorlatban a legtágabb nyílt licenc nem jelenti azt, hogy a FactGrid-adatok szerző nélküliek, épp ellenkezőleg. Mi azt szorgalmazzuk, hogy hivatkozzunk a kutatásra, és megelőlegezzük, hogy a Wikidata és a GND is boldogan feltünteti, ha a kutatás a mi platformunkról származik.

A FactGriden minden szerkesztéshez kapcsolva van a szerző neve. Ha egy kutatási projekt lényeges mértékben járult hozzá egy adatgyűjteményhez, akkor ezt jelezhetik egy külön jegyzetben, amelyet tovább lehet adni adatátvitelnél.

A Wikidatához vagy a GND-hez hasonló adatbázisok amúgy érdekeltek is a kutatások hivatkozásában – ez hozzájárul az adataik szilárdságához. A FactGrid abban a különleges helyzetben van, hogy mindkét szervezet számára olyan platformot szolgáltat, ahol a felhasználók olyasmiket csinálhatnak, ami saját, nagyobb platformjaikon nem engedett.

Mi történik, ha szeretném az adataimmal egy másik platformon folytatni a munkát?

Mivel szerzői jogi korlátozások nélkül vitted fel az adatokat, szabadon dolgozhatsz velük bárhol máshol. Valójában örülünk is, ha afféle inkubátor lehetünk kutatási adatok számára.

Mi történik, amikor FactGrid-felhasználók a “helyes” dátumról vitatkoznak?

A szoftver lehetővé teszi az egymásnak ellentmondó adatok kezelését – ez különösen fontos a történelmi kutatás területén, ahol gyakran találunk egymásnak ellentmondó forrásokat anélkül, hogy biztosan tudjuk, melyikük állítása igaz. A szoftverrel reprodukálhatjuk az ellentmondásos helyzetet, az állításokat pedig külön-külön alátámaszthatjuk hivatkozásokkal. Az eltérő állításokat súlyozhatjuk is egymáshoz képest – például a jelenleg irányadó állítást az egyéb variánsokkal szemben, vagy akár minősítőkkel az egyéni kiértékeléshez.

Tekintsük inkább érdekes helyzetként arra, amikor két kutató eltérő eredményekre jut. Sokkal rosszabb, amikor egy olyan platformon hibázol, ahol sosem lesznek kijavítva, és hitelteleníthetik az egész munkádat.

Miért kockáztassam meg az átláthatóságot rögtön a projektem kezdetétől?

Ez kemény dió, valószínűleg ez gátolja meg a legtöbb projektet, hogy használja a FactGrid erőforrásait. Az alternatíva egy platform, amihez csak a jelszóval rendelkező csapat férhet hozzá a projektet lezáró publikáció határidejéig. Így, szól az érv, semelyik versengő projekt sem tudja elcsaklizni a kutasi eredményeket. Senki sem látja, hol hibáztál az elején. Senki sem rögzíti, melyik adatot vitték fel asszisztensek és melyiket a projektvezető – ehhez hasonlók a feltételezett előnyei a nem átlátható munkának egy olyan platformon, amely csak a finanszírozás végével lesz online elérhető.

Az átlátható kutatás saját biztosítékokkal rendelkezik. Ha egy találsz egy minden eddigit felülíró dokumentumot vagy rögzítesz egy úttörő kapcsolódási pontot, akkor itt a lehetőség, hogy a saját nevedhez és projektedhez kösd az állítást. Ha holnap valaki ellátogat ugyanabba az archívumba és szintén felfedezi, amit te – pech, hiába. Te már rögzítetted a megfigyelést a platformon, amit a laptörténetben lekövethető változtatás minden kétséget kizáróan bizonyít.

Mindeközben a kollektív platform  meghívásként is működik az együttműködésre. Tedd egyértelművé a többi csapat számára, min dolgozol, hogy felvehessék veled a kapcsolatot.

Egy elméletileg biztonságos, csak a projekt végén nyilvánosságra hozott weboldal kockázatai komolyak. A felhasználókkal ekkor már nem lehetséges ötleteket cserélni. Az internetes jelenlét időzítése a projekt rohanós utolsó heteire esik, amikor már nem lehetséges semmiféle, koncepciót érintő változtatás. Ha a kutatást kizárólag egy könyves publikációhoz végeztétek, bizonytalan marad, mihez kezdjen a csapat a Word- és Excel-fájlokban összegyűjtött adatokkal. Senki sem tudja ekkor felvinni az adatokat egy nagyobb erőforrásba – egy ilyen késői fázisban a harmonizáció szinte megugorhatatlan akadály. Csak reménykedni lehet, hogy a könyv olvasói beszkennelik az összes lábjegyzetet, hogy a bennük lévő korrigálások elérhessék a könyvtári katalógusokat és a különféle Wikimédia-projekteket. A kockázatot itt a könyv jelenti, amely semmiféle hatással nincs a kollektív adatbázisra, illetve a digitális bölcsészet projektek, amelyek publikáció után elavulnak.

A jövő inkább egy újfajta hozzáállásban kell keresni egy közös, nyilvános adatbázis felé. A kutatóknak képesnek kell lenniük javítani és bővíteni ezt az adatbázist bárhol, bármikor hozzáférve. Az szükséges motivációt és biztonságot a kutató környezet jelenti, ahol megjelölhetik és idézhetővé tehetik saját munkájukat. Erre a Wikibase bármely más szoftvernél alkalmasabb.

Mi kell ahhoz, hogy a FactGrid befogadja a projektem?

A FactGrid-platformnak nincs láthatatlan mélyrétege. Bárki lekérdezhet az adatbázisból, és ugyanazt az eredményt fogja kapni akár be van jelentkezve, akár nincs. A személyes felhasználói fiók annyi előnnyel jár, hogy kiválaszthatod a kívánt nyelvet, miközben az adatokat böngészed, illetve lesz egy “szerkesztés”-link minden állítás alatt.

Ha szeretnéd betáplálni az adataid a FactGridbe, és ha szeretnél egy projektet futtatni a platformon, akkor szükséged lesz felhasználói fiókra. Ezt a valódi neved megadásával kaphatsz az adminisztrátoroktól. Ehhez az oldalon találsz egy “Request account” (felhasználó fiók igénylése) szövegű linket. E-mailben is felveheted velünk a kapcsolatot. Projektvezetők kaphatnak adminisztratív fiókokat, amivel kijelölhetnek csapattagokat, projekthez kapcsolódó személyeket.

Miután bejelentkeztél, felvihetsz adatokat nagy mennyiségben vagy végezhetsz meghatározott javításokat bármelyik elemen. Minden változtatásod a felhasználói fiókodhoz lesz kapcsolva. Mások visszavonhatják a szerkesztéseid, de nem nyomtalanul, dokumentálva lesz az elem történetében, mindenki láthatja.

Ha egy összetettebb projekten szeretnél dolgozni, —

  • ami lehet személyes családkutatás,
  • lehet egy egyszeri vizualizáció egy szemináriumi dolgozathoz,
  • vagy akár több ezer tételnyi adat bevitele egy 5 éves projekt folyamán

— egyeztess a többi felhasználóval és a platform szervezőivel. Nem (feltétlen) fogunk egy nyilvános egyetértési nyilatkozatot aláírni, de a blogunkon hírt adhatunk a projektedről, hogy eljusson mindenkihez a platformon. A munka akkor válik igazán izgalmassá, amikor mások befejezett munkáját módosítod, illetve amikor más projektek résztvevőit inspirálod az általad bevezetett modellezés használatára. Nem kötelező átbeszélni az adatmodelleket a többiekkel, de a modellek megosztása segíthet a kutatásodnak új embereket elérni, illetve felhasználhatók lesznek mások által létrehozott lekérdezésekben vagy vizualizációkban.

A szoftvert arra tervezték, hogy kezelni tudja mind az olyan állításokat, amelyek csak számodra érdekesek, mint azokat, amelyek az eredeti kutatási témádnál jóval távolabbra elérnek majd.

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).
Jack Kirby, “The Fourth Dimension is a many splattered thing!”, Alarming Tales, 1 (1957. szeptember).

FAQ FactGrid – Pourquoi devrais-je utiliser FactGrid pour mon projet de recherche ?

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).

auf Deutsch
in English
magyar nyelven

Qu’est-ce que FactGrid ?

FactGrid est une installation Wikibase – c’est-à-dire à la fois un wiki ordinaire et une base de données que vous pouvez utiliser pour faire des déclarations sur les objets qui vous intéressent – déclarations que vous pouvez ensuite traiter sur de grands jeux de données dans pratiquement toutes les langues.

La plate-forme est gérée par le Centre de recherche de Gotha et hébergée par l’ThULB Iéna. Elle s’adresse à des projets ayant un intérêt spécifique pour les données historiques.

En collaboration avec Wikimedia Allemagne et le GND de la Bibliothèque nationale allemande, nous essayons d’intégrer cette plateforme dans le prochain consortium d’instances fédérées de Wikibase comme ressource pour les « données de recherche ».

Pourquoi devrais-je utiliser FactGrid pour mes propres recherches ?

Le principal argument en faveur d’un compte FactGrid est la flexibilité imbattable du logiciel Wikibase, que nous avons réussi à installer, dans le cadre d’un projet pilote, en dehors de son site principal Wikidata et avec l’aide de Wikimedia Allemagne :

  • Vous recherchez un logiciel qui parle pratiquement toutes les langues – une plate-forme où vous pouvez entrer des données dans votre propre langue tout en permettant à d’autres de les lire dans leur propre langue ? Wikibase est ce logiciel.
  • Vous recherchez un logiciel qui vous permet de coordonner toute une équipe de manière transparente ? Dans Wikibase, c’est aussi simple que dans le logiciel MediaWiki de Wikipedia.
  • Vous recherchez un logiciel de base de données qui peut faire tout ce que les bases de données d’humanités numériques veulent normalement faire : analyses de réseau, représentations cartographiques, recherches croisées complexes, frises chronologiques (dans différents formats) – un logiciel qui se comporte presque comme un langage humain, tout en fournissant des services complets de base de données ? Wikibase est ce logiciel.
  • Vous avez des données provenant de projets antérieurs que vous voulez développer ? Wikibase dispose d’options de saisie automatique à grande échelle.
  • Vous voulez que vos données puissent être réutilisées ? Wikibase permet le téléchargement et le travail avec vos données, aussi bien hors ligne dans Excel qu’en dligne dans le cadre de nouveaux projets.
  • Vous voulez poser des questions entièrement nouvelles pour votre recherche ? Dans Wikibase, vous pouvez lier n’importe quel objet à n’importe quelle déclaration en fonction de vos intérêts.
  • Vous vous demandez ce qu’il adviendra de vos données et de vos outils de présentation une fois votre projet terminé ? Comptez sur une plate-forme sur laquelle vous ne travaillez pas seul et utilisez une licence de données qui permettra à d’autres personnes de continuer à travailler avec votre travail sans aucun risque !
  • Vous voulez poser des questions entièrement nouvelles dans votre recherche ? Dans Wikibase, vous pouvez relier n’importe quel type d’objet à n’importe quelle déclaration d’intérêt.
  • Vous vous inquiétez de ce qui arrivera à vos données et à vos présentations une fois votre financement terminé ? Comptez sur une plateforme où vous ne travaillez pas seul et utilisez une licence de données qui permet à d’autres de continuer à travailler à la fois avec vos données et vos outils !

Si vous recherchez une perspective à plus long terme, c’est ce que nous essayons d’offrir grâce à notre accord de collaboration en cours avec la Bibliothèque nationale allemande. Nous baserons notre plate-forme sur les données GND afin d’en faire aussi un outil grand public, avec pour objectif de devenir un acteur dans le paysage émergent des “installations fédérées Wikibase”.

Pourquoi ne pas utiliser Wikidata dès maintenant ?

C’est une question légitime à poser. Il y aura des projets (qui utilisent principalement des données) pour lesquels Wikidata sera la meilleure plateforme, comme l’Archivführer zur deutschen Kolonialzeit de la FH Potsdam. Reste que les projets Wikimedia (de même que GND) ne laissent pas de place à la recherche originale. Ils fonctionnent sur des “critères de notoriété” qui ne permettent pas la création à volonté d’objets et de relations entre objets innovants que les chercheurs voudraient tester.

Wikidata et le GND se concentrent sur les informations qui ont déjà été publiées ; ils mobilisent des travailleurs non chercheurs qui alimentent leurs bases de données à partir de recherches déjà publiées. Vous ne serez pas autorisé sur ces plateformes à énoncer des “hypothèses de travail” relevant de “votre recherche”. Vous ne pourrez pas créer des objets de base de données dans le seul but de mener sur eux à un stade ultérieur de votre recherche “rien de plus qu’une analyse statistique”.

Dans FactGrid, nous encourageons au contraire l’utilisation de la plate-forme comme un outil de recherche heuristique.

  • Créez des objets de base de données sur la plate-forme, quelle que soit par ailleurs leur pertinence pour une encyclopédie ou un catalogue de bibliothèque.
  • Risquez comme hypothèses de travail des chronologies provisoires en fonction de vos intérêts personnels.
  • Utilisez FactGrid afin de faire des déclarations non conventionnelles et qui n’ont d’intérêt que pour votre projet de recherche – le logiciel vous donne cette liberté.
  • Créez des objets de base de données spécifiques mentionnant votre projet de recherche dans les jeux de données que vous aurez substantiellement modifiés, ce qui vous permettra d’identifier votre contribution lorsque vous soumettrez votre recherche à votre institution de financement.
  • Risquez de nouvelles hypothèses sur la plateforme et indiquez votre point de vue par un numéro d’objet de base de données (servant en quelque sorte de “micro-publication”), afin d’attester de votre inventivité sur la base de données.

FactGrid est gratuit – comment est-ce possible ?

Le logiciel est disponible gratuitement et en cours de développement dans la communauté plus large des projets Wikimedia et au sein des institutions qui entendent utiliser Wikibase dans les prochaines années.

La plate-forme FactGrid est gérée par le Centre de recherche de Gotha sur un serveur virtuel de l’université d’Erfurt. L’URL allemande coûte 36 euros par an en frais de domaine, financés par le Centre de recherche de Gotha.

Tous les outils Wikidata sont à la disposition de nos utilisateurs. Ils comprennent toutes les applications standard dans les projets d’humanités numériques.

En outre, les logiciels et les outils étant open source, vous pouvez faire appel à votre prestataire de service informatique extérieur pour développer l’application spécifique dont vous auriez besoin.

Proposez à la communauté FactGrid vos propres développements d’outils et de présentation, ce sera le meilleur moyen pour que vos propres visualisations continuent à être développées après la fin du financement de votre projet. Si vous visez plutôt des solutions que vous voulez vendre, vous ne serez pas limité par la licence du logiciel. Vous pourrez commercialiser librement tout ce que vous aurez créé sur la base du logiciel ouvert.

Que dois-je faire des demandes de recherche non orthodoxes ?

Wikibase fait œuvre de pionnier dans la modélisation des données. Pour l’essentiel, vous ne créez que des relations entre des numéros Q (ou entre des numéros Q et des dates, des numéros Q et des coordonnées spatiales, des numéros Q et des fichiers média, des numéros Q et des URL).

Le logiciel ignore le type sémantique des relations que vous avez créées- il s’agit là encore de simples numéros P : Q1 – P1 – Q2 est un “triplet”, qui peut tout aussi bien signifier “Jean-Sébastien Bach (Q1) est le père de (P1) Carl Philipp Emanuel Bach (Q2) ” que “Cette lettre que j’ai trouvée dans les archives avec la cote XYZ (Q1) aurait été envoyée de (P1) Munich (Q2)”

Les numéros Q peuvent être attribués à toute espèce d’identité : personnes, documents, événements, idées… C’est vous qui décidez des types des numéros P dont vous avez besoin pour faire les déclarations qui vous intéressent. Vous n’avez pas à définir les objets dans un système de catégories a priori ; ce sont vos déclarations qui ajoutent de la chair aux objets que vous créez au fur et à mesure. Ne vous inquiétez pas si vous n’avez pas de modèle de données dès le premier jour. Faites des déclarations dès que vous en avez envie et voyez comment elles acquièrent la masse critique. C’est alors seulement que vous pourrez juger de la valeur de l’ensemble.

Toutes les déclarations peuvent elles-mêmes être « qualifiées » – “Jean-Sébastien Bach (Q1) était marié avec (P2) Maria Barbara Bach (Q2) à partir du (P2) 7 october 1707 (date) jusqu’à (P3) environ 5 juillet 1720 (date).” Toutes ces déclarations peuvent à leur tour être dotées de références : “cela ressort du (P4) registre paroissial de… (Q3)”, ”cela est indiqué dans (P5) la biographie bien connue de Bach XYZ (Q4)”.

Le système permet à tout moment de proposer des affirmations concurrentes. Elles sont simplement introduites avec leurs différentes sources et peuvent être comparées les unes avec les autres.

En fin de compte, n’importe quelle déclaration en langue naturelle peut être générée avec des triplets de ce genre, mais, surtout, cela permet d’exprimer cette déclaration dans n’importe quelle langue du monde : pour le système, toutes les déclarations ne sont que des liens entre des numéros Q et des numéros P. C’est vous seul qui attribuez aux numéros Q et P des “libellés” et des “définitions” qui leur donnent sens, et cela dans les langues avec lesquelles vous communiquez (le système gère par ailleurs les informations de date et de quantité dans toutes les normes mondiales avec une conversion automatique dans n’importe quelle direction) ; c’est là le secret des plateformes Wikibase, qui permet aux auteurs de saisir les informations dans leurs langues respectives et aux utilisateurs de lire ces informations dans n’importe quelle langue.

Quels sont les outils fournis par le système ?

Les entrées dans la base de données peuvent être effectuées une à une : ouvrez pour cela l’objet-id en question, allez au bas de la page de saisie et cliquez sur le lien “ajouter une déclaration”. Il vous sera alors demandé de saisir la déclaration que vous souhaitez faire. Vous n’avez pas besoin de connaître le numéro P. Il suffit d’indiquer l’objet dans la langue que vous utilisez et de cliquer sur l’auto-complétion qui vous est proposée. La plate-forme utilisera pour vous le numéro P de cette déclaration. Indiquez alors dans le champ qui s’ouvre l’objet de votre déclaration. Le système, là encore, vous proposera, à mesure que vous tapez le texte de votre déclaration, des suggestions de plus en plus précises.

Les entrées dans la base de données peuvent également être créées et enregistrées automatiquement à partir de tableaux Excel ou CSV. (Ceci est le masque de saisie et voici le guide succinct pour le faire).

Les requêtes dans la base de données doivent être formulées sous forme d’interrogations “SPARQL”, un langage de requêtes qui n’est (malheureusement) pas si facile à utiliser, mais qui, au fond, n’est pas plus complexe que les recherches que vous pourriez vouloir effectuer.

Le plus souvent les utilisateurs de SPARQL ne savent pas écrire leurs requêtes dans le code source. Vous pouvez cependant utiliser des modèles de requêtes où sont indiquées les entrées qu’il faut modifier afin d’exécuter votre recherche spécifique.

En outre, si vous savez exactement le type de requêtes que vos utilisateurs doivent exécuter, vous pouvez créer vos propres masques de saisie, comme ceux que vous utilisez dans les interfaces habituelles des bibliothèques en ligne, qui parleront alors SPARQL avec la base de données.

Le système comprend aussi des outils cartographiques, des frises chronologiques, des réseaux, des arbres généalogiques, des graphiques, etc. Vous n’avez pas besoin de télécharger des applications particulières. Vous demanderez à SPARQL de produire la représentation que vous essayez d’obtenir. Le projet Scholia sur Wikidata présente certaines de ces visualisations.

Que dois-je faire si je veux donner mes représentations de données sur ma propre plate-forme ?

Cela ne devrait pas poser de problème technique. Uwe Jung a montré comment l’interface de la FH Potsdam utilise Wikidata comme dépôt de données sans laisser les utilisateurs voir la base de données à laquelle ils accèdent.

Il n’y a rien de mal à utiliser FactGrid comme dépôt externe et à monter son propre projet de recherche sur le serveur de son université d’origine, en y proposant des accès ciblés à la base de données selon un modèle de recherche de son choix.

FactGrid octroie essentiellement des licences d’utilisation des données à CC0 – cela veut-il dire que je renonce à tous les droits sur mes recherches ?

Opter pour la licence Creative Commons signifie essentiellement que vous conservez tous les droits sur l’ensemble de vos données. Mais surtout, la licence CC0 signifie que vos données deviennent librement utilisables et que vous pouvez ainsi réduire le danger de recherches obsolètes à long terme.

Quelques considérations de base : CC BY 4.0 est à première vue la licence que les scientifiques préféreront. Elle permet l’utilisation gratuite des données à la condition que celles-ci soient correctement citées. En pratique, cela fonctionne pour les textes (comme ce billet de blog) ; dans ce cas, on voit clairement comment on aimerait que le texte soit cité : avec une référence à l’auteur, le titre de la publication, le lieu de publication et la date. Mais supposons que vous souhaitiez que vos données soient citées, disons dans une visualisation ? Une lettre envoyée de Paris à Berlin en juin 1753 se réduisant à une ligne sur une carte, comment cette ligne doit-elle être correctement annotée ? Comment voulez-vous être cité si vous n’avez fait qu’améliorer un ensemble de données existantes ? Les licences “share alike” sont encore plus problématiques : “Ces données sont disponibles gratuitement si les utilisateurs ultérieurs les gardent tout aussi libres”. Cela semble être le plaidoyer ultime pour la gratuité. Mais comment un sous-utilisateur peut-il s’assurer que ses sous-utilisateurs respecteront à leur tour votre contrat de licence (surtout si ce sous-utilisateur offre ses données sous CC0) ? Les sous-utilisateurs seront bien avisés de ne pas utiliser de données provenant de plateformes CC-BY ou CC Share-Alike.

Nos entreprises communes avec Wikidata et la Bibliothèque nationale allemande ne nous ont finalement laissé qu’une seule option : rendre nos données aussi librement disponibles que nos partenaires, autrement dit sous CC0, c’est-à-dire sans garantie que les utilisateurs ultérieurs préciseront toujours exactement qui a collecté les données, ni sur ce que les utilisateurs tiers seront autorisés à faire avec ces données.

 
En pratique, la licence ouverte maximale ne signifie pas que les données de FactGrid sont des données sans auteur, bien au contraire. Outre que nous suggérons aux utilisateurs de toujours citer la recherche qu’ils utilisent, nous faisons l’hypothèse que Wikidata et le GND souhaiteront renvoyer à la recherche sur notre plate-forme. Toutes les modifications apportées aux jeux de données sont liées par le système à nos vrais noms, visibles par tous les utilisateurs. Si un jeu de données a été tout particulièrement travaillé par un projet de recherche, vous pouvez l’indiquer dans une note à part qui sera transférée avec ce jeu de données. Vous pouvez également noter votre travail dans le jeu de données lui-même. Enfin, tout le monde peut interroger la base de données pour savoir quels jeux de données ont été travaillés dans le cadre d’un projet particulier.

En fait, les bases de données comme Wikidata ou le GND de DNB sont intéressées à citer la recherche – cela renforce la solidité de leurs données, et FactGrid est dans la position unique de fournir aux deux institutions une plate-forme sur laquelle les gens peuvent faire ce qu’ils ne pourraient pas faire sur leurs grandes plates-formes.

Que se passe-t-il si je veux continuer à travailler avec mes données sur une autre plateforme ?

Puisque vous avez saisi vos données sans restriction de droits d’auteur, vous pouvez travailler librement avec elles sur tout autre projet qui vous intéresse. En fait, nous aimons être “juste un incubateur” pour les données de recherche.

Que se passe-t-il si les utilisateurs de FactGrid se disputent sur une date “correcte” ?

Le logiciel permet de traiter des données contradictoires – ce qui est particulièrement intéressant dans le domaine de la recherche historique où nous disposons souvent de preuves documentaires contradictoires, sans pouvoir être certain de l’information correcte. Les noms sont traités avec des orthographes différentes ; il arrive que les historiens se contredisent.

Le système permet de reproduire la situation contradictoire ; il permet d’étayer les déclarations avec des dizaines de références et dans différentes orthographes.

Des déclarations divergentes peuvent être comparées les unes avec les autres – par exemple, la déclaration qui fait actuellement autorité et les variantes qui ne circulent qu’en raison des diverses sources contradictoires.

Que deux chercheurs arrivent à des résultats différents, voilà qui devrait en général vous intéresser. Le danger majeur est d’avoir fait une hypothèse erronée et qu’un autre projet sur une autre plateforme donne la solution de l’énigme et travaille sur la bonne date sans que vous le sachiez, ou pire, sans que vous ayez même la possibilité de corriger votre erreur des années après la fin de votre projet.

Pourquoi devrais-je risquer la transparence de mon projet dès le début ?

C’est probablement le problème le plus difficile, celui qui empêche actuellement certains projets d’utiliser la ressource que nous avons ouverte. L’alternative est une ressource accessible seulement avec un mot de passe aux membres de l’équipe jusqu’à la date de publication, c’est-à-dire quasiment jusqu’à la fin du projet. Aucun projet concurrent ne peut alors s’emparer des résultats, du moins en théorie. Personne ne peut voir l’erreur par où vous avez commencé et que vous avez ultérieurement corrigée. Personne ne peut voir non plus le travail fourni par les assistants qui entrent les données dans la base, ni l’implication réelle du chef de projet – tels sont les avantages supposés d’un travail non transparent sur une plateforme qui ne sera mise en ligne qu’à la fin de votre financement.

La recherche transparente offre ses propres garanties : si vous trouvez un document révolutionnaire et établissez une connexion décisive, c’est l’occasion d’attacher la découverte à votre nom et à votre projet. Si quelqu’un, demain, fait la même découverte dans les archives que vous venez de visiter, pas de chance pour lui : vous aurez enregistré votre observation avec un lien dans l’historique des versions que vos rivaux ne pourront pas nier.

En même temps, la plate-forme collective invite à coopérer. Expliquez clairement aux autres équipes sur quoi vous travaillez et permettez-leur de vous contacter sur la plate-forme !

Les inconvénients d’un site web prétendument sécurisé et qui ne sera mis en ligne qu’à la fin du financement du projet sont sérieux : Lorsque le projet est publié, le temps des échanges avec les utilisateurs est déjà révolu. Si la mise sur Internet se fait dans les dernières semaines, celles où le projet est sous pression, vous vous trouverez totalement incapable de réagir par des changements plus conceptuels. Et si vous avez mené des recherches uniquement pour la publication d’un livre, que ferez-vous, vous et votre équipe, des données que vous avez rassemblées dans des fichiers Word et des feuilles de calcul Excel ? Personne ne pourra les verser dans des bases de données, car l’harmonisation à ce stade tardif sera un obstacle insurmontable. Votre seul espoir est que des lecteurs de votre livre parcourront toutes vos notes de bas de page pour en tirer des corrections pour nos catalogues de bibliothèque et pour différents projets Wikipédia. Le risque, finalement, est d’avoir un livre sans impact sur la base de données collective et sur les projets d’humanités numériques et qui sera, à cet égard au moins, obsolète dès sa publication.

L’avenir devrait résider dans une nouvelle attitude à l’égard de la base de données publique. Les chercheurs devraient pouvoir corriger et élargir encore cette base chaque fois qu’ils y accèdent. Pour cela, il leur faut une incitation et une sécurité que seul peut leur donner un environnement de recherche dans lequel le travail soit référençable et citable. Pour cela, Wikibase est mieux équipée que tout autre système.

Comment puis-je faire accepter mon projet sur FactGrid ?

La plate-forme FactGrid ne comporte pas de couche profonde invisible. Tout le monde peut interroger la base de données et les requêtes donneront les mêmes informations, que vous soyez connecté ou non. Votre compte d’utilisateur personnel présente simplement l’avantage de vous permettre de passer à votre langue préférée lorsque vous consultez les données et de voir le lien d’édition sur chaque déclaration.

Si vous souhaitez alimenter la plate-forme avec vos propres données et si vous souhaitez y mener un projet, vous devez disposer d’un compte. Les comptes sont donnés sous des noms réels par les administrateurs. Le logiciel fournit un lien “demande de compte”. Vous pouvez également nous contacter par courrier électronique. Les chefs de projet peuvent recevoir des comptes administratifs leur permettant de donner accès aux membres de leur équipe et aux utilisateurs qui les intéressent.

Une fois connecté, vous pouvez saisir des données en masse ou apporter des corrections spécifiques où bon vous semble. Toute entrée sera connectée à votre compte d’utilisateur. D’autres utilisateurs peuvent annuler vos modifications, mais non sans laisser une trace documentée de cette intrusion dans l’historique des versions – visible par le monde entier.

Si vous souhaitez travailler sur un projet plus complexe, qu’il s’agisse d’une recherche familiale personnelle, d’une visualisation unique dont vous auriez besoin pour une communication, ou encore de l’intégration dans la base de milliers de documents que vous auriez rassemblés dans le cadre d’un projet de recherche de 5 ans, parlez-en à ceux qui sont déjà sur FactGrid et à ceux qui organisent la plate-forme. Nous ne serons pas (nécessairement) désireux de signer un protocole d’entente avec vous, mais il pourrait être très intéressant de faire connaître votre projet sur le blog, ainsi que sur l’ensemble de la plateforme. Là où votre travail devient passionnant, c’est lorsque vous modifiez le travail que d’autres ont déjà fait et que vous encouragez les acteurs d’autres projets à adopter les bons modèles que vous introduisez. Il n’est pas indispensable de discuter des modèles de données avec tous les autres utilisateurs, mais cela peut aider, ne serait-ce que pour diffuser votre travail sur la plateforme. Adoptez des requêtes de recherche composées par d’autres, découvrez des visualisations auxquelles vous n’avez pas pensé, obtenez de l’aide sur la plateforme.

FactGridest conçu pour gérer un environnement de recherche excitant que vous ne trouverez pas ailleurs.

traduit par Bruno Belhoste

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).
Jack Kirby, “The Fourth Dimension is a many splattered thing!” from Alarming Tales, 1 (September 1957).

FactGrid FAQ – Why should I use FactGrid for my research project?

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).

auf Deutsch
en français
magyarul

What is FactGrid?

FactGrid is a Wikibase installation — that is is both, a regular wiki and a database which you can use to make statements about objects of your interest — statements which you can then handle in practically any language in big data sets.

The platform is run by the Gotha Research Centre and hosted by the ThULB Jena. It addresses projects with a specific interest in historical data and is part of the German National Research Data Infrastructure NFDI4Memory.

In joint ventures with Wikimedia Germany and the German National Library’s GND we are trying to bring this platform into the upcoming consort of federated Wikibase instances as a resource for research data.

Why should I use FactGrid for my own research?

The biggest argument for a FactGrid account is the unbeatably flexible software, Wikibase, which we have managed to implement in a pilot project with the help of Wikimedia Germany – outside its primary location, Wikidata:

  • You are looking for a software that speaks practically any language — a platform on which you can enter data in your language and allow others to read your data in their languages? Wikibase is this software.
  • You are looking for software in which you can transparently coordinate a whole team? In Wikibase this is as easy as in the Wikipedia software MediaWiki .
  • You are looking for a database software that can do everything Digital Humanities databases normally want to do: network analysis, map representations, complex linked searches, timeline representations (in various formats) – a software that almost acts like human language yet provides full database services? Wikibase is this software.
  • You have data from previous projects which you want to build on? Wikibase has large-scale automatic input options.
  • You want to make sure that that other projects will actually use your data? Use a platform that allows the download and further work with your data offline in Excel or online in ever new projects.
  • You want to ask entirely new questions in your research? In Wikibase you can link any sort of objects with any kind of statements of your interest.
  • You are worried what will happen to your data and presentations once your funding is over? Work on a platform where you do not stay alone and where, thanks to the CC0 license you are using, you encourage colleagues to continue right were you stopped!

If you are looking for a long term perspective this is what we are trying to offer in our present joint venture with the German National Library. We will base our platform on GND data in order to serve as a broad public tool and with the aim to become a player in the emerging landscape of “Federated Wikibase installations”.

Why not use Wikidata right away?

That is a legitimate question to ask. There will be projects (projects that are mainly using data) for which Wikidata will be the better platform. The FH Potsdam’s “Archivführer zur deutschen Kolonialzeit” has demonstrated the beauty of working directly on Wikidata; we talked about this with Uwe Jung, who demonstrated the technical solutions they have chosen in Potsdam.

On the other hand, there remain basically two things which you will not be able to do on Wikidata or on a platform like the GND: Wikimedia projects (and the GND) have strict “No original Research” policies and observe fundamental decisions to operate on “criteria of notability“, which will not allow the arbitrary opening of database objects and the innovative object relationships researchers would like to test.

Wikidata and the GND focus on information that has already been published and on non-research workers who feed the respective databases from published research. You will not be allowed to state a “working hypotheses” of “your research” on these platforms. You will not be able to create entities with the aim to run “nothing but a statistical analysis” on them at a far later stage of your work.

In FactGrid we encourage the use of the platform as a heuristic research tool.

  • Create database objects on the platform, no matter what their relevance in an encyclopedia or in library catalog could be.
  • Risk provisional chronologies as working hypotheses along with your personal assumptions.
  • Use FactGrid in order to make unconventional statements that are presently interesting only in your research project – the software gives you this freedom.
  • Create specific database objects that state your research in all the data sets which you have substantially modified and become able to submit your research with the particular item as the envelope to your funding institution.
  • Risk any new thesis on the platform and state your respective view with a database object number as a “micro-publication” in order to claim your ingenuity on the data base.

FactGrid is free – how does it work?

The software is freely available and under development in the larger community of Wikimedia projects and among the institutions which are going to use Wikibase over the next years.

The FactGrid platform is presented by the Gotha Research Centre on a virtual server of Jena’s University Library free of charge.

All the Wikidata-tools are available to our users. These include all the standard applications of regular Digital Humanities projects.

With both software and tools being open source you can use any favorite software company you are working with, to generate the specific application which you feel you need.

If you feed your tools into the open compound this will be your best way to make sure that future projects will continue their development.

If you aim at technical solutions which you want to sell with financial profit that again will not be restricted by the software license. You can freely commercialize whatever you create on the basis of the open software.

What do I do with unorthodox research interests?

Wikibase is groundbreaking in its data modelling. Essentially you are only creating relations between Q-numbers (or relations between Q-numbers and dates, Q-numbers and space coordinates, Q-numbers and media files, Q-numbers and URLs).

The software does not know what kind of relationships you are stating – these again are just P-numbers: Q1 – P1 – Q2 is a “triple” and can mean “Johann Sebastian Bach (Q1) is the father of (P1) Carl Philipp Emanuel Bach (Q2)”; it can mean just as well “This letter which I found in the archive with the shelf mark XYZ (Q1) has allegedly been sent from (P1) Munich (Q2)”

Q-numbers can be assigned to anything imaginable – people, documents, events, ideas… You decide what kinds of P-numbers you need in order to make statements of your interest. You do not define objects in a system of fixed categories; your statements are adding colour and solidity to whatever object you create as you go along. Do not worry if you do not have the data model on day one. Make statements when you suddenly want to make them and see how they gain the critical mass that can eventually be evaluated.

All statements can be “qualified” – “Johann Sebastian Bach (Q1) was married to (P2) Maria Barbara Bach (Q2) beginning on (P2) October 7, 1707 (date) ending (P3) about July 5 1720 (date).” All of these statements can in turn be equipped with references : “this is clear from (P4) the church book of… (Q3)”,”this is stated in (P5) the well known Bach biography XYZ (Q4)”.

The system allows competing claims at any time. They are simply introduced with their different sources and can be balanced against each other.

You can create practically any normal language statement with triples of this depth of specificity; but above all, this opens the door to the world of statements in all the various languages you might want to speak: The system operates with Q- and P-numbers; the rest is labels in languages which you want to offer to your users. The software will in addition translate dates and quantities into other formats; this is basically the secret that makes it possible for Wikibase platforms to be edited by people in their own languages and to be read by the world in practically any other language.

Which tools does the software provide?

Database entries can be made one by one: Open the object-id in question, go to the bottom of the input page and click the “add statement” link. You will now be asked for the statement you want to make. You do not need to know the P-number. State the property in the language you are using and click at the auto complete you are eventually being offered. The platform will now use the P-number of that statement for you. Complete in the next box that opens your statement. You will again get suggestions to use as you are typing.

Database entries can also be created and substantiated in automated inputs from Excel or CSV lists. (This is the input mask and this is the short guide to it.)

Database queries have to be formulated as “SPARQL” queries, a search language that is (unfortunately) not that easy to use, but that is eventually as complex as the searches you might want to perform.

SPARQL users do not necessarily know how to write SPARQL source code. You usually use sample queries that tell you where you have to change the input in order to run your particular search.

If you know exactly which type of search queries your users should run you can create your own input masks just as you know them from conventional online library interfaces, which will then speak SPARQL with the database.

The software package includes illustrations on maps, timelines, networks, genealogical relationships, graphs, and so on. You do not need to download particular applications. You will ask SPARQL to produce the representation you are trying to get. The Scholia project on Wikidata has a beautiful first presentation of some of the visualisations.

What do I do if I want to give my very own data representations on my own platform?

That should not be a technical problem. Uwe Jung demonstrated how the FH Potsdam interface uses Wikidata as its data repository, without letting users see the database they are accessing.

There is nothing wrong with using FactGrid as an external repository and building up your own research project on the server of your home university, where you can offer targeted database accesses under a typical search template of your choice.

FactGrid basically licenses data to CC0 – does that not mean that I give up all rights to my research?

Opting for the Creative Commons 0 license means essentially that you continue to be free to do whatever you want with your data – you, and not your publisher or the platform that received your data under a scheme, continue to control. But above all, the CC0 license means that your data becomes freely usable and that you can thus reduce the danger of obsolete research in the longer run – others will continue to root out the ugly mistakes you could not hope to correct.

Some basic considerations: CC BY 4.0 is at first glance the license that scientists will prefer: It allows the free further use as long as it receives the accurate citation. In practice, this will work for texts (such as this blog post); here it is clear how one would like to see the text cited: with a reference to one’s own name, with the title of the publication, the place of publication and the date. But do you want your data quoted let us say in a visualisation? A letter sent from Paris to Berlin in June 1753 will be a line on a map and how should this line be properly annotated? How do you want to be quoted if you only improved a data set? “Share alike” licenses are even more problematic: “These data are freely available if the subsequent users keep it just as freely available.” That sounds like the ultimate plea for free use. But how can a sub-user ensure that his sub-users, in turn, will respect your license agreement (especially if this sub-user is offering his data on CC0)? Sub-users are well advised not to use data from CC-BY or CC Share-Alike platforms.

Our joint ventures with Wikidata and the German National Library left us only only one option: to make our data as freely available as our partners: CC0, that is without ensuring that subsequent users will still specify exactly who collected the data, and what third-party users are allowed to do with that data.


In practice, the maximum open license does not mean that FactGrid data is data without authorship, quite the contrary. We suggest that research is cited and assume that Wikidata and the GND are only too happy to state research from our platform. All changes are linked to respective the author names. If research projects have worked more substantially on a data set, they will have stated this in a separate note on the data set that can now be adopted with the data transfer.

Databases like Wikidata or DNB’s GND are in fact interested to quote research – it boosts their data solidity, and FactGrid is here in the unique position to give both institutions a platform on which people can do what they cannot do on the respective larger platforms.

What happens if I want to continue working with my data on another platform?

Since you entered your data without a copyright restriction, you are free work with them on any other project of your interest. We actually like to be “just an incubator” for research data.

What happens when FactGrid users argue about a “correct” date?

The software makes it possible to handle contradictory data. This is particularly interesting in the field of historical research, where we often have conflicting documentary evidence without being able to determine the correct statement after so much time. The software makes it possible to reproduce such a contradictory situation. Numerous statements can be given side by side with their various respective sources. You can then still balance the statements against each other – either by turning one of them into the statement to privilege in future searches and/or by adding qualifying statements with your personal evaluations.

If two researchers come to different results, think of it as the situation you should actually be interested in. It is far worse that you have made mistakes on a platform where they will never be corrected and where they eventually discredit all your work as obsolete beyond repair.

Why should I risk transparency in my project right from the start?

This is likely to be the toughest issue that currently prevents projects from using the resource which we have opened. The alternative is the resource, which is accessible to the team only under passwords until the publication deadline is reached almost at the end of the project. No competing project can snatch away findings, so the theory. No one sees where you have initially made a mistake. Nobody records what assistants are typing in and where the project leader is involved – such are the presumed advantages of non-transparent working on a platform that will only go online at the end of your funding.

Transparent research offers its own securities: If you find a groundbreaking document and establish a decisive connection, then this is your chance to fix the statement to your name and project. If someone makes the same discovery tomorrow in the archive you have just visited, tough luck. You will have recorded your observation with a link in the version history which your rivals will not be able to deny.

At the same time, the collective platform expresses the invitation to cooperate. Make it clear to other teams what you are working on and allow them to contact you on the platform!

The risks of the allegedly secure website, which is only going online at the end of the project’s funding, are serious: The time for an exchange with users is over. The internet presence goes online in the heated final weeks while the project is totally unable to react with more conceptual changes. If you have done research solely for a book publication, it will remain unclear what you and your team should do with the data, you have still collected in Word files, and Excel spreadsheets. Nobody will be able to feed all these data into any resource – the harmonisation at this late stage will be an insurmountable obstacle. You can only hope that readers of your book will scan all your footnotes for corrections that should reach our library catalogs and the various Wikipedia projects. The risk is here the book that has no influence on the collective data base and of DH projects that become obsolete right after their publication.

The future should lie in a new attitude toward the public data base. Researchers should be able to correct and to further widen this base wherever they access it. The incentive and the security they will need here is the research environment in which they can mark their work and make it citable. For this Wikibase is better equipped than any other software.

How do I get my project accepted on FactGrid?

The FactGrid platform has no invisible deeper layer. Anyone can query the database and the queries will give the same information whether you are logged in or not. Your personal user account just has the advantage that you can now switch to your favorite language when looking at data, and that you see the edit link on each statement.

If you want to feed your own data into the platform and if you want to run a project on the the platform, you will need an account. These are given under real names by the administrators. The software provides an “account request” link. You can also contact us via email. Project leaders can receive administrative accounts which they use to assign to team members and users of their interest.

Once logged in, you can enter data in bulk or make specific corrections wherever you feel like. Any input will be connected to your user account. Others can undo your edits but not without leaving a documented mark of that intrusion in the version history – visible to all the world.

If you want to work on a more complex project —

  • that can be personal family research,
  • it can be a single visualization you need in a seminar paper,
  • it may just as well be the input of thousands of records in a 5-year research project

— speak with those on board and those organising the platform. We will not (necessarily) be interested to sign a public memorandum of understanding with you but it might be cool to advertise your project on the blog and to make it known on the entire platform. Your work becomes exciting, where you modify the work others have already done and where you encourages players from other projects to adopt good models which you are introducing. You do not need to discuss data models with all the others but using models with all the others is also a way to spread your work and to make it appear in queries composed by others, and visualizations you did not think of.

The software is designed to manage both: unique statements which only you are interested in and statements that will spread far beyond your own initial research interest as you are now feeding the unforeseen queries which others will run on their and your data.

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).
Jack Kirby, “The Fourth Dimension is a many splattered thing!” from Alarming Tales, 1 (September 1957).

FactGrid FAQ – Warum sollte ich das FactGrid für die eigene Forschung nutzen?

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).

in English
en français
magyar nyelven

  1. Was ist das FactGrid?
  2. Warum sollte ich das FactGrid für die eigene Forschung benutzen?
  3. Warum nicht gleich Wikidata benutzen?
  4. Das FactGrid kommt kostenfrei – wie geht das an?
  5. Was mache ich mit unorthodoxen Forschungsanliegen?
  6. Welche Tools stellt die Software mir zur Verfügung
  7. Was mache ich, wenn ich ganz eigene Datendarstellungen auf meiner eigenen Plattform realisieren will?
  8. Das FactGrid lizenziert Daten grundsätzlich CC0 – heißt das nicht, dass ich alle Rechte an meiner Forschung aufgebe?
  9. Was geschieht, wenn ich mit meinen Daten auf einer anderen Plattform weiterarbeiten will?
  10. Was passiert, wenn es zwischen FactGrid-Benutzern zum Streit über ein “korrektes” Datum kommt?
  11. Warum sollte ich in meinem Projekt Transparenz schon von Anfang an riskieren?
  12. Wie nutze ich das FactGrid konkret?

Was ist das FactGrid?

Das FactGrid ist eine Wikibase-Instanz, die, vom Forschungszentrum Gotha aus organisiert, an der ThULB Jena gehostet wird.

Wikibase ist die Software, die hinter Wikidata läuft. Die Instanz will historischer Forschung einen eigenen Freiraum zur Verfügung stellen und im Verlauf technisch in der Lage sein, mit der GND und mit Wikidata laufend Daten auszutauschen — Daten, die aus dem FactGrid heraus international als Forschungsdaten zitierbar werden. Seit dem 5. November 2022 ist das FactGrid — als global agierende Plattform — offizielles Repositorium im Spektrum der deutschen Nationalen Forschungsinfrastruktur, NFDI4Memory.

Sehen Sie hierzu auch den Beitrag zu den Zielerwägungen, den Barbara Fischer für die GND und Jens Ohlig für Wikimedia am 9. Mai 2019 im Wikimedia Blog veröffentlichten.

Warum sollte ich das FactGrid für die eigene Forschung benutzen?

Dafür spricht erstens die unschlagbar flexible Software, Wikibase, die wir im Pilotprojekt mit Wikimedia Deutschland bahnbrechend außerhalb ihres eigentlichen Orts, Wikidata, zum Laufen brachten:

  • Sie suchen eine Software, die praktisch jede gängige Sprache spricht und in der sich Daten in jeder Sprache eingeben und in danach in beliebigen anderen Sprachen ausgeben lassen? Wikibase ist diese Software.
  • Sie suchen eine Software, in der Sie ein ganzes Team transparent koordinieren können? In Wikibase ist das so einfach wie in der Wikipedia Software MediaWiki.
  • Sie suchen eine Datenbank-Software, die alles kann, was Datenbanken der Digital Humanities normalerweise können: Netzwerkanalysen, Repräsentationen auf Landkarten, komplex verknüpfte Recherchen, Timeline-Darstellungen (in verschiedenen Datenformaten), und die sich dabei einem Umgang mit normalen Aussagen annähert? Wikibase ist diese Software.
  • Sie haben Datenmengen aus vorheriger Forschung, auf die Sie aufbauen wollen? Wikibase erlaubt den großflächigen automatischen Input.
  • Sie wollen sicherstellen, dass Ihre Daten nachnutzbar werden? Wikibase ist genau darauf eingestellt.
  • Sie wollen neuartige Fragen an Material stellen? In Wikibase können Sie beliebige Objekte mit beliebigen Aussagen Ihres Interesses verknüpfen.
  • Sie fragen sich, was nach Ihrer Projektlaufzeit mit Ihren Daten und Ihren Präsentationstools noch geschieht? Setzen Sie auf eine Plattform, auf der Sie nicht allein arbeiten und auf eine Datenlizenz, die es anderen ermöglicht, Ihre Arbeit wirklich risikolos zu nutzen und fortzuentwickeln!

Für das FactGrid spricht im selben Moment, dass wir im Interesse am breiten und offen bleibenden Datenaustausch in einer Kooperation mit der Deutschen Nationalbibliothek die gesamte Plattform soeben auf GND-Daten aufsetzen, um das Projekt in seiner größeren Breite in der entstehenden Landschaft von “Federated Wikibase Platforms” zu verankern.

Warum nicht gleich Wikidata benutzen?

Das ist eine gute Frage, die man sich stellen sollte. Es wird Projekte geben (die hauptsächlich Daten nutzen), für die Wikidata die bessere Plattform ist. Für die FH-Potsdam demonstrierte dies der „Archivführer zur deutschen Kolonialzeit“; wir sprachen darüber mit Uwe Jung, der die technischen Lösungen vorstellte, die man dort realisierte.

Zwei Dinge, gibt es, die es andererseits interessant machen, gezielt eine (Wikidata und die GND beliefernde) eigene Plattform aufzubauen: Die Wikimedia- (und GND–) spezifische “No Original Research” Grundregel und die fundamentale Entscheidung für Relevanzkriterien auf beiden Plattformen, die das beliebige Aufmachen von Datenbankobjekten und Objektbeziehungen ausschließt.

Wikidata und die GND richten sich auf bereits publizierte Information aus und auf Bearbeiter außerhalb der Forschung, die Publikationen auswerten und Daten eingeben. Unmöglich wird es bleiben, auf diesen Plattformen Arbeitshypothesen zu riskieren, Datierungen, die erst einmal auf Probe gestellt sind, Personeninformationen, die später in einer Publikation nur statistisch ausgewertet werden sollen.

Im FactGrid ermuntern wir zur Nutzung der Plattform als heuristischem Forschungstool.

  • Legen Sie hier Datenbankobjekte an, die Sie weit später erst auswerten wollen, egal welche Relevanz diese in einer Enzyklopädie oder in Bibliothekskatalogen gewinnen können.
  • Riskieren Sie provisorische Datierungen – als Arbeitshypothesen zusammen mit Ihren persönlichen Annahmegründen.
  • Wagen Sie im FactGrid unkonventionelle Aussagen, die erst einmal nur in Ihrem Forschungsprojekt interessant sind – die Software erlaubt es Ihnen.
  • Bauen Sie eigene Datenbankobjekte zu Ihren Forschungsprojekten und verknüpfen Sie diese mit allen Datenbankobjekten, an denen Sie arbeiteten, um so Ihrem Geldgebern die eigene Forschung im Paket der Datenbeziehungen vorlegen zu können.
  • Riskieren Sie im FactGrid Thesen und führen Sie diese in der Datenbank als “Mikro-Publikationen” mit eigenen Datenbank Objekt-Nummern.

Das FactGrid kommt kostenfrei – wie geht das?

Die Software ist frei verfügbar und befindet sich in einer von großen Communities getriebener Entwicklung im Wikimedia-Bereich und in Zukunft in hinzukommenden Institutionen wie denen der europäischen Nationalbibliotheken, die soeben eigene Wikibase Instanzen und Tools bauen.

Das FactGrid selbst läuft unter Ägide des Forschungszentrums Gotha auf einem virtuellen Server der Universität Erfurt. Für die deutsche URL fallen jährlich €36 Domaingebühren an, die vom Forschungszentrum Gotha getragen werden.

Nutzern stehen alle Tools aus dem Wikidata Projekt zur Verfügung. Mit ihnen sind die Standardanwendungen gängiger Humanities Projekten erst einmal abgedeckt.

Da die Software open source ist, können Projekte eigene Software-Etats gezielt in Tools und Präsentationen investieren, um die es ihnen in der eigenen Forschung geht. Arbeiten Sie gerne mit einer favorisierten Softwareschmiede zusammen, so wird diese, was den Quellcode der laufenden Software anbetrifft, vor offenen Türen stehen. Bieten Sie Ihre eigenen Entwicklungen offen zur Weiterentwicklung an, und Sie können darauf vertrauen, dass Visualisierungen auch nach Ihrer Projektförderung noch fortentwickelt werden. Streben Sie dagegen eigene Softwarelösungen mit dem Ziel einer kommerziellen Vermarktung an, so bindet Ihnen die Software-Lizenz hier nicht die Hände: Sie erhalten die bestehenden Softwarelösungen frei und können eigene darauf aufbauenden Tools jederzeit kommerziell verwerten.

Was mache ich mit unorthodoxen Forschungsanliegen?

Wikibase ist bahnbrechend offen in den mit dieser Software möglich werdenden Datenbankanwendungen. Letztlich werden hier nur Beziehungen zwischen Q-Nummern hergestellt (respektive Beziehungen zwischen Q-Nummern und Daten, Q-Nummern und Raumkoordinaten, Q-Nummern und Mediendateien, Q-Nummern und Internetadressen).

Was das für Beziehungen sind, das ist für die Software irrelevant. Q1 – P1 – Q2 ist ein “Triple” und kann bedeuten “Johann Sebastian Bach (Q1) ist der Vater von (P1) Carl Philipp Emanuel Bach (Q2)”; es kann genauso gut bedeuten “Der Brief des Archivs X mit der Signatur YZ (Q1) notiert als Absendeort (P1) München (Q2)”

Q-Nummern können für alles nur Denkbare vergeben werden – Personen, Dokumente, Ereignisse, Ideen… Sie selbst legen fest, was für P-Nummern Sie definieren wollen, um Aussagen Ihres Interesses zu Ihren Datenbankobjekten zu treffen. Im System kristallisiert sich letztlich erst mit den Aussagen, die Sie zu Ihren Objekten treffen, heraus, welcher Art Objekte das sind. Das heißt: Sie benötigen kein Kategoriensystem, das Ihnen im Vorhinein klar sein muss, um mit der Datenbank zu arbeiten. Sie treffen Aussagen dann, wenn Sie sie plötzlich setzen wollen, und sehen zu, wie sich diese zu einer kritischen auswertbaren Masse akkumulieren.

Alle Aussagen lassen sich “qualifizieren” – “Johann Sebastian Bach (Q1) war verheiratet mit (P2) Maria Barbara Bach (Q2) mit Beginn am (P2) 7. Oktober 1707 (Datum) bis zum (P3) ca. 5. Juli 1720 (Datum).” Alle diese Aussagen lassen sich wiederum beliebig mit Quellenaussagen versehen – “das geht hervor aus (P4) dem Kirchenbuch von… (Q3)”, “das wird so behauptet in (P5) der Bach-Biographie XYZ (Q4)”.

Das System lässt jederzeit konkurrierende Behauptungen zu. Sie werden einfach mit ihren unterschiedlichen Quellen eingebracht und können dabei beliebig untereinander bewertet werden. In ihrer weiteren Nutzung im System gewinnen sie ihre eigentliche Bedeutung.

Letztlich lassen sich auf damit beliebige normalsprachliche Aussagen generieren; vor allem aber öffnet dies die Tür in die Welt global handhabbarer Aussagen. Für das System spielen sich alle Aussagen nur als Verknüpfungen von Q-Nummern mittels P-Nummern ab. Sie selbst belegen die Q- und P-Nummern mit “Labeln” in den Sprachen, in denen Sie kommunizieren (Datums- und Mengenangaben verwaltet das System bereits in beliebigen globalen Standards mit automatischer Umrechnung in jede Richtung); so das Geheimnis, das es möglich macht, dass auf Wikibase Plattformen Autoren in ihrer jeweiligen Sprache eingeben und andere Nutzer diese Informationen in beliebigen Sprachen auslesen.

Welche Tools stellt die Software mir zur Verfügung

Datenbank-Eingaben können sukzessive erfolgen: Sie wollen über ein Objekt eine neue Aussage treffen? Rufen Sie das Objekt auf, gehen Sie ans Ende der Eingabe-Seite, wo “Aussage hinzufügen” steht, und beginnen Sie die Aussage in Ihrer Lieblingssprache – das System ergänzt mit Auto-Complete die gesuchte Aussage und sucht sich die P-Nummer dieser Aussage heraus. Tippen Sie in das sich nun eröffnende Feld ein, auf welches andere Objekt diese Aussage laufen soll oder auf welches Datum (in Ihrer Sprache) und die Software macht ihnen immer präzisere Vorschläge, noch während Sie tippen.

Datenbank-Eingaben können zweitens massenweise und automatisiert in gängigen Formaten aus Excel-Listen oder CSV-Listen erfolgen. (Dies ist die Eingabemaske und dies die kurze Anleitung dazu.)

Datenbankabfragen geschehen im Gegenzug mit “SPARQL“, eine Such-Sprache, die (leider) nicht einfach zu bedienen ist, die es jedoch nun erlaubt, die Datenbank beliebig komplex zu befragen – komplexer als jede Standard-Suchmaske Ihnen das erlauben würde. SPARQL-Nutzer müssen nicht unbedingt den SPARQL-Quellcode schreiben können. Man bedient sich in der Regel einer passenden Musterabfrage, die man in einer Sample-Queries-Liste findet, und tauscht hier die Suchbegriffe aus.

Weiß man exakt, welcher Art Suchanfragen Benutzer des eigenen Projektes durchführen können, so lassen sich Suchschablonen wie in herkömmlichen Katalogen bauen, die die Anfragen an das System unterhalb der Benutzeroberfläche in SPARQL formulieren.

Im Software-Paket finden sich Darstellungen auf Landkarten, Timelines, in Netzwerken, genealogischer Beziehungen, Diagramm-Darstellungen und so fort. Für diese Anwendungen müssen keine Softwarepakete eigens installiert werden. Sie formulieren in Ihrer SPARQL Anfrage, was für eine Darstellung Sie wünschen.

Einen sehr schönen Überblick über Visualisierungen gibt das Scholia Projekt auf der Wikidata Plattform.

Was mache ich, wenn ich ganz eigene Datendarstellungen auf meiner eigenen Plattform realisieren will?

Das sollte technisch kein Problem sein. Uwe Jung demonstrierte, wie eine Benutzeroberfläche der FH Potsdam Wikidata als Datenrepositorium benutzt, ohne dass die Benutzer mitbekommen, auf welche Repositorien die Abfragen zugreifen.

Nichts spricht dagegen, das FactGrid als ein externes Repositorium zu benutzen und das eigene Forschungsprojekt auf dem Server der Heimat-Uni aufzubauen und dort die Benutzer mit gezielten Datenbankzugriffen unter einer typischen Suchschablone zu bedienen.

Das FactGrid lizenziert Daten grundsätzlich CC0 – heißt das nicht, dass ich alle Rechte an meiner Forschung aufgebe?

Positiv gesprochen bedeutet die Entscheidung für die Creative-Commons-0-Lizenz, dass Sie die vollen Rechte an allen (Ihren) Daten behalten. Vor allem aber bedeutet die CC0-Lizenz, dass Ihre Daten frei nutzbar werden und damit weniger Gefahr laufen, als Forschung obsolet zu werden.

Einige grundsätzliche Erwägungen dazu: CC BY 4.0 ist auf den ersten Blick die Lizenz, die Wissenschaftlern näher liegt: Man gestattet die freie weitere Nutzung, wenn man dafür fachgerecht zitiert wird. In der Praxis lässt sich diese Lizenz bei Textveröffentlichungen (wie diesem Blogbeitrag) noch gut durchsetzen. Hier ist es klar, wie man den Text, den man verfasste, und Thesen, die man bahnbrechend formulierte, zitiert sehen möchte: Mit einem Verweis auf den eigenen Namen, mit dem Titel der Publikation, dem Publikationsort und dem Datum. Wie aber soll das Datenzitat (etwa die Information, dass ein Brief im Juni 1753 von Paris nach Berlin ging) innerhalb einer Visualisierung erfolgen, auf Strichen, die auf einer Landkarte erscheinen? Wie sollen Benutzer Datensätze zitieren, wenn diese nur zum Teil Informationen aus Ihrem Forschungsprojekt enthalten, zum größeren Teil jedoch andere Datenbankinformationen etwa aus einer öffentlichen Archivdatenbank bieten, die Sie einspielten? Noch größere Probleme stellen sich bei Daten mit Lizenzen, die eine “share-alike” Klausel bergen: “Diese Daten sind frei verfügbar, wenn die Nachnutzer sie genauso frei verfügbar halten.” Das klingt erst einmal nach nachdrücklicher freier Nutzung. Wie aber soll ein Nachnutzer sicherstellen, dass wiederum seine Nachnutzer sich an die von Ihnen gewünschte Lizenzvereinbarung halten (insbesondere, wenn dieser Nachnutzer auf CC0 geht)? Nachnutzer sind gut beraten, keine Daten aus CC-BY oder CC Share-Alike Lizenzen zu verwenden.

In der Praxis der größeren Kooperationen mit Wikidata und der Deutschen Nationalbibliothek kann es darum nur eine Option geben: Genauso frei Daten zur Verfügung zu stellen, wie die Kooperationspartner diese tun: CC0, das heißt ohne, dass sichergestellt wird, dass Nachnutzer noch exakt angeben, wer die Daten einzeln erhob, und was Drittnutzer wiederum mit diesen Daten tun dürfen.

 
Die maximal offene Lizenz heißt in der Praxis durchaus nicht, dass FactGrid Daten Daten ohne Autorschaft sind, ganz im Gegenteil. Wir legen es nahe, Forschung als Forschung zitierbar zu machen und gehen davon aus, dass Wikidata und die GND Zitiervoschläge gerne übernehmen. Alle Datensatzänderungen werden von der Software für alle Nutzer sichtbar an bei uns Real-namentlich gebunden. Haben Forschungsprojekte substanzieller an einem Datensatz gearbeitet, vermerken Sie dies jederzeit mit einer eigenen Notiz Ihrer Arbeit im Datensatz. Jeder kann die Datenbank danach befragen, welche Datensätze im Rahmen eines bestimmten Projektes bearbeitet wurden.

Tatsächlich ist es für Datenbanken wie Wikidata oder die Gemeinsame Normdatenbank der DNB, die GND, ungemein interessant, Daten aus dem FactGrid als dort erstmals publizierte zitieren zu können – es steigert die eigene Datensolidität, wenn sich Forschung benennen lässt und es gibt beiden Institutionen eine Plattform auf der möglich wird, was auf der eigenen Plattform ausgeschlossen bleibt.

Was geschieht, wenn ich mit meinen Daten auf einer anderen Plattform weiterarbeiten will?

Da Sie Ihre Daten ohne Copyright-Aufgabe einpflegten, können Sie sie in beliebig vielen anderen Projekten parallel laufen lassen. Wir sind hier gerne “nur” ein “Inkubator” für Forschungsdaten.

Was passiert, wenn es zwischen FactGrid-Benutzern zum Streit über ein “korrektes” Datum kommt?

Die Software lässt es zu, einander widersprechende Daten zu handhaben – das ist gerade im Feld der Geschichtswissenschaften interessant, wo wir oft dokumentarisch belegte divergierende Informationen haben, ohne noch ermessen zu können, welches die korrekte Aussage ist. Namen werden in verschiedenen Schreibungen gehandhabt; Geschichtsschreiber widersprechen einander.

Die Software erlaubt es, die widersprüchliche Lage abzubilden; sie erlaubt es, Objekte mit Dutzenden Namensschreibweisen zu belegen – es sind nur verschiedene Schreibweisen zu ein und derselben Q-Nummer.

Divergierende Aussagen lassen sich unterschiedlich einstufen – etwa als das derzeit autoritative Datum gegenüber Varianten, für die allein die verschiedenen einander widersprechenden Quellen sprechen.

Sollten zwei Forscher zu unterschiedlichen Befunden kommen, so ist das letztlich der Fall, auf den es jedes Projekt anlegen sollte. Das viel größere Risiko ist die hypothetische Entscheidung, die Sie in Ihrem Projekt treffen, während ein Projekt auf einer anderen Plattform das Rätsel löst und mit dem belastbaren Datum weiterarbeitet, ohne dass Sie davon auch nur erfahren, geschweige denn die Korrektur Jahre nach Ihrer Projektlaufzeit noch einpflegen können.

Warum sollte ich in meinem Projekt Transparenz schon von Anfang an riskieren?

Das dürfte die härteste Frage sein, die Projekte im Moment davon abhält, sich der eröffneten Ressource bereits zu bedienen. Die Alternative ist die Ressource, die bis zum Publikationstermin gegen Projektende nur unter Passwörtern dem Team zugänglich ist. Kein Konkurrenzprojekt kann Ihnen in der verdeckten Arbeit an Ihrer Plattform Befunde wegschnappen, so die Theorie. Auch sieht niemand, wo Sie erst einmal Fehler machten, die Sie erst im Verlauf korrigierten. Niemand erfasst, was Hilfskräfte eingaben und was dagegen Sie als Projektleiter verantworten – so die Vorteile des intransparenten Arbeitens auf einer Plattform, die erst am Projektende online geht und die keinen Blick in die Versionsgeschichten der Datensätze zulässt geschweige denn in die tägliche Projektarbeit.

Die transparente Forschung, zu der das FactGrid einlädt, bietet indes ganz eigene Sicherheiten: Wenn Sie bahnbrechend ein bestimmtes Dokument auffinden und einen bestimmten Zusammenhang herstellen, dann ist der Editiervorgang, mit dem Sie den Datensatz mit Aussagen bestücken, Aussage um Aussage datiert und jeweils mit Ihrem Namen verbunden. Macht morgen jemand im selben Archiv dieselbe Entdeckung, werden Sie im FactGrid nachweisbar und fälschungssicher notiert haben, dass Sie den Zusammenhang schon einen Tag zuvor öffentlich zugänglich machten.

Die kollektive Plattform spricht im selben Moment die Einladung zur Kooperation aus. Machen Sie anderen Teams klar, woran Sie arbeiten und erlauben Sie noch auf Ihrer Plattform die Kontaktaufnahme mit Ihnen!

Die Risiken des vermeintlich sicheren und erst am Ende der Projektzeit online gehenden Internetauftritts sind gravierend: Die Zeit für einen Austausch mit den Nutzern ist mit der finalen Publikation abgelaufen. Der Internetauftritt erfolgt in den letzten Wochen Ihres Projektes, währen alle anderen letzten Arbeiten laufen und für konzeptionelle Änderungen kein Raum mehr bleibt. Ist überhaupt kein Digital Humanities-Part in der Forschung einkalkuliert, so bleibt unklar, was mit den Daten noch geschehen soll, die Mitspieler in Word-Dateien, Excel-Listen oder eigenen Softwarelösungen ganz für sich sammelten – sie noch irgendwo einzupflegen, hat niemand mehr die Kraft. Man kann nur noch hoffen, dass Leser der abschließenden Buchpublikation in dieser alle Fußnoten auf Korrekturen hin durchkämmen, die im öffentlichen Informationsstand nötig werden und diese dann in allen Bibliothekskatalogen und in den verschiedenen Wikipedia-Projekten durchführen. Das Risiko sind hier Bücher, die an der kollektiven Datengrundlage vorbeigehen und DH-Projekte, die nach ihrer Publikation mangels weiterer Pflege in wenigen Monaten veralten.

Die Zukunft sollte darin liegen, dass wir die Datenlage, derer wir uns selbst in der Forschung bedienen, eigenverantwortlich bearbeiten können. Um dies wiederum ohne Gefahr der Aufgabe wichtiger Befunde tun zu können, müssen wir es Forschern erlauben, ihre Forschungsleistung transparent und zitierbar sichtbar zu machen. Hierfür ist Wikibase besser als jeder andere Software ausgerüstet.

Wie nutze ich das FactGrid konkret?

Das FactGrid hat keine unsichtbare Tiefenschicht. Jeder kann die Datenbank befragen und die Abfragen bieten dabei eingeloggten Benutzern dieselben Antworten wie fremden. Alle Datensätze sind in allen Versionsstufen öffentlich präsent. Der eigene Benutzeraccount bietet beim puren Auslesen von Daten nur den Vorteil, dass Nutzer nun die Software auf die eigene Sprache umstellen können.

Wer eigene Daten einspeisen und mit ihnen auf der Plattform arbeiten will, benötigt dagegen einen Account. Diese werden unter Klarnamen von den Administratoren vergeben. Die Software bietet ein Link zur Account-Anforderung. Wir vergeben ansonsten Accounts auf (Email) Anfrage. Projektleiter erhalten administrative Zugänge, mit denen sie selbst Benutzerkonten vergeben können.

Einmal eingeloggt kann man sowohl Daten in Massen eingeben wie an beliebiger Stelle Datenkorrekturen vornehmen. Alle Eingaben werden an den Benutzer-Account gebunden, der sie tätigt, und können von jedem anderen zurückgenommen werden, was wiederum als exakt diese Rücknahme namentlich dokumentiert und mit einem Zeitstempel versehen wird – für eingeloggte und nicht eingeloggte Benutzer gleichermaßen sichtbar.

Wer an einem komplexeren Projekt arbeiten will —

  • das kann die persönliche Familienforschung sein,
  • das kann eine einzelne Visualisierung im Rahmen einer Seminararbeit sein,
  • das kann genauso gut eine Eingabe von Tausenden von Datensätzen in einem auf mehrere Jahre laufenden Forschungsprojekt mit mehreren Mitarbeitern sein

— ist gut beraten, noch bei der Account-Eröffnung den Austausch mit der Plattform zu suchen. Eine Kooperationsvereinbarung kann dem eigenen Projekt Rückhalt gegenüber Geldgebern geben; doch kann auch einfach nur ein Blogbeitrag mit einer Projekteröffnung interessant sein. In jedem Fall sollten andere auf der Plattform von Ihnen wissen. Spannend wird die kollektiven Datenbank, wo man die Vorarbeiten anderer nutzt und Mitspieler aus anderen Projekten anregt, gute Modelle zu übernehmen. Nötig ist die Abstimmung nicht; praktisch aber trägt sie zur Verbreitung der eigenen Arbeit bei – zu Suchanfragen, die man selbst so schnell nicht zu formulieren weiß, zu Visualisierungen, an die man nicht dachte, zu Hilfe, wo man sie benötigt.

Die Software verspricht eine neugierige Nutzung im breiten Netz und dieses Netz sollte man mit Forschung ansprechen.

Jack Kirby, "The Fourth Dimension is a many splattered thing!" from Alarming Tales, 1 (September 1957).
Jack Kirby, “The Fourth Dimension is a many splattered thing!” from Alarming Tales, 1 (September 1957).

Memorandum of Understanding between the University of Erfurt and the German National Library – to base the FactGrid on GND data in a joint project

German Version

We are proud to announce a new and massive Wikibase project that should keep a large community busy for far more than a year: Last month the president of the University of Erfurt, Prof. Dr. Walter Bauer-Wabnegg, and Dr. Elisabeth Niggemann, director-general of the German National Library in Frankfurt and Leipzig (DNB) signed a memorandum of understanding that aims to bring GND data into the FactGrid – on a grand scale.

The GND, the German Integrated Authority File, is an authority file of millions of persons plus corporate bodies, conferences and events, geographic information, topics and works – designed to shape the exchange between libraries, archives and academic projects in the DACH countries of Germany, Austria and Switzerland.

integrating the GND into the FactGrid had been our constant topic of discussion during the last year. A Wikibase instance becomes a cool thing to contribute to, as soon as it becomes the research tool that you would use yourself in your research. GND data links into the world of open data; they clarify who or what you are speaking of in your research in all German-language contexts – and they will reach out to the other global authority files and to the universe of library data.

In April 2018 it became clearer that the FactGrid would eventually be one of several Wikibase instances which could and should in this case aim for a larger federation. Early in June it transpired that the German National Library was on its way to test Wikibase in a software evaluation, with the aim to run possibly about ten Wikibase instances in a constant exchange with each other. That was when we contacted the DNB with our own agenda to import their data. We wanted to try, so that our proposal, could become a platform for “original research” – a platform without GND or Wikidata criteria of notability – in the evolving network of Wikibase platforms. Users will be allowed to create Q-Numbers for infants who died right after birth on FactGrid, and the GND and Wikidata will be free to decide under their criteria of notability and relevance, whether they would like to use our information – information they can now quote as original research from the FactGrid platform (with the detailed information of the projects behind this research).

Whilst the GND is CCO and free to be copied, the open joint venture with the German National Library aims to bring transparency into the data input. The more transparency we can bring into all the design decisions in this early stage, the better the wikibase platforms we are heading towards, will eventually be able to communicate with each other.

Now a team has to be formed. The German National Library and the Gotha research institutions of the University of Erfurt will send members into the team. The question is: Will we be able to broaden this team? We should have experts from the Wikimedia communities on board – people who know Wikibase and Wikidata, people who are used to community work on a regular wiki.

  • We would like to attract people who know how to formulate SPARQL searches and who will be able to test data models and make suggestions for the improved data models we should use, in order to handle the massive data sets we are expecting.
  • We’re looking for Wikibase experts who know how to bring in tens of millions of records into a Wikibase installation, and who know how to interconnect these records with genealogical and geographical links.
  • We do not yet know how we will keep the FactGrid manageable with respect to the wave of doublets and name parallels we are facing: The GND has these name parallels in unprecedented numbers. We will have to find ways to quickly inform researchers whether a person they have found in a document is already on the FactGrid or whether they will have to create the item. The hunt for items to be merged will become a permanent issue and we do not yet know how to technically support a community on this collective quest.
  • We will create new and complex fields of expertise: Millions of personal data sets will come with career statements. The FactGrid will turn all these statements into Q-Items, which we will have to organise in order to allow sociological searches for instance. The FactGrid project on historical jobs and their evolution will be only one of these projects.
  • We need players with Wikipedia experience: Though we will restrict ourselves to clear name accounts, we widely invite users with professional to private ambition to join the platform with their projects – whether they are focused on private genealogy or on publicly funded historical research.
  • We will have to provide a simplified FactGrid user interface that will bypass the SPARQL QueryService and the mushrooming Wikibase input pages. Magnus Manske’s Reasonator might become our standard interface for regular users, who will access the FactGrid as if they are accessing library catalogues – through organsied input forms.
  • We will eventually need help with database maintenance. It is particularly unfortunate that our project is primarily the work of historians, who do not always have a keen eye on how to optimally supply this technology.

The FactGrid will grow – and it will offer plenty of space for people to develop their own projects within this growth.


Scan of the Memorandum of Understanding (in German)


More

  • Barbara Fischer & Jens Ohlig, “Neues Testfeld für Wikibase: Eine Bundesbehörde geht auf Expedition im Wikiversum.” 2019-05-09 at https://blog.wikimedia.de

Memorandum of Understanding zwischen der Universität Erfurt und der Deutschen Nationalbibliothek – das FactGrid wird in einem Gemeinschaftsprojekt auf GND-Daten aufgesetzt

English Version

Das FactGrid-Projekt steht vor zwölf Monaten neuer Herausforderungen: Mit ihren Unterschriften vom 15. und 25. März 2019 unterzeichneten der Präsident der Universität Erfurt, Prof. Dr. Walter Bauer-Wabnegg, und Dr. Elisabeth Niggemann als Generaldirektorin der Deutschen Nationalbibliothek in Frankfurt und Leipzig ein Memorandum of Understanding, das in großem Umfang GND-Daten ins FactGrid bringen soll – Daten zu mehreren Millionen Personen und Körperschaften. Noch ist nicht klar, aus welcher Datenquelle wir die Ortsinformationen einspielen werden, die wir zudem benötigen werden.

Für die FactGrid-Projektbeteiligten lag hier noch nach der ersten Berührung mit der Software das sich abzeichnende große Desiderat: Eine Wikibase-Instanz wird zum interessanteren Werkzeug, wenn sie Benutzern Recherchen abnimmt und Wissen anbietet, auf das Forschung unmittelbar aufbauen kann. Die GND stand im selben Moment als die Datenquelle im Raum, aus der die Geisteswissenschaften im deutschsprachigen Raum sich in jedem Fall zu bedienen hätten. Von einem GND-Input aus könnte man beliebig weiterdenken, mit dem Blick auf die Verzeichnisse deutscher Drucke oder auf komplementäre internationale Normdaten.

Klar wurde im April 2018, der Europeana Workshop in Antwerpen war hier eine Wegscheide, dass soeben allerorten erste unabhängige Wikibase-Instanzen entstanden; sie würden im optimalen Fall eine „Föderation“ anstreben. Die Deutsche Nationalbibliothek würde, so der Informationsstand nur zwei Monate später, eigene Wikibase-Instanzen aufbauen — erst einmal in einer Software-Evaluation. Das FactGrid-Projekt stand damit vor Entscheidungen: Entweder setzten wir auf eine Plattform, die sich spezialisierte und noch im Frühstadium isolierte und nutzten GND-Daten nur für uns oder wir riskierten eine Ressource, die sich im Verlauf zwischen der GND und Wikidata als Plattform für „Original Research“ anbieten kann. Unser spezielles Angebot lässt sich benennen: Wir werden nicht die GND- oder Wikidata-Relevanzkriterien übernehmen. Bei uns wird man Datensätzen zu Säuglingen anlegen können, die nach der Geburt verstarben, um ein klareres Bild von Säuglingssterblichkeit im historischen Längsschnitt zu gewinnen. Wir werden der GND und Wikidata im selben Moment anbieten können, nach ihren eigenen Relevanzkriterien Informationen von uns zu beziehen — Informationen, die wir als Forschungsbeiträge zitierbar machen.

In welche technische Lösungen sich das übersetzen wird, sprich: wie Wikibase-Instanzen in Zukunft miteinander kommunizieren werden, ist noch offen. Jetzt jedoch schon können wir eine Instanz zur Verfügung stellen, auf der sich die GND in einer Wikibase-Version bearbeiten lassen wird.

Eine solche GND-Version gemeinsam mit der Deutschen Nationalbibliothek zur Verfügung zu stellen, hat vor allem den Zweck, Erfahrungen dabei unter allen Beteiligten verfügbar zu machen. Von der Transparenz der Design-Entscheidungen wird abhängen, wie gut die hier entstehenden Instanzen später miteinander kommunizieren werden.

Ein Team wird jetzt zu sammeln sein — aus den beteiligten Institutionen der Deutschen Nationalbibliothek und der Gothaer Forschungseinrichtungen der Universität Erfurt und, hier soll das unten publizierte Memorandum of Understanding Klarheiten schaffen, aus den Commmunities des Wikimedia-Umfelde, die mit Wikibase und mit Wikis im Moment entschieden vertrauter sind als wir.

  • Wir suchen SPARQL-Bewanderte, die Datenmodelle austesten und Vorschläge für geschicktere Datenkonfigurationen machen werden, mit denen man die auf uns zukommenden großen Informationsmengen intuitiv und fruchtbar handhaben wird.
  • Wir suchen Wikibase-Kenner, die wissen, wie man Mengen von mehreren Millionen Datensätzen in eine Wikibase-Instanz hineinbringt, und diese Datensätze dabei mit genealogischen und räumlichen Vernetzungen durchdringt.
  • Uns fehlt Expertise darin, wie wir das FactGrid in der Woge der Doubletten und Namensgleichheiten handhabbar halten, die nun auf uns zurollt: Die GND birgt Namensgleichheiten in bislang nicht dagewesenem Maße. Wir werden Wege finden müssen, wie man Forschenden in diesem Meer schnell Überblick gibt, ob die Person, die sie in einem Dokument genannt finden, schon über einen Datensatz verfügt oder neu angelegt werden muss. Die Doublettenfahndung wird zum Dauerthema werden, und wir wissen im Moment noch nicht, wie wir sie auf eine interessierte Community ausrichten und diese dabei technisch unterstützen.
  • Eigene diffizile Fachgebiete werden bei uns entstehen: In Millionen der GND-Personeneinträge finden sich Berufsangaben; bei uns wird aus jeder solchen Angabe ein Datenbankobjekt werden, zu dem nun eigene Aussagen zu machen sind. Wir werden hier Fachleute in verschiedensten Gebieten anziehen müssen, die derartige Felder zu durchdringen und zu erschließen wissen.
  • Wir brauchen Mitspieler, die schlicht Community-Erfahrung haben: Das FactGrid visiert die breite Nutzung an, auch wenn wir dabei auf die Verwendung von Klarnamen setzen. Im gelingenden Fall wird das FactGrid in den Wikipedia-Geschichtsprojekten beliebt werden und Accounts an Universitäten, in Bibliotheken und Archiven vergeben. Lokale Geschichtsvereine und Internet-Genealogie-Projekte sollten an der entstehenden Ressource mit ihren komplexen Vernetzungsangeboten Interesse gewinnen.
  • Wir werden das FactGrid mit einer Benutzeroberfläche ausstatten müssen, die technische Laien am SPARQL-QueryService und an den wuchernden Wikibase Eingabeseiten vorbeiführt. Suchmasken, die vermutlich direkt auf Seiten unseres (im Moment noch nicht sonderlich gut funktionierenden) Reasonator-Angebots führen, das Benutzer in beliebigen Sprachen mit strukturierten Datenblättern bedienen wird, könnten der Zielpunkt sein.
  • Wir werden schließlich Hilfe in der Datenbank-Betreuung benötigen. Hier ist ganz besonders misslich, dass unser Projekt im Moment vor allem die Arbeit von Geschichtsfachleuten ist, die nicht in jedem Moment bereits im Blick haben, wie sie die Technik optimal beliefern.

Das FactGrid wird wachsen und Mitspieler brauchen, die in diesem Wachstum vor allem Raum für ihre ganz eigene Projekte entdecken werden.

Mehr

  • Barbara Fischer & Jens Ohlig, “Neues Testfeld für Wikibase: Eine Bundesbehörde geht auf Expedition im Wikiversum.” 9. Mai 2019 at https://blog.wikimedia.de

Nachfolgend der Text der getroffenen Vereinbarung:


Memorandum of Understanding

zwischen

Deutsche Nationalbibliothek, vertreten durch die Generaldirektorin, Frau Dr. Elisabeth Niggemann
Adickesallee 1
60322 Frankfurt am Main

Universität Erfurt, vertreten durch den Präsidenten, Herrn Prof. Dr. Walter Bauer-Wabnegg
Nordhäuser Straße 63
99089 Erfurt

ausführende Einrichtungen:

Forschungszentrum Gotha der Universität Erfurt
Schlossberg 2
99867 Gotha
im Folgenden: FZG

Forschungsbibliothek Gotha der Universität Erfurt
Schloss Friedenstein
99867 Gotha
im Folgenden: FBG

Präambel

Die Deutsche Nationalbibliothek hat die Aufgabe, lückenlos alle deutschen und deutschsprachigen Publikationen, Tonträger und Musikalien (einschließlich Netzpublikationen und digitaler Objekte) ab 1913, im Ausland erscheinende Germanica und Übersetzungen deutschsprachiger Werke sowie die zwischen 1933 und 1945 erschienenen Werke deutschsprachiger Emigranten zu sammeln, dauerhaft zu archivieren, bibliografisch zu verzeichnen sowie der Öffentlichkeit zur Verfügung zu stellen.

Die FBG und das FZG sind zentrale wissenschaftliche Einrichtungen der Universität Erfurt. In ihrer Arbeit sind sie auf der einen Seite auf die Gothaer Bestände ausgerichtet; über ihre Stipendienprogramme und Forschungsprojekte, mit Schwerpunkten in der Erforschung der Frühen Neuzeit und der Globalisierung des 19. Jahrhunderts, andererseits international aktiv.

Die nachfolgenden Vereinbarungen betreffen die vom FZG initiierte und vom Universitätsrechen- und Medienzentrum der Universität Erfurt unter der URL https://database.factgrid.de gehostete Wikibase-Instanz, die seit dem August 2017 in einer Kooperation zwischen dem FZG und Wikimedia Deutschland aufgebaut wurde, um historischer Forschung insbesondere im Interesse an der internationalen Zusammenarbeit wissenschaftlicher Projekte zur Verfügung zu stehen.

Dies vorangestellt, treffen die DNB und die Universität Erfurt folgende Absichtserklärung:

§ 1 Gemeinsame Vorstellungen

Wikibase, die für Wikidata genutzte Software, soll sich in Zukunft zu einem funktionsfähigen Werkzeug für Wissenschaftler und wissenschaftliche Projekte entwickeln, mit dem in eigenen Installationen Daten offen und kollaborativ geteilt werden können.

Die gemeinfreien Daten der Gemeinsamen Normdatei (GND) – speziell die Daten für Personen und Körperschaften – sollen hierzu in der bestehenden Installation die Datengrundlage bieten, die es Wissenschaftlern erlaubt, Informationen in der Datenbank zu verknüpfen und anzureichern.

Für die GND liegt hierin ein erster Testfall einer größeren Datenintegration in eine Wikibase Instanz. Größere Aufgabenfelder werden im Rahmen dieser Vereinbarung im Blick zu halten sein: Wie lässt sich eine Wikibase Instanz in einen kontinuierlichen Datenabgleich mit Schwesterprojekten bzw. anderen Wikibase Instanzen bringen? Wie lassen sich etablierte Nutzungen der GND auf Seiten von Anwendern und Recherchierenden in neuer Systemumgebung realisieren?

§ 2 Gemeinsame Ziele

Die Partner wollen – im Rahmen ihrer Ressourcen und Möglichkeiten – im Erfahrungsaustausch miteinander die bestehende FactGrid Wikibase-Instanz mit Personen- und Körperschaftsdaten der GND befüllen.

Folgendes soll in diesem Projekt umgesetzt und evaluiert werden:

  1. Import von GND-Datensätzen in die (Factgrid-)Wikibase-Instanz
  2. Anforderungserhebung zur Synchronisation von Daten verschiedener Wikibase-Instanzen
  3. Anforderungserhebung für das Retrieval
  4. Evaluation bestehender Werkzeuge zur Qualitätssicherung und zur Präsentation der Daten
  5. Dokumentation der Projektarbeit und der Evaluationsergebnisse

§ 3 Aktivitäten

Zusammenarbeit

Die Partner stellen ein Team zusammen, das sich im ersten halben Jahr nach Vereinbarungsabschluss mindestens alle sechs Wochen in Treffen und Video-Konferenzen koordiniert und Aufgaben unter sich aufteilt.

Bis zum März 2019 streben sie die Erstellung eines Arbeitsplans mit Aufgabenverteilungen an.

Die DNB erhält Zugriff auf die Datenbank und administrative Benutzer-Accounts im FactGrid.

Die Partner dokumentieren im Blick auf spätere Datenbankverbindungen zu Wikidata und eventuellen DNB-Wikibase-Instanzen ihre Designentscheidungen und Arbeitserfahrungen.

Kommunikation

Die DNB und das FZG/FBG benennen einander je einen Ansprechpartner für alle im Rahmen der Zusammenarbeit abzustimmenden Angelegenheiten. Die Beteiligten sorgen dafür, dass sie sich regelmäßig gegenseitig über Vorhaben und Projekte in den gemeinsamen Arbeitsbereichen informieren.

Die Partner nutzen die ihnen zur Verfügung stehenden Kommunikationskanäle, um die Öffentlichkeit und ihre Communities über gemeinsame Aktivitäten zu informieren. Kommunikation nach außen, die das gemeinsame Vorhaben betrifft, wird vor Veröffentlichung immer zwischen den Partnern abgestimmt.

Für die Außenkommunikation räumen sich die Partner wechselseitig das nicht-ausschließliche, zeitlich auf die Laufzeit dieser Vereinbarung begrenzte und nur mit vorheriger Zustimmung übertragbare Recht ein, die von dem jeweils anderen Partner zur Verfügung gestellten Logos-, Namens-, Bild- oder Markenrechte zum Zwecke der Durchführung der vorliegenden gemeinsamen Ziele zu nutzen; dies gilt nur, soweit dies rechtlich zulässig ist und keine Rechte Dritter entgegenstehen. Die für die vereinbarten Zwecke benötigten Materialien, Abbildungen etc. werden kostenfrei vom jeweiligen Partner zur Verfügung gestellt. Die Partner verpflichten sich, die graphischen Gestaltungsvorgaben des jeweils anderen zu erfüllen.

§ 4 Dauer

Diese Vereinbarung tritt mit ihrer Unterzeichnung in Kraft. Sie gilt zunächst für 12 Monate und kann danach jederzeit unter Einhaltung einer Frist von 30 Tagen zum Ende eines Kalendervierteljahres einseitig gekündigt oder im beiderseitigen Einvernehmen vorzeitig beendet werden.

§ 5 Sonstiges

Durch diese Vereinbarung entstehen der DNB und der Universität Erfurt keine finanziellen Verpflichtungen. Die Partner stellen jeweils die auf ihrer Seite notwendigen Personal- und Sachleistungen zur Verfügung und tragen die ihnen dadurch entstehenden Kosten selbst. Wechselseitige Schadensersatzansprüche sind ausgeschlossen. Bei Ansprüchen Dritter haftet der Verursachende allein und ausschließlich.

Frankfurt am Main,
den 25.03.2019
Dr. Elisabeth Niggemann
Erfurt,
den 15. MRZ. 2019
Prof. Dr. Walter Bauer-Wabnegg


Scan der originalen Vereinbarung

Nachklapp zur ersten GNDCon der Deutschen Nationalbibliothek, Frankfurt am Main, 3./4. Dezember 2018

Die Tickets für die erste große – vom 3. auf den 4. Dezember 2018 an der Frankfurter Nationalbibliothek veranstaltete – GNDCon waren Monate zuvor restlos vergeben. Um die 300 Interessenten füllten schließlich den großen Saal der Adickesallee 1 mit seiner Empore und am Rande aufgestellten Stehtischen: Bibliotheksrepräsentanten, Informatiker, die an Museen und in Archiven im deutschsprachigen Raum Datenbanken betreuen, Geisteswissenschaftler aus den Digital Humanities aller möglichen Projekte. Schließlich sollte es um nicht weniger als die „Öffnung der GND“, der Gemeinsamen Normdaten gehen, mit denen die Deutsche Nationalbibliothek Kultureinrichtungen im gesamten deutschsprachigen Raum und weltweit versorgt. CC0, frei lizenziert, sind sie schon seit längerem, doch das soll erst der Beginn der Öffnung sein.

Die anwesende Forschung war angereist zum guten Teil mit dem Willen aufzubegehren: Man sollte drauf dringen, in Zukunft höhere Rechte erhalten als das bescheidene, Vorschläge zu neuen Einträgen und zu dringenden Korrekturen machen zu dürfen. Bibliothekare äußerten sich unter der Spannung eines auf sie zurollenden Softwareumbruchs. Wer auch immer von der „Öffnung der GND“ redete, hatte womöglich noch kaum verstanden, wie die GND ihre Autorität bislang verteidigte. Für Wikidata sollte die Veranstaltung zu einer eigenartigen Geburtstagsfeier werden: Sechs Jahre waren vergangen und Wikidata war, anders als die Wikipedien zuvor, nach diesem sehr kurzen Spurt in der Lage, unter den globalen Normdatenanbietern mit Autorität zu punkten und mit der Software um die sich alles immer wieder drehte.

Durch das Programm führten Barbara Fischer und Jürgen Kett, erstere von Wikimedia an die DNB gewechselt. Internetkulturen mischten sich plötzlich mit ganz unerwartetem Charme.


Bildquelle: https://wiki.dnb.de/display/GNDCON2018/Bilder+%7C+GNDCon, Lizenz: Creative Commons unter Namensnennung, Weitergabe unter gleichen Bedingungen 2.5 Generic

Normdaten – Dreh- und Angelpunkte der Verständigung über die Dinge im Internet

Über die Normdaten organisieren sich mittlerweile die Katalogsysteme der Archive, Bibliotheken und Museen – und zunehmend auch Forschungsprojekte in den Digital Humanities.

Früher vermerkte jede Bibliothek, jedes Museum und jedes Forschungsprojekt für sich, von wem es soeben sprach; ob von „Thomas Mann“, dem Autor der Buddenbrooks, dem 1946 geborenen CDU-Politiker, dem zwanzig Jahre jüngeren Juristen oder von einem anderem der insgesamt 28 Träger dieses Namens, die die GND listet. Eindeutigkeit und Referenzdaten gewährleistet heute die GND-Nummer, an die sich alle Daten koppeln, über die die Trennungen verlaufen: biographische Eckdaten, geographische Informationen, Berufsbezeichnungen, zentrale Werkzuweisungen. Natürlich sollte Forschung der Digitalen Geisteswissenschaften sich der GND bei jedem Arbeitsschritt bedienen. Ein Projekt, das in Periodika der Weimarer Republik Autoren namentlich identifiziert, sollte diesen GND-Nummern zuweisen, wo immer solche bereits vorliegen, und so für spätere Auswertungen nachvollziehbar machen, wen genau man identifizierte. Es wäre im selben Moment praktisch, wenn das Projekt selbst GND-Nummern vergeben könnte. Am Ende erwartet man von der Deutschen Nationalbibliothek, dass sie die Forschung auswertet und neue Einträge generiert. Die Forschung weiß eigentlich am präzisesten, welche Datensätze sie soeben generieren möchte.

Im Rahmen des organisatorischen Verbunds, der die GND effektiv unter dem „DACH“ deutsch-österreichisch-schweizerischer Institutionen produziert, agieren in der GND eben darum längst schon Forscher mit eingeschränkten Editierrechten, mit Vorschlagsrechten – was indes eben immer noch weit entfernt bleibt von der Offenheit, mit der Wikidata jedem Nutzer erlaubt, Datensätze zu Personen und Werken anzulegen und Q-Nummern zu vergeben.

Die Eröffnungsvorträge der GNDCon folgten aufeinander wie zum Fanal abgestimmt. Harriet Aagaard, die Vertreterin der königlichen Bibliothek Schwedens, Vincent Boulet von der Bibliothéque Nationale de France und Jürgen Kett von der Deutschen Nationalbibliothek mit ihren Verschwisterungen nach Österreich und in die Schweiz verkündeten ihre Entscheidung, Wikidata in Zukunft als Brückenkopf im Informationsaustausch einzubeziehen. Darüber hinaus werde man prüfen, ob nicht Wikibase, die Software von Wikidata, die neue allgemeine Software im Bereich werden könne. Lydia Pintscher führte in Abrundung dieses Fanals in Wikidata ein. Spannung lag im Saal, da diese Weichenstellung verwirrende Unsicherheiten schafft: Wie vermittelt sich diese Entscheidungen der Bibliotheksleiter nach unten? Und: Was genau war hier den Forschern gesagt, die in der GND editieren wollen – dass sie besser gleich in Wikidata Datensätze erzeugten?

Wie Wikidata solches Gewicht gewann

Wikidata, der Startschuss zur Softwareentwicklung fiel erst 2012, begann mit dem Versuch, die Binnenverlinkung zwischen den gut 200 weltweit arbeitenden Wikipedien zu übernehmen – bis dahin hatten Wikipedianer sichergestellt, dass man über die „Interwiki-Links“ korrekt in Parallelartikel der anderen Sprachen gelenkt wurde. Wikidata weiß aus dieser Datenübernahme, in welchen Sprachen es einen „Thomas Mann“-Wikipedia-Artikel gibt und trennt die Artikel zum Lübecker Autor dabei mühelos von den Artikeln zu den anderen Namensträgern in allen Sprachen. Das allein wäre keine Revolution. Die kam mit der Entscheidung, die eigenen Identifikationen im nächsten Schritt mit allen wichtigeren Normdatensätzen weltweit zu verbinden. Wikidata wurde damit unvermerkt das Normdaten Repositorium, das den nationalen (und primär bibliothekarischen) Normdatenprojekten zueinander hilft: BNF-Mitarbeiter schlagen in Wikidata nach, welche GND-Datensätze den in der BNF identifizierten entsprechen. Doch wäre auch das vermutlich nur ein praktisches kleines Geschenk gewesen, wäre Wikidata nicht in jedem Moment dabei ganz anders aufgestellt gewesen: Wikidata kennt nicht nur alle Personen, die in irgendeiner Wikipedia einen Artikel haben, und kann dabei sagen, wo sich zwei Artikel auf dieselbe Person beziehen. Wikidata hat daneben auch Normdatensätze für Apfelsorten, Tische, Stühle und Bänke, ob namhafte Einzelstücke oder den Apfel, den Stuhl, den Tisch als solchem. Die Aussagen, die Wikidata in den Datensätzen macht, sind struktureller Natur: Wikidata erfasst (wie die DNB), dass Heinrich Mann Thomas Manns Bruder war. Anders als die GND-Datenbank weiß Wikidata jedoch zudem, sofern Wissen struktureller Natur ist, nicht nur nebenbei, was „Bruder“ auf Chinesisch oder Koreanisch heißt. „Bruder“, „Vater“, „Mutter“… sind in Wikidata selbst wieder Objekte mit Q-Nummern und mit Aussagen durch P-Nummern, die nun klären, was einen „Vater“ von einem „Bruder“ und einer „Mutter“ im Geflecht struktureller Aussagen zu nun Generation und Geschlecht unterscheidet – und hier wird im nächsten Zug wieder mit Q-Nummern und P-Aussagen definiert.

Die Normdatensätze der Bibliotheken sind, verglichen mit diesen Projekt, eng in ihrer vornehmlich nationalen Orientierung wie ihren Relevanzkriterien, die darauf abzielen, primär Autoren zu identifizieren und Schlagwortkataloge zu beliefern. Auf die Enzyklopädie aller Begriffe und Diskussionsgegenstände in allen Sprachen hatte es keine der Nationalbibliotheken abgesehen – Wikidata dagegen entspringt dieser globalen Enzyklopädie.

Wikibase: Eine Datenbank-Software für jedermann, die typische Bibliothekssoftware überraschend schlägt

Ich begriff am Vormittag des zweiten Tags klarer, warum man in der Deutschen Nationalbibliothek und eben nicht nur hier soeben über Wikibase nachdenkt. Interessierten war im Keller der Nationalbibliothek Zugriff auf eine Datenbankdoublette der GND eingeräumt.

Für den, der in Wikibase bereits Datensätze anlegte, ist die Software ein Schritt zurück in die 1990er Jahre: Die Benutzeroberfläche verlangt Einarbeitung. Jede Zeile eines Datensatzes eröffnet mit einer Nummer, der Ankündigung der nachfolgenden Aussage für den späteren Katalogeintrag. Hinter jeder Nummer muss Information in einer sehr speziellen Sprache abgelegt werden, um nachher korrekt ausgelesen zu werden. Man öffnet die begleitende Dokumentation im zweiten Browserfenster, sieht nach, welche Nummern etwa in einem Personendatensatz verwendet werden könnten und wie dabei die Eingabe zu geschehen hat – hier werden nicht Q-Nummern miteinander verbunden, hier wird vergleichsweise oft Text standardisiert eingegeben. Die Software arbeitet flach: Speichert man ab, wird der bisherige Datensatz überschrieben. Wikibase notiert dagegen, welche einzelne Aussage im Datensatz geändert oder hinzugefügt wurde und bietet Raum für Quellenangaben im Plural hinter jedem beliebigen Statement eines jeden Datensatzes. Die GND-Software ist zufrieden mit einer einzigen Quellenangabe für den ganzen Datensatz – und selbst die fehlt, wo immer man Daten aus vorhandenen Bibliotheksrepositorien übernahm.

Große Entscheidungen muss auch die DNB fällen und vorher diskutieren – die Diskussionen bleiben intern und außerhalb des Systems, wo in Wikidata ganz wie in den Wikipedien über alles öffentlich beraten, wenn nicht gestritten wird, was nachher Richtungsänderungen mit sich bringt.

Braucht man die Wikipedia-Öffentlichkeit in nationalen Bibliotheken? Und ist die Versionsverliebtheit der Wikibase-Software mit ihren Bearbeiterstempeln und Datierungen wie ihren „undo“-Aufforderungen mehr als eine nutzlose Anschwellung der Datenbank, die sich besser darauf konzentrierte, Fakten zu präsentieren?

Aus Sicht des Historikers ist die Antwort klar: Was heute erst einmal nach unnütz viel mehr Daten anmutet, wird in fünf Jahren von Laptops geleistet; und natürlich braucht man die Versionierung und die Quellen zu jedem einzelnen Statement. Es genügt nicht, irgendein Geburtsdatum zu kennen. Man sollte sagen können, woher dieses Datum bezogen ist. Und bei interessanten größeren Entscheidungen würde man gerne wissen, auf welcher Argumentation sie zustande kamen, um diese entweder übernehmen oder die Revision diskutieren zu können.

Die Autorität des Monopols

Die Autorität der nationalen Normdatenanbieter war bislang primär institutionell gewährleistet. Die deutsche Nationalbibliothek bietet das Geburtsdatum des Autors der Buddenbrooks, das jede Bibliothek übernehmen kann, weil eine Änderung (wenn sie denn unter einem neuen Befund nötig würde) eben der Nationalbibliothek gemeldet würde, um von hier aus in den vielen Katalogen zu erscheinen.

Den Scan der Geburtsurkunde benötigt die DNB dabei nicht. Wikidata würde ihn benötigen, die Datenbank, in der jeder Dahergelaufene Unsinn behaupten könnte, und die erst mit einem öffentlichen Quellenbeleg eine korrekte Information durchsetzen kann. Wikibase bietet die Nachweis-Aufforderung bis hin zur Option, einander widersprechende Daten mit den jeweiligen Quellen als genau solche divergierenden Daten verwalten zu können – eine extrem attraktive Option, da wir in der Datenüberlieferung oft nicht mehr haben, als einander widersprechende Quellen.

Eine neue GND-Software wird mindestens so leistungsfähig sein müssen wie Wikibase gegenwärtig ist. Sie wird in der Lage sein müssen, Nummern mehrsprachig zu belegen. Sie wird Edits einzeln versionieren können, um in Datensätzen jede einzelne Stellungnahme überprüfbar zu machen. Sie wird den Quellennachweis zu jeder Aussage einfordern und der Öffentlichkeit Einblick in Entscheidung gewähren, um mehr Sicherheit als Wikidata zu geben.

Wikibase ist frei lizenziert. Theoretisch könnte man die Software wohl so umprogrammieren, dass sie danach wesentliche Hierarchien in Bearbeitungsrechten aufweist, wie intransparente, „rein interne“ gegenüber öffentlich sichtbaren Bereichen. Praktisch wird der Schritt in Wikibase viel einfacher sein, wenn es gelingt, Instanzen in Kommunikation miteinander zu bringen. Man wird dann von der Nationalbibliothek aus mehrere Instanzen betreiben – öffentliche und weniger öffentliche und zwischen diesen die Richtungen im fortlaufenden Datenfluss autoritativ festlegen.

Dass Wikibase-Instanzen sich untereinander austauschen können, das Projekt von „Federated Wikibase Instances“, steht unabhängig davon in den Wikimedia Entwicklungsplänen.

Einigten die zentralen Normdatenanbieter sich global auf Softwarestandards, wäre man einen immensen Schritt weiter im Streben nach neuer Eindeutigkeit im weltweiten Datenaustausch. Gemeinsam mit Wikidata würden die alten Bibliotheken wieder Sicherheiten von Aussagen ins Netz bringen, härtere Aussagen als die der fuzzy Google searches, an die wir uns gewöhnten.

Und die Forschung?

In der GND zu editieren ist unter den gegenwärtigen Bedingungen für Forschungsprojekte nur bedingt attraktiv. Die Software ist unbefriedigend, doch natürlich wäre man gerne als Lieferant und Bezieher von GND-Nummern mit dabei, falls diese nicht soeben rapide an Wert verlieren. Im Moment sticht die GND – sobald man auf die nationale Ebene geht – Wikidata noch in der puren Quantität der Daten in den Kerngebieten aus; ein Rechenexempel aus Gothas Illuminaten-Projekt kann das verdeutlichen:

Zahl der nachgewiesenen Mitglieder im Illuminatenorden 1354 100%
Zahl der nachgewiesenen Illuminaten mit GND-Nummern 553 41%
Zahl der nachgewiesenen Illuminaten mit Wikidata-Nummern 191 14%

Die GND erfasst mehr historische Personen. Dass sie Studenten mit einer bibliotheksnotierten Dissertation beim Namen nennt, macht sie bei den Illuminaten überlegen; diese rekrutierten vornehmlich Studenten mit guten Karriereprognosen.

Im Zeitalter des freien Datenflusses hat ein solcher Vorsprung sein Verfallsdatum. Wikidata könnte die gesamte GND-Personenliste importieren (man mag ob der Doubletten, die man sich einhandeln würde, wie der fehlenden Vernetzung der Datensätze, vor einem solchen Import zurückschrecken). Die Masse Wikidata-nummerierter Personen bleibt im Gegenzug für die GND so uninteressant wie chinesische Lokalpolitiker, die Artikel in der Wikipedia ihrer Sprache haben. Die Überlegung lässt erahnen, von wo nach wo der Informationsfluss verlaufen wird: von den feinmaschigen vielen nationalen Datenbanken hin zu Wikidata.

Die Frage der „Relevanzkriterien“, die es bei der GND und weniger hart bei Wikidata gibt, ist am Ende die Frage, die für ganz eigene Forschungsplattformen spricht, denn die Forschung benötigt in letzter Konsequenz gänzlich offene Plattformen, auf denen man Datensätze bereits anlegen kann, wenn man erst noch sehen muss, ob sich mehr Dokumente zum Namen finden, über den man soeben stolperte. Ein Forschungsprojekt zum Bevölkerungsaufbau in frühneuzeitlichen Städten wird Datensätze für Säuglinge anlegen, die in den ersten zwei Lebensjahren verstarben – eine Erlaubnis, solche Personen einfügen zu dürfen, wird ein solches Forschungsprojekt von niemandem erbitten wollen. Was in der Forschung „relevant“ ist, darauf wetten Projekte kompetitiv in einer Zukunftsprognose: Was wichtige Forschung und damit relevante Information ist, das stellt sich dann heraus, wenn die Zitate der Arbeit beginnen und die Daten-Nutzung in Gang kommt, so die Spekulation jedes einzelnen Projekts.

Es ist dies der Grund, warum eine unabhängige Wikibase-Instanz mit den GND-Daten für die deutschsprachige Forschung so besonders spannend wäre – eine Plattform, die danach Schrittweise Datensätze anderer Nationen aufnähme.

Die große Kulturrevolution steht am Ende weniger für die GND oder Wikidata an, als für die Geisteswissenschaften, für deren bedeutendste Repräsentanten das Internet im Moment noch immer nicht viel mehr als ein grandioser Selbstbedienungsladen ist. Hier stellen, so die professorale Sicht, Großkonzerne wie Google gemeinsam mit Bibliotheken Hunderttausende von Büchern ins Netz, und hier schreiben fleißige namenlose Bienchen Wikipedia-Artikel, aus denen man mit copy & paste Informationen schnell mal eben beziehen kann, verblüffend verlässlich. Man selbst schreibt ein großes Buch und erwartet im Gegenzug mit dem Selbstverständnis des wissenschaftlich Publizierenden, dass die Leute aus dem Internet die eigene Arbeit geflissentlich beachten und noch aus den Fußnoten, die man setzte, die biographischen Richtigstellungen beziehen und korrekt in die Kataloge und Wikipedia-Artikel bringen. (Empört ist man, wenn die eigene Arbeit dabei nicht ordnungsgemäß zitiert wird; enttäuscht, wenn sie von denen im Internet unbeachtet bleibt.)

Die GND wird in der Transformation der Geisteswissenschaften, die hier noch immer ansteht, den interessantesten Impuls geben, wenn sie ihre Haltung zu den Wissenschaftlern wie zur eigenen Arbeit ändert. Es wird nötig werden, dass Wissenschaftler die Datenlage, die sie nutzen, unter der laufenden Arbeit in gesellschaftlicher Verantwortung in Stand halten – offen proklamiert. Sie benötigen dazu Plattformen, auf denen sie auch marginale Korrekturen von Daten noch als Forschungsbeiträge verbuchen können – sie ziehen es andernfalls vor, den persönlichen Wissensvorsprung auf dem privaten Rechner in Word-Dateien für sich und gegenüber den Kollegen zu behaupten, die ihre eigenen Word-Dateien mit bahnbrechenden Informationen für sich sorgsam hüten.

Die GND und Wikidata sind gegenwärtig in der einmaligen Lage, die Plattformen zur Verfügung stellen zu können, auf denen sich in Zukunft Wissen diskursiv – durch das Angebot des Belegs und der nachvollziehbaren Forschung – von der Flut der haltlosen bleibenden Behauptungen abgrenzt. Der Aufbau der neuen überlegenen, weil zitierbaren Ressourcen ist dabei derzeit noch gar nicht als Zentrum der Verantwortung der Geisteswissenschaften für das Wissen unserer Gesellschaften (wieder) in den Blick genommen.

Mehr Links

2017-12-1/2: Erster FactGrid Workshop in Berlin: Ergebnisse

Das Treffen begann mit wechselseitigen Vorstellungen von Wikidata und dem Illuminatenprojekt (mehr zu Wikidata hier, mehr zum Projekt die Illuminatenakten online zu bringen: hier), eine Etherpad Seite dokumentiert, was an Links in der Runde durchgegangen wurde.

Hier die wichtigsten Überlegungen und Ergebnisse:

1| Das FactGrid muss vorbefüllt werden, insbesondere mit bibliographischer Information

In einer Demonstration korrigierten wir das Todesdatum zu August Bohse (Q760965). Die Korrektur selbst war einfach, die Quellenangabe jedoch umständlich und unbefriedigend: Das Bearbeitungsfeld akzeptiert entweder eine URL (hier hätte man das Google Books-Link angeben können) oder ein bereits bestehendes Wikidata Objekt mit seiner Q-Nummer. Das Datenbank-Objekt zu generieren, war mühselig. Das Ergebnis war zudem ohne viel weiteren Nutzen: Man wird das zitierte Buch so nicht in zukünftigen Buchrecherchen wiederfinden. Bibliothekskataloge nehmen Titel weit komplexer auf, ohne dass man Benutzern diese komplexen Eingaben indes zumuten will.

Das Fazit aus dieser Demonstration war: Wir benötigen im FactGrid eine Vorabfüllung, so dass Forschende hier bereits bestehende Objekte in Beziehung miteinander setzen. Das FactGrid sollte bereits eine breite Basis an

  1. Wikidata-Objekten
  2. GND-Objekten
  3. Bibliographischer Information (namentlich der Nationalkatalogen für die frühe Neuzeit: VD16-VD18, ESTC, STCN aufweisen

Man wird erstens nachdenken müssen, wie man für die historische Datenbank auswählt (das menschliche Genom, das in Wikidata vollständig sequenziert erfasst ist, ist uninteressant, auch will man eher unglückliche Informationsangebote aus der neuen Datenbank heraushalten – man benötigt jedoch etwa zu Personen Grunddaten, um sie eindeutig identifizieren zu können). Man wird zweitens nachdenken müssen, wie man bei der Zusammenführung von Wikidata und GND-Informationen mit Doubletten umgeht.

2| Benötigt: Schicke (spielerische) Werkzeuge zur Ausmerzung von Doubletten

Das Problem taucht beim Anlegen bruchstückhafter Datensätze wieder auf – etwa wenn man aus einem Besucherbuch Namen abschreibt, von denen man nur weiß, dass sie zu einem genannten Zeitpunkt am genannten Ort sich so auswiesen.

Die Lösung wird ein Tool sein, dass Wahrscheinlichkeiten misst. Wie wahrscheinlich ist es, dass zwei Personen selben Namens am selben Tag und in der selben Stadt geboren wurden – und dann etwa auch noch das Sterbedatum und den Sterbeort teilen. Vermutlich kann man bei einer Zusammenführung von Daten automatische von Doubletten riskieren, wenn man dabei die statistische Wahrscheinlichkeit der Identität greifbar macht.

Attraktiv wäre ein Tool, das erwägt, wer wer sein könnte: Bei wem liegt die tentative Information im Bereich der Lebensspanne? Wer ist dagegen auszuschließen, da er an diesem Tag ein Alibi hat? Man kann dann massenweise aus Kirchenbüchern Namen und Daten notieren, Objekte anlegen und später das System nach Vorschlägen der Identifikation befragen.

3| Forschungsprojekten in der Ressource Raum bieten, die eigene Arbeit zu präsentieren

Demonstrationen verschiedener Tools machten klar, dass es bereits wunderbare Anwendungen gibt, die den Rang ganzer wissenschaftlicher Projekte haben könnten. Daniel Mietchen zeigte die Genealogie seiner Doktorväter bis um 1500 zurück:

Screenshot from https://tools.wmflabs.org/scholia/author/Q20895785 / enlarge

Die Entwicklungsrichtung, für die wir uns nach den Demonstrationen entschieden, ist es, vorwiegend mit der Datenbank zu arbeiten und Projekten dabei die Chance selektiver Präsentationen zu geben. Wir werden dafür eine Art Tagging einführen, mit dem Projekte Dokumente und Personen oder (Zeit–)räume ihres Interesses ausmachen können, um dann spezifische Suchangebote innerhalb eines abgesteckten Geländes machen zu können.

4| SQID und Reasonator

Die Entscheidung das „Illuminatenwiki“ langfristig aufzulösen, fiel insbesondere im Blick auf den Reasonator und SQID: Hier die Vergleichsseiten zu Johann Sebastian Bach in den Wikidata-Präsentationen durch beide beide Tools.

Beide Tools lassen sich parallel anbieten und werden einen ähnlichen Entwicklungsbedarf aufwerfen. Beim Umgang mit Dokumenten hätten wir gerne die Scans, Transkripte und Übersetzungen auf denselben Seiten. Eine typische Seite zu einer Quelle ist aus der Gotha Illuminati Research Base diese zu Schwedenkiste Band 13, Dokument SK13-070.

Elegant wäre, es zweispaltig Digitalisate neben Transkriptionen setzen zu können (und die Software für das Editieren zu öffnen). Elegant wäre es, wenn Benutzer zudem hier Übersetzungen anfertigen könnten.

5| Der FactGrid Quellen-Nachweis

Ausgiebig diskutierten wir das Schema des FactGrid Quellennachweises, wie es sich hier als Diskussionsvorschlag findet: Faktenbelege, die “Original Research” zulassen.

Prinzipiell sollte dieses Schema es Forschern erlauben, Befunde erstmals im FactGrid zu präsentieren und dabei selbst Arbeitshypothesen als solche handhaben zu können. Das Ziel ist nicht die Ressource, die ausschließlich mit solider Information bestückt wird, sondern ein Forschungshilfsmittel, das man etwa mit Personenlisten aus Dokumenten befüllen kann, um später zu sehen, welche Aussagen sich dazu machen lassen.

5| CC0 oder CC BY 4.0

Die Lizenz für das Factgrid sollte bislang CC BY 4.0 sein – jeder darf Informationen beliebig verwenden, muss sie aber wie verlangt zitieren. Das ist die wissenschaftliche Praxis, und das Zitat kann in diesem Fall nicht einfach „FactGrid“ lauten, es muss die Forscher nennen, die im FactGrid auf den Befund verwiesen.

Gegen die CC BY 4.0 spricht, dass sie bei einer Föderation mit Wikidata und dortiger CCo Lizenz ein Lizenzgefälle erzeugt, auch dass sich bei vielen Tools am Ende nicht das erwünschte Zitat mitliefern lassen wird: Wo sollen bei einer Visualisierung die Angaben zu den Forschern erscheinen? Fordert man sie ein, verhindert man die Visualisierungen.

Die pragmatische Alternative könnte lauten, dass wir uns auf CC0 einlassen, aber

  • eine best practice Information geben: Dort, wo einzelne Informationen etwa zu einem Todesdatum von uns zitiert werden, stellt ein eigenes Zitierlink zusammen, wie wir das Datum wissenschaftlich zitieren würden. Das ist gerade für uns selbst attraktiv: Wir können dann von hier aus in eigenen Artikeln Fußnoten beziehen.
  • mit Wikidata eine Vereinbarung treffen, wie wir dort Informationen unserer Arbeit zitiert sehen wollen
  • auf eine technische Lösung hinarbeiten, die es Benutzern in Wikipedia leicht macht, ganze Fußnoten zu Informationen von uns zu beziehen – bislang werden Todesdaten etwa regulär ohne Quellenangaben gehandhabt.

6| Die Daten der Schwedenkiste-Excel-Liste in Triple verwandeln

Wir gingen diese Liste spaltenweise durch. Es sollte kein Problem sein, die Tripel zu den gelisteten Dokumenten zu formulieren. Etwas Anpassungsarbeit wird nötig, um etwa nicht mehr vorhandene Dokumente zudem einzeln führen zu können. Die Schwedenkiste enthält Seiten jeweils mehreren Entwürfen von Briefen, die selbst nicht mehr überliefert, aber von hier aus einzeln rekonstruierbar sind.

Matti Blume und Olaf Simons wollen sich am 11.12. in Berlin für das Datenmodell und die Anpassung der Excel-Liste treffen.

7| Zeitschnitte

Spannend wäre es, wenn man im FactGrid historische Situationen darstellbar machen könnte. Der Artikel zu Gotha wird in diesem Fall nach gewünschtem Zeitraum zusammengestellt mit Informationen, die Zeitraum-gerecht arrangiert werden. Gotha hat um 1800 etwa 12.000 Einwohner, es gehört nicht zur BRD sondern ist Residenzstadt im Herzogtum Sachsen-Gotha-Altenburg und so fort.

Eine Website, die Zeitschnitte recherchierbar macht, wäre ein denkbares Objekt für einen coding Wettbewerb.

8| Barcamp Open Science, Coding Da Vinci, Hackathon

Vom Berliner Workshop ging die Anregung aus, einen nächsten Workshop im Frühjahr – vielleicht Anfang März zu veranstalten und dabei absolvierte Arbeitsschritte zu besprechen. Unser Ziel sollte es im selben Moment sein, von hier aus Projekte für coding-events zu formulieren:

9| Koordination