- English summary: https://www.wikidata.org/wiki/Wikidata:FactGrid#First_FactGrid_Workshop_in_Berlin,_December_2017
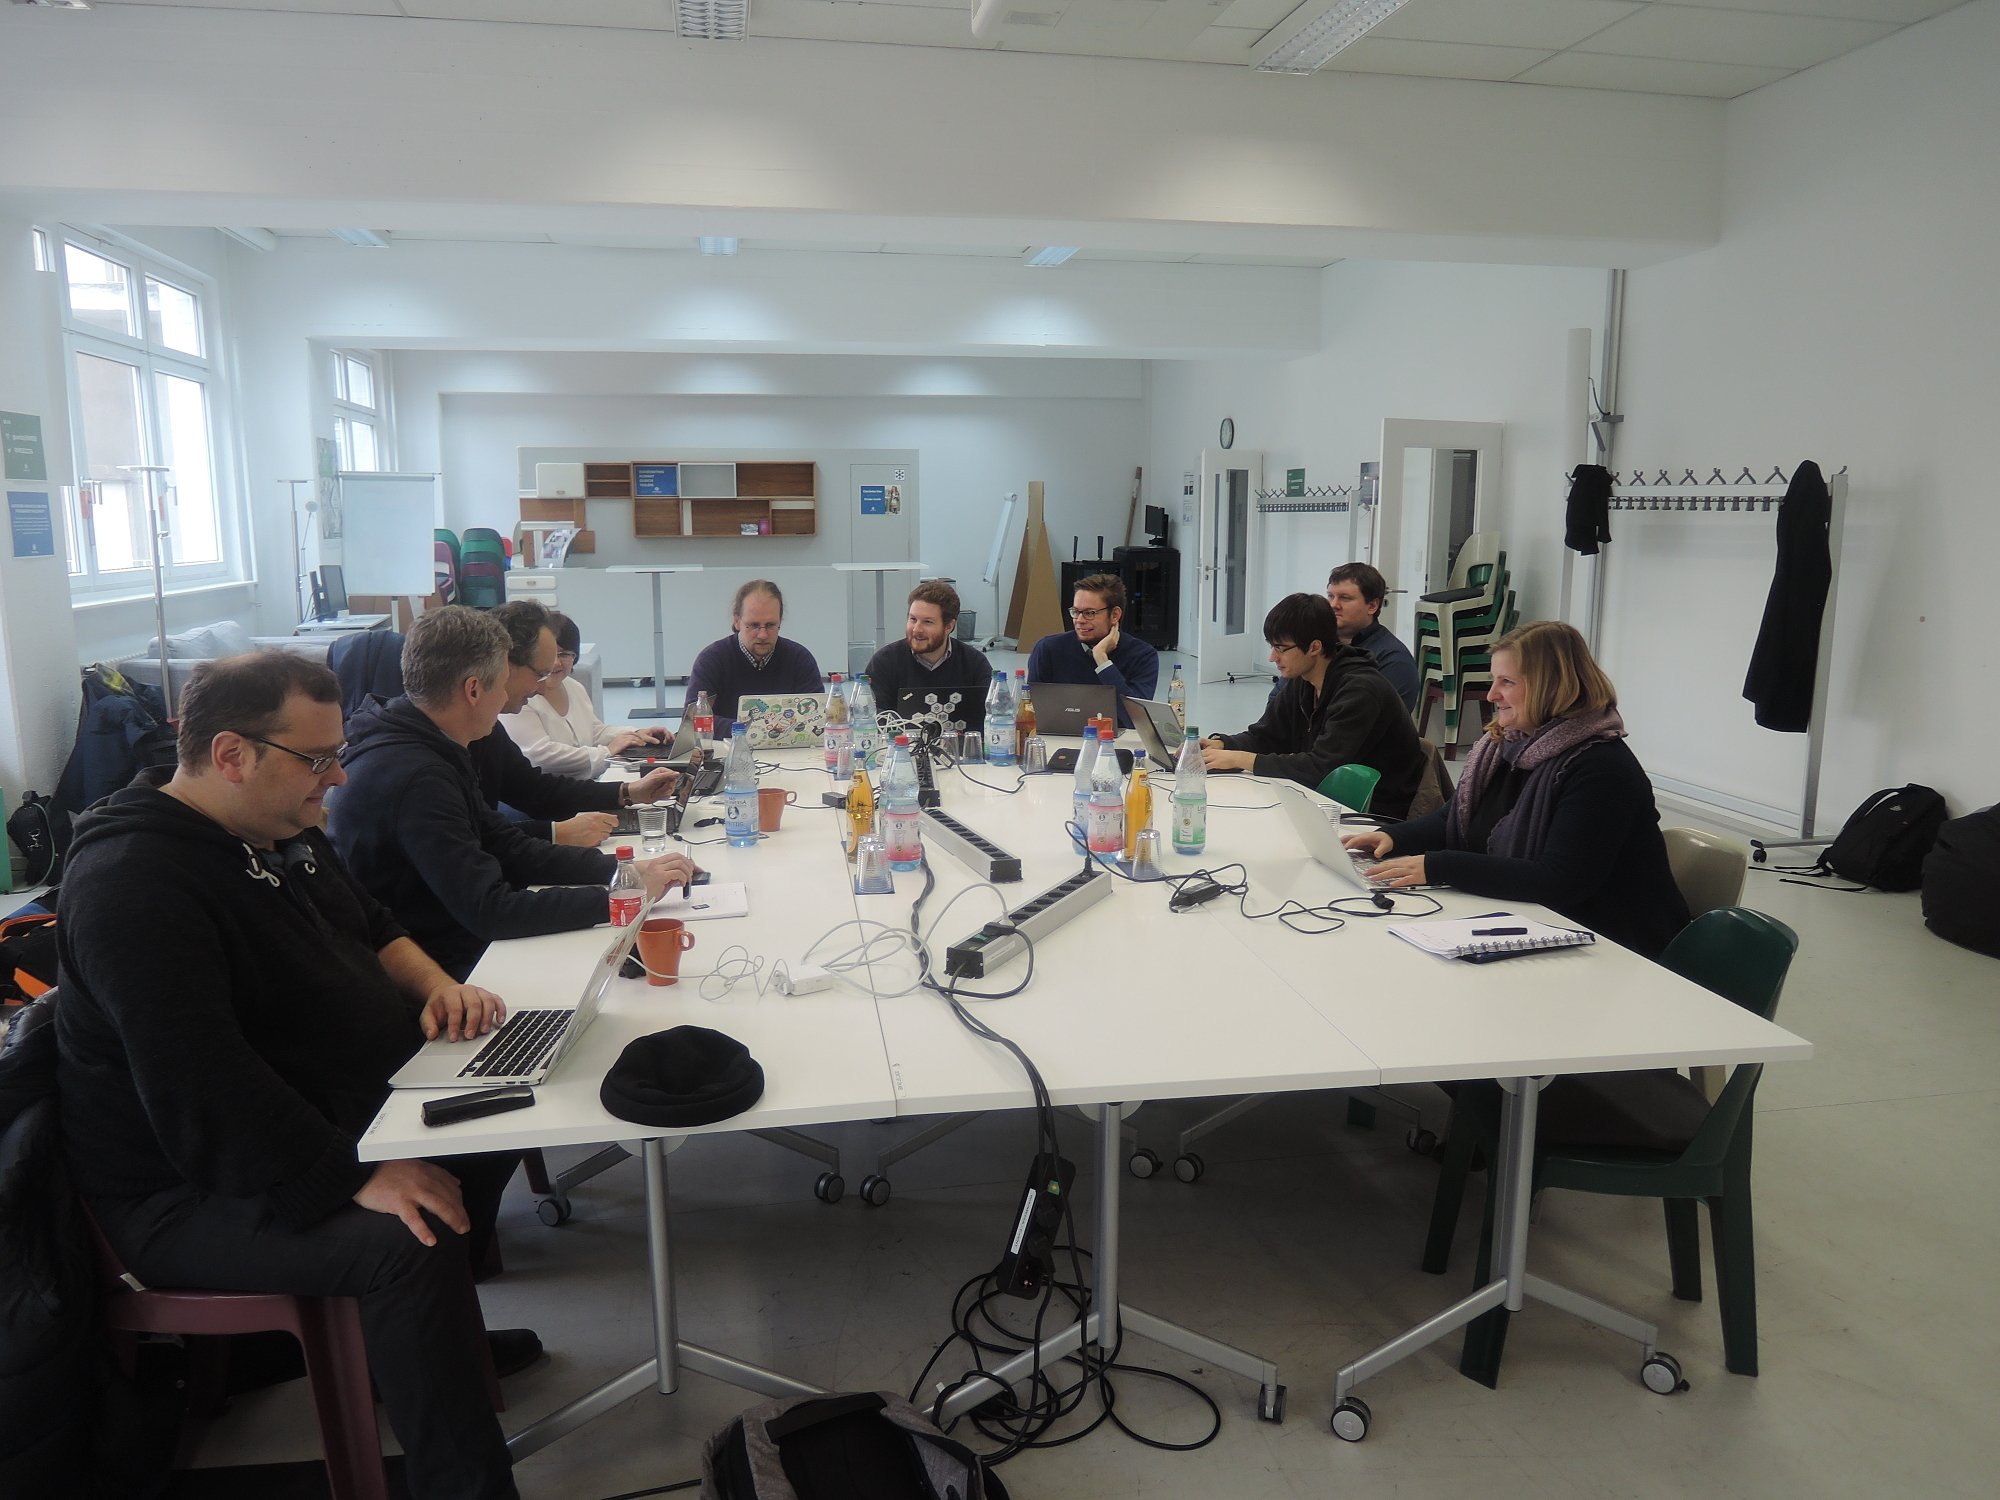
- Teilnehmer/innen: Lydia Pintscher, Jens Ohlig, Matti Blume, Adrian Heine, Daniel Mietchen, Lucas Werkmeister, Olaf Simons, Markus Meumann, Erik Liebscher, Christian Wirkner, Hendrikje Carius, Daniel Burckhardt, ChristianKl
Das Treffen begann mit wechselseitigen Vorstellungen von Wikidata und dem Illuminatenprojekt (mehr zu Wikidata hier, mehr zum Projekt die Illuminatenakten online zu bringen: hier), eine Etherpad Seite dokumentiert, was an Links in der Runde durchgegangen wurde.
Hier die wichtigsten Überlegungen und Ergebnisse:
1| Das FactGrid muss vorbefüllt werden, insbesondere mit bibliographischer Information
In einer Demonstration korrigierten wir das Todesdatum zu August Bohse (Q760965). Die Korrektur selbst war einfach, die Quellenangabe jedoch umständlich und unbefriedigend: Das Bearbeitungsfeld akzeptiert entweder eine URL (hier hätte man das Google Books-Link angeben können) oder ein bereits bestehendes Wikidata Objekt mit seiner Q-Nummer. Das Datenbank-Objekt zu generieren, war mühselig. Das Ergebnis war zudem ohne viel weiteren Nutzen: Man wird das zitierte Buch so nicht in zukünftigen Buchrecherchen wiederfinden. Bibliothekskataloge nehmen Titel weit komplexer auf, ohne dass man Benutzern diese komplexen Eingaben indes zumuten will.
Das Fazit aus dieser Demonstration war: Wir benötigen im FactGrid eine Vorabfüllung, so dass Forschende hier bereits bestehende Objekte in Beziehung miteinander setzen. Das FactGrid sollte bereits eine breite Basis an
- Wikidata-Objekten
- GND-Objekten
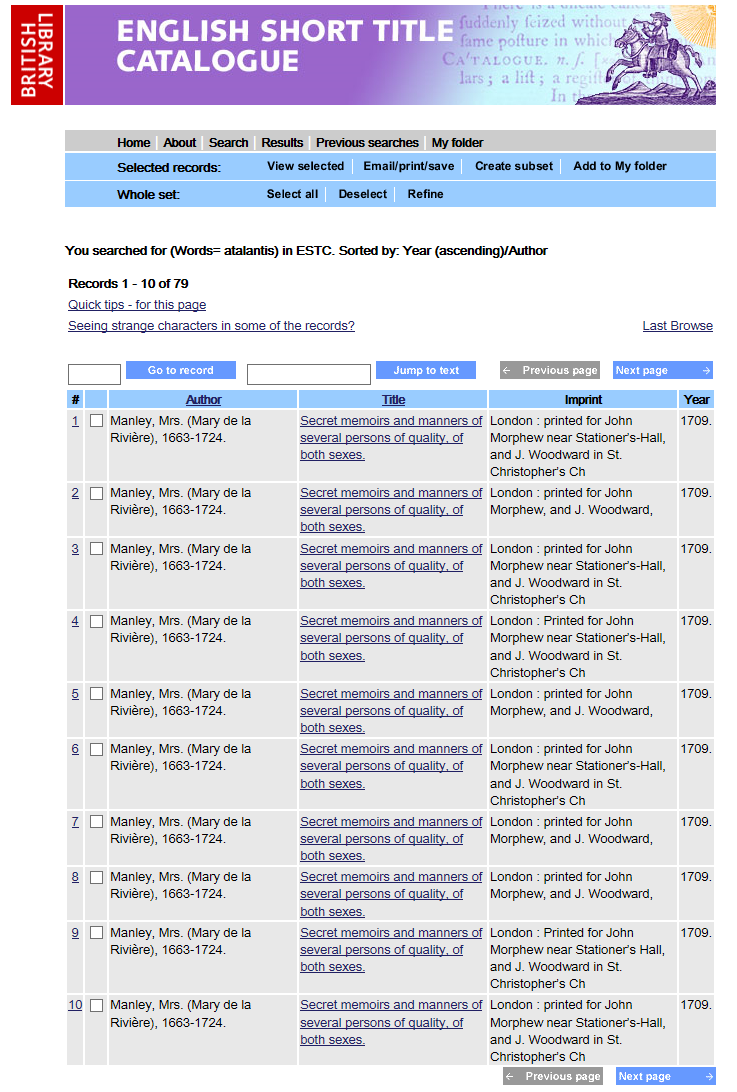
- Bibliographischer Information (namentlich der Nationalkatalogen für die frühe Neuzeit: VD16-VD18, ESTC, STCN aufweisen
Man wird erstens nachdenken müssen, wie man für die historische Datenbank auswählt (das menschliche Genom, das in Wikidata vollständig sequenziert erfasst ist, ist uninteressant, auch will man eher unglückliche Informationsangebote aus der neuen Datenbank heraushalten – man benötigt jedoch etwa zu Personen Grunddaten, um sie eindeutig identifizieren zu können). Man wird zweitens nachdenken müssen, wie man bei der Zusammenführung von Wikidata und GND-Informationen mit Doubletten umgeht.
2| Benötigt: Schicke (spielerische) Werkzeuge zur Ausmerzung von Doubletten
Das Problem taucht beim Anlegen bruchstückhafter Datensätze wieder auf – etwa wenn man aus einem Besucherbuch Namen abschreibt, von denen man nur weiß, dass sie zu einem genannten Zeitpunkt am genannten Ort sich so auswiesen.
Die Lösung wird ein Tool sein, dass Wahrscheinlichkeiten misst. Wie wahrscheinlich ist es, dass zwei Personen selben Namens am selben Tag und in der selben Stadt geboren wurden – und dann etwa auch noch das Sterbedatum und den Sterbeort teilen. Vermutlich kann man bei einer Zusammenführung von Daten automatische von Doubletten riskieren, wenn man dabei die statistische Wahrscheinlichkeit der Identität greifbar macht.
Attraktiv wäre ein Tool, das erwägt, wer wer sein könnte: Bei wem liegt die tentative Information im Bereich der Lebensspanne? Wer ist dagegen auszuschließen, da er an diesem Tag ein Alibi hat? Man kann dann massenweise aus Kirchenbüchern Namen und Daten notieren, Objekte anlegen und später das System nach Vorschlägen der Identifikation befragen.
3| Forschungsprojekten in der Ressource Raum bieten, die eigene Arbeit zu präsentieren
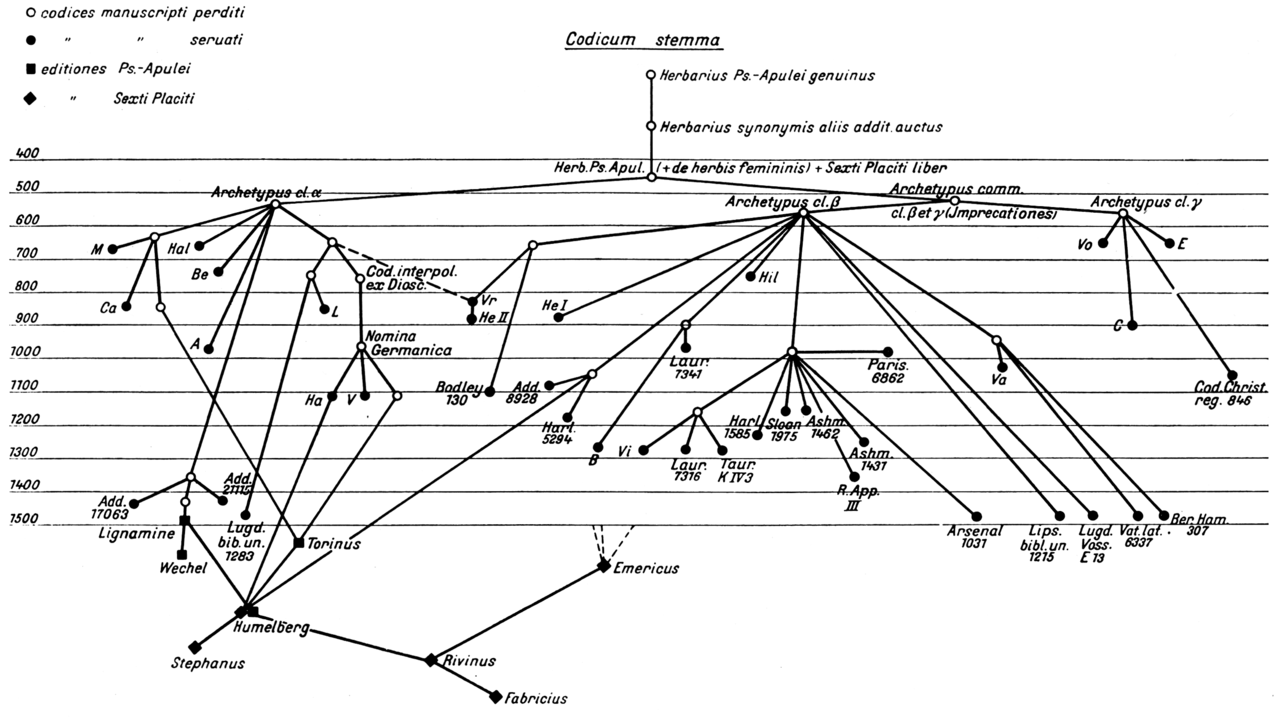
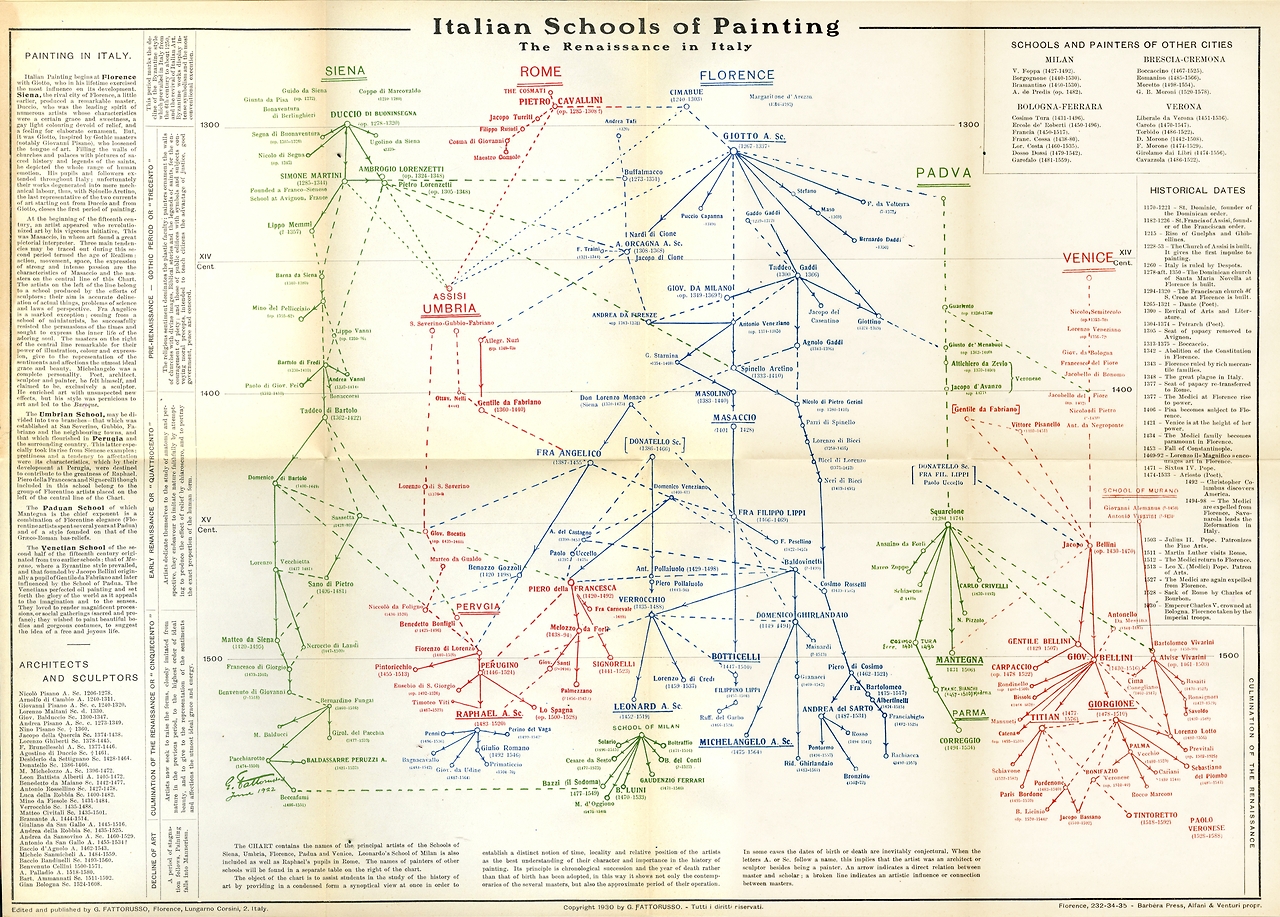
Demonstrationen verschiedener Tools machten klar, dass es bereits wunderbare Anwendungen gibt, die den Rang ganzer wissenschaftlicher Projekte haben könnten. Daniel Mietchen zeigte die Genealogie seiner Doktorväter bis um 1500 zurück:
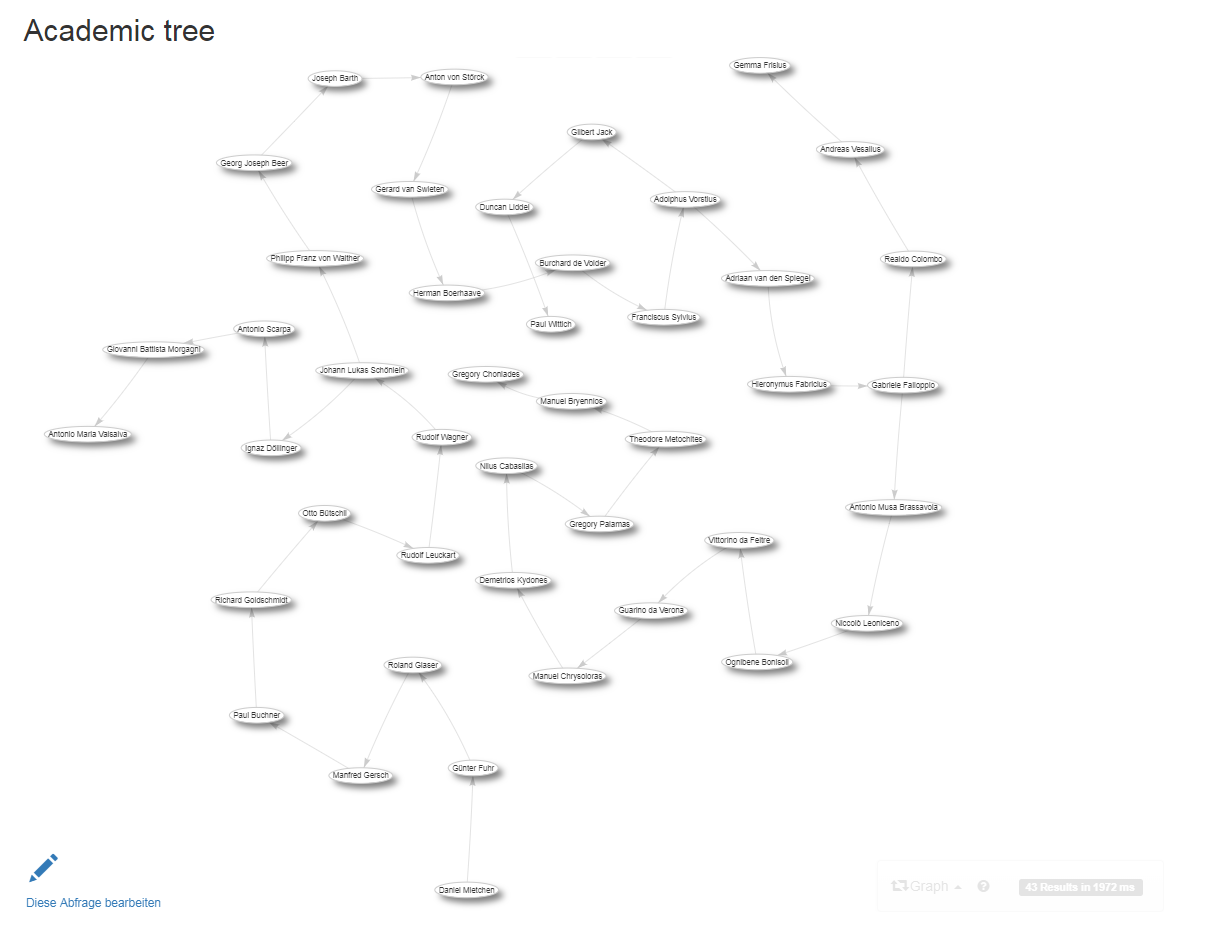
Die Entwicklungsrichtung, für die wir uns nach den Demonstrationen entschieden, ist es, vorwiegend mit der Datenbank zu arbeiten und Projekten dabei die Chance selektiver Präsentationen zu geben. Wir werden dafür eine Art Tagging einführen, mit dem Projekte Dokumente und Personen oder (Zeit–)räume ihres Interesses ausmachen können, um dann spezifische Suchangebote innerhalb eines abgesteckten Geländes machen zu können.
4| SQID und Reasonator
Die Entscheidung das „Illuminatenwiki“ langfristig aufzulösen, fiel insbesondere im Blick auf den Reasonator und SQID: Hier die Vergleichsseiten zu Johann Sebastian Bach in den Wikidata-Präsentationen durch beide beide Tools.
Beide Tools lassen sich parallel anbieten und werden einen ähnlichen Entwicklungsbedarf aufwerfen. Beim Umgang mit Dokumenten hätten wir gerne die Scans, Transkripte und Übersetzungen auf denselben Seiten. Eine typische Seite zu einer Quelle ist aus der Gotha Illuminati Research Base diese zu Schwedenkiste Band 13, Dokument SK13-070.
Elegant wäre, es zweispaltig Digitalisate neben Transkriptionen setzen zu können (und die Software für das Editieren zu öffnen). Elegant wäre es, wenn Benutzer zudem hier Übersetzungen anfertigen könnten.
5| Der FactGrid Quellen-Nachweis
Ausgiebig diskutierten wir das Schema des FactGrid Quellennachweises, wie es sich hier als Diskussionsvorschlag findet: Faktenbelege, die “Original Research” zulassen.
Prinzipiell sollte dieses Schema es Forschern erlauben, Befunde erstmals im FactGrid zu präsentieren und dabei selbst Arbeitshypothesen als solche handhaben zu können. Das Ziel ist nicht die Ressource, die ausschließlich mit solider Information bestückt wird, sondern ein Forschungshilfsmittel, das man etwa mit Personenlisten aus Dokumenten befüllen kann, um später zu sehen, welche Aussagen sich dazu machen lassen.
5| CC0 oder CC BY 4.0
Die Lizenz für das Factgrid sollte bislang CC BY 4.0 sein – jeder darf Informationen beliebig verwenden, muss sie aber wie verlangt zitieren. Das ist die wissenschaftliche Praxis, und das Zitat kann in diesem Fall nicht einfach „FactGrid“ lauten, es muss die Forscher nennen, die im FactGrid auf den Befund verwiesen.
Gegen die CC BY 4.0 spricht, dass sie bei einer Föderation mit Wikidata und dortiger CCo Lizenz ein Lizenzgefälle erzeugt, auch dass sich bei vielen Tools am Ende nicht das erwünschte Zitat mitliefern lassen wird: Wo sollen bei einer Visualisierung die Angaben zu den Forschern erscheinen? Fordert man sie ein, verhindert man die Visualisierungen.
Die pragmatische Alternative könnte lauten, dass wir uns auf CC0 einlassen, aber
- eine best practice Information geben: Dort, wo einzelne Informationen etwa zu einem Todesdatum von uns zitiert werden, stellt ein eigenes Zitierlink zusammen, wie wir das Datum wissenschaftlich zitieren würden. Das ist gerade für uns selbst attraktiv: Wir können dann von hier aus in eigenen Artikeln Fußnoten beziehen.
- mit Wikidata eine Vereinbarung treffen, wie wir dort Informationen unserer Arbeit zitiert sehen wollen
- auf eine technische Lösung hinarbeiten, die es Benutzern in Wikipedia leicht macht, ganze Fußnoten zu Informationen von uns zu beziehen – bislang werden Todesdaten etwa regulär ohne Quellenangaben gehandhabt.
6| Die Daten der Schwedenkiste-Excel-Liste in Triple verwandeln
Wir gingen diese Liste spaltenweise durch. Es sollte kein Problem sein, die Tripel zu den gelisteten Dokumenten zu formulieren. Etwas Anpassungsarbeit wird nötig, um etwa nicht mehr vorhandene Dokumente zudem einzeln führen zu können. Die Schwedenkiste enthält Seiten jeweils mehreren Entwürfen von Briefen, die selbst nicht mehr überliefert, aber von hier aus einzeln rekonstruierbar sind.
Matti Blume und Olaf Simons wollen sich am 11.12. in Berlin für das Datenmodell und die Anpassung der Excel-Liste treffen.
7| Zeitschnitte
Spannend wäre es, wenn man im FactGrid historische Situationen darstellbar machen könnte. Der Artikel zu Gotha wird in diesem Fall nach gewünschtem Zeitraum zusammengestellt mit Informationen, die Zeitraum-gerecht arrangiert werden. Gotha hat um 1800 etwa 12.000 Einwohner, es gehört nicht zur BRD sondern ist Residenzstadt im Herzogtum Sachsen-Gotha-Altenburg und so fort.
Eine Website, die Zeitschnitte recherchierbar macht, wäre ein denkbares Objekt für einen coding Wettbewerb.
8| Barcamp Open Science, Coding Da Vinci, Hackathon
Vom Berliner Workshop ging die Anregung aus, einen nächsten Workshop im Frühjahr – vielleicht Anfang März zu veranstalten und dabei absolvierte Arbeitsschritte zu besprechen. Unser Ziel sollte es im selben Moment sein, von hier aus Projekte für coding-events zu formulieren:
- Barcamp Open Science 2018, 12. März 2018, Wikimedia, Berlin
- Coding Da Vinci Ost: Kick-Off 14./15. April 2018 Universitätsbibliothek Leipzig, Sprint 9 Wochen, um kooperativ Projekte umzusetzen, Preisverleihung 19. Juni 2018, Universitätsbibliothek Leipzig
- Wikimedia Hackathon 2018: Barcelona 18.–20. Mai 2018
9| Koordination
- Alle Beteiligten erhalten hier im Blog Accounts: Hier insbesondere die Einladung interessante Visualisierungen, Tools, Events im Blog vorzustellen
- Wikidata informiert über das Projekt hier: https://www.wikidata.org/wiki/Wikidata:FactGrid
- Wikimedia richtet eine Mailingliste für das Projekt mit der Adresse factgrid@wikimedia.de ein