A FactGrid vocabulary of types of functional texts after Eckard Rolf

auf Deutsch

The data set in basic queries:

The links above give access to our first controlled vocabulary on FactGrid: “The FactGrid vocabulary of types of functional texts.”

Types of functional texts are not a matter of course. The corresponding genres of literary texts are, with all the problems discussed in the literary debate, far better known. The genres of functional texts are less controversial, but also less comprehensive. You find them in any mass of public records in the form of “insurance policies,” “interrogation protocols,” and “school reports,” to the odd “delousing certificate.” They do their jobs – so why collect the terms?

The technical answer is that Wikibase is software that invites you to use very specific vocabularies. You can run SPARQL queries on these specific terms and they will retrieve the “delousing certificate” in the mass of data, and you can, with very simple switches, bring far broader fields into view. The reduction to fields is the first step into statistics. If you can bring the variety under broader headings you can get a quick view of any vast production in your table. The vocabularies you need for this purpose have to be more than just lists of words. They need categorisations, common denominators above the words, ontologies.

A linguist’s perspective and data model

Our “Vocabulary of types of functional texts” has the required structural depth to allow statistical analysis and the broader analysis of larger bodies of texts. So far it is based primarily on the two Properties P894 “Eckard Rolf class of functional text types” and P912 “Speech act qualities.” The analysis is under both properties based on Eckard Rolf’s Die Funktionen der Gebrauchstextsorten (Berlin/ New York, 1993). Tobias Christ asked for the import of this vocabulary and its inherent structure for a project on functional texts of Germany’s Nazi era. He will explore handbooks for the organisers of Hitler Youth camps, official directives on the insignia of uniforms, etc. Rolf’s book is immensely practical with its in-depth analysis of 2055 terms arranged here in the five branches of illocutionary acts. Types of functional texts, under this premise, are essentially illocutionary speech acts as proposed by Austin and Searle in the 1950s and 1960 in their five branches:

  • assertives = speech acts that commit a speaker to the truth of the expressed proposition,
  • directives = speech acts that are to cause the hearer to take a particular action, e.g. requests, commands and advice,
  • commissives = speech acts that commit a speaker to some future action, e.g. promises and oaths,
  • expressives = speech acts that express on the speaker’s attitudes and emotions towards the proposition, e.g. congratulations, excuses and thanks
  • declarations = speech acts that change the reality in accord with the proposition of the declaration, e.g. baptisms, pronouncing someone guilty or pronouncing someone husband and wife

…thus the Wikipedia article illocutionary acts. Rolf deployed three further layers underneath this basic differentiation: two layers (of more or less specific) options on how the respective aims can be achieved and the fourth layer of situational conditions. The “delousing certificate” is under this matrix a “declarative statement” (a person is “declared” to be free of lice after the required treatment). The certificate will add a “personal dimension” to the bearer of the certificate – he or she will be free again to interact with others with the legitimation of the certificate. The statement is finally “body related.” Rolf created 100 groups under these four layers. The “delousing certificate” is in group “DECLA 12” together with the “allergy passport” or the “vaccination certificate.” Other types of texts do different things differently: A “doctoral thesis” (ASS 24) is an “assertive” – it commits the speaker to the truth of his or her exploration. The work is supposed to be “descriptive” and “argumentative.” The author will hand in this work with the “intention to gain a specific qualification.” Neighbouring types of texts such as the “book review” share some but not all features: Book reviews are again “assertives” and “descriptive” but without the author’s intention to gain a specific qualification with them. Their focus lies on a “judgment” they pass.

The following search gives the entire vocabulary in the four languages that are presently fully supported with Eckard Rolf’s primary classes and their basic categorisation:

  • Types of functional texts, generic terms in German, English, French, Spanish with Eckard Rolf’s bottom-line classification https://tinyurl.com/27ctrfam

The actual set of words is – especially on its German side – larger than the set of items. Rolf had separated terms like “Jagdschein” and “Jagdkarte” – in this case to have the German and the Austrian terms. In English both things are “hunting permits” unless we decide to offer individual  hunting permits all around the world. In other cases the differences were stylistic, created by registers that could not be reproduced in English, French, or Spanish. We eventually reduced the set to objects of essentially the same meaning. About 200 words are now variants in the alias sections and on the P34 “naming” Property where they can attract explanations of their proper use.

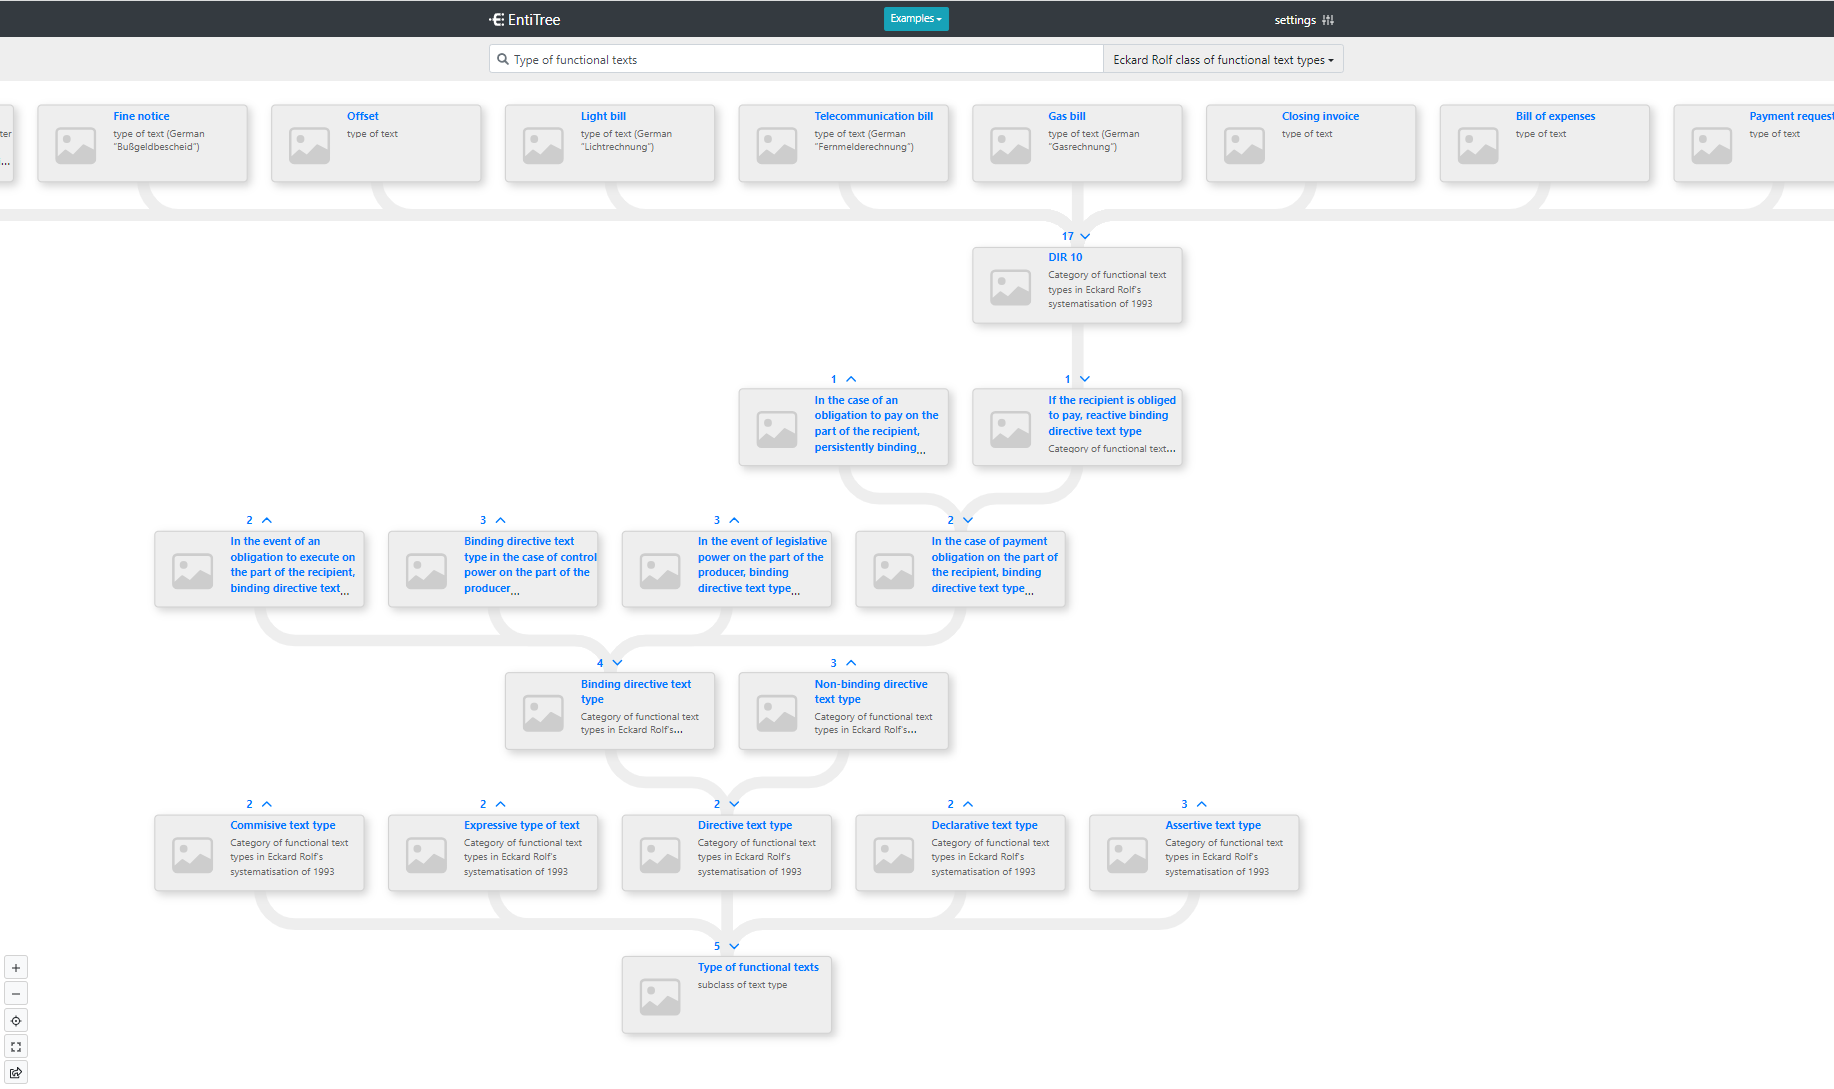
Eckard Rolf presented his original 2055 terms together with a series of structural overviews. Tobias Christ offered a condensed PDF-version of these visualisations in a single tree structure. You can use the EntiTree App to show rhis structure on your screen:

Any of the nodes in the representation can determine a specific query of the terms at the end of the ensuing ramification. This is the complete list of speech act qualities searchable on the P912 Property of “Qualities of speech acts”:

It is just as easy to generate statistics on each structural level. Here is the visualisation of the top level in a bar chart:

The following four searches give the scripts for each level (the level difference is determined with the Q-Item in line 8):

  1. The five illocutionary purposes of speech acts Q538467
  2. Division by general way to achieve the purpose Q538468
  3. Division by specific way to achieve the purpose Q538469
  4. Division by primary conditions of speech acts Q538470

The searches above cover the entire terminological set so they can now be run on any specific body of texts.

The open tool

The FactGrid database version of Eckard Rolf’s structural analysis should turn the book’s considerations into an immensely practical tool ready to download into any other software environment and ready to be expanded on FactGrid. New types will not compromise the original set – it remains intact through the statement P124+Q514322 (“listed in Eckard Rolf, Die Funktionen der Gebrauchstextsorten”) that is made on every individual word:

The best way to add a new term is to find neighbouring terms and to adopt their statements. FactGrid already had a couple of candidates, such as the popular “Briefsteller” (the “letter writer’s guide”) of the German 18th century, or the “Quibus Licet” (the letter which Illuminati had to hand in every month to stay in contact with the “unknown superiors”).

Our first “controlled vocabulary” is with these preliminary remarks still very much of an experiment. —

  • It will be interesting to offer the generic terms also as “Lexemes”: — Wikibase Lexemes are special entities that organise individual words in their languages.
  • The French and Spanish labels in particular are still very artificial translations – we should have original terms for each of these items as referenced in historical documents.
  • The present vocabulary is not yet matched with external databases. Wikidata and the GND are the two most urgent data partners here. The following search gives the matching so far: https://tinyurl.com/284jbjhc
  • The linguist’s categorisation should be seen as one option to make sense of all these terms. One can easily think of other qualities of speech acts. In our preliminary talk Rolf proposed to explore, for instance, the assumed-sincerity dimension in many of these speech acts. “Lip service” was his example – a speech act where the “honesty of the emittent is unclear or doubtful.” One can just as well create completely independent properties on features of genres beyond the linguist’s interest.
  • We should eventually expand this work. A vocabulary of genres in all the arts and literature would be of interest here. One would balance such a vocabulary with a particular vocabulary of “historical generic terms.” (I remember, I once wrote a 700 page book with a plea to explore these terminologies in all their “deficiencies.” The deficiencies, so I proposed back then, were usually the first indications that people were not doing the things we are doing with works of “art” and “literature” in our debates. We might question our keenness on succinct definitions in these particular fields, so my thought ages ago; we do not really define words in order to settle debates, we are always far more interested in the destabilisation the definition will actually produce – but that is already a topic for a very different blog post.)

Published as part of the NFDI4Memory Task Area “Data Connectivity”, Historical Data Center Halle, project number 501609550.

Eckard Rolfs Vokabular der Gebrauchstextsorten als FactGrid-Angebot

English version

Der Datensatz in Basis-Abfragen:

Mit den obigen und den folgenden Link-Angeboten lässt sich ein erstes „kontrolliertes Vokabular“ zu Gattungen von Gebrauchstexten aus dem FactGrid ziehen, sowohl als einfache Wortliste wie mit inhaltlichen Durchdringungen und Übersetzungen. Im Moment hat dieses Angebot noch experimentellen Charakter. Wikibase ist eine Software für Wissensgegenstände, nicht für Worte. Die Gegenstände erhalten Q-Nummern und auf diesen liegende Bezeichnungen in den verschiedensten Sprachen – Worte dagegen würde man in ihren Sprachen belassen wollen. Die Wikibase-Entwickler erweiterten darum 2018 ihr Angebot: Zu den Q-Nummern für die Dinge des Wissens kamen L-Nummern für „Lexeme“, die in ihren Sprachen verbleiben und nun Aussagen zu sprachlichen Bedeutungen auf sich ziehen.

Die Gebrauchstextsorten, die Eckard Rolf 1993 erfasste und sortierte, sind eindeutig Wissensgegenstände, die Angelegenheit für Q-Nummern: Eine „Mahnung“ ist eine Aufforderung, eine versäumte Zahlung nachzuholen – man kann diese Erklärung in verschiedenen Sprachen geben und die verschiedensten Sprachen haben ihre Worte für denselben Gegenstand: „dunning“ im Englischen, „mise en demeure“ im Französischen.

Der Anstoß zu diesem ersten kontrollierten FactGrid-Vokabular kam von Tobias Christ auf seiner Suche nach einem Werkzeug für die Erfassung von NS-Gebrauchstexten. Eckard Rolfs funktionale Klassifikation von Gebrauchstextsorten erfasst großzügig Begriffe und Kommunikationsstrukturen unter dem pragmatischen Gesichtspunkt des Handlungszwecks und erlaubt damit Blicke auf jeweils benachbarte Gegenstände – interessant etwa in Vergleichen der Gestaltung gleichartiger Texte. Statistiken von Produktionen lassen sich mit Rolfs Erfassung generieren, da sie das Gelände ohne große Doppelungen der Zuweisungen aufteilt. Der Autor stand bei der Datenbank-Version zur Seite, und ich vermute, er wird noch an einigen Stellen editorisch nachfassen. Mit dem nachfolgenden Link lässt sich die Liste in JSON, CSV, TSV oder Html-Tabellen herunterladen (rechts am Seitenrand eröffnen sich im Mouse-over die Optionen). Spalte 1 bietet die Links in die einzelnen Datenbankobjekte. Die Spalten 3 und 4 ordnen den Begriffen Rolfs Signaturensystem zu. Ich setze diesem die Einstufung nächster Ebene zur Seite, da mit ihr die Ordnungskriterien greifbarer werden:

Eckart Rolfs Klassifikation der Gebrauchstextsorten umfasst originär 2056 Gattungsbegriffe, die auf oberster Ebene in fünf Gruppen auseinanderdividiert sind; die assertiven Gattungen bilden das Gros gefolgt von den direktiven, deklarativen, kommissiven und expressiven:

Mit der EntiTree App lässt sich (durch Anklicken der Pfeile) das Gefüge entfalten:

Eckard Rolf bot diese Entfaltung bereits in seinem Buch an. Tobias Christ fasste sie in einer praktischen und um eigene Beispiele ergänzten Ansicht zusammen (Pdf), die mich die Knotenpunkte im System zuweisen ließ. Die spezifische Visualisierung wirft ein Schlaglicht auf die Art der Erschließung, die Rolf durchführte. Personalausweise mögen Personen Geschlecht, Augenfarbe, Körpergröße und Adressen zuschreiben – Eigenschaften, die einander gegenüber variabel bleiben. Eckard Rolfs Erschließung ist grundlegend anders: Die Eigenschaften untergliedern sich, sie werden feiner. Ich machte diese Verschachtelung der Optionen sichtbar, indem ich die Untergliederungen in den Aussagen auf allen ihren Ebenen mit erfasste. Auf der obersten Ebene ist die „Mahnung“ eine „direktive Textsorte“, auf der untersten eine „bei Zahlungspflicht auf Seiten des Rezipienten insistente bindende direktive Textsorte“.

Neben der Verortung im Gefüge eine Erfassung der Objekt-Eigenschaften

Die von Rolf angebotene Stammbaum-Untergliederung liegt auf einer einzigen Property, der Property P894: Eckard Rolf Gebrauchstextsorten-Klasse. Der Stammbaum mit seinen Differenzierungen eröffnet sich dabei von den Basisklassifikationen ausgehend; sie sind vom unten nach oben vernetzt. Mit der gewählten Property P894 lässt sich damit zwar das gesamte Gefüge wiedergeben und bei guter Skriptkenntnis beliebig gebündelt abfragen, im Umgang mit den einzelnen Begriffen bleibt das jedoch unbefriedigend. Die Aussagen zu jedem Begriff liegen jeweils in den unsichtbaren Knoten über ihm. Zwei Möglichkeiten bestehen, um die Aussagen einzeln zudem auch noch auf die Begriffsebene zu legen: Man kann für jede Ebene der Granularität eine eigene Property aufmachen, oder eine Summarische Sprechakt-Property aufmachen und auf dieser die Eigenschaften einzeln notieren. Ich spielte beide Lösungen durch und entschied mich im Verlauf mit nur einer Sammel-Property zu arbeiten – der Property P912: Sprechaktqualitäten. Es geht bei dieser Lösung nichts verloren, da wir auch auf den jeweiligen Aussagen vermerken können, auf welcher Betrachtungsebene sie gemacht sind und damit dieselben statistischen Auswertungen für jede Betrachtungsebene durchführen können. Die Sammlung der Eigenschaften unter der einen Property P912 ist vorteilhaft, da Nutzer nur bei Abfragen nicht vorab wissen müssen, auf welcher Ebene sich die jeweilige Eigenschaft bewegt. Man sucht nach Texten mit der Eigenschaft unter einer einzigen Property und erhält mehr oder weniger große Bündelungen.

Hier die statistischen Abfragen des gesamten Corpus, wie es Rolf erfasste, auf den einzelnen Eigenschaftsebenen:

  1. Zweckbestimmung
  2. Generelle Zweckanstrebungsweise
  3. Spezielle Zweckanstrebungsweise
  4. Vorbereitende Bedingung
  5. Erfülltheit der Aufrichtigkeitsbedingung

Im beratenden Gespräch spielte Eckard Rolf die Antworten am Beispiel des „Lippenbekenntnisses“ durch, wobei er unversehens mit der „Erfülltheit der Aufrichtigkeitsbedingung des Sprechakts“ eine neue Ebene der Eigenschaften aufmachte, die in seinem Buch so nicht vorkam. Frage der Aufrichtigkeit ist interessant, da sie sich nicht im Stammbaum unterordnet und quer durch das Gefüge der Begriffe greift. Bei Textsorten wie der „Sonntagsrede“ sollte sie wieder aufkommen. Ich machte indes keine Begriffe auf und versuchte keine Zuordnung der P912-Property – Sprachwissenschaftler sollten hier nachdenken und eigene Begriffe und Erwägungen spielen lassen.

Die obigen Suchen sind gleichzeitig Musterabfragen, mit denen sich beliebige Corpora statistisch zergliedern lassen. Im Internet findet sich ein einzelner Anwendungsfall des Rolfschen Vokabulars mit der Statistik, die Stefan Rabanus in seiner Staatsexamens-Arbeit Die Sprache der Internet-Kommunikation, Mainz, Gardez! Verlag, Mai 1996 durchexerzierte. Hier ist besonders Node 37) nit der Auswertung interessant. Die FactGrid-Erfassung macht solche Auswertungen in Zukunft einfacher.

Genauso gut lassen sich unter der einheitlichen P912 Property nun einzelne Aussagen herausgreifen. Die folgende Mustersuche erfasst so etwa „bindende“ Textsorten. Wenn man unter dem i-Symbol den Query Helper öffnet, kann man diese Eigenschaft gegen jede andere aus der Liste aller Eigenschaften austauschen:

Das sich öffnende Projekt

Die in Eckard Rolfs Publikation 1993 ursprünglich genannten 2056 Textsorten sind über die Quellenvermerke notiert und abfragbar. Das erlaubt es, neue Begriffe wie den „PodCast“ wie das „Quibus Licet“ (Q10508), das Illuminaten monatlich bei den Ordensoberen einreichen mussten in das Gefüge aufzunehmen ohne die Ursprungskonfiguration dabei unsichtbar werden zu lassen – man kann das größere FactGrid-Corpus abfragen wie Rolfs ursprüngliches. Aus der abgeschlossenen Buchpublikation von 1993 wird damit ein beliebig erweiterbares Gefüge.

In eine zweite Richtung musste das Projekt im FactGrid umgehend geöffnet werden: Die Datenbank ist auf Übersetzungen aller Termini angewiesen; englische Label sind dabei unabdingbar, um in den Sprachen, die noch nicht bedient werden. Die Übersetzungen sind im Moment noch sehr provisorisch.

Google scheiterte großflächig an den Nuancen der Rolfschen Liste. Bei 230 im Deutschen unterschiedlichen Begriffen kam es auf der englischen Seite zu Konvergenzen. „Rat“ und „Ratschlag“ wurden „Advice“; „Unglücksbotschaft“, „Unglücknachricht“ und „Schreckensnachricht“ wurden erst einmal nur „bad news“. Mitunter wissen wir im Deutschen, wann ein bestimmter Begriff angemessen ist: „Jagdkarte“ ist österreichisch, und „Jagdschein“ deutsch. „Schwur“ und „Eid“ überschneiden sich im Deutschen, doch zeigen „Amtseid“ und „Racheschwur“ Grenzen der Austauschbarkeit: der Schwur ist eher ein emphatisches Versprechen, der Eid formeller. Wenn eine andere Sprache nicht genauso differenziert – im Englischen gibt es nur den „oath“, ob als „oath of revenge“ oder als „oath of office“ – dann erhalten deren Nutzer zwei Items „oath“, zwischen denen sie sich nicht entscheiden können, nur weil auf deutscher Seite hier Unterschiedliches steht. In diesen Fällen ist es eigentlich ratsam, nur ein Item zu bespielen und auf diesem für jede Sprache ins Detail zu gehen und Worte zu listen, die dies meinen, samt qualifizierenden „Nutzungshinweisen“ auf der Property P598. Worte gehen bei solchen Zusammenlegungen nicht verloren, sie erhalten nur einen präziseren Platz als Optionen, die Sprachen unterschiedlich zur Verfügung stellen.

Was zu tun bleibt

Kontrollierte Vokabulare auf einer Wikibase-Instanz anzubieten, dürfte praktisch sein: In der Graph-Datenbank lassen sich Vokabulare im Plural verwalten und komplikationslos auf dieselben Begriffe legen. Wir können im selben Moment sagen, wie sich diese Vokabulare zueinander verhalten, wo sie deckungsgleich sind, wo sie eigene Vernetzungen auftun, und können so zwischen Vokabularen mühelos vermitteln. Man kann im selben Moment externe Datenbanken, die sich eines bestimmten Vokabulars bedienen, egal in welcher Sprache sie das tun, mit dem eigenen Lieblingsvokabular verstehen.

Das vorliegende Vokabular birgt im Moment als deutlich deutsches Produkt mit sehr feiner Nuancierung in der globalen Nutzung Desiderate:

  • Die Property-Label und Beschreibungen sollten noch einmal übersehen werden. Dies sind alle aktuell bestehenden Eigenschaften von Gebrauchstextsorten.
  • Die Übersetzungen müssen noch vollständig überprüft werden.
  • In der gesamten Begriffs-Liste sollten Zusammenziehungen auf „das jeweils Gemeinte“ erwogen werden. Verschiedene Worte für mehr oder minder dasselbe, legt man dabei zum einen auf die Alias Position (das geschieht beim “Merging” automatisch, danach landet man beim Eintippen der beliebigen Alternative auf dem zentral gesetzten Begriff), zum andern kann man die Varianten danach an Ort und Stelle mit „Nutzungshinweisen“ ausstatten. Es ist dies der Weg, der das Instrumentarium mehrsprachig eindeutig macht.
  • Das gesamte Vokabular ist derzeit nur im Ansatz mit Wikidata abgeglichen und kaum mit GND-Nummern ausgestattet. Auch hier ist im Moment noch nachzufassen.

Publiziert im Rahmen des der NFDI4Memory Task Area “Data Connectivity”, Historisches Datenzentrum Halle, Projektnummer 501609550.